Sparse-vDiT: Sparse Attention Acceleration for Video Diffusion Transformers
利用稀疏注意力模式加速视频扩散 Transformer 推理
Sparse-vDiT: Sparse Attention Acceleration for Video Diffusion Transformers
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Sparse-vDiT: Unleashing the Power of Sparse Attention to Accelerate Video Diffusion Transformers |
| 作者 | Pengtao Chen, Xianfang Zeng, Maosen Zhao, Peng Ye, Mingzhu Shen, Wei Cheng, Gang Yu, Tao Chen |
| 机构 | Fudan University, StepFun, CUHK, Imperial College London |
| 论文 | arXiv:2506.03065 |
| 代码 | GitHub |
| 发布 | 2025年6月3日 |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
视频扩散 Transformer (vDiT) 的 3D 全注意力机制导致二次复杂度,在长序列设置下成为推理瓶颈。例如,HunyuanVideo 生成 5 秒 720p 视频需要约 50 分钟,其中注意力模块占比 81%。
解决方案概述
Sparse-vDiT 是一个稀疏加速框架,通过以下策略加速 vDiT:
- 注意力头跳过: 3-6% 的注意力头可以跳过而不影响质量
- 三种稀疏模式: 对角线、多对角线、垂直条纹模式
- 离线搜索算法: 基于硬件感知的代价模型为每个层和头选择最优稀疏策略
- 头融合: 将相同注意力策略的头融合以提高效率
核心性能
| 模型 | FLOP 减少 | 实际加速 | PSNR |
|---|---|---|---|
| CogVideoX1.5 | 2.09× | 1.76× | 24.13 |
| HunyuanVideo | 2.38× | 1.85× | 27.09 |
| Wan2.1 | 1.67× | 1.58× | 22.59 |
三、技术架构
整体框架图
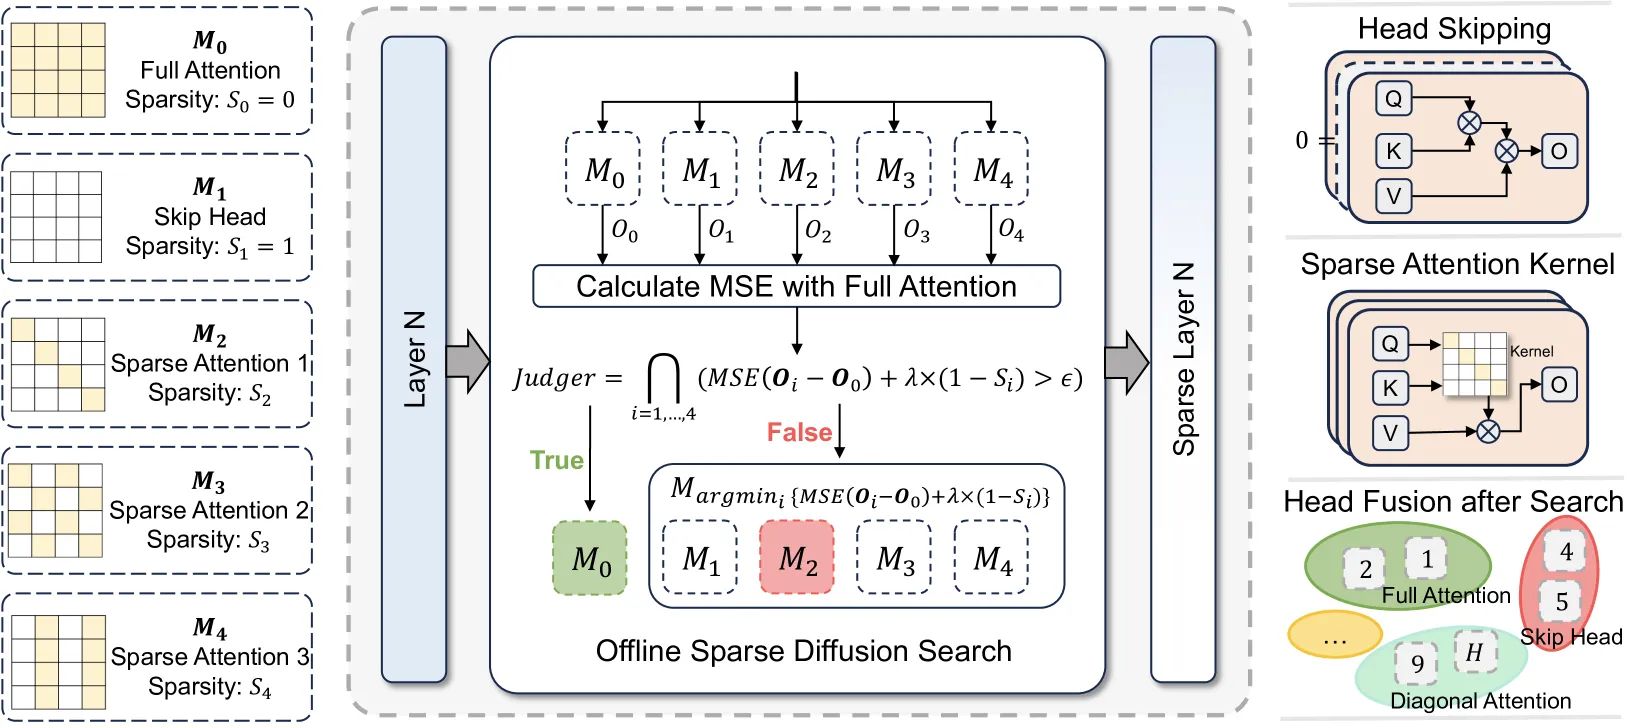
Figure 5: Sparse-vDiT 概览。预定义五种注意力模式 ,通过离线稀疏扩散搜索算法为每个层和头选择最优模式,然后融合相同模式的头以提高效率。
核心公式
全注意力机制
离线搜索损失函数
其中:
- : 全注意力输出
- : 第 种稀疏模式输出
- : 第 种模式的稀疏度
- : 质量-效率平衡因子
注意力模式选择
其中 控制推理时的整体稀疏度。
四种注意力模式
| 模式 | 说明 | 稀疏度 | 适用场景 |
|---|---|---|---|
| Full | 全注意力,值均匀分布 | 0 | 无法稀疏化的头 |
| Skip | 跳过注意力,输出置零 | 1 | 冗余头 |
| Diagonal | 对角线模式,大值在主对角线 | 预定义 | 帧内自交互 |
| Multi-Diagonal | 多对角线模式,多条均匀间隔对角线 | 预定义 | 跨帧一致性 |
| Vertical-Stripe | 垂直条纹模式,全局 token | 预定义 | 全局 token 交互 |
注意力图结构
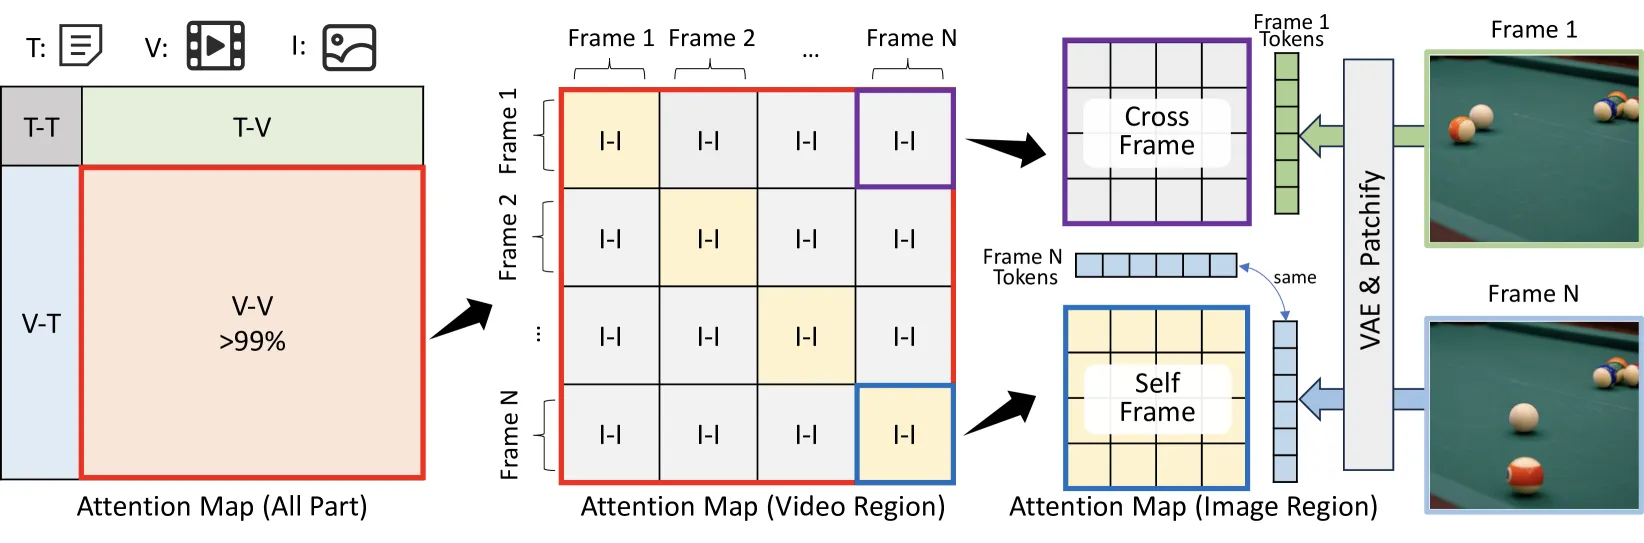
Figure 2: vDiT 注意力图的四个交互区域。主导的 V-V 区域包含帧内对角线块和跨帧非对角线块。
稀疏模式可视化
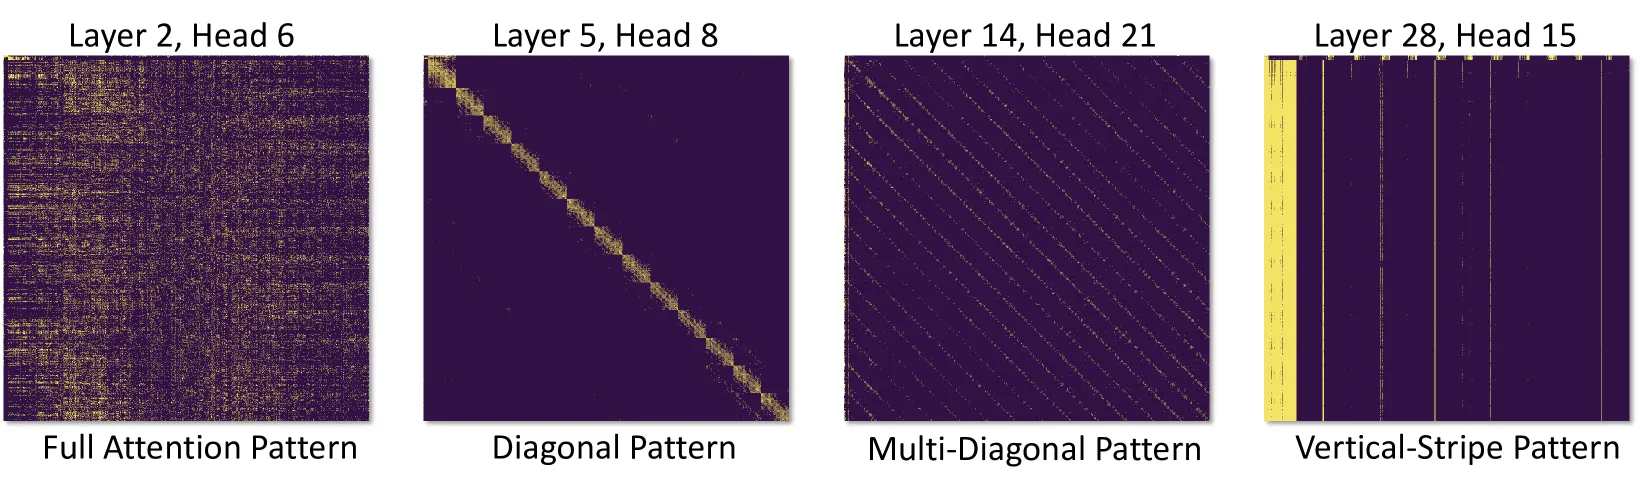
Figure 3: vDiT 中四种循环注意力模式的可视化。
注意力模式不变性
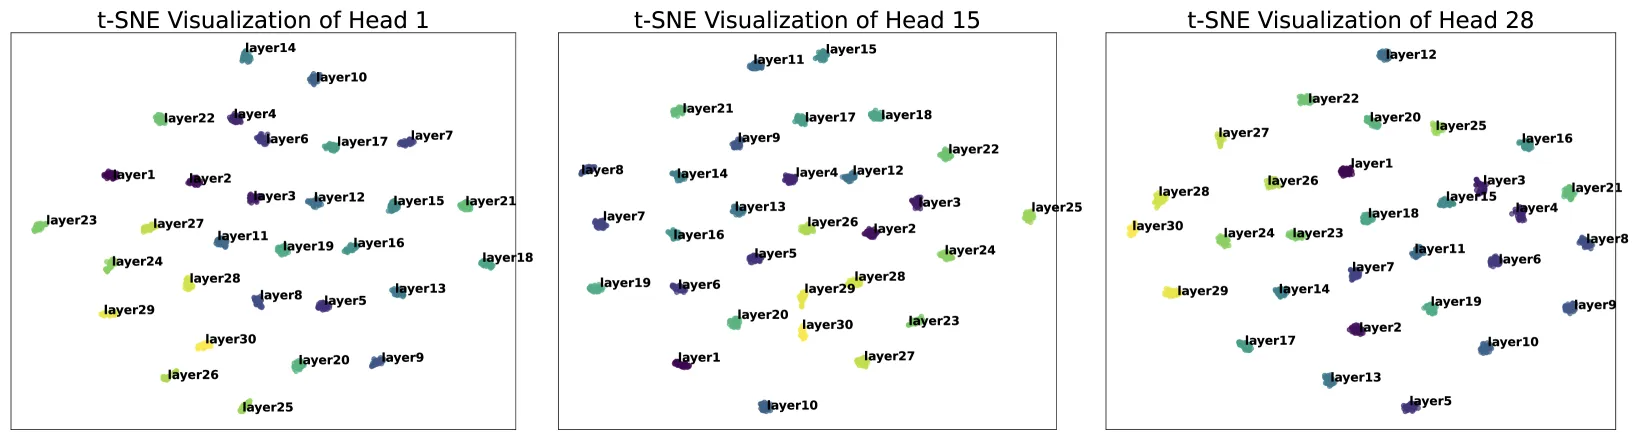
Figure 4: VBench 子集上注意力模式的 t-SNE 可视化。不同层用不同颜色表示。不同 prompt 的模式呈现聚类,说明模式与输入内容无关。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 稀疏核 | 针对三种稀疏模式的高效实现 | Triton/CUDA |
| 离线搜索器 | 为每个层和头选择最优模式 | , |
| 头融合器 | 融合相同模式的头 | 层内融合 |
| 跳过策略 | 跳过冗余头,输出置零 | 3-6% 跳过率 |
搜索算法
Algorithm 1: Offline Sparse Diffusion Search
- 输入: vDiT 模型,小样本集
- 对每个时间步和每个层:
- 通过 到 获取隐藏状态 到
- 计算
- 计算损失
- 如果所有 ,保留全注意力
- 否则选择 的模式
- 输出: 每个层和头的固定稀疏模式配置
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 注意力冗余分析 | 发现 3-6% 头可跳过,三种稀疏模式 | Table 1 跳过实验 |
| 模式不变性 | 稀疏模式与输入无关,仅与位置相关 | Figure 4 t-SNE 聚类 |
| 离线搜索 | 仅需小样本即可确定最优配置 | 离线 Profiling |
| 头融合 | 相同模式的头融合提高效率 | 层内融合优化 |
| 三种稀疏核 | 针对对角线/多对角线/垂直条纹的高效实现 | Triton/CUDA 实现 |
五、实验结果
主要结果 (CogVideoX1.5)
| 方法 | FLOPS (PFLOPS)↓ | 延迟↓ | 加速↑ | SSIM↑ | PSNR↑ | LPIPS↓ |
|---|---|---|---|---|---|---|
| 原始 | 147.87 | 901s | 1.00× | - | - | - |
| MInference | 84.89 | 634s | 1.42× | 0.61 | 14.63 | 0.37 |
| WinAttn (Spatial) | 72.34 | 531s | 1.69× | 0.64 | 19.07 | 0.32 |
| WinAttn (Temporal) | 72.34 | 537s | 1.67× | 0.69 | 19.64 | 0.28 |
| PAB | 105.88 | 630s | 1.43× | 0.72 | 20.93 | 0.23 |
| SVG | 74.57 | 550s | 1.64× | 0.75 | 21.92 | 0.22 |
| Sparse-vDiT | 70.69 | 511s | 1.76× | 0.82 | 24.13 | 0.14 |
主要结果 (HunyuanVideo)
| 方法 | FLOPS (PFLOPS)↓ | 延迟↓ | 加速↑ | SSIM↑ | PSNR↑ | LPIPS↓ |
|---|---|---|---|---|---|---|
| 原始 | 612.37 | 3166s | 1.00× | - | - | - |
| MInference | 293.87 | 2042s | 1.55× | 0.64 | 19.23 | 0.43 |
| WinAttn (Spatial) | 258.84 | 1755s | 1.80× | 0.56 | 17.81 | 0.56 |
| WinAttn (Temporal) | 258.84 | 1764s | 1.79× | 0.80 | 23.76 | 0.22 |
| SVG | 259.79 | 1802s | 1.75× | 0.86 | 26.83 | 0.14 |
| Sparse-vDiT | 257.09 | 1715s | 1.85× | 0.87 | 27.09 | 0.12 |
主要结果 (Wan2.1)
| 方法 | FLOPS (PFLOPS)↓ | 延迟↓ | 加速↑ | SSIM↑ | PSNR↑ | LPIPS↓ |
|---|---|---|---|---|---|---|
| 原始 | 660.49 | 1935s | 1.00× | - | - | - |
| MInference | 469.79 | 1453s | 1.33× | 0.62 | 15.49 | 0.36 |
| WinAttn (Spatial) | 401.21 | 1265s | 1.53× | 0.68 | 19.14 | 0.25 |
| WinAttn (Temporal) | - | - | - | 0.73 | 20.29 | - |
| Sparse-vDiT | - | - | 1.58× | 0.80 | 22.59 | - |
注意力头跳过实验 (Table 1)
CogVideoX1.5:
| 跳过比例 | PSNR↑ | SSIM↑ | LPIPS↓ |
|---|---|---|---|
| 1% | 36.62 | 0.96 | 0.01 |
| 3% | 33.31 | 0.95 | 0.02 |
| 6% | 30.02 | 0.92 | 0.04 |
| 10% | 26.87 | 0.85 | 0.09 |
HunyuanVideo:
| 跳过比例 | PSNR↑ | SSIM↑ | LPIPS↓ |
|---|---|---|---|
| 1% | 31.84 | 0.95 | 0.02 |
| 3% | 28.94 | 0.91 | 0.06 |
| 6% | 24.21 | 0.81 | 0.12 |
| 10% | 17.98 | 0.72 | 0.22 |
消融实验 (Table 3)
超参数 和 的影响:
| PSNR↑ | SSIM↑ | LPIPS↓ | 加速↑ | ||
|---|---|---|---|---|---|
| 0.01 | 0.1 | 24.13 | 0.82 | 0.14 | 1.76× |
| 0.005 | 0.1 | 23.85 | 0.81 | 0.15 | 1.78× |
| 0.01 | 0.05 | 24.52 | 0.83 | 0.13 | 1.72× |
| 0.01 | 0.15 | 23.65 | 0.80 | 0.16 | 1.80× |
视觉质量对比
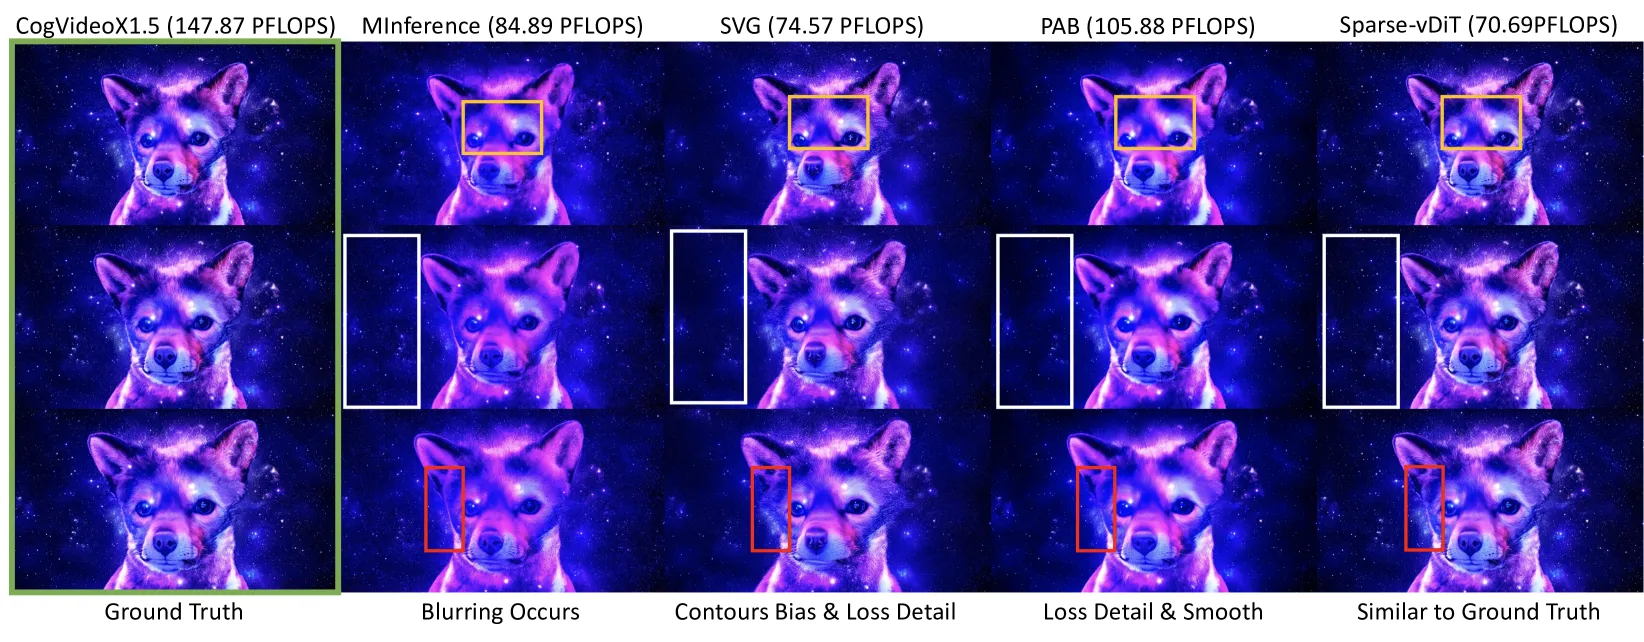
Figure 6: Sparse-vDiT 与基线方法的视觉对比。绿框为真值,黄框突出模糊和平滑度差异,白框突出细节差异,红框强调轮廓对比。
延迟分解
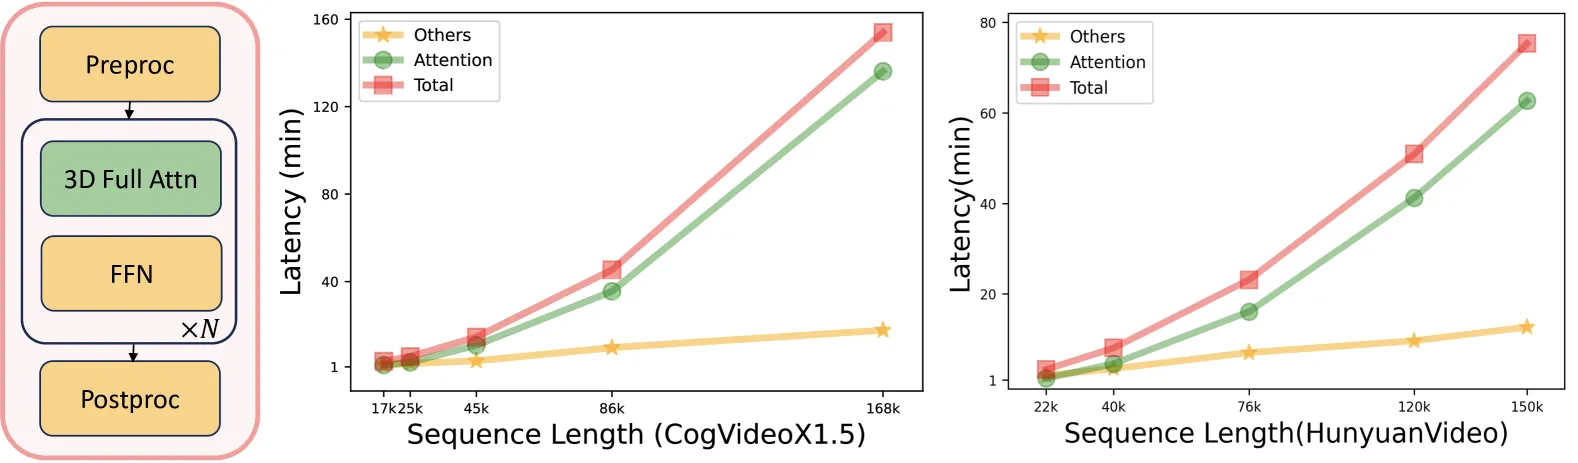
Figure 1: vDiT 架构及其两种变体 (CogVideoX1.5 和 HunyuanVideo) 的推理延迟分析。在长序列设置下,注意力模块延迟占主导地位。
六、与现有方法对比
| 方面 | MInference | WinAttn | SVG | PAB | Sparse-vDiT |
|---|---|---|---|---|---|
| 方法类型 | 稀疏注意力 | 窗口注意力 | 稀疏注意力 | 缓存 | 稀疏注意力+头跳过 |
| 模式类型 | 动态 | 固定窗口 | 在线搜索 | 固定 | 离线搜索 |
| 头跳过 | 无 | 无 | 无 | 无 | 有 |
| 头融合 | 无 | 无 | 无 | 无 | 有 |
| CogVideoX 加速 | 1.42× | 1.69× | 1.64× | 1.43× | 1.76× |
| HunyuanVideo 加速 | 1.55× | 1.80× | 1.75× | - | 1.85× |
| 质量损失 | 大 | 中等 | 较小 | 较小 | 极小 |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| SVG | 最近的 vDiT 稀疏加速方法,Sparse-vDiT 超越 |
| MInference | LLM 稀疏注意力迁移,效果有限 |
| WinAttn | 窗口注意力基线 |
| PAB | 缓存方法基线 |
| DiTFastAttn | DiT 注意力加速参考 |
| CogVideoX, HunyuanVideo, Wan2.1 | 目标 vDiT 模型 |
八、总结
核心贡献
- 注意力冗余分析: 发现 vDiT 中 3-6% 头可跳过,三种循环稀疏模式
- 模式不变性: 稀疏模式与输入无关,仅与注意力位置相关
- Sparse-vDiT 框架: 离线搜索+稀疏核+头融合的完整加速方案
- SOTA 性能: 在 CogVideoX1.5、HunyuanVideo、Wan2.1 上均达到最佳加速效果
技术影响
- 视频生成加速: 为 vDiT 提供系统性的稀疏加速方案
- 离线优化: 仅需小样本即可确定最优配置,运行时无额外开销
- 头融合: 利用固定模式实现层内融合,进一步提高效率
- 通用性: 适用于多种 vDiT 架构 (CogVideoX, HunyuanVideo, Wan)
局限性
- 仅在三个模型上验证
- 稀疏核需要 Triton/CUDA 实现
- 未与蒸馏或量化方法结合
- 超参数 和 需要调整
九、参考资源
- 论文: arXiv:2506.03065
- 代码: GitHub
- 许可: CC BY 4.0
- 页数: 约 20 页
十、关键公式速查
| 公式 | 说明 |
|---|---|
| 全注意力 | |
| 离线搜索损失 | |
| 模式选择 |
十一、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | vDiT 架构和延迟分析 | x1.png |
| Figure 2 | 注意力图四个交互区域 | x2.png |
| Figure 3 | 四种循环注意力模式 | x3.png |
| Figure 4 | t-SNE 模式聚类可视化 | x4.png |
| Figure 5 | Sparse-vDiT 框架概览 | x5.png |
| Figure 6 | 视觉质量对比 | x6.png |
| Figure 7 | 更多视觉对比结果 | x7.png |
| Figure 8 | 更多视觉对比结果 | x8.png |
| Figure 9 | 更多视觉对比结果 | x9.png |
| Figure 10 | 帧间一致性对比 | x10.png |
| Figure 11 | 帧间一致性对比 | x11.png |