SkyReels-Audio: Omni Audio-Conditioned Talking Portraits in Video Diffusion Transformers
基于预训练视频扩散 Transformer 的全音频条件说话人像生成与编辑统一框架,支持无限长度生成和多模态控制
SkyReels-Audio: Omni Audio-Conditioned Talking Portraits in Video Diffusion Transformers
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SkyReels-Audio: Omni Audio-Conditioned Talking Portraits in Video Diffusion Transformers |
| 作者 | Zhengcong Fei, Hao Jiang, Di Qiu, Baoxuan Gu, Youqiang Zhang, Jiahua Wang, Jialin Bai, Debang Li, Mingyuan Fan, Guibin Chen, Yahui Zhou |
| 机构 | Skywork AI |
| 论文 | https://arxiv.org/abs/2506.00830 |
| 代码 | https://github.com/SkyworkAI/SkyReels-Audio |
| 发布 | 2025-06-01 |
| 许可 | 未明确标注 |
二、核心思想
问题定义
音频驱动的说话人像生成(Talking Portrait Generation)面临三大核心挑战:
- 多模态控制不足:现有方法难以同时利用文本、图像、视频和音频等多种条件进行统一控制
- 长视频生成困难:现有框架在生成长视频时存在误差累积、视觉质量下降和时间不一致问题
- 音频-视觉对齐不精确:唇部同步精度、身份一致性和面部动态真实性难以同时保证
解决方案概述
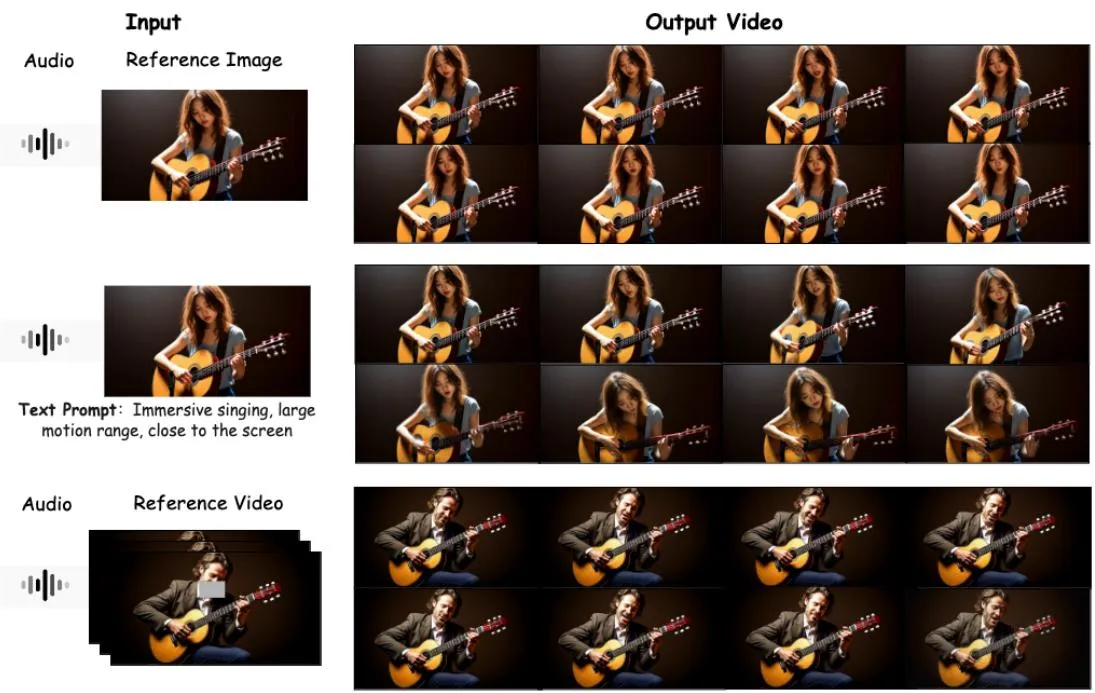
SkyReels-Audio 是一个统一的全音频条件说话人像框架,基于预训练的视频扩散 Transformer(SkyReels-V2),实现:
- 无限长度生成与编辑:通过双向潜在融合(BLF)策略实现无缝长视频生成
- 多模态控制:支持文本、图像、视频和音频的灵活组合输入
- 混合课程学习:渐进式对齐音频与面部运动,实现细粒度多模态控制
- 音频引导 CFG:推理时增强音频同步的条件引导机制
三、技术架构
整体框架
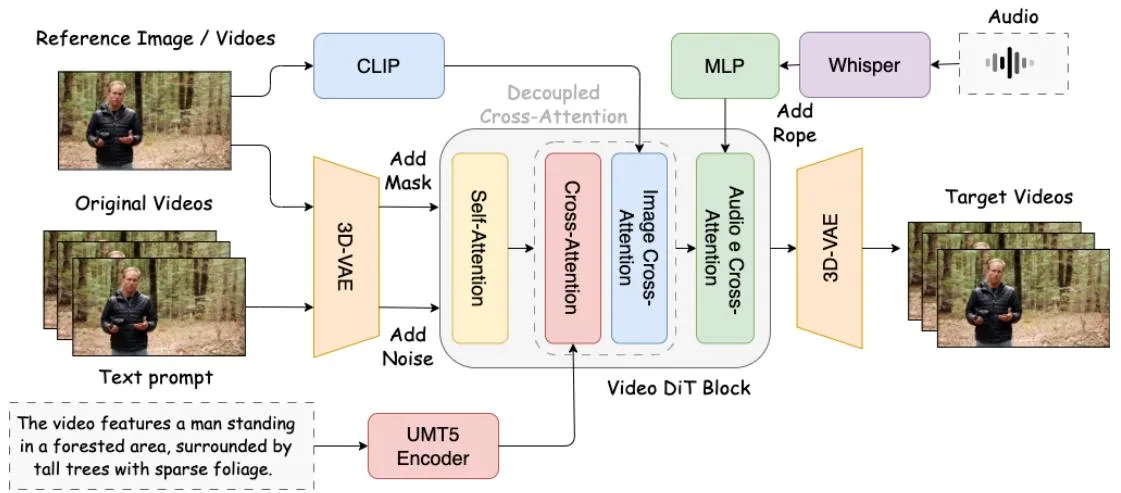
基于 SkyReels-V2 视频扩散 Transformer,通过以下组件实现音频驱动:
核心组件:
- 3D VAE:因果 3D VAE 联合压缩时间轴和空间轴,提取潜在视觉特征
- UMT5 文本编码器:生成语义嵌入,通过交叉注意力注入扩散网络
- Whisper 音频编码器:提取音频特征,通过 1D RoPE 位置编码和交叉注意力融合到视频 DiT 中
- 二进制时间掩码:区分静态图像和动态视频输入,编码模态特定信息
音频条件注入机制:
- Whisper 特征提取器:重采样和特征编码
- Whisper 编码器:获取离散 token 嵌入
- 1D RoPE:增强音频 token 的距离感知关系
- 解耦交叉注意力:音频 token 注入到视频 DiT 的解耦交叉注意力块末尾
核心公式
Flow Matching 训练目标:
L_{mse} = \mathbb{E}_{z_0, z_1, t \sim [0,1]} \left[ \left\| v_t - u_\theta(z_t, t, T_s, I_s, V_s, A) \right\|_2^2 \right] \tag{1}
其中 是可训练去噪网络, 和 分别是训练样本和高斯噪声的潜在嵌入, 是回归目标。
多模态条件:
- :文本提示
- :静态肖像图像
- :参考视频片段
- :驱动音频序列
训练时随机丢弃任一条件以促进鲁棒泛化。
联合损失函数(混合学习策略):
L_{joint} = w_1 * V_m^{downsample} * L_{mse} + w_2 * (1 - V_m^{downsample}) * L_{msk} \tag{2}
其中 是掩码序列,用于区分图像动画和视频编辑任务。
面部掩码损失:
通过 DWPose 提取面部关键点掩码,经三线性插值转换到潜在空间。概率门控机制平衡唇部同步精度和全局视觉保真度。
音频引导条件采样(Audio CFG):
\hat{u}_\theta^{cfg} = (1 + \omega_{audio}) u_\theta(\mathbf{z}_t, t, T_s, I_s, V_s, A) - \omega_{audio} u_\theta(\mathbf{z}_t, t, T_s, I_s, V_s, \emptyset) + (1 + \omega_{text}) u_\theta(\mathbf{z}_t, t, T_s, I_s, V_s, \emptyset) - \omega_{text} u_\theta(\mathbf{z}_t, t, \emptyset, \emptyset, \emptyset, \emptyset) \tag{3}
和 分别是音频和文本的 CFG 权重,采用时间依赖调度动态平衡条件影响。
混合推理策略(视频编辑时):
u_\theta^t = \begin{cases} u_\theta(\mathbf{z}_t, t, T_s, V_s^V, V_M^V, A), & \text{if } t \leq N \\ u_\theta(\mathbf{z}_t, t, T_s, V_s^I, V_M^I, A), & \text{otherwise} \end{cases} \tag{4}
前 N 步使用完整视频输入保持结构一致性,后续切换到图像输入(首帧)细化唇部同步细节。
双向潜在融合(BLF)
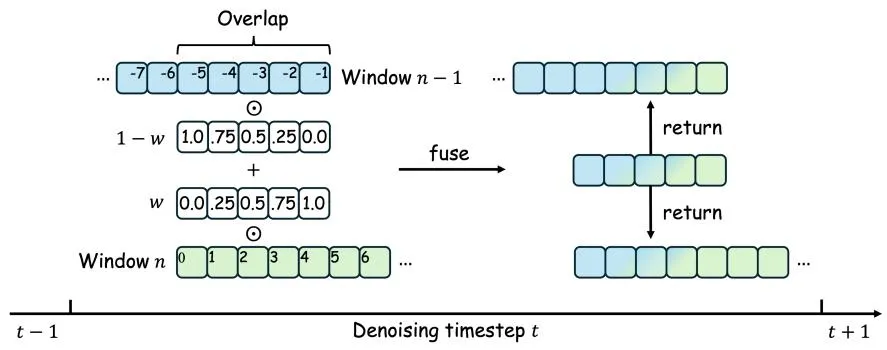
BLF 是免训练的无限视频推理策略,通过重叠滑动窗口双向加权融合相邻窗口的潜在表示:
三个关键阶段:
- 音频重采样:确保与视频帧时间对齐,初始化对应时长的噪声向量
- 加权融合:在同一去噪步内,通过线性插值权重融合重叠区域的潜在表示
- 双向传播:将融合后的潜在表示重新插入两个参与窗口,确保平滑过渡
Algorithm 1:BLF 完整伪代码描述了滑动窗口去噪过程,包括重叠长度 、融合权重 等细节。
优势:
- 免训练(tuning-free)
- 相比无重叠方法:显著减少图像跳跃
- 相比单向融合:更好的时间连续性
- 相比运动帧方法:减少误差累积
混合学习策略
通过掩码区分两种任务:
图像动画任务:
- 输入:参考图像 + 空帧序列
- 掩码:
- 特点:控制信号有限(文本+图像+音频),模型更容易学习音频驱动合成
视频编辑任务:
- 输入:视频首帧(参考)+ 后续帧(DWPose 检测面部关键点,生成下脸边界框掩码)
- 掩码:
- 特点:额外视频控制引入唇部运动与周围区域的依赖,削弱音频控制影响
模型加速
| 技术 | 说明 | 效果 |
|---|---|---|
| TeaCache | 通过潜在表示重用消除冗余去噪步 | 显著减少推理时间 |
| USP | 统一序列并行,支持多 GPU 推理 | 线性加速 |
| CPU 卸载 | TeaCache 计算转移到 CPU | 减少 VRAM 消耗 |
两者可同时激活,80 帧视频生成可在 1 分钟内完成(8×A800 GPU,50 步推理)。
数据流水线
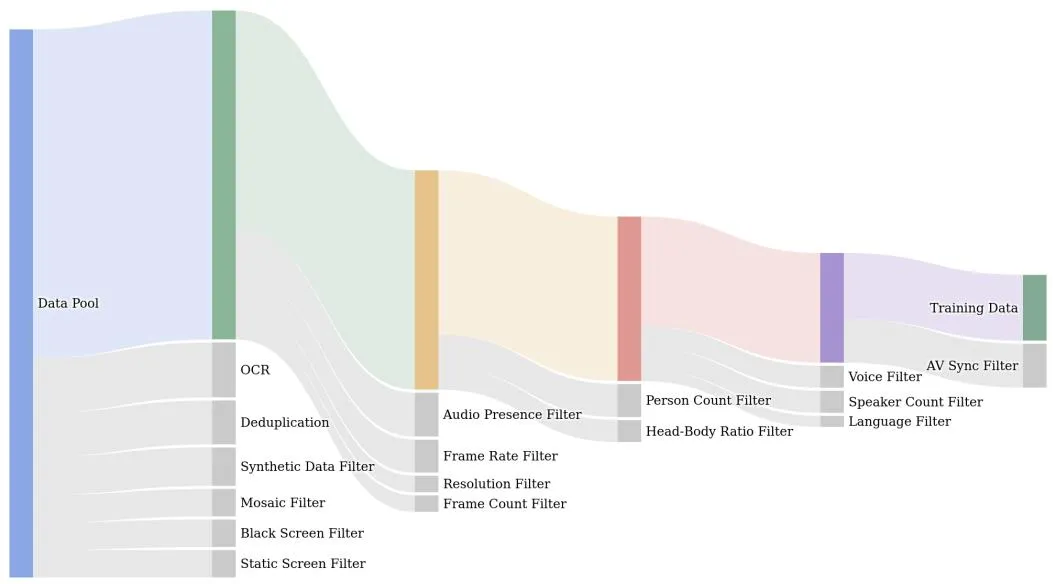
数据规模:原始 10K 小时 → 过滤后 1K 小时
数据来源:OpenHumanVid、Panda-6M、Hallo3 等公开数据集 + 自采数据
多阶段过滤:
- 图像内容:OCR、去重、合成数据过滤、马赛克/黑屏/静态屏幕过滤
- 视频质量:帧率、分辨率、帧数过滤
- 人像质量:人物数量、头身比过滤
- 音频质量:音频存在性、语言过滤
- 音视频同步:同步置信度分数、说话人数量过滤
辅助工具:
- SkyCaptioner-V1:生成描述性标注
- YOLO-World + InsightFace:人体和面部检测
- DWPose:提取姿态特征,计算头身比
- Whisper:识别语音语言
- 同步置信度分数:评估音视频同步
质量控制:每个阶段引入人工标注,确保坏案例率低于 5%。
四、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| 全音频条件框架 | 统一处理图像动画和视频编辑 | 多模态灵活组合控制 |
| 双向潜在融合(BLF) | 免训练的滑动窗口双向融合 | 无限长度生成,平滑过渡 |
| 混合课程学习 | 渐进式对齐音频与面部运动 | 精细唇部同步 |
| 音频引导 CFG | 推理时增强音频同步的条件引导 | 提升音视频一致性 |
| 面部掩码损失 | 概率门控平衡局部精度和全局保真度 | 选择性强调唇部区域 |
| 1D RoPE 音频位置编码 | 增强音频 token 的距离感知 | 改善跨模态对应关系 |
| 混合推理策略 | 前 N 步视频输入 + 后续图像输入 | 结构一致性 + 唇部精度 |
五、代码实现分析
项目结构
SkyReels-Audio/
├── README.md
├── requirements.txt
├── models/                    # 模型权重
├── configs/                   # 配置文件
├── inference/                 # 推理脚本
└── training/                  # 训练代码
训练配置
| 参数 | 值 |
|---|---|
| 优化器 | AdamW |
| 学习率 | 1e-5(恒定) |
| 训练数据 | ~1K 小时(内部数据) |
| GPU | 80× NVIDIA |
| 推理步数 | 50 |
| Audio CFG | 4.5 |
| 条件丢弃率 | 0.15(文本/图像/音频各 15%) |
训练阶段
- 阶段一:仅音频数据训练,建立音频-视觉模态基础对齐
- 阶段二:图像+视频联合训练,提升运动一致性和时间连贯性
六、实验结果
HDTF 数据集定量比较
| 方法 | FID ↓ | FVD ↓ | Sync-C ↑ | Sync-D ↓ | IQA ↑ | ASE ↑ |
|---|---|---|---|---|---|---|
| Hallo3 | 40.12 | 408.12 | 5.75 | 10.12 | 4.03 | 2.65 |
| FantacyTalking | 39.53 | 381.22 | 5.36 | 11.68 | 3.50 | 2.38 |
| SkyReels-Audio | 38.32 | 364.71 | 6.06 | 9.12 | 4.60 | 2.92 |
SkyReels-Audio 在所有指标上均优于开源基线。
Lip Sync 定量比较
| 方法 | FID ↓ | FVD ↓ | Sync-C ↑ | IQA ↑ | AV Consist. ↑ | Visual Quality ↑ |
|---|---|---|---|---|---|---|
| LatenSync | 40.23 | 390.25 | 8.48 | 3.63 | 1.19 | 1.00 |
| SkyReels-Audio | 39.75 | 377.23 | 8.49 | 3.62 | 1.38 | 1.32 |
用户研究:20 名参与者评估,SkyReels-Audio 在音视频一致性和视觉质量上均优于基线。
内部数据集定量比较
| 方法 | Sync-C ↑ | Sync-D ↓ | IQA ↑ | ASE ↑ |
|---|---|---|---|---|
| Hallo3 | 5.53 | 9.33 | 4.13 | 2.80 |
| MagicInfinite | 6.22 | 8.43 | 4.56 | 3.00 |
| OmniHuman-1 | 7.50 | 7.47 | 4.66 | 3.19 |
| FantacyTalking | 3.67 | 10.97 | 4.26 | 2.80 |
| SkyReels-Audio | 6.75 | 8.32 | 4.42 | 2.91 |
SkyReels-Audio 与闭源模型 OmniHuman-1 具有可比性。
消融实验
Audio CFG 影响:
| CFG 值 | Sync-C ↑ | Sync-D ↓ | IQA ↑ | ASE ↑ |
|---|---|---|---|---|
| 1 | 5.78 | 9.65 | 4.58 | 3.02 |
| 3 | 6.30 | 8.78 | 4.45 | 2.91 |
| 4.5(默认) | 6.75 | 8.32 | 4.42 | 2.91 |
随 CFG 增大,音视频一致性提升,但视觉质量略有下降。
Audio RoPE 影响:
| 配置 | Sync-C ↑ | Sync-D ↓ | IQA ↑ | ASE ↑ |
|---|---|---|---|---|
| w/o Audio RoPE | 5.58 | 9.75 | 4.35 | 2.82 |
| w/ Audio RoPE | 6.75 | 8.32 | 4.42 | 2.91 |
位置编码显著提升音频-视觉对齐。
推理加速效果:
| 配置 | 1 GPU | 2 GPU | 4 GPU | 8 GPU |
|---|---|---|---|---|
| w/o TeaCache | 23.62 min | 17.90 min | 7.80 min | 4.29 min |
| w/ TeaCache (α=0.3) | 8.96 min | 7.18 min | 1.88 min | 0.97 min |
TeaCache + USP 组合实现约 24 倍加速(23.62 → 0.97 分钟)。
定性比较
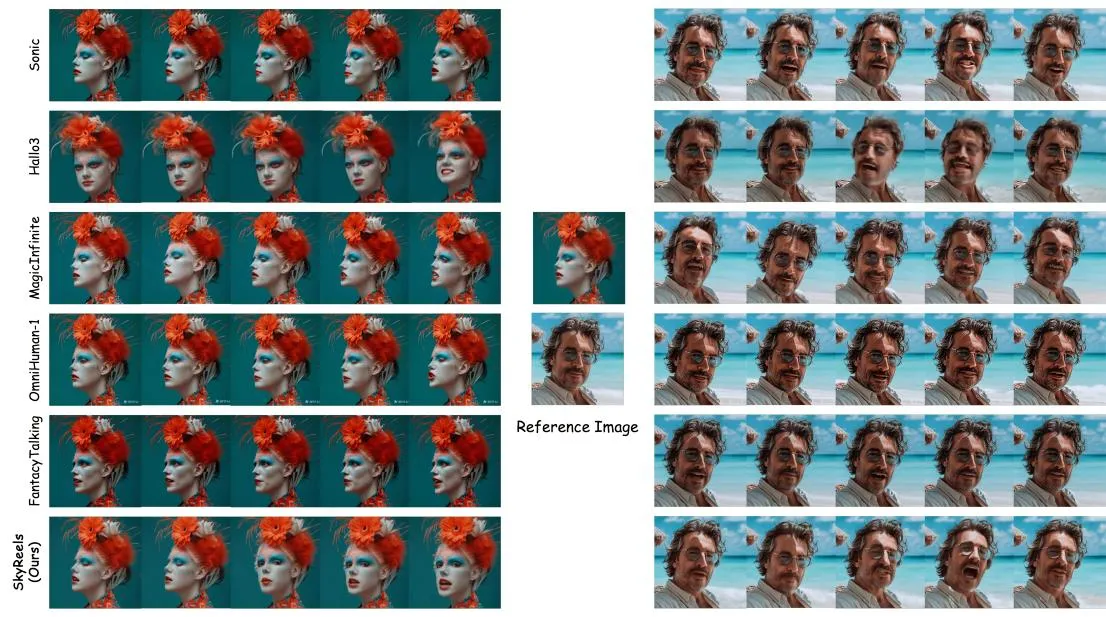
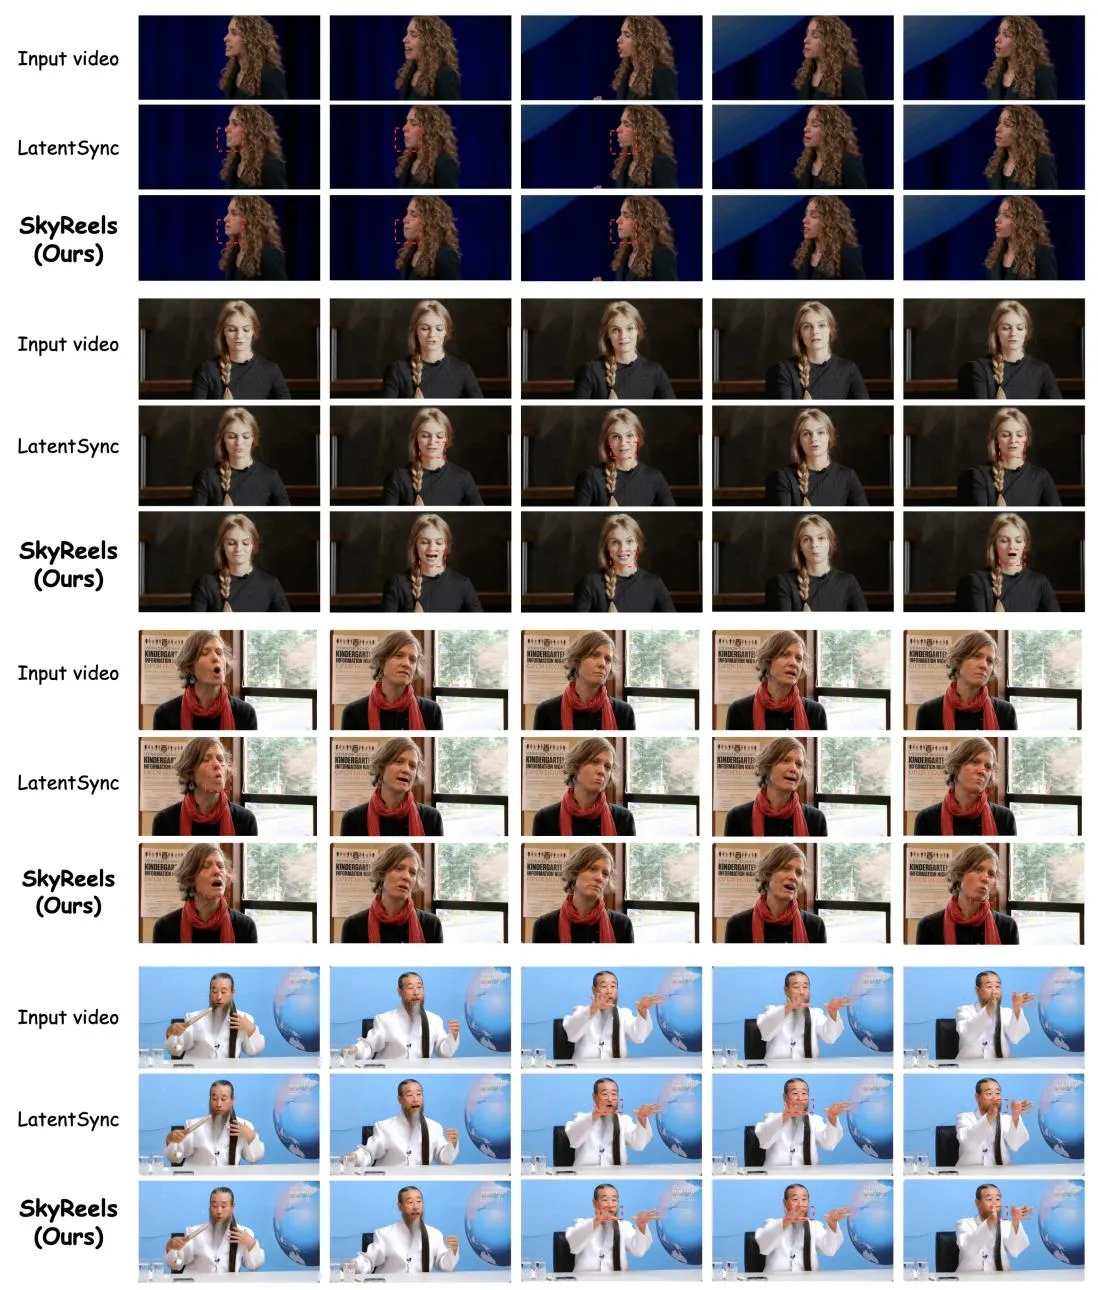
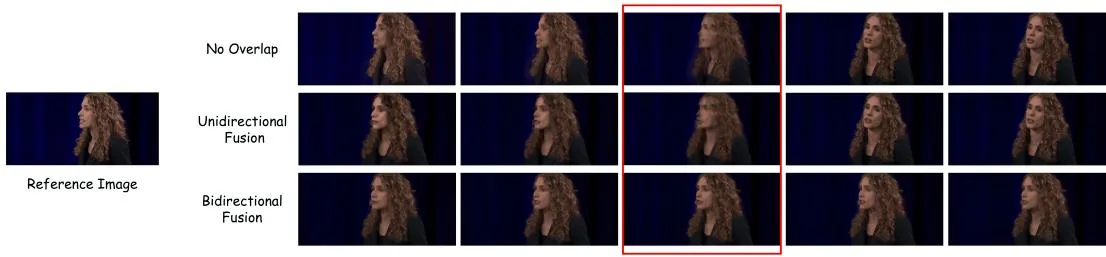
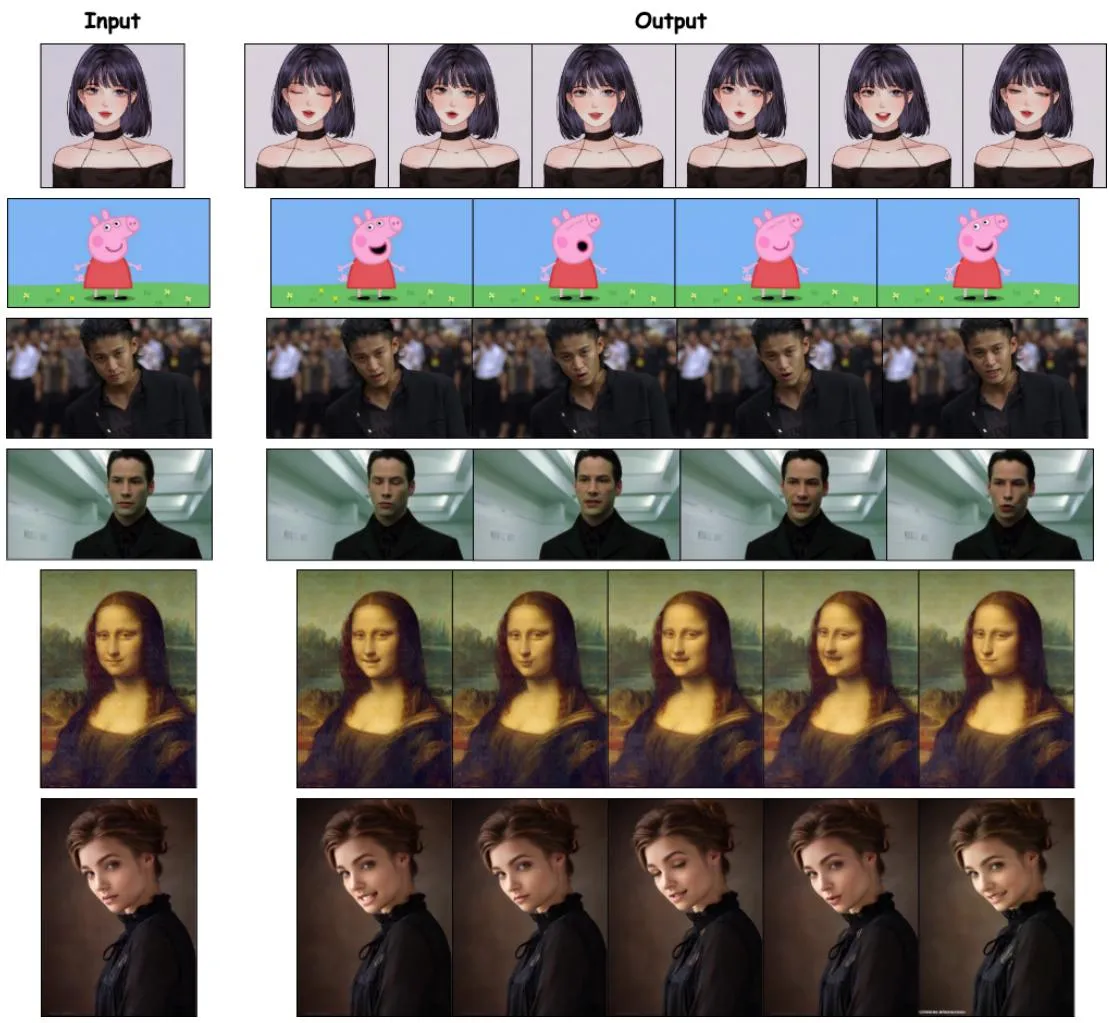
七、相关工作
扩散模型唇部同步
- LatenSync:使用 SyncNet 损失辅助唇部同步
- EMO:音频驱动唇部同步 + 稀疏视觉线索驱动头部动态
- V-Express:音频驱动 + 视觉线索的协同控制
- Hallo3:端到端扩散框架,音频驱动肖像动画
扩散模型肖像动画
- Echomimic / MegActor-Sigma:联合建模视觉和听觉信号
- OmniHuman-1:基于 DiT 的高质量肖像动画
- CogVideoX / HunyuanVideo:3D 全注意力机制的视频生成
SkyReels-Audio 的差异化
- 统一框架:同时支持图像动画和视频编辑
- 无限长度生成:BLF 策略实现免训练的长视频生成
- 音频引导 CFG:推理时增强音频同步
- 混合课程学习:渐进式多模态对齐
八、总结
核心贡献
- 全音频条件框架:基于预训练视频扩散 Transformer 的统一肖像生成和编辑系统
- 双向潜在融合(BLF):免训练的无限视频推理策略,实现时间连续性
- 混合学习范式:结合图像和视频控制的多模态条件,面部区域加权损失
- 高质量数据流水线:精心策划的音视频文本三元组数据集
技术影响
- 数字人应用:为虚拟通信、数字故事、沉浸式教育提供基础技术
- 长视频生成:BLF 策略可推广到其他视频生成任务
- 多模态控制:统一框架展示了多条件灵活组合的可能性
- 推理加速:TeaCache + USP 组合提供高效推理方案
局限性
- 开源缺失:GitHub 仓库尚未公开,代码和模型暂不可用
- 训练数据依赖:需要 1K 小时高质量音视频三元组数据
- 计算资源:训练需要 80×GPU,推理需要多 GPU 加速
- 颜色漂移:长视频推理中观察到图像颜色变暗现象(通过数据质量和后处理缓解)
- 面部多样性:主要针对正面人脸,侧面和极端角度可能效果有限
- 评估基准:内部基准尚未公开,与闭源模型比较有限
九、参考资源
论文
相关工作
- SkyReels-V2: 预训练视频扩散 Transformer 骨干
- SkyCaptioner-V1: 视频标注模型
- Whisper: 音频特征提取和编码
- DWPose: 面部关键点检测
- TeaCache: 推理加速技术
- USP: 统一序列并行
数据集
- OpenHumanVid, Panda-6M, Hallo3 等公开数据集
- 自采数据(未公开)