SageAttention2++: A More Efficient Implementation of SageAttention2
基于 FP8 Matmul + FP16 累加器指令进一步加速 SageAttention2 的注意力量化内核实现,在保持精度的同时取得相对 FlashAttention 最高 3.9× 加速。
SageAttention2++: A More Efficient Implementation of SageAttention2
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SageAttention2++: A More Efficient Implementation of SageAttention2 |
| 作者 | Jintao Zhang, Xiaoming Xu, Jia Wei, Haofeng Huang, Pengle Zhang, Chendong Xiang, Jun Zhu, Jianfei Chen |
| 机构 | 清华大学(THU-ML) |
| 论文 | https://arxiv.org/abs/2505.21136 |
| 代码 | https://github.com/thu-ml/SageAttention |
| 发布 | 2025-05-27(提交),2025-06-06(在线发布) |
| 主题 | Machine Learning (cs.LG); Artificial Intelligence (cs.AI); Hardware Architecture (cs.AR); Computer Vision and Pattern Recognition (cs.CV) |
| 许可 | 论文未明确声明;代码随 SageAttention 仓库开源 |
二、核心思想
问题定义
注意力机制的时间复杂度随序列长度呈二次增长,因此在长序列真实应用中高效实现注意力至关重要。现有降低注意力计算开销的方法主要分为三类:(1) 线性注意力(达到 复杂度);(2) 稀疏注意力(只计算相关上下文);(3) 硬件优化的注意力实现——在保持完整序列计算的同时,通过底层指令与量化获得更高的速度与精度。FlashAttention 系列与 SageAttention 系列属于第三类,且对各类模型与任务的通用性最好。
SageAttention2 通过把注意力中的矩阵乘法(Matmul)用低比特量化来加速:对 用 INT4/INT8、对 用 FP8(E4M3)。其 FP8 Matmul 仍使用 FP32 累加器(mma 指令 mma.f32.f8.f8.f32)。
解决方案概述
SageAttention2++ 在 SageAttention2 的基础上,将 的 FP8 Matmul 改用 FP16 累加器 的更快指令 mma.f16.f8.f8.f16。在 RTX4090/RTX5090 上:
- FP16 输入 + FP32 累加器:1× 基准速度
- FP8 输入 + FP32 累加器:2× 速度
- FP8 输入 + FP16 累加器:4× 速度
即把 FP8 的 2× 增益再叠加 FP16 累加器的 2× 增益。代价是 FP16 动态范围(±65504)远小于 FP32,量化结果可能溢出。为此,SageAttention2++ 通过收窄 FP8 量化范围(重新标定 scale factor)保证累加结果落在 FP16 可表示区间内,从而在精度几乎不变的前提下再获得约 30% 的端到端加速(3.9× vs SageAttention2 的 3×)。
三、技术架构
整体框架
SageAttention2++ 的工作流与 SageAttention2 一致:
输入 Q, K, V
   │
   ├─ Smoothing(Q, K)                # Q/K 平滑(与 SageAttention2 相同)
   │
   ├─ QKᵀ Matmul  ── INT4/INT8 量化 Q,K(per-block)
   │
   └─ PV Matmul   ── FP8(E4M3) 量化 P̃, V
                     └─ 关键改动:使用 mma.f16.f8.f8.f16
                        (FP16 累加器,而非 FP32 累加器)
                     └─ 收窄量化范围:δ_P = |max(P̃)|/P_r, δ_V=|max(V)|/V_r
每个 tile 仍基于 FlashAttention 的分块(tiling)与 online softmax 渐进计算注意力。相对 SageAttention2 的唯一核心差异在 这一步的 MMA 指令与对应量化策略。
核心公式
SageAttention2 的量化 scale(per-block 对 ,per-channel 对 ):
反量化还原:
SageAttention2++ 的关键约束——为保证 FP16 累加结果不溢出(FP16 范围 ±65504,32 个乘积累加):
例如取 即可满足。据此收窄 的量化范围(调整 scale factor,使量化值落在更窄区间内):
其中约束 (因为 )。
模型组件与变体
| 组件 / 变体 | 说明 | 关键参数 |
|---|---|---|
| SageAttn2++(8+8) | 对 用 INT8,对 用 FP8(E4M3) | :INT8;:FP8 |
| SageAttn2++(4+8) | 对 用 INT4,对 用 FP8(E4M3) | :INT4;:FP8 |
| MMA 指令 | 的 FP8 Matmul | mma.f16.f8.f8.f16(FP16 累加) |
| MMA 规格 | 单次 MMA 的形状 | mma.m16n8k32(32 个乘积在 FP16 中累加) |
训练流程
本文为推理期注意力内核实现,无训练过程。实现基于 CUDA,针对 RTX4090 / RTX5090(Ada / Blackwell 架构,均支持 FP8 Tensor Core)做了指令级优化。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| FP16 累加的 FP8 Matmul | 将 的 FP8 Matmul 由 FP32 累加(mma.f32.f8.f8.f32)改为 FP16 累加(mma.f16.f8.f8.f16),指令本身快 2× | 表 1:FP8+FP16 累加相对 FP16+FP32 累计达 4× 加速 |
| 量化范围收窄 | 通过重新标定 (公式 2)保证 32 个乘积的 FP16 累加不溢出 | 约束 $ |
| 精度无损加速 | 在更窄量化范围内保持与 SageAttention2 相同的注意力精度 | 表 2:CogvideoX 上 Cossim 均为 99.97%,L1 一致(0.01862/0.01863) |
五、代码实现分析
- 仓库:https://github.com/thu-ml/SageAttention(SageAttention 系列统一仓库,SageAttention2++ 作为新变体合入)
- 语言/平台:CUDA 内核实现,面向 NVIDIA RTX4090(Ada Lovelace)与 RTX5090(Blackwell)
- 关键指令:
mma.m16n8k32形状的 FP8 Tensor Core MMA,使用 FP16 累加器 - 实现要点:
- 复用 SageAttention2 的 平滑(smoothing)与分块策略;
- 在 阶段切换 MMA 指令并应用收窄后的 scale factor;
- 提供 (8+8) 与 (4+8) 两种比特配置变体。
六、实验结果
基准测试
表 1(Preliminary):不同 Matmul 配置相对 FP16+FP32 的加速(RTX4090/RTX5090)
| GPU | MM Input | MM Accumulator | Speedup |
|---|---|---|---|
| RTX4090, RTX5090 | FP16 | FP32 | 1× |
| RTX4090, RTX5090 | FP8 | FP32 | 2× |
| RTX4090, RTX5090 | FP8 | FP16 | 4× |
表 2:CogvideoX 各注意力层平均精度(量化范围收窄后的精度保持)
| Method | Cossim ↑ | L1 ↓ | ||
|---|---|---|---|---|
| SageAttn2 | 448 | 448 | 99.97% | 0.01862 |
| SageAttn2++ | 112 | 4.5 | 99.97% | 0.01862 |
| SageAttn2++ | 56 | 9 | 99.97% | 0.01863 |
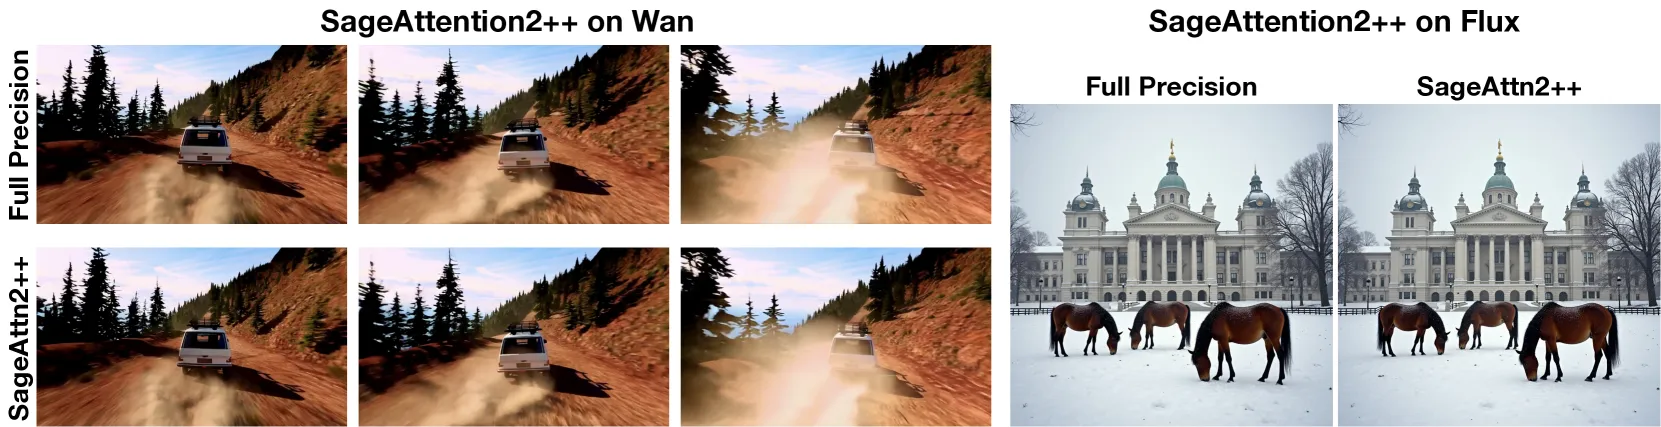
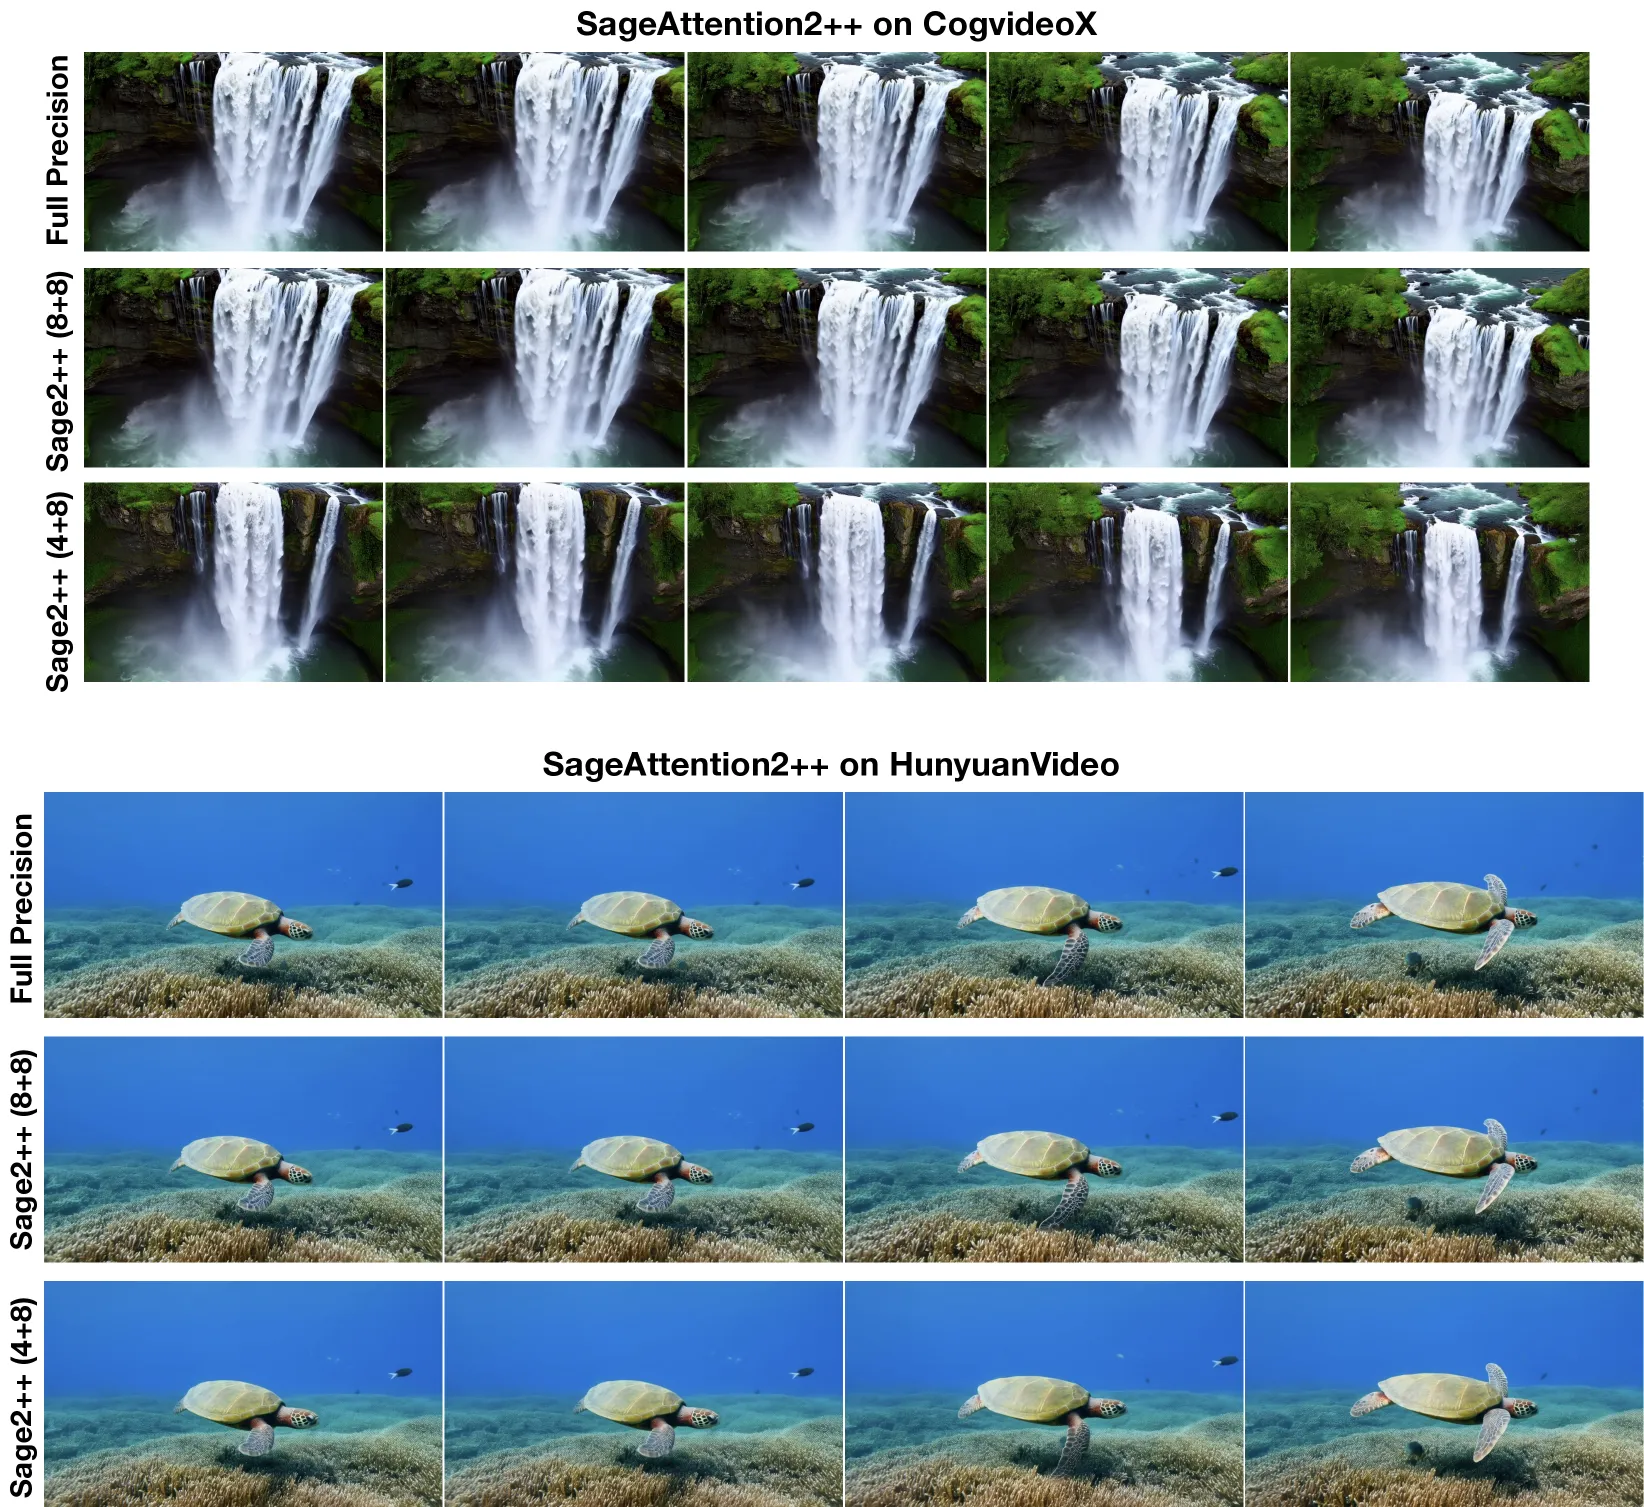
主要结果:SageAttention2++ 相对 FlashAttention2 最高取得 3.9× 加速(SageAttention2 为 3×),并持续优于 SageAttention 与 SageAttention2 的计算效率;端到端指标在多种架构上几乎无损失。
速度对比(RTX4090 / RTX5090,headdim=128 与 64):
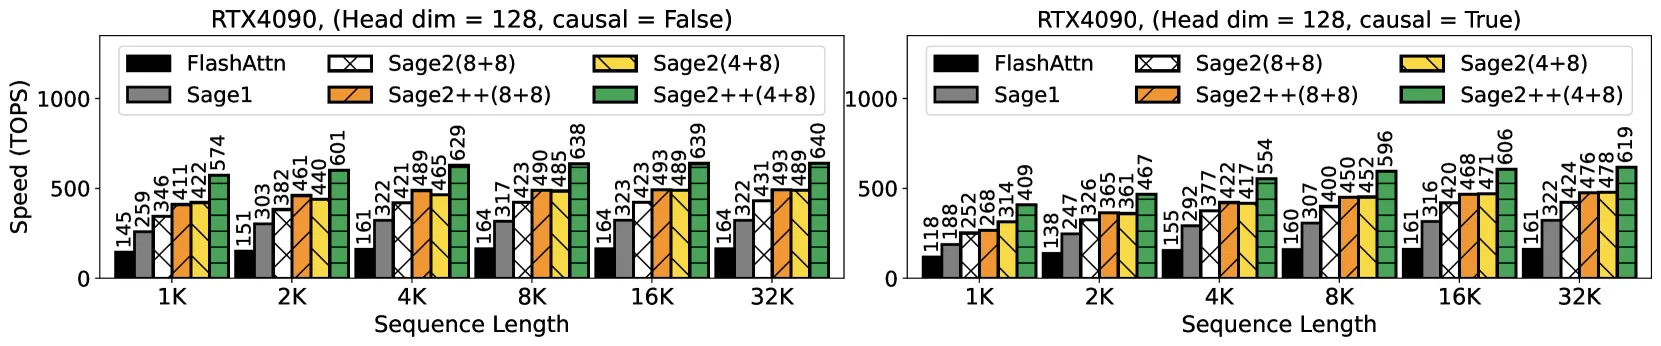
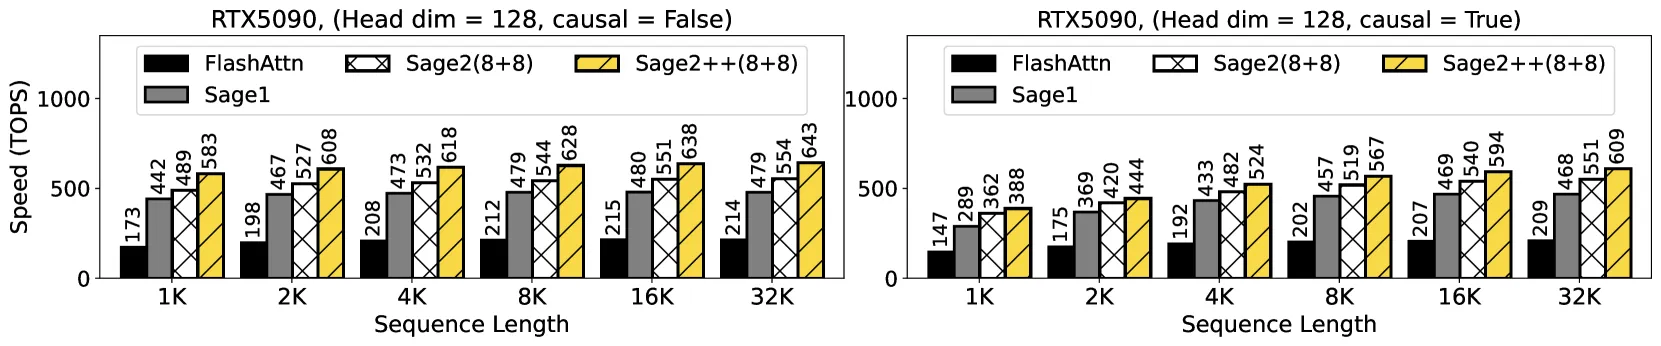
表 3:文本/图像/视频生成模型的端到端指标(节选核心行)
文本(Llama3.1 8B,越低越好 Ppl.,越高越好 Acc.)
| Attention | WikiText (Ppl.) ↓ | Lambda (Acc.) ↑ | NIAH (Acc.) ↑ |
|---|---|---|---|
| Full-Precision | 6.013 | 0.815 | 0.906 |
| SageAttn2(8+8) | 6.019 | 0.811 | 0.903 |
| SageAttn2++(8+8) | 6.020 | 0.813 | 0.901 |
视频(HunyuanVideo,CLIPSIM/CLIP-T↑,VQA-a/VQA-t/FScore↑)
| Attention | CLIPSIM ↑ | CLIP-T ↑ | VQA-a ↑ | VQA-t ↑ | FScore ↑ |
|---|---|---|---|---|---|
| Full-Precision | 0.175 | 0.999 | 77.437 | 52.731 | 1.169 |
| SageAttn2(8+8) | 0.175 | 0.999 | 78.145 | 54.878 | 1.176 |
| SageAttn2++(8+8) | 0.175 | 0.999 | 78.569 | 51.080 | 1.192 |
图像(Flux,FID/sFID↓,CLIP/IR↑)
| Attention | FID ↓ | sFID ↓ | CLIP ↑ | IR ↑ |
|---|---|---|---|---|
| Full-Precision | 165.117 | 147.831 | 31.401 | 0.912 |
| SageAttn2(8+8) | 163.185 | 146.101 | 31.453 | 0.905 |
| SageAttn2++(8+8) | 163.555 | 146.036 | 31.445 | 0.902 |
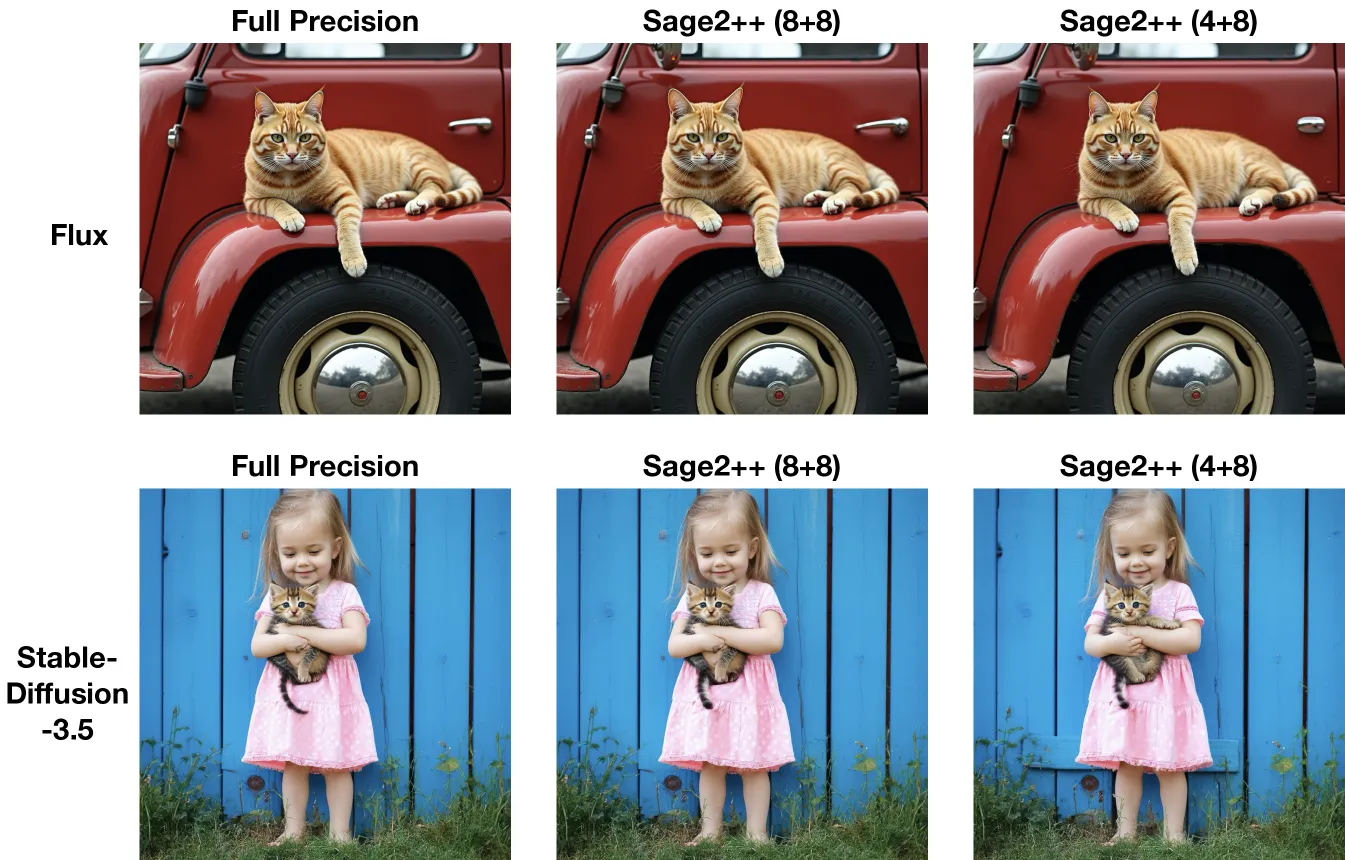
结论:SageAttn2++(8+8) 在大幅加速的同时,各端到端指标与 Full-Precision / SageAttn2 基本一致(差异在千分位级别)。
消融实验
- 量化范围收窄的有效性:表 2 显示,即便把 从 448 收窄到 112、 从 448 收窄到 4.5(或 56/9),CogvideoX 的注意力 Cossim 仍保持 99.97%,L1 误差与 SageAttn2 完全相同(0.01862),证明收窄范围未引入精度损失。
- (8+8) vs (4+8):INT4 版 (4+8) 在部分视频任务(如 Wan 的 VQA-a)上指标略低于 INT8 版 (8+8),但在精度敏感场景仍接近 Full-Precision。
与现有方法对比
| 方法 | 相对 FlashAttention2 加速 | 注意力精度(CogvideoX Cossim) | 硬件 |
|---|---|---|---|
| FlashAttention2 | 1× | 基准 | RTX4090/5090 |
| FlashAttention3 | — | — | 仅 Hopper(不可用) |
| SageAttention | < SageAttn2 | — | RTX4090/5090 |
| SageAttention2 | 3× | 99.97% | RTX4090/5090 |
| SageAttention2++ | 3.9× | 99.97%(相同) | RTX4090/5090 |
七、相关工作
- 线性 / 稀疏注意力(如 Linear Attention、NSA、滑动窗口):将复杂度降到亚二次,但跨模型/任务的通用性有限。
- FlashAttention / FlashAttention2 / FlashAttention3:基于 IO 感知分块与 online softmax 的精确注意力,无量化;FA3 仅 Hopper。
- xFormers:融合注意力内核库。
- SageAttention 系列(SageAttn / SageAttn2):基于分块 + 量化的硬件优化注意力,SageAttention2++ 是其更激进的 FP8+FP16 累加实现。
八、总结
核心贡献
- 提出 SageAttention2++:将 的 FP8 Matmul 改用 FP16 累加器指令
mma.f16.f8.f8.f16,相对 SageAttention2 的 FP32 累加再快约 2×。 - 给出量化范围收窄方案(公式 1–2),保证 FP16 累加不溢出,且精度与 SageAttention2 完全一致。
- 在 RTX4090/RTX5090 上取得相对 FlashAttention2 最高 3.9× 加速(SageAttention2 为 3×),端到端指标在语言/图像/视频生成模型上几乎无损。
技术影响
为消费级与数据中心 GPU(Ada/Blackwell)上的注意力推理提供即插即用的高效内核;FP8+FP16 累加的思路可推广到其它低比特 Matmul 算子,对长序列、视频/图像生成等算力敏感场景价值显著。
局限性
- 仅在 RTX4090/RTX5090(支持 FP8 Tensor Core)上验证;更老架构(无 FP8)不适用。
- 依赖 SageAttention2 已有的 平滑与分块策略,未改变 阶段的 INT 量化。
- 论文较短(技术报告风格),缺少与更多基线(如 FP4 路径)及更大规模训练的对比。
九、参考资源
- 论文:https://arxiv.org/abs/2505.21136
- HTML 全文:https://arxiv.org/html/2505.21136v1
- 代码:https://github.com/thu-ml/SageAttention
- 前作 SageAttention2:arXiv:2502.11419(Zhang et al., 2025a)
- 评估模型:Llama3.1-8B、CogvideoX-2B、HunyuanVideo、Wan、Flux、Stable-Diffusion3.5
定性示例