SkyReels-V2: Infinite-length Film Generative Model
首个开源无限长度视频生成模型,融合 MLLM 结构化描述、多阶段预训练、运动质量强化学习和 Diffusion Forcing 框架,在 V-Bench 上达到开源模型最高分
SkyReels-V2: Infinite-length Film Generative Model
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SkyReels-V2: Infinite-length Film Generative Model |
| 作者 | Guibin Chen, Dixuan Lin, Jiangping Yang, Chunze Lin, Junchen Zhu, Mingyuan Fan, Hao Zhang, Sheng Chen, Zheng Chen, Chengcheng Ma, Weiming Xiong, Wei Wang, Nuo Pang, Kang Kang, Zhiheng Xu, Yuzhe Jin, Yupeng Liang, Yubing Song, Peng Zhao, Boyuan Xu, Di Qiu, Debang Li, Zhengcong Fei, Yang Li, Yahui Zhou |
| 机构 | Skywork AI |
| 论文 | https://arxiv.org/abs/2504.13074 |
| 代码 | https://github.com/SkyworkAI/SkyReels-V2 |
| 发布 | 2025-04-17 (v3: 2025-04-21) |
| 许可 | 未明确标注 |
二、核心思想
问题定义
视频生成领域面临四个核心挑战,现有方法难以同时解决:
- 运动质量与视觉质量的矛盾:提升时域视觉质量时往往牺牲运动动态性
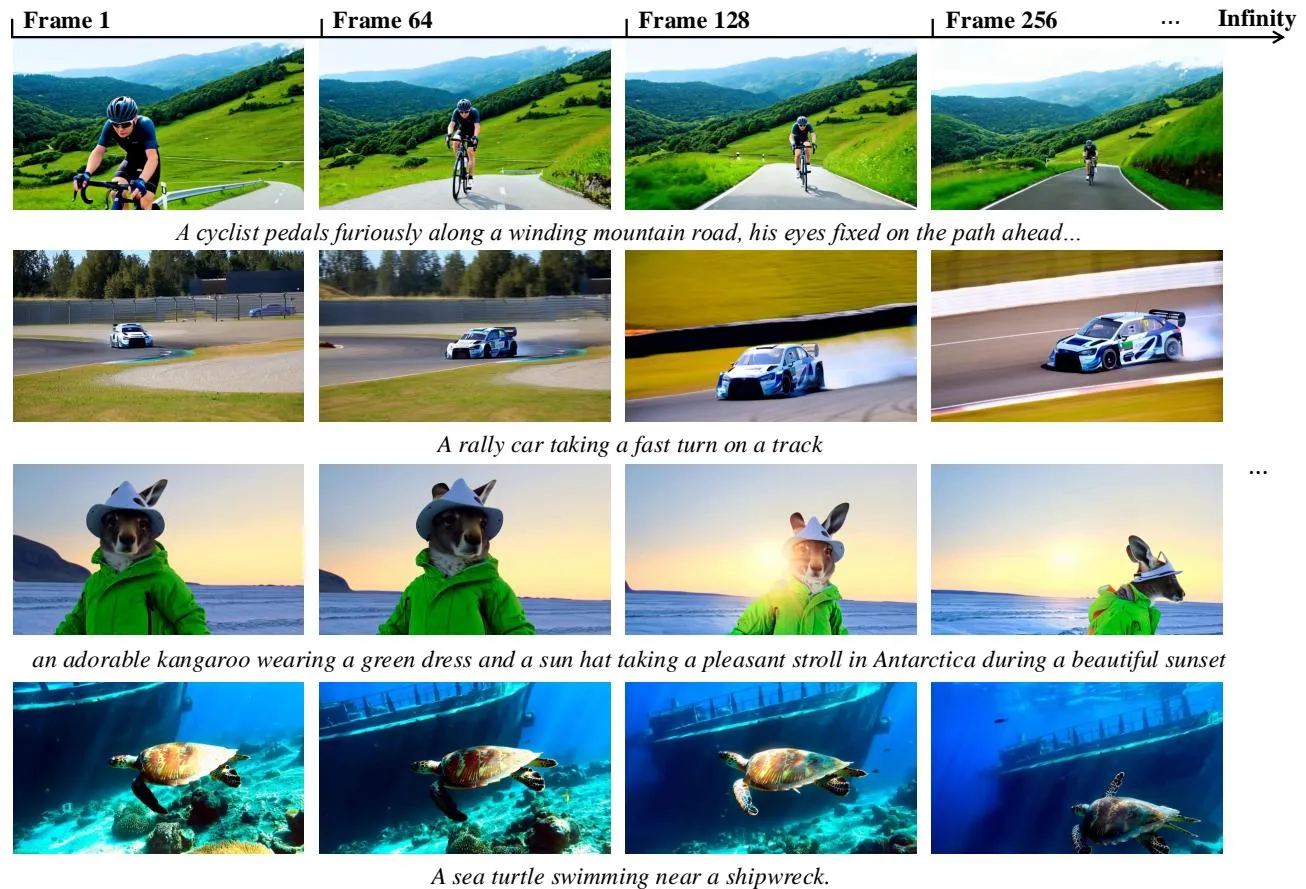
- 视频时长受限:为保证分辨率,视频被限制在 5-10 秒
- 镜头语言理解不足:通用 MLLM 无法准确解读镜头构图、演员表情、摄影机运动等电影语法
- 自回归与扩散的割裂:纯扩散模型时域不连续,纯自回归模型误差累积,两者无法产生长视频
解决方案概述
SkyReels-V2 是首个开源无限长度视频生成模型,核心创新在于四大技术的协同:
- SkyCaptioner-V1:结合通用 MLLM 和子专家模型的结构化视频描述器,大幅提升镜头语言理解
- 多阶段渐进预训练:从 256p → 360p → 540p 逐步提升分辨率,建立扎实的生成基础
- 运动质量强化学习:基于半自动偏好数据的 DPO 训练,专门提升运动动态性
- Diffusion Forcing 框架:将全序列扩散模型微调为 Diffusion Forcing 模型,解锁无限长度生成
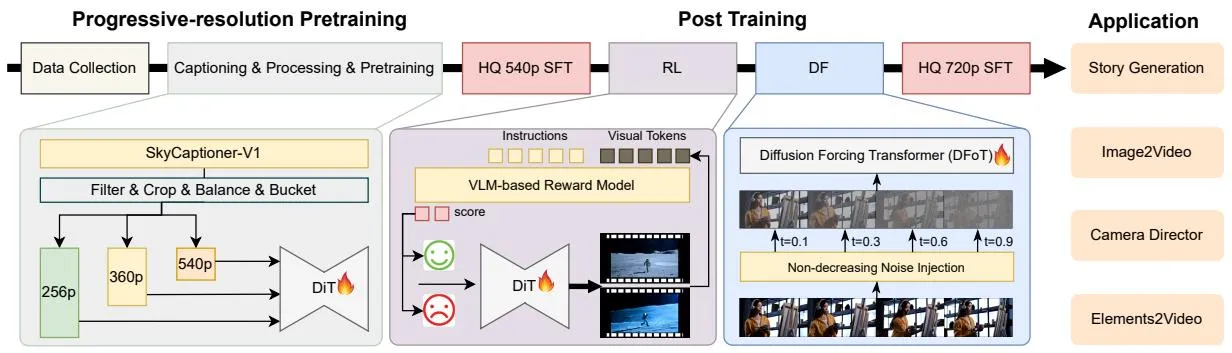
三、技术架构
整体训练流程
训练流程分为两大阶段:
预训练阶段:
- 数据采集与处理(Data Collection)
- 结构化描述与预训练(Captioning & Processing & Pretraining)
后训练阶段:
- 高质量 540p SFT(概念均衡)
- 运动质量强化学习(RL)
- Diffusion Forcing 训练
- 高质量 720p SFT
数据处理流水线
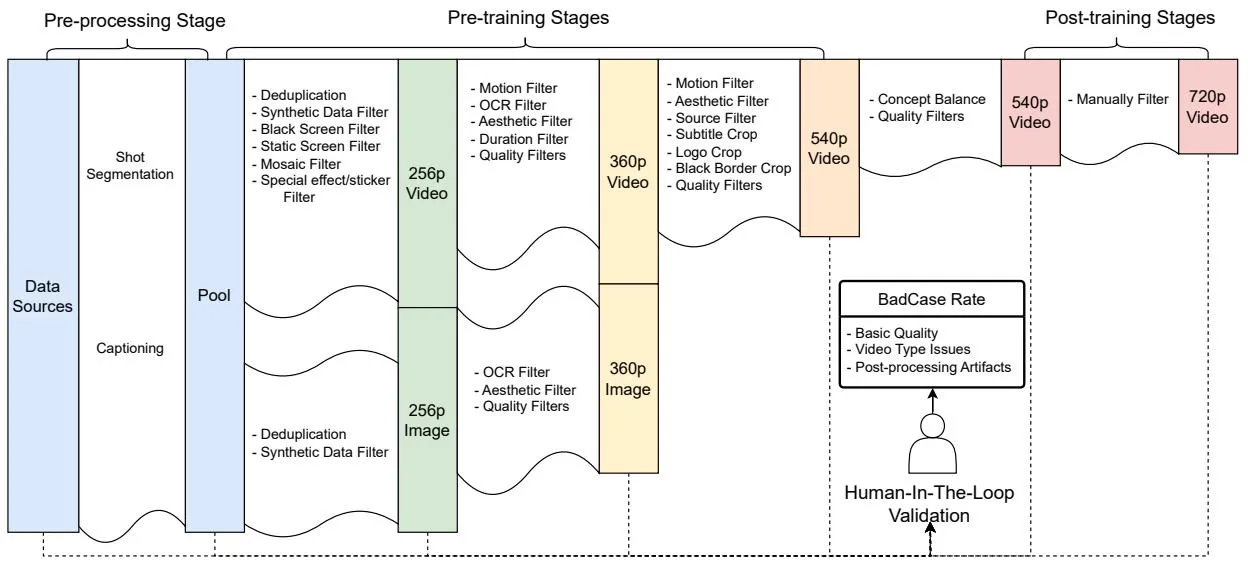
数据处理采用渐进式过滤策略,从宽松到严格:
| 阶段 | 分辨率 | 过滤策略 |
|---|---|---|
| 预处理 | 原始 | 去重、合成数据过滤、黑屏/静态/马赛克过滤、OCR/美学/质量过滤 |
| 预训练 Stage1 | 256p | 联合图像-视频训练,严格质量过滤 |
| 预训练 Stage2 | 360p | 增加时长/运动/OCR/美学/质量过滤 |
| 预训练 Stage3 | 540p | 仅视频目标,更严格的运动/美学/质量过滤 |
| 后训练 | 540p/720p | 概念均衡 + 人工筛选 |
数据规模:
- 原始数据:O(100M) 规模
- 来源:开源数据集(Koala-36M、HumanVid)+ 自采 280K+ 电影 / 800K+ 电视剧(6.2M+ 小时)
- 概念均衡图像:O(100M) 用于早期训练
字幕与 Logo 裁剪
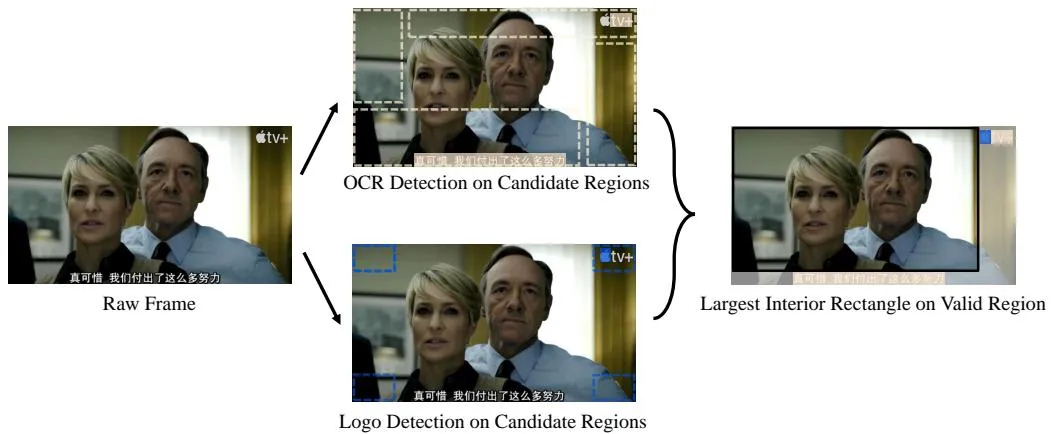
针对电影/电视剧训练数据中的字幕和 Logo 问题:
- 字幕检测:在候选区域(顶部 20%、底部 40%、左右各 20%)使用 CRAFT 模型进行 OCR 检测
- Logo 检测:在四角区域(各 15%)使用 MiniCPM-o 模型检测
- 最大内矩形裁剪:基于单调栈算法找到最大内矩形,若覆盖原始帧 80% 以上面积则裁剪
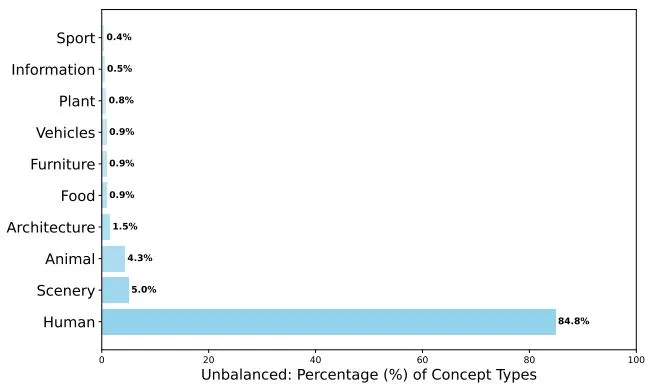
概念均衡
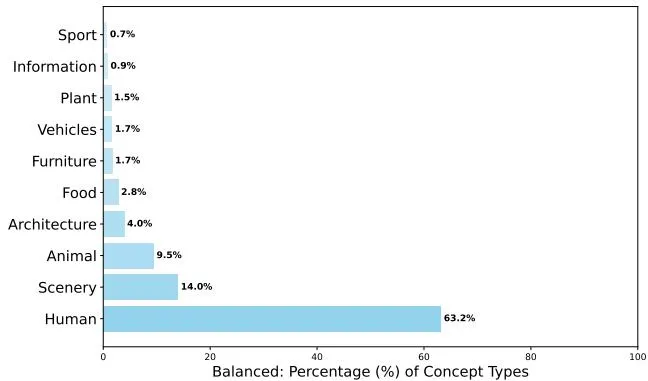
均衡前后对比:
| 类型 | 均衡前 | 均衡后 |
|---|---|---|
| Human | 84.8% | 63.2% |
| Scenery | 5.0% | 14.0% |
| Animal | 4.3% | 9.5% |
| Architecture | 1.5% | 4.0% |
| 其他 | 4.4% | 9.3% |
结构化视频描述器(SkyCaptioner-V1)
结构化描述包含两个核心维度:
1. 主体信息(Subjects):
- 类型层级:Human → Woman, Animal → Mammal 等
- 属性描述:外观、动作、表情、位置
- 主次区分:is_main_subject 标志
2. 镜头元数据(Shot Metadata):
- 景别:close-up, medium shot, long shot, full shot
- 角度:eye level, high angle, low angle
- 位置:front view, back view, over the shoulder 等
- 摄影机运动、环境、光照
子专家模型:
| 模型 | 任务 | 准确率 |
|---|---|---|
| Shot Type Classifier | 景别分类 | 82.2% |
| Shot Angle Classifier | 角度分类 | 78.7% |
| Shot Position Classifier | 位置分类 | 93.1% |
| Emotion Classifier | 表情分类 | 85% |
| Camera Motion Classifier | 运动分类 | 89%(单类型) |
SkyCaptioner-V1 性能对比:
| 模型 | 平均准确率 | 景别 | 角度 | 位置 | 摄影机运动 |
|---|---|---|---|---|---|
| Qwen2.5-VL-7B | 51.4% | 76.8% | 60.0% | 28.4% | 62.0% |
| Qwen2.5-VL-72B | 58.7% | 82.5% | 73.7% | 32.7% | 61.2% |
| Tarsier2-recap-7B | 49.4% | 60.2% | 52.4% | 23.6% | 45.3% |
| SkyCaptioner-V1 | 76.3% | 93.7% | 89.8% | 83.1% | 85.3% |
训练配置:基于 Qwen2.5-VL-7B-Instruct,64×A800 GPU,全局 batch 512,lr=1e-5,2 epochs。
多阶段预训练
基于 Wan2.1 架构,仅从头训练 DiT,保留预训练的 VAE 和文本编码器。使用 Flow Matching 框架:
训练目标(Flow Matching):
\mathbf{x}_t = t\mathbf{x}_1 + (1-t)\mathbf{x}_0 \tag{1}
\mathbf{v}_t = \frac{d\mathbf{x}_t}{dt} = \mathbf{x}_1 - \mathbf{x}_0 \tag{2}
\mathcal{L} = \mathbb{E}_{t, \mathbf{x}_0, \mathbf{x}_1, \mathbf{c}} \left[ \| \mathbf{u}_\theta(\mathbf{x}_t, \mathbf{c}, t) - \mathbf{v}_t \|^2 \right] \tag{3}
预训练设置:
- 优化器:AdamW
- Stage 1 (256p):lr=1e-4 → 5e-5,weight decay 0 → 1e-4
- Stage 2-3 (360p/540p):lr=2e-5
- 双轴 Bucketing 框架:时间长度 × 空间宽高比矩阵
- FPS 归一化:学习频率嵌入 + 自适应降采样
后训练阶段
运动质量强化学习
针对两种核心失败模式:
- 大幅度可变形运动处理不佳
- 违反物理规律
偏好数据收集(半自动流水线):
- 人工标注:30K 样本对,专业标注者评估运动质量
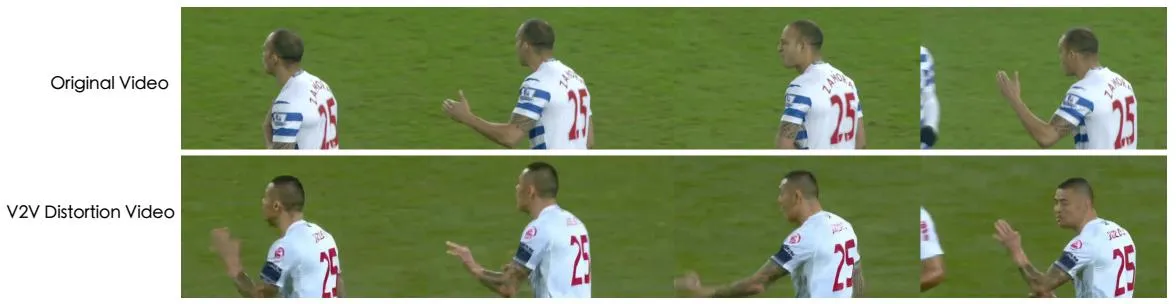
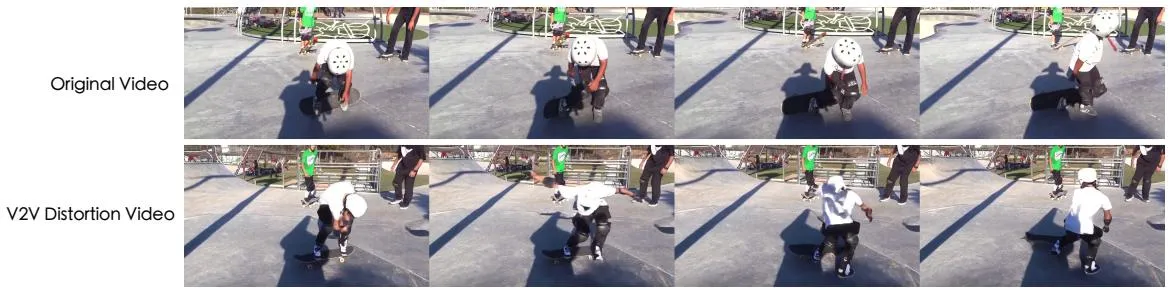
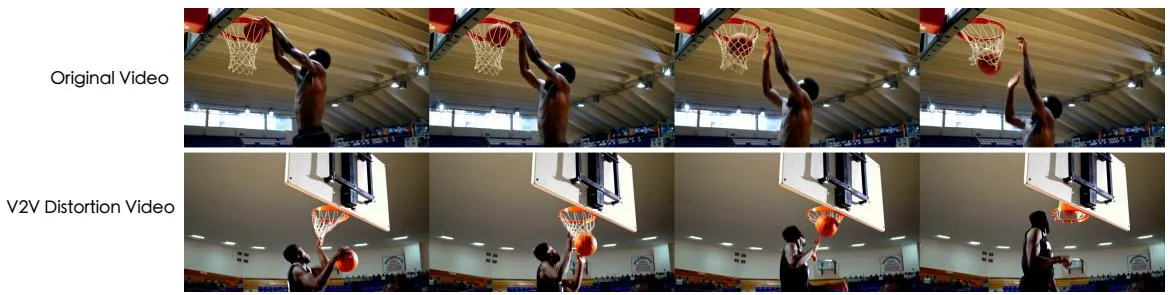
- 自动数据增强:渐进式失真创建
| 失真类型 | 方法 | 失真程度 |
|---|---|---|
| V2V | 直接噪声潜变量反转 | 最低 |
| I2V | 首帧引导重建 | 中等 |
| T2V | 文本描述重新生成 | 最高 |
还使用 Tea-Cache 方法注入噪声、视频倒放等技术模拟各种失败案例。
奖励模型训练:
基于 Qwen2.5-VL-7B-Instruct,使用 Bradley-Terry with Ties (BTT) 损失:
DPO 训练(Flow-DPO):
\mathcal{L}_{\text{DPO}} = -\frac{1}{N} \sum_{i=1}^{N} \log \sigma \left(-\frac{\beta}{2} \left[ \Delta_{\text{model}} - \Delta_{\text{ref}} \right]\right) \tag{4}
其中:
训练分 3 阶段进行,每阶段 20K 数据,当模型容易区分 chosen/rejected 时刷新参考模型。
Diffusion Forcing 训练
Diffusion Forcing 为每个 token 分配独立噪声级别,通过因果注意力实现无限长度扩展。
FoPP 时间步调度器(Frame-oriented Probability Propagation):
- 均匀采样帧索引 和时间步
- 动态规划计算概率传播
- 非递减约束下的转移方程:
- 访问概率计算与时间步采样
AD 调度器(Adaptive Difference,推理时使用):
- 同步扩散:(所有帧相同时间步)
- 自回归生成:(逐帧递增)
- 较小 :相邻帧更相似
- 较大 :内容变化更大
因果注意力优化:训练时使用双向注意力,推理时切换为因果注意力,支持 KV 缓存,显著降低计算开销。
高质量 SFT
两个阶段:
- 540p SFT:概念均衡数据,移除 FPS 嵌入,为后续阶段建立优化初始化
- 720p SFT:Diffusion Forcing 之后,提升生成分辨率
四、核心创新
| 创新点 | 说明 | 关键优势 |
|---|---|---|
| 结构化视频描述 | 结合 MLLM 和子专家模型的多维度描述 | 镜头语言准确率大幅提升(28% → 83%) |
| SkyCaptioner-V1 | 知识蒸馏的统一描述模型 | 平均准确率 76.3%,超越所有基线 |
| 运动质量 RL | 半自动偏好数据 + DPO 训练 | 专门解决运动失真和物理违反 |
| Diffusion Forcing | 全序列扩散微调为 DF 模型 | 解锁无限长度视频生成 |
| 渐进预训练 | 256p → 360p → 540p 三阶段 | 稳定训练,逐步提升质量 |
| 概念均衡 | 50% 数据量减少,类别分布均衡 | 避免模型偏向高频类别 |
五、代码实现分析
项目结构
SkyReels-V2/
├── generate_video_df.py          # Diffusion Forcing 视频生成
├── requirements.txt              # 依赖
├── README.md
└── models/                       # 模型权重
模型系列
| 类型 | 模型 | 分辨率 | 帧数 | 状态 |
|---|---|---|---|---|
| Diffusion Forcing | 1.3B-540P | 544×960 | 97f | 已发布 |
| Diffusion Forcing | 14B-540P | 544×960 | 97f | 已发布 |
| Diffusion Forcing | 14B-720P | 720×1280 | 121f | 已发布 |
| Text-to-Video | 14B-540P | 544×960 | 97f | 已发布 |
| Text-to-Video | 14B-720P | 720×1280 | 121f | 已发布 |
| Image-to-Video | 1.3B/14B | 多分辨率 | 多帧数 | 已发布 |
| Camera Director | 14B-720P | 720×1280 | - | 即将发布 |
推理优化
| 技术 | 加速比 | 说明 |
|---|---|---|
| FP8 量化(线性层) | 1.10× | 动态量化 + GEMM 加速 |
| sageAttn2-8bit | 1.30× | 注意力层量化 |
| 多 GPU 并行 | 1.8× | 4→8 GPU,Content/CFG/VAE 并行 |
| DMD 蒸馏 | 显著 | 4 步生成,替代 30-50 步采样 |
单 GPU 部署:RTX 4090 (24GB) + FP8 量化 + 参数级 offloading,支持 720p 生成。
六、实验结果
SkyReels-Bench 人工评估(T2V)
| 模型 | 平均 | 指令遵循 | 一致性 | 视觉质量 | 运动质量 |
|---|---|---|---|---|---|
| Runway-Gen3 Alpha | 2.53 | 2.19 | 2.57 | 3.23 | 2.11 |
| HunyuanVideo-13B | 2.82 | 2.64 | 2.81 | 3.20 | 2.61 |
| Kling-1.6 STD | 2.99 | 2.77 | 3.05 | 3.39 | 2.76 |
| Hailuo-01 | 3.0 | 2.8 | 3.08 | 3.29 | 2.74 |
| Wan2.1-14B | 3.12 | 2.91 | 3.31 | 3.54 | 2.71 |
| SkyReels-V2 | 3.14 | 3.15 | 3.35 | 3.34 | 2.74 |
关键发现:SkyReels-V2 在指令遵循(3.15)和一致性(3.35)上达到最优,视觉质量略低于 Wan2.1。
V-Bench 1.0 自动评估(T2V)
| 模型 | 总分 | 质量分 | 语义分 |
|---|---|---|---|
| CogVideoX1.5-5B | 80.3% | 80.9% | 77.9% |
| OpenSora-2.0 | 81.5% | 82.1% | 78.2% |
| HunyuanVideo-13B | 82.7% | 84.4% | 76.2% |
| Wan2.1-14B | 83.7% | 84.2% | 81.4% |
| SkyReels-V2 | 83.9% | 84.7% | 80.8% |
SkyReels-V2 在 V-Bench 上达到开源模型最高总分(83.9%)和质量分(84.7%)。
Image-to-Video 评估
| 模型 | 平均 | 指令遵循 | 一致性 | 视觉质量 | 运动质量 |
|---|---|---|---|---|---|
| HunyuanVideo-13B | 2.84 | 2.97 | 2.95 | 2.87 | 2.56 |
| Wan2.1-14B | 2.85 | 3.10 | 2.81 | 3.00 | 2.48 |
| Hailuo-01 | 3.05 | 3.31 | 2.58 | 3.55 | 2.74 |
| Kling-1.6 Pro | 3.4 | 3.56 | 3.03 | 3.58 | 3.41 |
| Runway-Gen4 | 3.39 | 3.75 | 3.2 | 3.4 | 3.37 |
| SkyReels-V2-DF | 3.24 | 3.64 | 3.21 | 3.18 | 2.93 |
| SkyReels-V2-I2V | 3.29 | 3.42 | 3.18 | 3.56 | 3.01 |
SkyReels-V2-I2V 在开源模型中达到最优,与闭源模型 Kling-1.6 Pro(3.4)和 Runway-Gen4(3.39)具有可比性。
超长视频生成
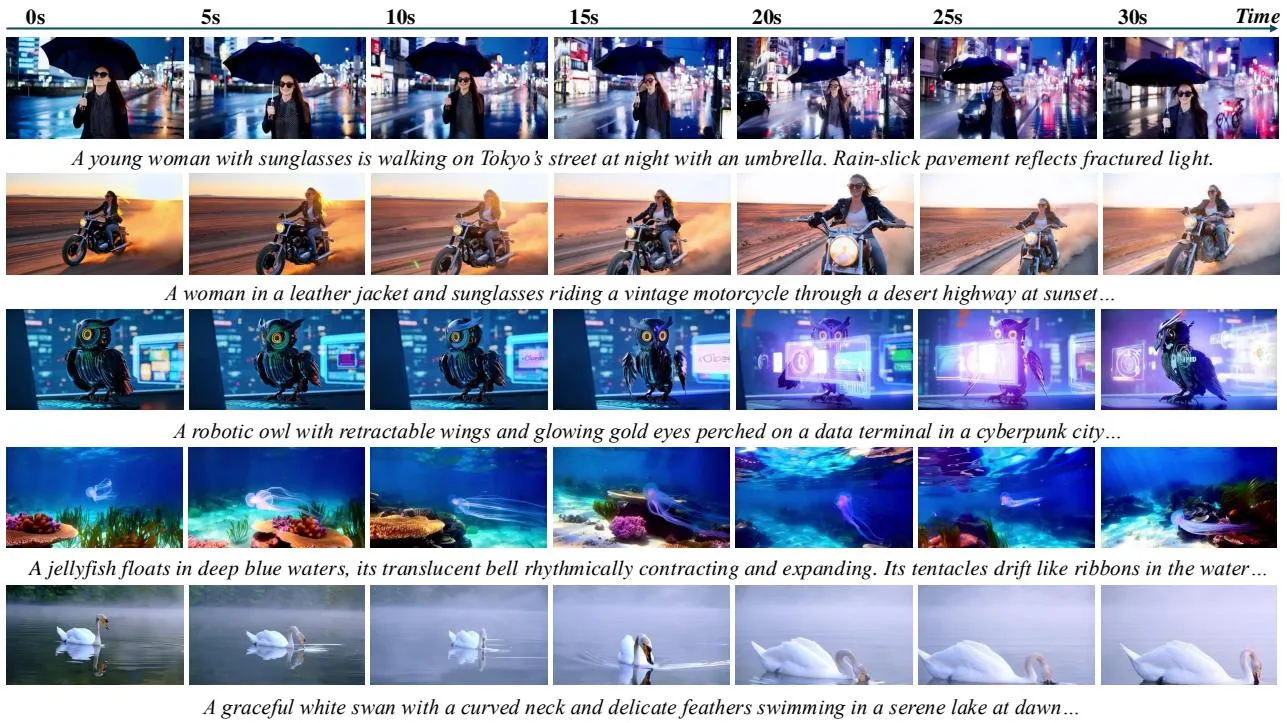
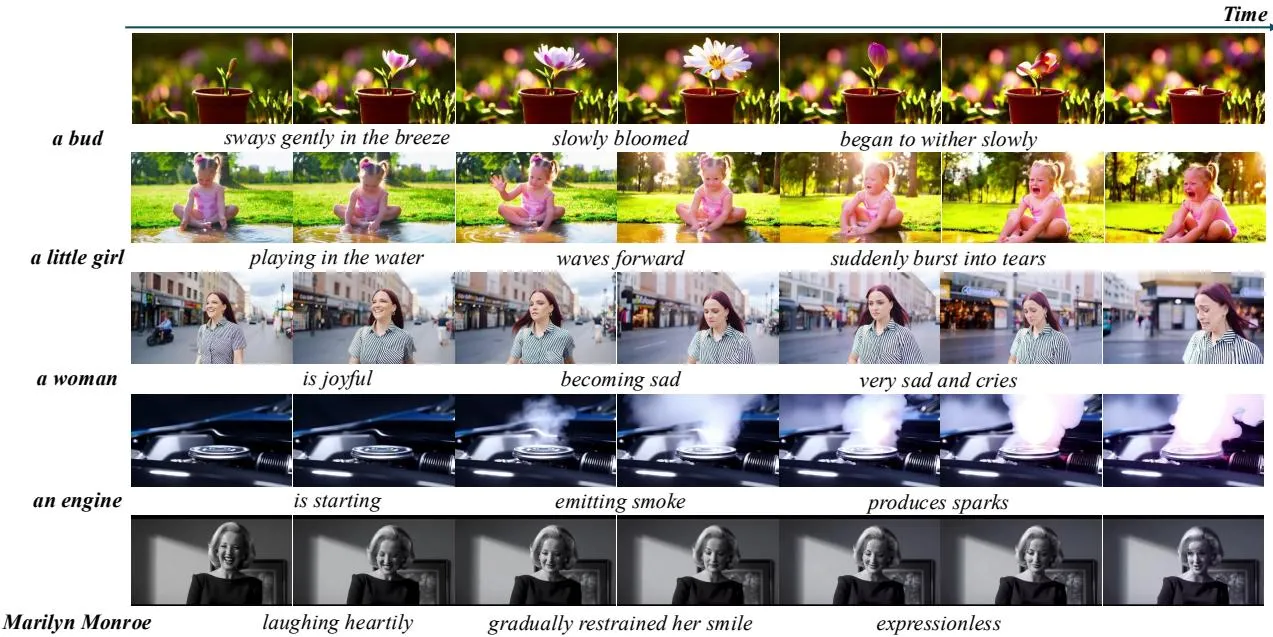
- 单提示生成:通过滑动窗口 + 轻微噪声稳定,生成 30+ 秒视频
- 序列提示生成:支持多段叙事提示,生成连贯的多动作长镜头
Elements-to-Video
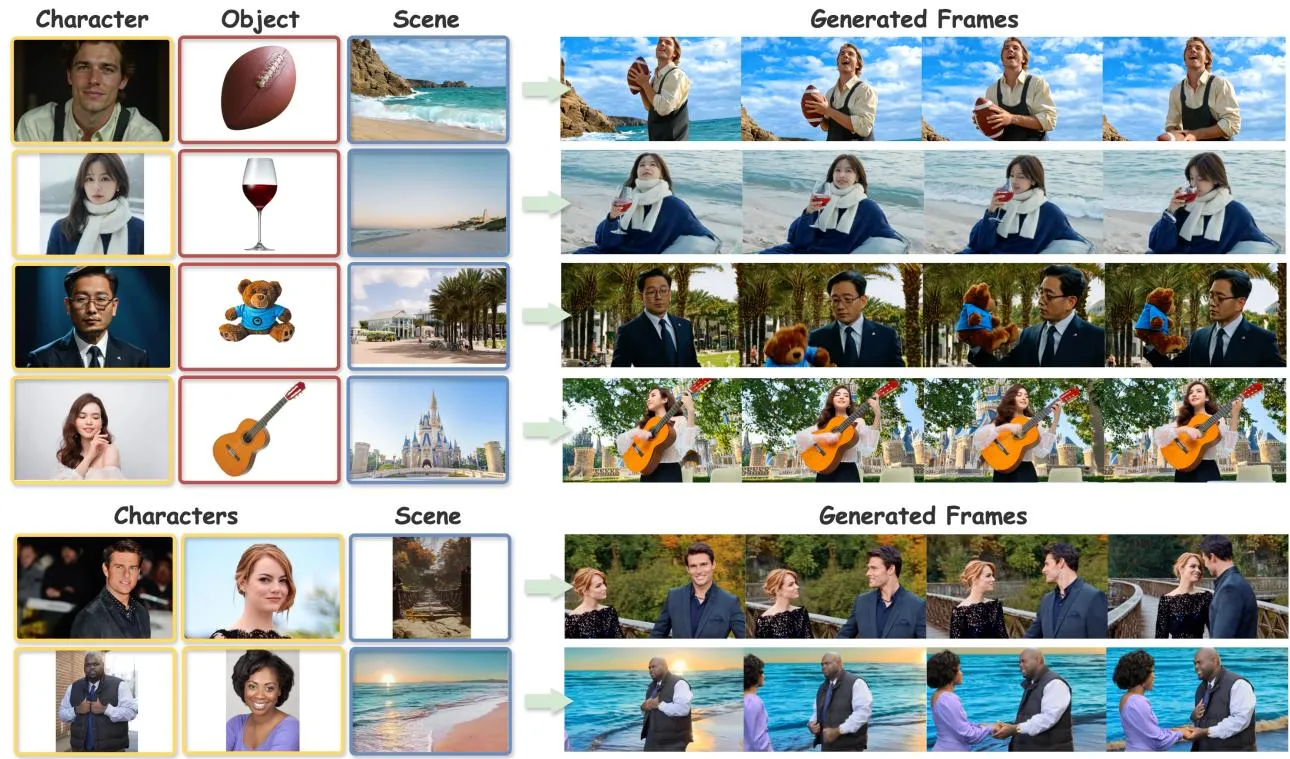
SkyReels-A2 支持多参考图像 + 文本提示,生成组合视频,保持各元素身份一致性。
七、核心创新总结
| 创新点 | 说明 | 影响 |
|---|---|---|
| 结构化描述体系 | 多维度主体 + 镜头元数据 | 镜头语言理解准确率提升 2-3 倍 |
| 半自动偏好数据 | 人工 + 自动失真创建 | 运动质量 RL 数据规模可控 |
| Diffusion Forcing 微调 | 全序列扩散 → DF 模型 | 首个开源无限长度视频模型 |
| 多阶段训练 | 预训练 + 4 阶段后训练 | 系统性提升各维度性能 |
| 全系列开源 | 1.3B/5B/14B 多种任务模型 | 推动社区研究 |
八、技术影响
对视频生成领域的指导
- 描述即接口:结构化视频描述证明了领域特定描述格式对生成质量的关键作用
- 运动质量专用 RL:借鉴 LLM RLHF 思路,为视觉生成模型的运动质量优化提供新范式
- DF 微调策略:从全序列扩散模型微调为 DF 模型,避免从头训练的不稳定性
- 数据为王:O(100M) 数据规模 + 多级过滤流水线,证明大规模数据处理的重要性
应用前景
- 电影/短剧制作:无限长度 + 镜头语言理解 + 叙事能力
- 故事生成:序列提示驱动的多场景连贯视频
- 图像到视频:高质量 I2V 合成
- 摄影机导演:可控摄影机运动
- 元素组合:多参考图像的组合视频生成
局限性
- 误差累积:Diffusion Forcing 框架在超长生成中仍存在误差累积
- 运动质量:运动质量得分(2.74)仍低于 Kling-1.6(2.76),与 Runway-Gen4(3.37)差距明显
- 视觉质量:视觉质量(3.34)略低于 Wan2.1(3.54)和 Kling-1.6(3.39)
- 计算成本:14B 模型训练和推理需要大量 GPU 资源
- 评估局限:V-Bench 对镜头场景语义的评估不足
九、参考资源
论文
- 本文: https://arxiv.org/abs/2504.13074
- 项目网站: https://github.com/SkyworkAI/SkyReels-V2
- HuggingFace: https://huggingface.co/Skywork
- ModelScope: https://modelscope.cn/organization/Skywork
相关工作
- SkyReels-V1: 首个开源人体中心视频基础模型
- SkyReels-A1: 人像图像动画框架
- SkyReels-A2: 可控元素组合视频生成
- Wan2.1: 大规模视频生成模型(架构基础)
- Diffusion Forcing: 下一 token 预测与全序列扩散的统一
- AR-Diffusion: 异步视频生成的自回归扩散
- CausVid: 高效 DFoT 适配策略
数据集
- Koala-36M, HumanVid, InternVid 等开源视频数据集
- 自采 280K+ 电影 / 800K+ 电视剧