SpargeAttn: Accurate and Training-free Sparse Attention Accelerating Any Model Inference
训练无关的通用稀疏注意力,加速所有模型推理(语言、图像、视频生成)
SpargeAttn: Accurate and Training-free Sparse Attention Accelerating Any Model Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SpargeAttn: Accurate Sparse Attention Accelerating Any Model Inference |
| 作者 | Jintao Zhang, Chendong Xiang, Haofeng Huang, Jia Wei, Haocheng Xi, Jun Zhu, Jianfei Chen |
| 机构 | Tsinghua University (thu-ml) |
| 论文 | arXiv:2502.18137 |
| 代码 | github.com/thu-ml/SpargeAttn |
| 发布 | 2025-02-25 (ICML 2025) |
| 许可 | — |
二、核心思想
SpargeAttn 是一种通用的、训练无关的稀疏注意力算子,可应用于各类生成式模型(语言建模、文本到图像、文本到视频),在不损失端到端性能的前提下显著加速推理。
问题定义
注意力机制的时间复杂度为 ,随着序列长度增长(视频生成中可达 45K-128K),注意力成为推理延迟的主要部分。虽然注意力图通常具有稀疏性(softmax 产生大量接近零的值),但现有稀疏注意力方法面临两大挑战:
- L1. 通用性不足: 已有方法多针对特定任务设计(如语言模型使用滑动窗口或注意力 sink),而不同任务的注意力模式差异很大(见 Fig. 2)。
- L2. 可用性与精度的矛盾: 准确预测稀疏区域需要高开销的计算,而低开销预测又难以保证精度。例如 MInference 需要极长序列(100K)才能实现明显加速。
解决方案概述
SpargeAttn 通过三个核心技术解决上述问题:
- 选择性 Token 压缩的稀疏掩码预测:通过将每个 block 内的 Q/K 按 token 相似度有选择地压缩为单个 token,构建稀疏掩码,准确预测注意力图中应计算的块。该方法跨任务通用。
- Sparse Warp Online Softmax:在 GPU warp 级别设计的在线 softmax 稀疏算法,利用全局最大值与局部最大值的差异进一步跳过部分 乘法,且无额外开销。
- 与 SageAttention 集成:将稀疏方法整合到 8-bit 量化的 SageAttention 框架中实现进一步加速。
三、技术架构
整体框架
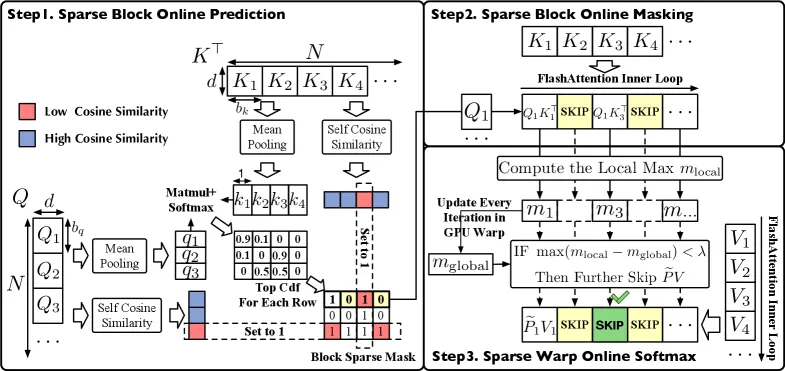
SpargeAttn 包含两阶段在线滤波器来实现稀疏 FlashAttention:
- Stage 1(Step 1-2):快速准确地预测注意力图中的稀疏块,跳过对应的 和 计算。
- Stage 2(Step 3):通过稀疏在线 softmax 进一步跳过部分 计算。
核心公式
FlashAttention 在线 Softmax 基础:
其中 和 是 向量,初始化为 和 。 是类 softmax 算子:, 。最终输出 。
稀疏掩码定义:
令 和 为维度 的二进制掩码:
选择性 Token 压缩:
对每个 block 计算平均 token 和块内自相似度:
其中 用于衡量 block 内 token 的相似程度。
注意力近似矩阵:
TopCdf 掩码选择:
对每行 ,选择累积概率超过阈值 的位置:
同时强制保留低相似度 block 的所有计算:
Sparse Warp Online Softmax:
定义局部最大值 ,当 时,可近似认为 ,从而跳过 乘法。
在 warp 级别,设 warp 索引为 ,其覆盖的行范围为 ,若满足:
则跳过 的计算,直接令 。
Algorithm 1: SpargeAttn 实现流程
Input: Q(FP16), K(FP16), V(FP16) ∈ ℝ^(N×d), block size bq, bk_v,
       GPU Warps count cw, hyper-parameters τ, θ, λ

1. Divide Q to Tm=N/bq blocks {Qi}; divide K,V to Tn=N/bk_v blocks {Ki},{Vi}

2. Q̂i, K̂j, δQ, δK = Quant(Qi, Kj)              // per-block quantization (SageAttention)

3. qi = mean(Qi, axis=0);  kj = mean(Kj, axis=0)

4. Ŝ = qkᵀ;  sqi = CosSim(Qi);  skj = CosSim(Kj)
   Ŝ[:,j] = -∞, if skj < θ

5. P̂[i] = Softmax(Ŝ[i]);  M[i,:] = TopCdf(P̂[i], τ)
   M[i,:] = 1, if sqi < θ;  M[:,j] = 1, if skj < θ

6. for i = 1 to Tm do
7.   Load Q̂i and δQ[i] into a SM
8.   for j = 1 to Tn do
9.     if M[i,j] != 0 then
10.      Compute Si_j = Q̂i K̂jᵀ / √δQ[i]δK[j] + δBias
11.      Compute (mi_j, P̃i_j) via online softmax
12.      if Mp_v[i,j] != 0 then
13.        Compute P̃i_j Vj and accumulate to output
14.      end
15.    end
16.  end
17. end
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Block Mask | 第一阶段掩码,决定跳过哪些 和 计算 | , |
| PV Mask | 第二阶段掩码,仅跳过 乘法 | |
| Selective Token Compression | 按块内 token 相似度压缩 Q/K block 到单 token | CosSim 归一化 |
| TopCdf | 基于累积分布函数的稀疏选择 | 阈值 |
| HilbertCurve Permutation | 空间填充曲线排列 Q/K/V 以提升块内相似性 | 块大小 4 |
| SageAttention Integration | 8-bit 量化集成,per-block quantization | FP16 → INT8 |
超参数确定策略
三个超参数 , , 通过 L1 误差约束自适应确定:
其中 为完整注意力输出, 为稀疏注意力输出。给定两层阈值 :
- 若 :增大 (提高稀疏度)
- 若 :保持当前参数
- 若 :减小 (降低稀疏度以保证精度)
各模型使用的 值:
- Llama3.1:
- CogvideoX / Mochi:
- Stable-Diffusion3.5 / Flux:
HilbertCurve Permutation
图像和视频模型受益于强空间先验:相邻像素往往相似。为提升稀疏预测准确性,使用 Hilbert 空间填充曲线将 重排为 (),使得空间相邻的 token 在序列中也相邻,从而提高 block 内自相似性,增加可跳过的计算比例。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 选择性 Token 压缩 | 按块内 token 相似度有选择地压缩 Q/K block 为单 token,而非简单取平均 | Eq.(4)-(9):CosSim 筛选确保低相似度 block 不被过度压缩 |
| 两阶段在线稀疏滤波 | 第一阶段 跳过 和 ,第二阶段 仅跳过 | Table 6:合并后 sparsity 达 54%,高于单独使用任一阶段 |
| Warp-level 稀疏 Softmax | 在 GPU warp 粒度上利用 条件跳过 | 零额外开销——在线 softmax 已计算 |
| HilbertCurve 排列 | 利用空间填充曲线提升图像/视频模型的 block 自相似性和稀疏度 | Table 4:HilbertCurve 的 Sim-q=0.572, Sim-k=0.479 最优 |
| 跨模型通用性 | 训练无关,无需针对特定模型调整 | 在 LLM、T2I、T2V 五种模型上均有效 |
五、代码实现分析
GitHub: thu-ml/SpargeAttn
- 使用 CUDA 实现
- 基于 FlashAttention 的 tiling 策略
- 可选集成 SageAttention 的 per-block 8-bit 量化
- 支持 Llama3.1、CogvideoX、Mochi、Flux、Stable-Diffusion3.5 等多种模型
关键实现文件(按 GitHub repo 结构推断):
sparge_attn.py/ CUDA kernel:核心稀疏注意力实现- 两阶段掩码生成逻辑
- HilbertCurve 排列工具
六、实验结果
基准测试
评估模型:
- 文本: Llama3.1 (8B)
- 视频: CogvideoX (2B), Mochi
- 图像: Flux (.1-dev), Stable-Diffusion3.5 (large)
评估数据集:
- WikiText(ppl)、Longbench、InfiniteBench En.MC、Needle-in-A-Haystack
- Open-Sora prompt sets(视频)
- COCO annotations(图像,FID / CLIP / ImageReward)
端到端指标对比(Table 1):
| 模型 | 指标 | Full Attn | SpargeAttn | MInfer 30% | FlexPref γ=0.95 |
|---|---|---|---|---|---|
| Llama3.1 | WikiText ppl | 5.59 | 5.58 | 14.43 | 330.90 |
| Llama3.1 | Longbench | 62.68 | 62.66 | 50.44 | 30.43 |
| Llama3.1 | Needle Haystack | 100 | 100 | 22.50 | 10.00 |
| CogvideoX | VQA-a | 54.85 | 54.65 | 39.54 | 52.48 |
| CogvideoX | VQA-t | 67.45 | 67.20 | 44.28 | 66.74 |
| CogvideoX | FScore | 1.814 | 1.813 | 1.375 | 1.801 |
| Mochi | VQA-a | 54.27 | 54.15 | 34.66 | 53.01 |
| Mochi | VQA-t | 67.01 | 66.92 | 44.72 | 66.66 |
| Mochi | FScore | 1.807 | 1.805 | 1.138 | 1.802 |
| Flux | FID ↓ | 13.71 | 13.74 | 16.67 | 13.86 |
| Flux | CLIP ↑ | 30.47 | 30.46 | 30.37 | 30.46 |
| Flux | IR ↑ | 0.574 | 0.573 | 0.573 | 0.574 |
| SD3.5 | FID ↓ | 11.75 | 11.80 | 12.39 | 11.76 |
| SD3.5 | CLIP ↑ | 31.51 | 31.50 | 31.49 | 31.50 |
| SD3.5 | IR ↑ | 0.579 | 0.579 | 0.579 | 0.579 |
SpargeAttn 在全部模型上几乎无损,而 MInference 和 FlexPrefill 在多项指标上显著下降。
注意力内核速度对比(Fig. 9):
在 RTX4090 上,序列长度 22K,head dim 128:
- SpargeAttn + FA2: 相比完整 FlashAttention 2 加速明显
- SpargeAttn + Sage: 结合 8-bit 量化,速度进一步提升
- SpargeAttn + Sage2: 结合 SageAttention2,达到最高速度
- 随稀疏度增加,SpargeAttn 速度持续提升,且在相同稀疏度下全面超越基线
端到端生成延迟(Table 2):
| 模型 | GPU | Original | SageAttn | SpargeAttn |
|---|---|---|---|---|
| CogvideoX | RTX4090 | 87 s | 68 s | 53 s |
| Mochi | L40 | 1897 s | 1544 s | 1037 s |
| Llama3.1 (24K) | RTX4090 | 4.01 s | 3.53 s | 2.6 s |
| Llama3.1 (128K) | L40 | 52 s | 42 s | 29.98 s |
SpargeAttn 在 Mochi 上实现 1.83x 端到端加速,在 Llama3.1 128K 长序列上实现 1.74x 加速。
消融实验
稀疏掩码预测开销(Table 3):
| Sequence Len | Prediction (ms) | Full Attention (ms) | Overhead |
|---|---|---|---|
| 8k | 0.251 | 6.649 | 3.78% |
| 16k | 0.487 | 26.83 | 1.82% |
| 32k | 0.972 | 106.68 | 0.911% |
| 64k | 2.599 | 424.24 | 0.612% |
| 128k | 8.764 | 1696.2 | 0.516% |
预测开销随序列长度增长而递减,在 128K 时仅占 0.516%。
Permutation 方法对比(Table 4):
| Method | Sim-q ↑ | Sim-k ↑ | L1 ↓ | Sparsity ↑ |
|---|---|---|---|---|
| Random | 0.321 | 0.019 | 0.0414 | 0.048 |
| Rowmajor | 0.551 | 0.390 | 0.0307 | 0.363 |
| Timemajor | 0.514 | 0.367 | 0.0342 | 0.338 |
| HilbertCurve | 0.572 | 0.479 | 0.0389 | 0.392 |
HilbertCurve 在块自相似性和稀疏度上均最优。
Self-similarity Judge 消融(Table 5):
| Method | VQA-a ↑ | VQA-t ↑ | FScore ↑ |
|---|---|---|---|
| W/o self-sim Judge | 34.664 | 44.722 | 1.138 |
| With self-sim Judge | 54.179 | 67.219 | 1.807 |
自相似度判断对质量至关重要,移除后各项指标大幅下降。
两阶段稀疏贡献分析(Table 6):
| Strategy | Sparsity |
|---|---|
| only | 51.2% |
| only | 27.7% |
| 54% |
两阶段组合获得最高稀疏度,说明 在 基础上进一步跳过部分 计算。
长序列稀疏度变化(Table 7):
在 Llama3.1 上,保持恒定精度约束下,稀疏度随序列长度增加而提高(长序列有更多可跳过的块)。
七、相关工作
三类稀疏注意力方法:
-
Pattern-based methods(依赖固定模式):
- H2O, InfLLM, DUOAttention — 滑动窗口
- SampleAttention, MOA, StreamingLLM — 滑动窗口 + attention sink
- DitFastAttn — 滑动窗口 + 注意力图相似性(仅限简单 diffusion transformer,不兼容语言模型和 MMDiT)
-
Dynamic sparse methods(输入驱动,更通用):
- SparQAttn, LokiAttn — 通道压缩(降低注意力维度)
- MInference, FlexPrefill — Token 压缩(block 压缩到单 token)
- SeerAttention — 需训练额外参数
-
Training-based methods(需重新训练):
- Reformer, FastAttention
其他加速方向(正交方法):kernel 优化(FlashAttention)、量化、分布式、线性时间注意力。
八、总结
核心贡献
- 首个训练无关的通用稀疏注意力算子:SpargeAttn 可在语言、图像、视频生成模型上统一应用,无需针对特定模型调整。
- 选择性 Token 压缩:通过块内 token 自相似度判断进行有选择的压缩,避免 MInference 式激进压缩导致的精度丢失。
- Warp-level 稀疏在线 Softmax:零额外开销的第二阶段稀疏,进一步跳过 计算。
- HilbertCurve 排列:利用空间填充曲线提升图像/视频模型的稀疏度。
- 全面的实验验证:在 5 种模型(LLM + 2 T2V + 2 T2I)上验证,端到端指标几乎无损,加速比 2.5x-5x。
技术影响
SpargeAttn 为长序列推理提供了一种即插即用的加速方案,可与量化(SageAttention)、FlashAttention 等正交方法叠加使用。
局限性
- 超参数 需针对不同模型手动设定(通过 L1 误差约束自适应调节,但仍需先验调参)
- 对于短序列场景,预测开销占比相对较高(8K 时 3.78%)
- 稀疏度依赖于注意力图的内在稀疏性,在某些注意力均匀分布的场景下效果可能受限
九、参考资源
- arXiv: 2502.18137
- Code: github.com/thu-ml/SpargeAttn
- ICML 2025
图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | SpargeAttn 在 Mochi 上实现 1.83x 加速(L40 GPU) | figure-1-speedup-mochi.png |
| Figure 2 | 不同任务(视频/图像/语言)的注意力图采样模式 | figure-2-attention-patterns.png |
| Figure 3 | SpargeAttn 工作流程(两阶段在线滤波) | figure-3-workflow.png |
| Figure 4 | 各类模型中 Query 和 Key 的注意力模式示例 | figure-4-qk-patterns.png |
| Figure 5 | 不同 Token 排列方法对比(1×6×6 空间,块大小 4) | figure-5-permutation-comparison.png |
| Figure 6 | Flux 和 SD3.5 上的定性对比示例 | figure-6-image-comparison-flux-sd35.png |
| Figure 7 | Mochi 上的定性对比示例 | figure-7-video-comparison-mochi.png |
| Figure 8 | Llama3.1 上 NeedleInAHaystack 对比示例 | figure-8-nah-comparison-llama.png |
| Figure 9 | RTX4090 上不同稀疏度的内核速度对比 | figure-9-kernel-speed-comparison.png |
| Figure 10 | Llama3.1 上另一组 NeedleInAHaystack 对比 | figure-10-nah-comparison-llama-long.png |
| Figure 11 | Mochi 上另一组视频对比示例 | figure-11-video-comparison-mochi-additional.png |