Fast Video Generation with Sliding Tile Attention
滑动瓦片注意力加速视频扩散 Transformer 推理
Fast Video Generation with Sliding Tile Attention
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Fast Video Generation with Sliding Tile Attention |
| 作者 | Peiyuan Zhang, Yongqi Chen, Runlong Su, Hangliang Ding, Ion Stoica, Zhengzhong Liu, Hao Zhang |
| 机构 | UC Berkeley |
| 论文 | arXiv:2502.04507 |
| 代码 | GitHub |
| 发布 | 2025年2月6日 |
| 会议 | ICML 2025 |
| 许可 | arXiv 非独占分发许可 |
二、核心思想
问题定义
视频扩散 Transformer (DiT) 使用 3D 全注意力机制来建模空间和时间依赖性,但其二次复杂度导致推理成本极高。以 HunyuanVideo 生成 5 秒 720P 视频为例:
- 总推理时间:945 秒(使用 FlashAttention-3)
- 其中注意力计算:800 秒(占比 84.7%)
- 处理 token 数量:115K
核心观察
- 3D 局部性:尽管使用全 3D 注意力训练,HunyuanVideo 表现出强烈的局部性——仅覆盖 15.52% token 空间的局部窗口即可捕获 70% 的注意力分数
- 滑动窗口注意力的低效性:传统 2D/3D 滑动窗口注意力 (SWA) 会产生大量”混合块”(mixed blocks),无法有效减少计算量,且掩码计算开销大
- 头部特化:不同注意力头表现出不同的局部性模式——有些关注细粒度细节,有些捕获更广泛的上下文
解决方案概述
Sliding Tile Attention (STA) 是一种硬件感知的注意力机制,通过以下策略加速视频 DiT:
- 瓦片级操作:以瓦片(tile)而非单个 token 为单位滑动,消除显式注意力掩码需求
- 硬件感知设计:采用生产者-消费者范式,异步加载数据,保持计算密集
- 头部特化窗口:通过 profiling 自动为每个注意力头配置最优窗口大小
- 训练无关+微调:支持即插即用的训练无关加速,以及进一步微调加速
核心性能
| 配置 | 加速比 | 延迟 | VBench 下降 |
|---|---|---|---|
| STA (training-free) | 1.89× | 501s | 无 |
| STA (finetuning) | 3.53× | 268s | 0.09% |
三、技术架构
整体框架图
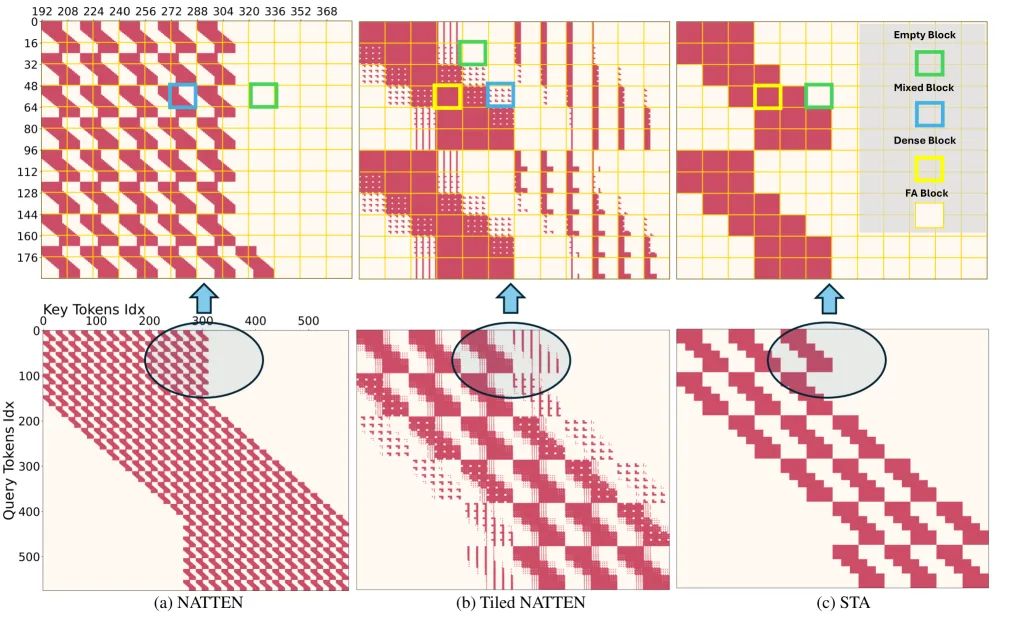
Figure 5: Sliding Tile Attention 概览。(a) 每个瓦片由 FlashAttention 块大小确定,STA 逐瓦片滑动而非逐 token 滑动。(b) 生产者-消费者范式:生产者 warpgroup 异步加载数据并计算掩码,消费者 warpgroup 执行密集注意力计算。
核心公式
全注意力机制
其中 为注意力掩码。
滑动窗口注意力
传统 SWA 中,每个 query 仅关注固定窗口内的 key:
STA 瓦片级操作
STA 以瓦片为单位定义注意力窗口,消除混合块问题:
其中 为瓦片级窗口大小。
注意力蒸馏损失(微调)
其中 为 STA 注意力输出, 为原始全注意力输出。
注意力局部性分析
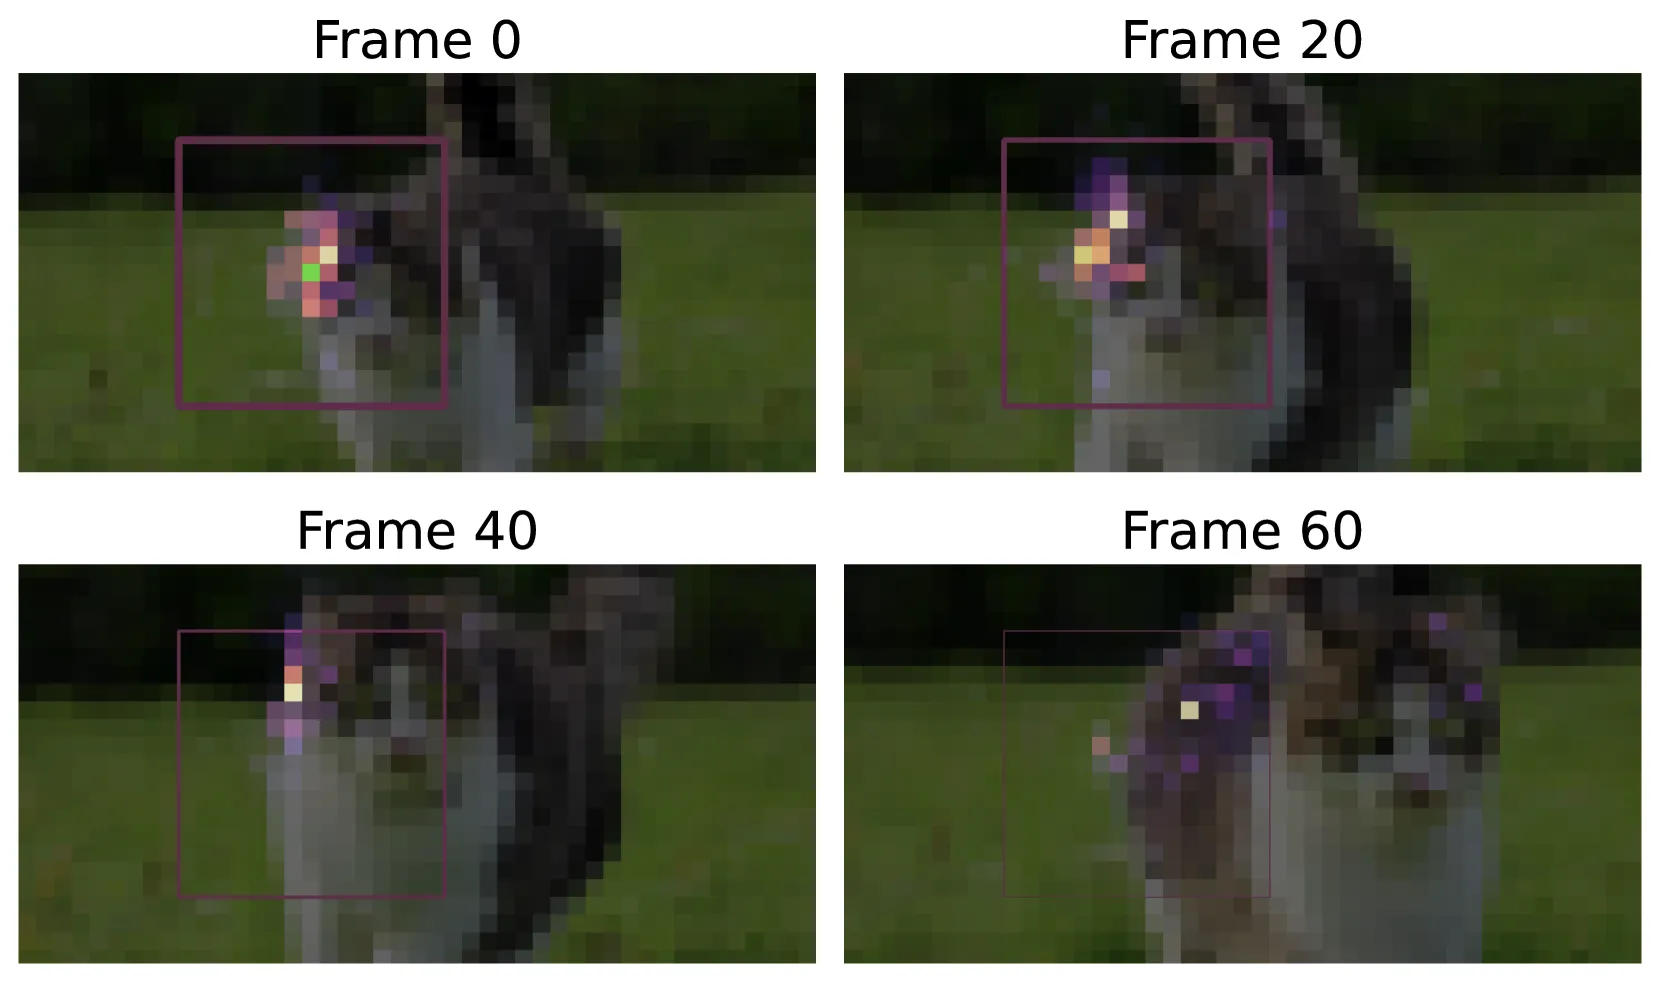
Figure 2: 注意力局部性可视化。绿点为 query 点,岩浆色区域表示高注意力值区域。query 的注意力形成集中的局部热点。
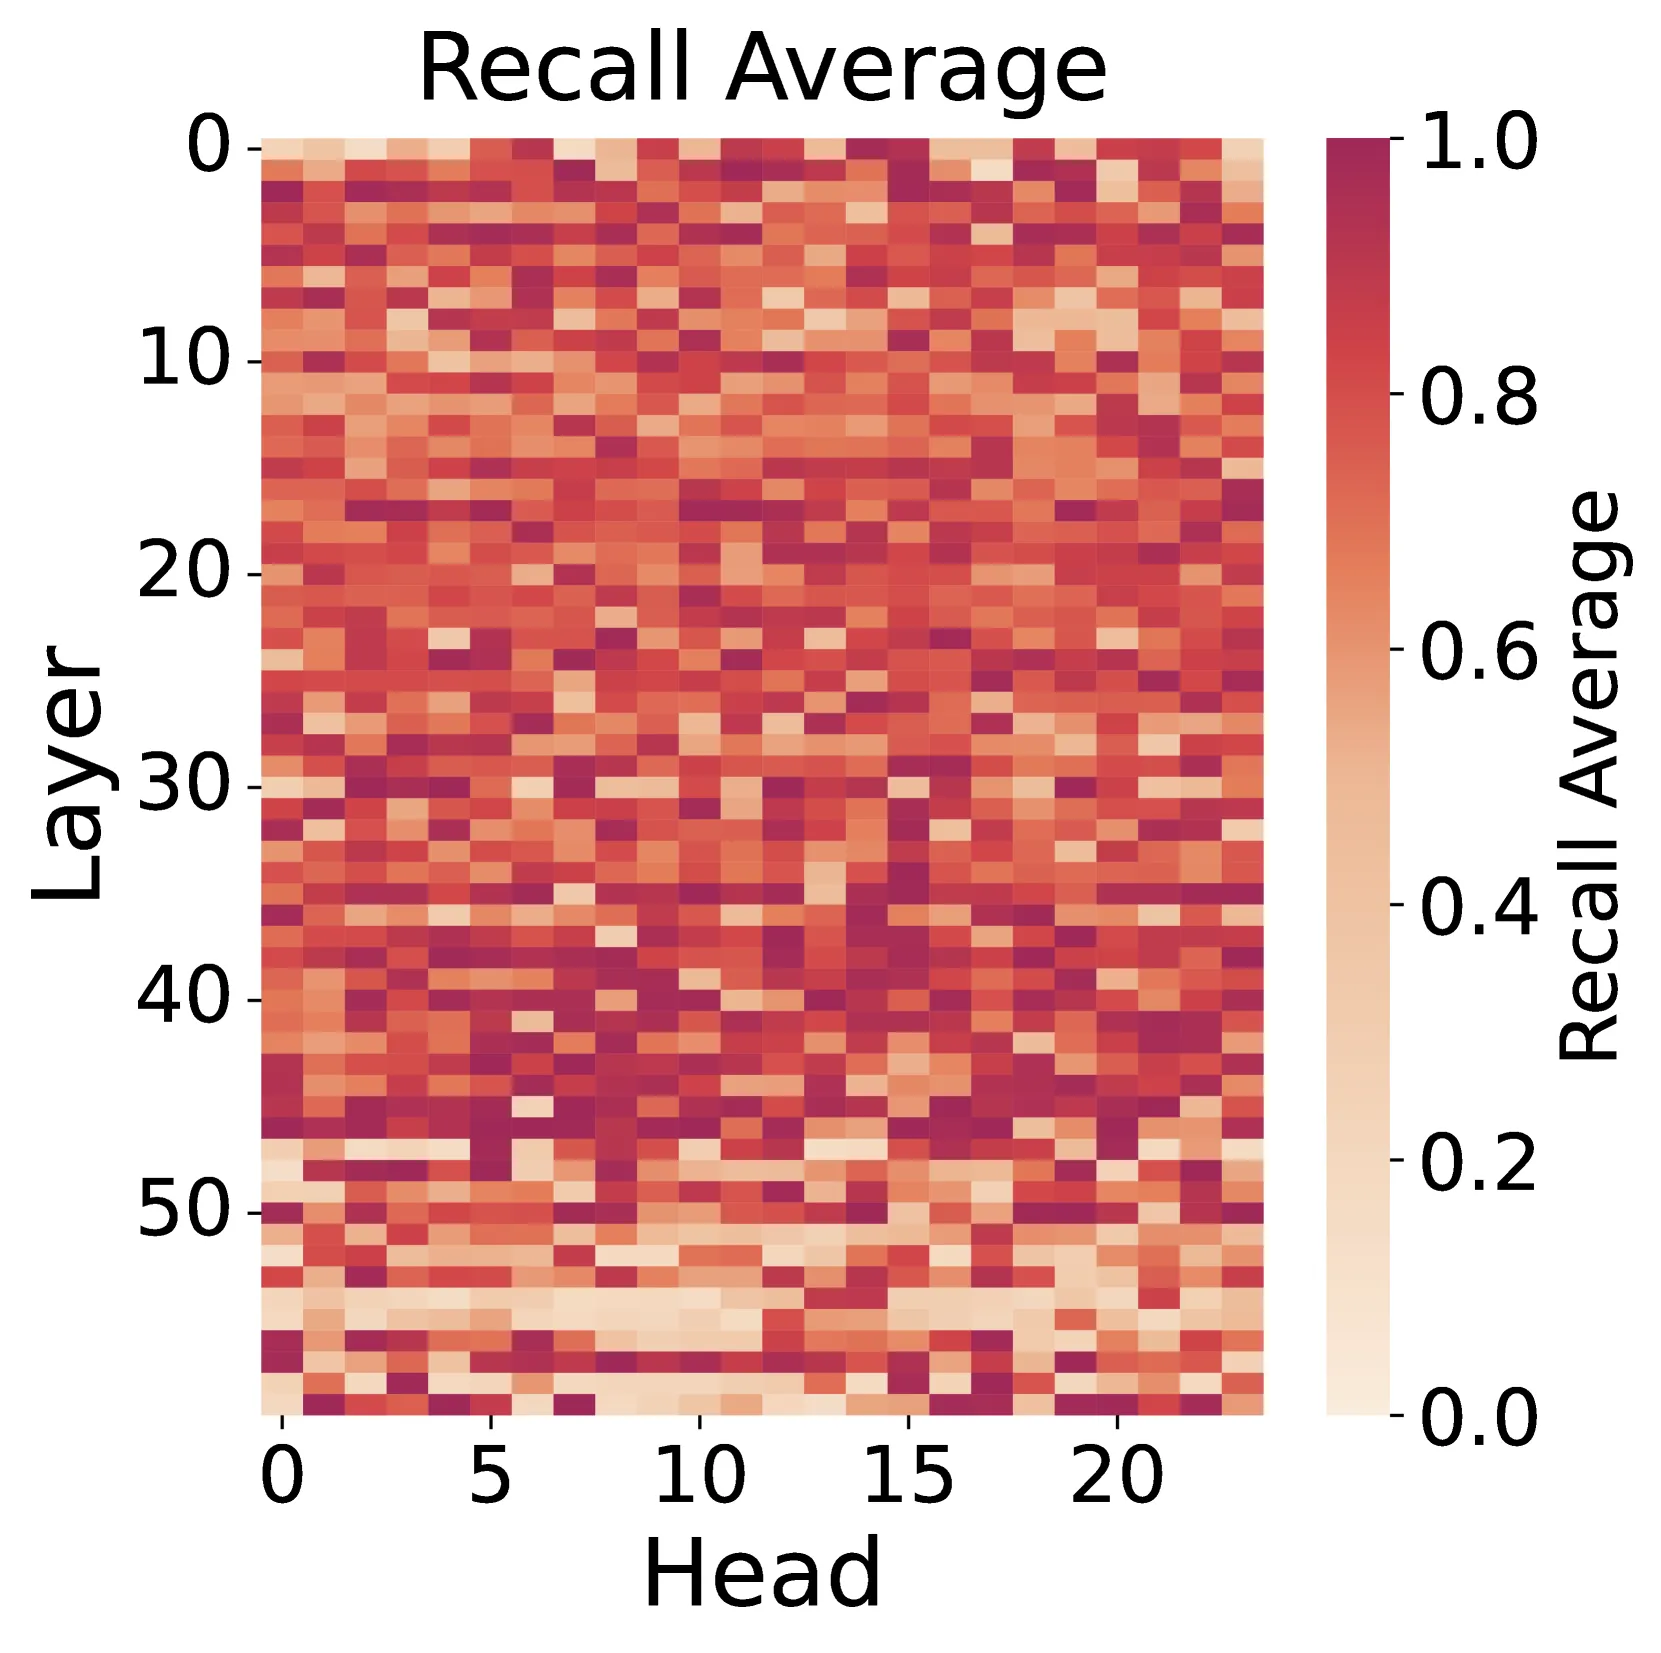
Figure 3: 左:不同扩散步和 prompt 下 (12, 24, 24) 局部窗口的注意力分数比例。大多数头表现出高召回率,表明局部注意力模式。
滑动窗口注意力的问题
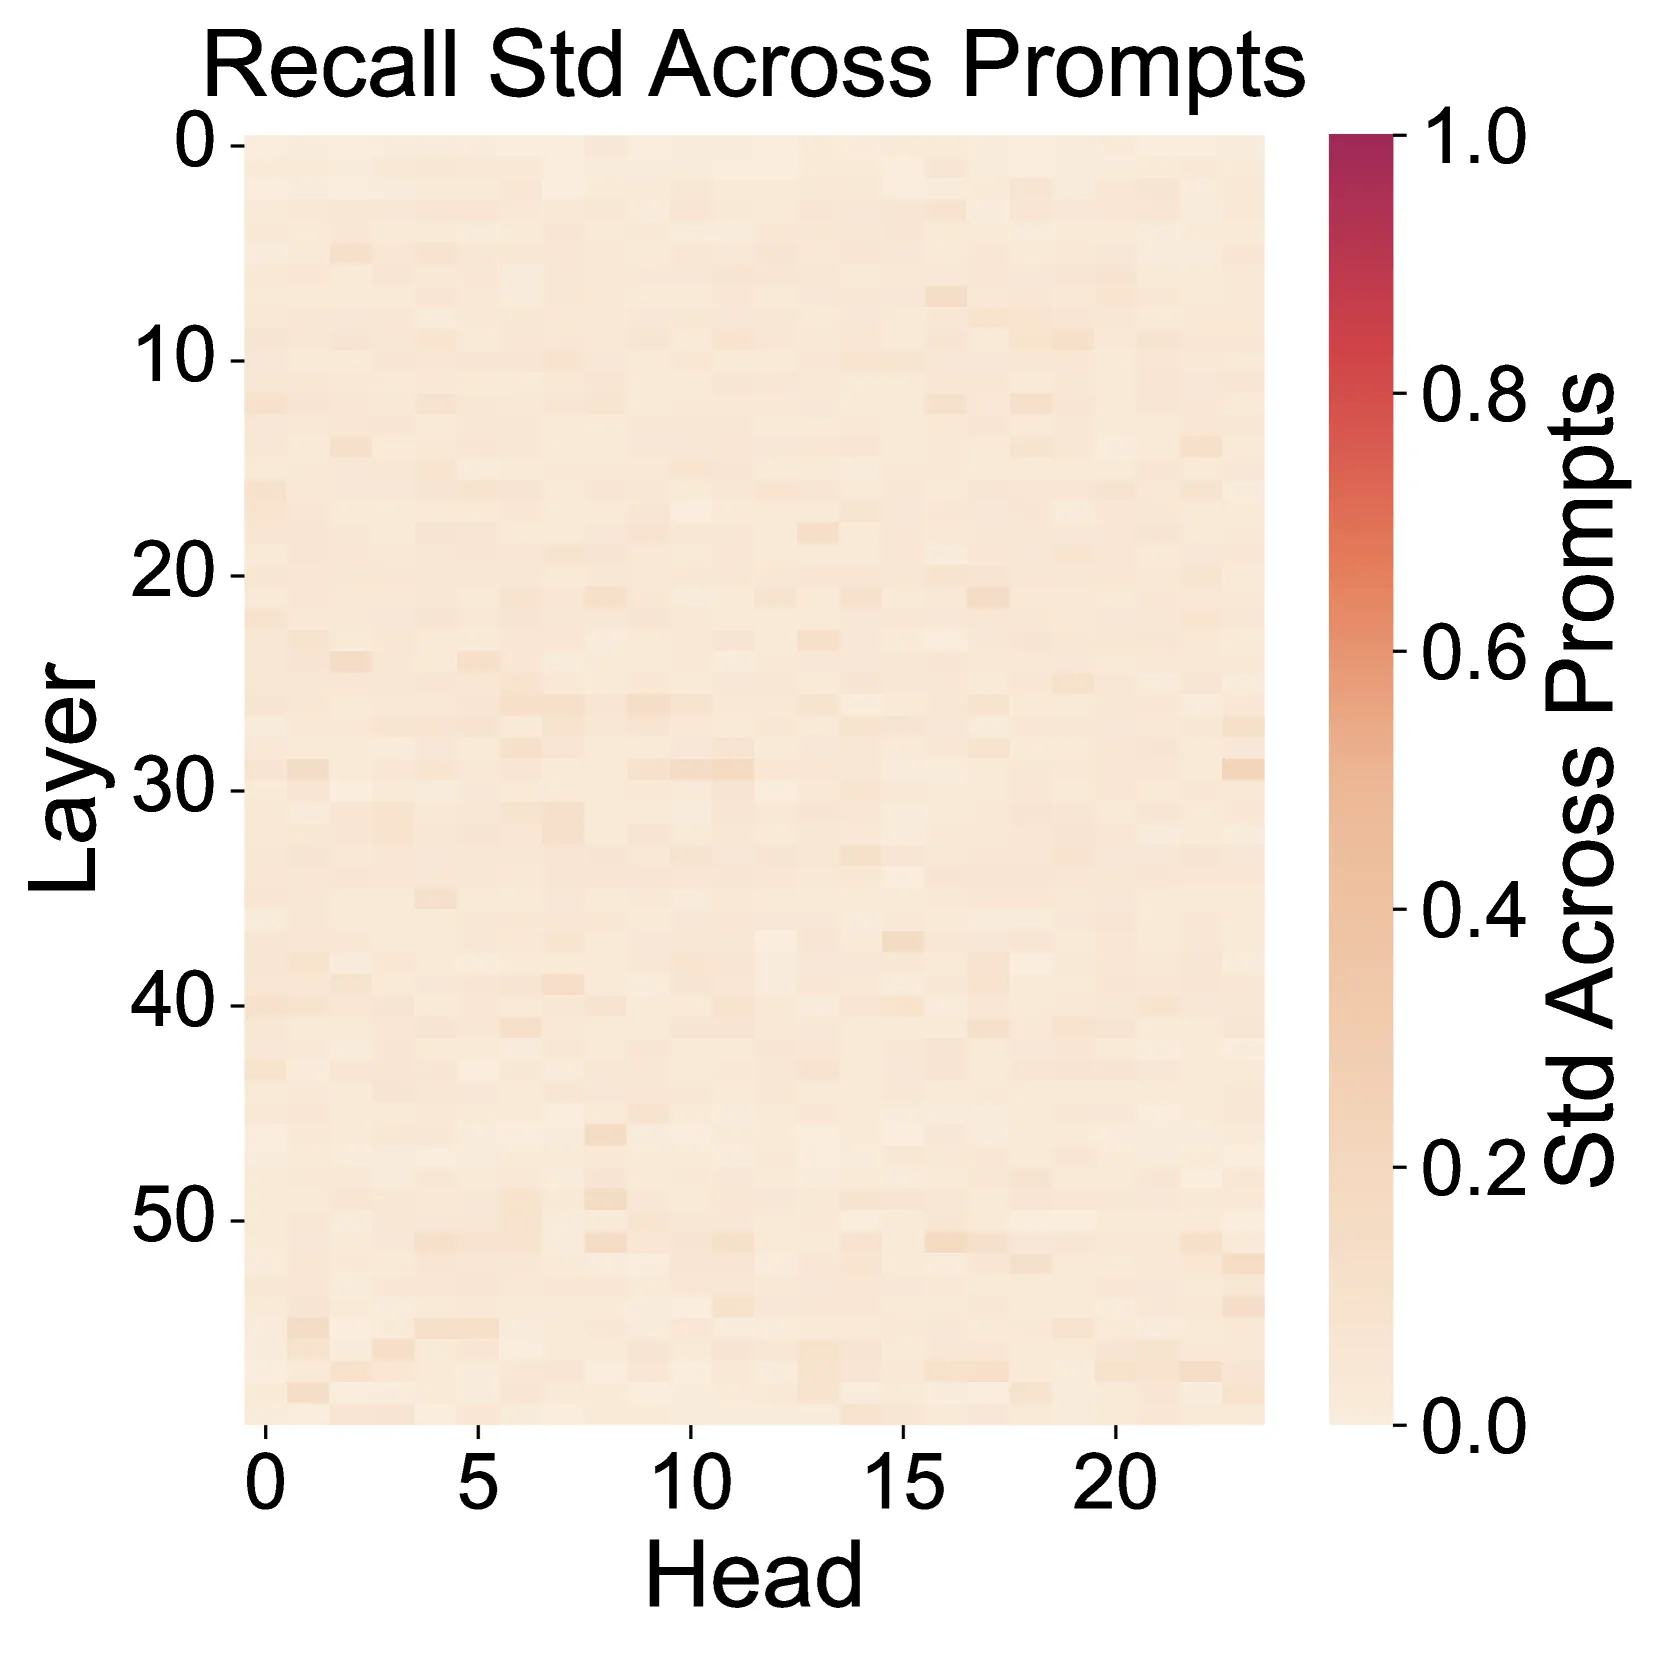
Figure 4: NATTEN、Tiled NATTEN 和 STA 的注意力图对比。(a) NATTEN 创建大量混合块,对 FlashAttention 计算非常低效。(b) Tiled NATTEN 通过重排输入增加密集块,但仍有显著比例的混合块。(c) STA 消除混合块,实现高效计算。
混合块问题分析:
| 块类型 | 说明 | 计算效率 |
|---|---|---|
| Dense | 所有注意力分数保留 | 高效 |
| Empty | 全部掩码掉 | 跳过 |
| Mixed | 部分保留部分掩码 | 低效(需完整计算后掩码) |
STA 硬件感知设计
STA 关键设计:
- 瓦片级滑动:以 FlashAttention 块大小为单位滑动,消除显式掩码计算
- 生产者-消费者范式:
- 生产者 warpgroup:异步从 HBM 加载数据到 SRAM,计算掩码
- 消费者 warpgroup:执行密集注意力计算
- 掩码管理:稀疏注意力掩码完全由生产者 warpgroup 管理,消费者保持密集计算
头部特化
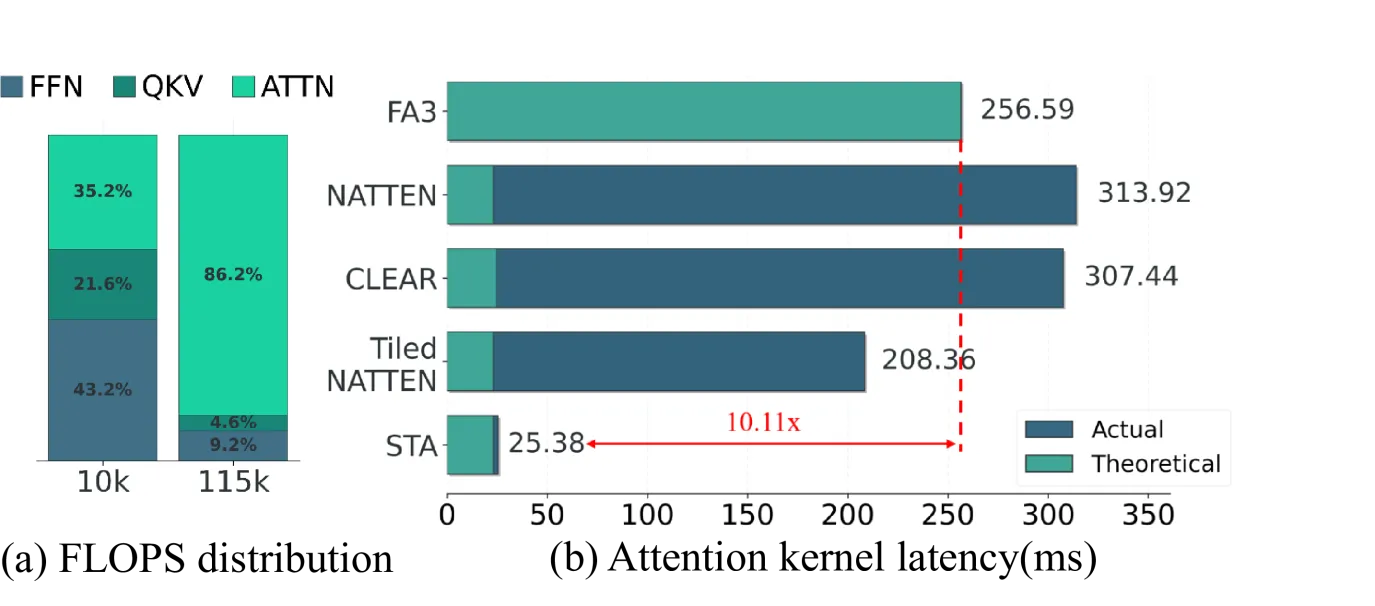
Figure 1: (a) HunyuanVideo 处理 115K token,注意力是主要成本。(b) 注意力延迟对比:现有方法无法将 FLOP 减少转化为实际加速;STA 实现与稀疏度成比例的加速。
头部特化机制:
- 不同注意力头表现出不同的局部性模式
- 通过 profiling 自动为每个头配置最优窗口大小
- 平衡效率和质量
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| STA 核 | 硬件感知的滑动瓦片注意力实现 | Triton/CUDA |
| 窗口配置器 | 通过 profiling 为每个头选择最优窗口 | 窗口大小 |
| 注意力蒸馏 | 微调时匹配原始注意力行为 | |
| 生产者-消费者 | 异步数据加载和计算 | warpgroup 分配 |
应用到视频扩散模型
STA 在视频 DiT 中的应用:
- 识别局部性:通过分析预训练模型的注意力模式,确认 3D 局部性
- 配置窗口:为每个注意力头自动配置最优窗口大小
- 替换注意力:将全注意力替换为 STA
- 可选微调:使用注意力蒸馏进一步优化
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 3D 局部性发现 | 视频 DiT 中注意力分数集中在局部 3D 窗口 | Figure 3 注意力召回率分析 |
| 瓦片级滑动 | 以瓦片而非 token 为单位滑动,消除混合块 | Figure 4 注意力图对比 |
| 硬件感知设计 | 生产者-消费者范式,异步加载,密集计算 | 58.79% MFU |
| 头部特化 | 不同头使用不同窗口大小 | 自动 profiling |
| 首个高效 2D/3D 滑动窗口实现 | 实现与稀疏度成比例的墙钟加速 | Figure 1(b) |
五、实验结果
核心加速效果
HunyuanVideo 结果
| 方法 | 延迟 (s) | 加速比 | VBench |
|---|---|---|---|
| FlashAttention-2 | 1496 | 1.00× | - |
| FlashAttention-3 | 945 | 1.58× | - |
| STA (training-free) | 501 | 1.89× | 无下降 |
| STA (finetuning) | 268 | 3.53× | -0.09% |
注意力核性能
| 方法 | 注意力加速 | 端到端加速 |
|---|---|---|
| STA vs FA2 | 2.8-17× | 2.98× |
| STA vs FA3 | 1.6-10× | 1.89× |
与现有方法对比
Training-free 结果 (HunyuanVideo, 50 steps)
| 方法 | SSIM↑ | PSNR↑ | CD-FVD↓ | 加速比 |
|---|---|---|---|---|
| Δ-DiT (1.36×) | 72.86 | 24.83 | 247.36 | 1.36× |
| Δ-DiT (1.8×) | 67.56 | 23.39 | 304.48 | 1.80× |
| STA | 87.67 | 27.14 | 84.80 | 1.76× |
Finetuning 结果
| 方法 | VBench | 延迟 | 加速比 |
|---|---|---|---|
| HunyuanVideo (原始) | 基线 | 945s | 1.00× |
| STA-tf-1.89× | 无下降 | 501s | 1.89× |
| STA-t-2.43× | -0.09% | 268s | 3.53× |
Wan 2.1 结果
| 方法 | SSIM↑ | PSNR↑ | CD-FVD↓ | 加速比 |
|---|---|---|---|---|
| Δ-DiT (1.36×) | 72.86 | 24.83 | 247.36 | 1.36× |
| Δ-DiT (1.8×) | 67.56 | 23.39 | 304.48 | 1.80× |
| STA | 87.67 | 27.14 | 84.80 | 1.76× |
超级分辨率结果
| 方法 | PSNR↑ | SSIM↑ |
|---|---|---|
| 原始 | 基线 | 基线 |
| STA | 保持 | 保持 |
核效率对比
| 方法 | MFU | 说明 |
|---|---|---|
| FlashAttention-3 | ~70% | 密集注意力基线 |
| STA | 58.79% | 稀疏注意力,最小开销 |
| NATTEN | ~30% | 传统滑动窗口 |
| Tiled NATTEN | ~40% | 改进的滑动窗口 |
视觉质量对比
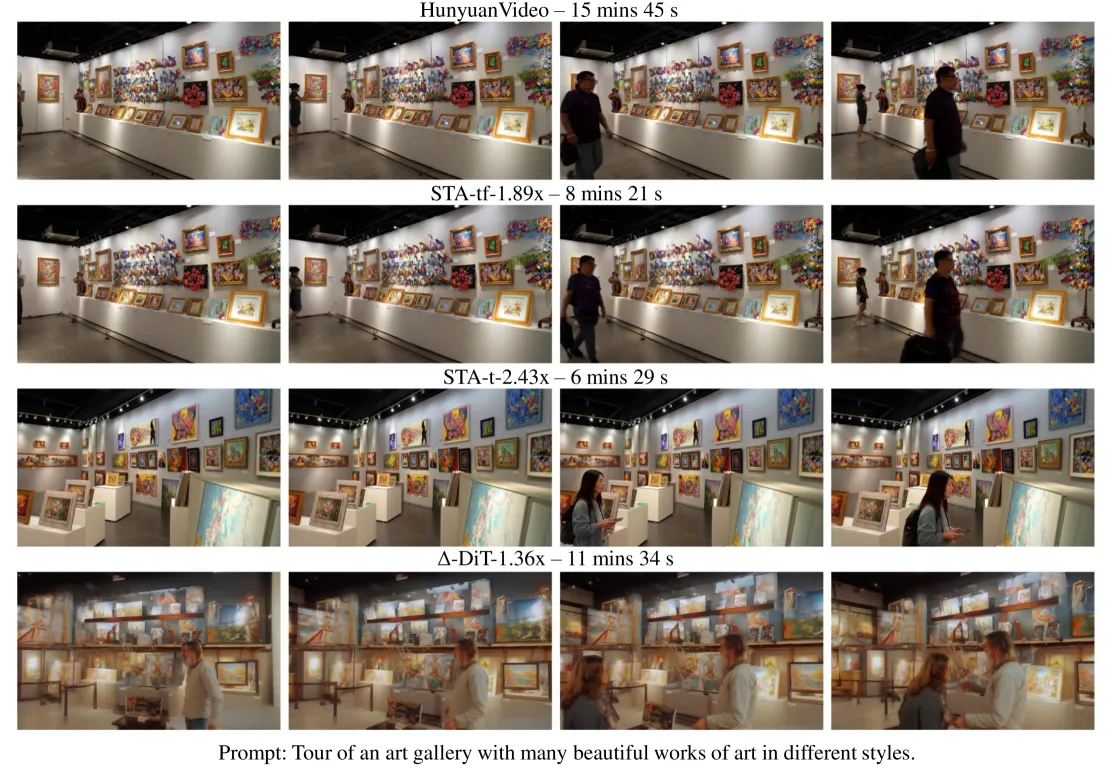
Figure 6: STA 与基线方法的视觉对比。STA 在保持视觉质量的同时实现显著加速。
六、与现有方法对比
| 方面 | NATTEN | Tiled NATTEN | Δ-DiT | STA |
|---|---|---|---|---|
| 方法类型 | 滑动窗口 | 滑动窗口 | 稀疏注意力 | 瓦片级滑动窗口 |
| 混合块 | 大量 | 中等 | 无 | 无 |
| 掩码开销 | 高 | 中等 | 低 | 极低 |
| 硬件效率 | 低 | 中等 | 中等 | 高 |
| MFU | ~30% | ~40% | - | 58.79% |
| HunyuanVideo 加速 | <1× | ~1.2× | 1.36-1.8× | 1.89-3.53× |
| 质量损失 | 小 | 小 | 中等 | 极小/无 |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| FlashAttention | STA 的基础,使用相同的 tiling 和在线 softmax |
| FlashAttention-3 | 对比基线,STA 实现 1.6-10× 加速 |
| NATTEN | 传统滑动窗口注意力,STA 超越 |
| Tiled NATTEN | 改进的滑动窗口,STA 超越 |
| Δ-DiT | 稀疏注意力基线,STA 在质量和速度上均超越 |
| HunyuanVideo | 目标视频 DiT 模型 |
| Wan 2.1 | 额外验证的视频 DiT 模型 |
八、总结
核心贡献
- 3D 局部性发现:量化了视频 DiT 中的 3D 局部性和头部特化现象
- Sliding Tile Attention:首个硬件高效的 2D/3D 滑动窗口注意力实现
- 显著加速:注意力加速 2.8-17×(vs FA2),端到端加速 3.53×(含微调)
- 质量保持:训练无关模式无质量损失,微调模式仅 0.09% VBench 下降
技术影响
- 视频生成加速:为视频 DiT 提供即插即用的加速方案
- 硬件感知设计:展示了算法-系统协同设计的重要性
- 头部特化:为注意力优化提供了新的视角
- 开源贡献:FastVideo 代码库公开
局限性
- 仅在 HunyuanVideo 和 Wan 2.1 上验证
- 需要 Triton/CUDA 实现稀疏核
- 头部特化需要额外的 profiling 步骤
- 微调需要额外的训练成本
九、参考资源
- 论文: arXiv:2502.04507
- 代码: GitHub
- 会议: ICML 2025
- 许可: arXiv 非独占分发许可
- 页数: 约 25 页
十、关键公式速查
| 公式 | 说明 |
|---|---|
| 全注意力机制 | |
| 注意力蒸馏损失 | |
| 滑动窗口掩码 |
十一、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 注意力成本分析和加速对比 | x1.png |
| Figure 2 | 注意力局部性可视化 | x2.png |
| Figure 3 | 注意力召回率分析 | x3.png |
| Figure 4 | NATTEN/Tiled NATTEN/STA 注意力图对比 | x4.png |
| Figure 5 | STA 框架概览和硬件设计 | x5.png |
| Figure 6 | 视觉质量对比 | x6.png |
| Figure 7 | 更多视觉对比结果 | x7.png |
| Figure 8 | 更多视觉对比结果 | x8.png |
| Figure 9 | 更多视觉对比结果 | x9.png |
| Figure 10 | 附加结果 | x10.png |