LTX-Video: 实时视频潜在扩散模型
Lightricks 提出的实时文/图生视频模型:把 patchify 操作从 Transformer 输入端移入 Video-VAE,实现 1:192 高压缩(32×32×8 时空下采样 + 128 潜通道),并让 VAE 解码器承担最后一步去噪,无需额外超分模块。1.9B 参数即可在单张 H100 上以 2 秒生成 5 秒 768×512@24fps 视频(快于实时),人评 T2V 胜率 85%、I2V 胜率 91% 显著超越同量级开源模型。
LTX-Video: 实时视频潜在扩散模型
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LTX-Video: Realtime Video Latent Diffusion |
| 作者 | Yoav HaCohen 等(16 位作者) |
| 机构 | Lightricks |
| 发布 | arXiv:2501.00103(2024-12-30) |
| 代码/模型 | 开源(Apache-2.0,模型权重公开) |
| 主题 | 文生视频 / 图生视频、潜在扩散、Video-VAE、DiT、实时生成 |
一句话总结:通过把 patchify 从 Transformer 端下沉到 VAE,并让 VAE 解码器兼任”最后一步去噪 + 潜变量转像素”,LTX-Video 在极高压缩率下实现了快于实时、消费级 GPU 可跑的高质量视频生成。
二、核心思想
现有视频潜在扩散模型普遍存在两个割裂:
- VAE 与扩散 Transformer 相互独立——VAE 只负责压缩/重建,Transformer 在潜空间独立完成全部去噪;
- 压缩不足——为保证生成质量,多数模型采用较低压缩率(如 8×8×4),导致潜空间 token 数量庞大、计算昂贵,且常需级联的超分模块。
LTX-Video 提出一种 holistic(整体式)潜在扩散范式,把 VAE 与去噪 Transformer 深度融合:
- 把 patchify 操作移入 VAE 输入端:传统 DiT 在 Transformer 入口做 patch 化(如 2×2 patch),LTX-Video 把这一步整合进 VAE 编码器,使 VAE 直接输出可供 Transformer 使用的紧凑潜表示,实现 1:192 的总压缩率(32×32×8 时空下采样 + 128 个潜通道)。
- VAE 解码器承担最后一步去噪:不再由 Transformer 在潜空间完成全部去噪,而是让 VAE 解码器在”潜变量→像素”转换的同时执行最后一步去噪(denoising decoder)。高压缩带来的高频细节损失,正好由解码器的最后一步去噪补偿,因此无需额外的超分/上采样模块。
这种设计让整条链路在紧凑潜空间中高效运行,1.9B 参数即达到 SOTA,单张 H100 上 2 秒即可生成 5 秒 768×512@24fps 视频(快于实时)。
三、整体架构
LTX-Video 由两大组件构成:Video-VAE(高压缩编码器 + 去噪解码器)与 Video Transformer(潜空间去噪主干),二者共享同一个扩散目标。
3.1 共享扩散目标(Shared Diffusion Objective)
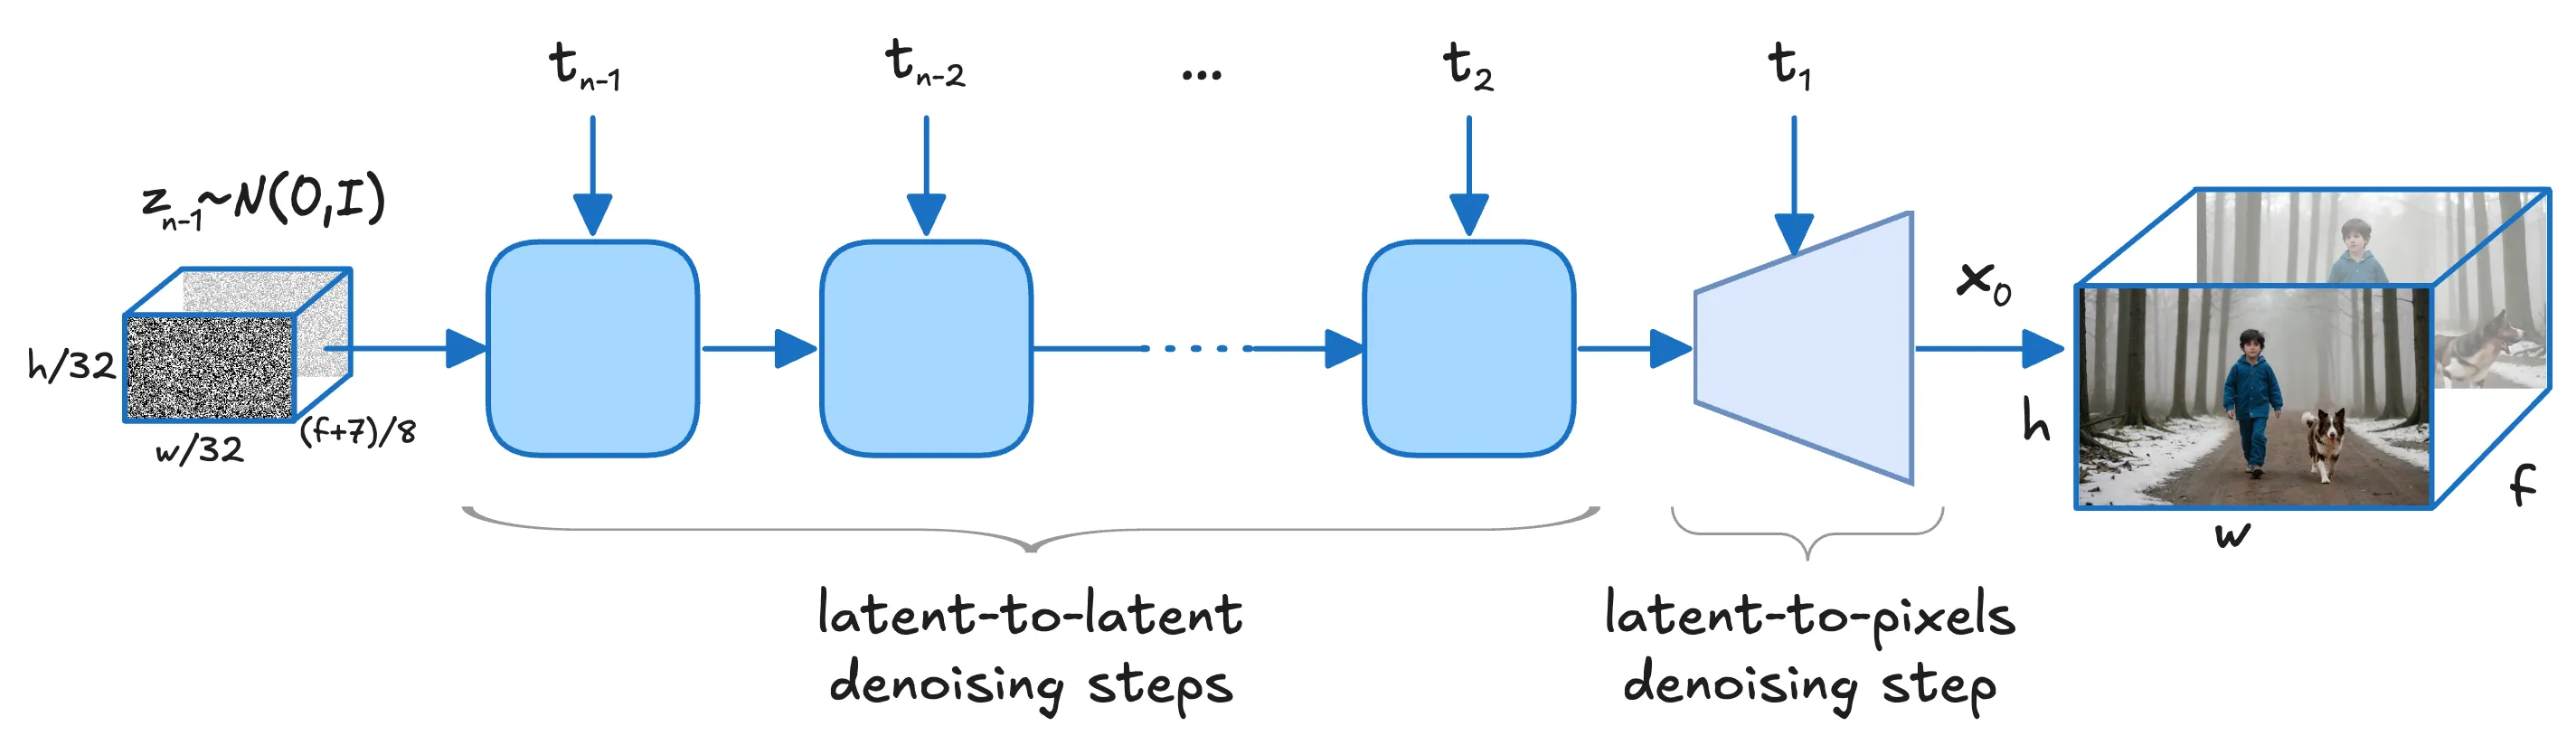
传统流程:Transformer 在潜空间完成 全部 去噪 → VAE 解码器无噪重建像素。
LTX-Video 流程:Transformer 完成 绝大部分 去噪步 → 把仍带少量噪声的潜变量交给 VAE 解码器,由解码器在转像素的同时完成 最后一步去噪。二者共享 rectified-flow 扩散目标,形成一个端到端的去噪链路。消融实验(第五节)表明该设计对高速运动视频的细节恢复尤为关键。
四、关键技术
4.1 Video-VAE:高压缩编码器
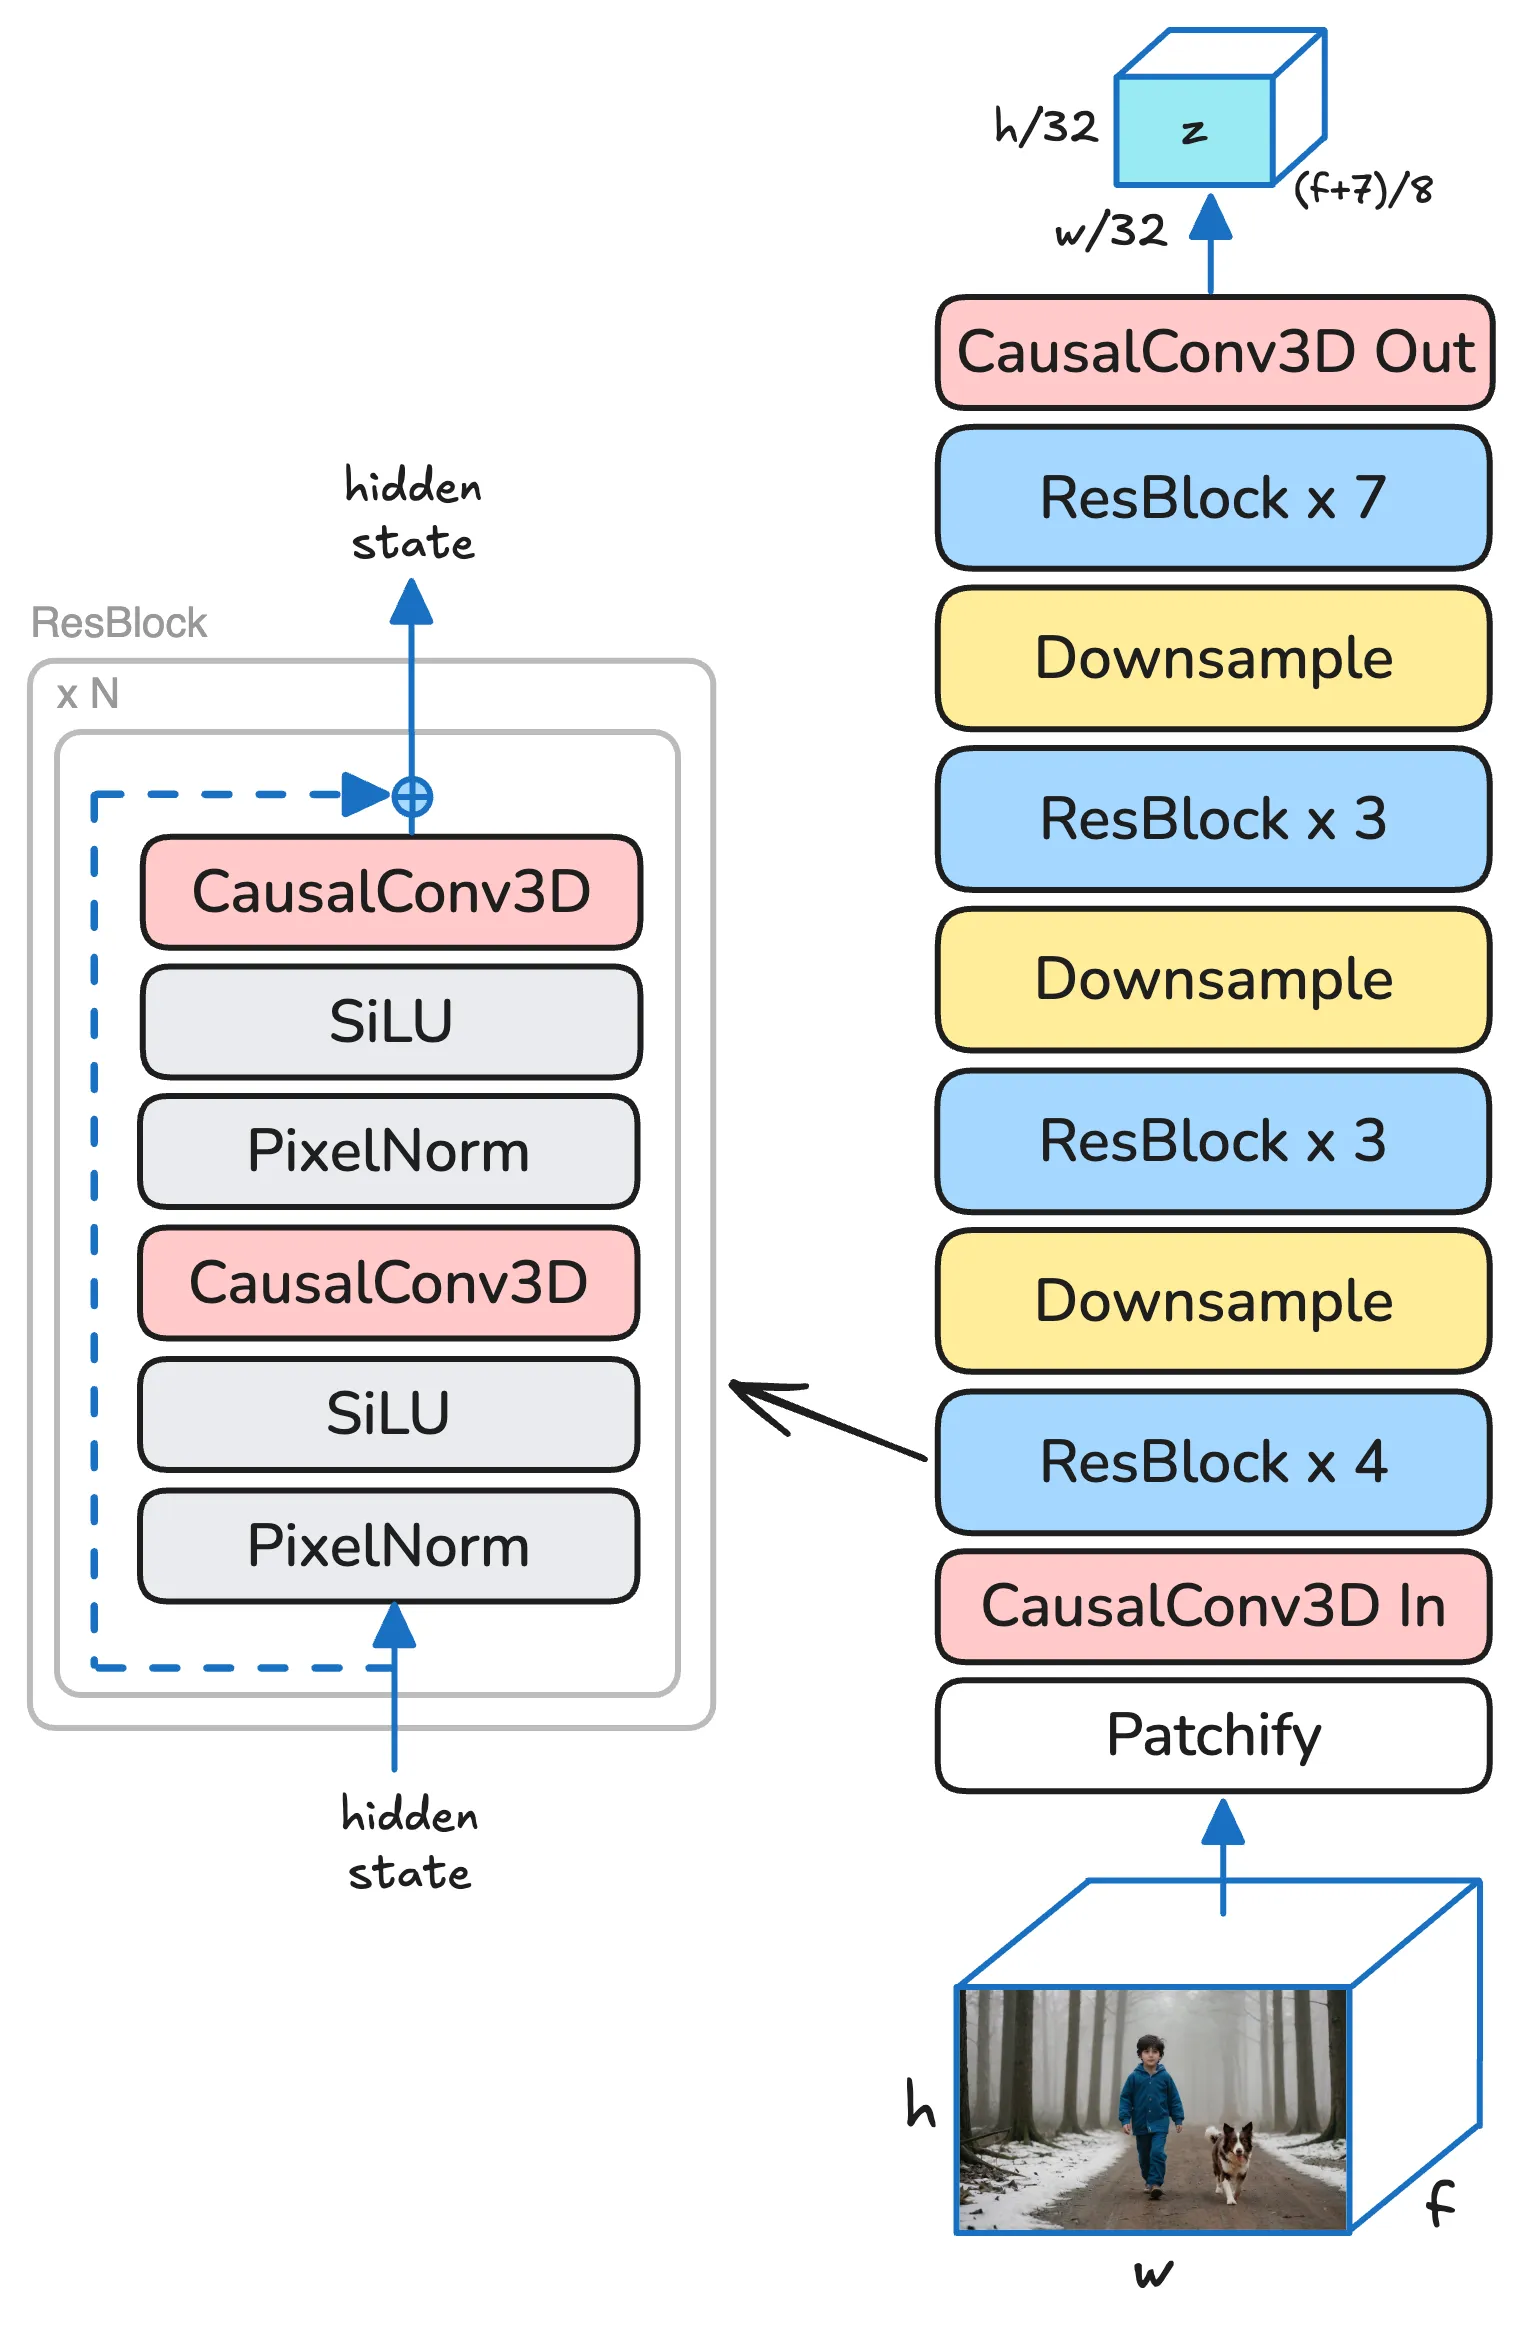
- 因果编码器(Causal Encoder):采用 3D 因果卷积,保证时序上只依赖过去帧;第一帧被单独编码为一个独立的潜帧,便于图像条件生成与首帧对齐。
- 1:192 高压缩:空间 32×32、时间 8 倍下采样,输出 128 个潜通道。像素到 token 比例高达 1:8192,大幅削减 Transformer 需处理的 token 数。
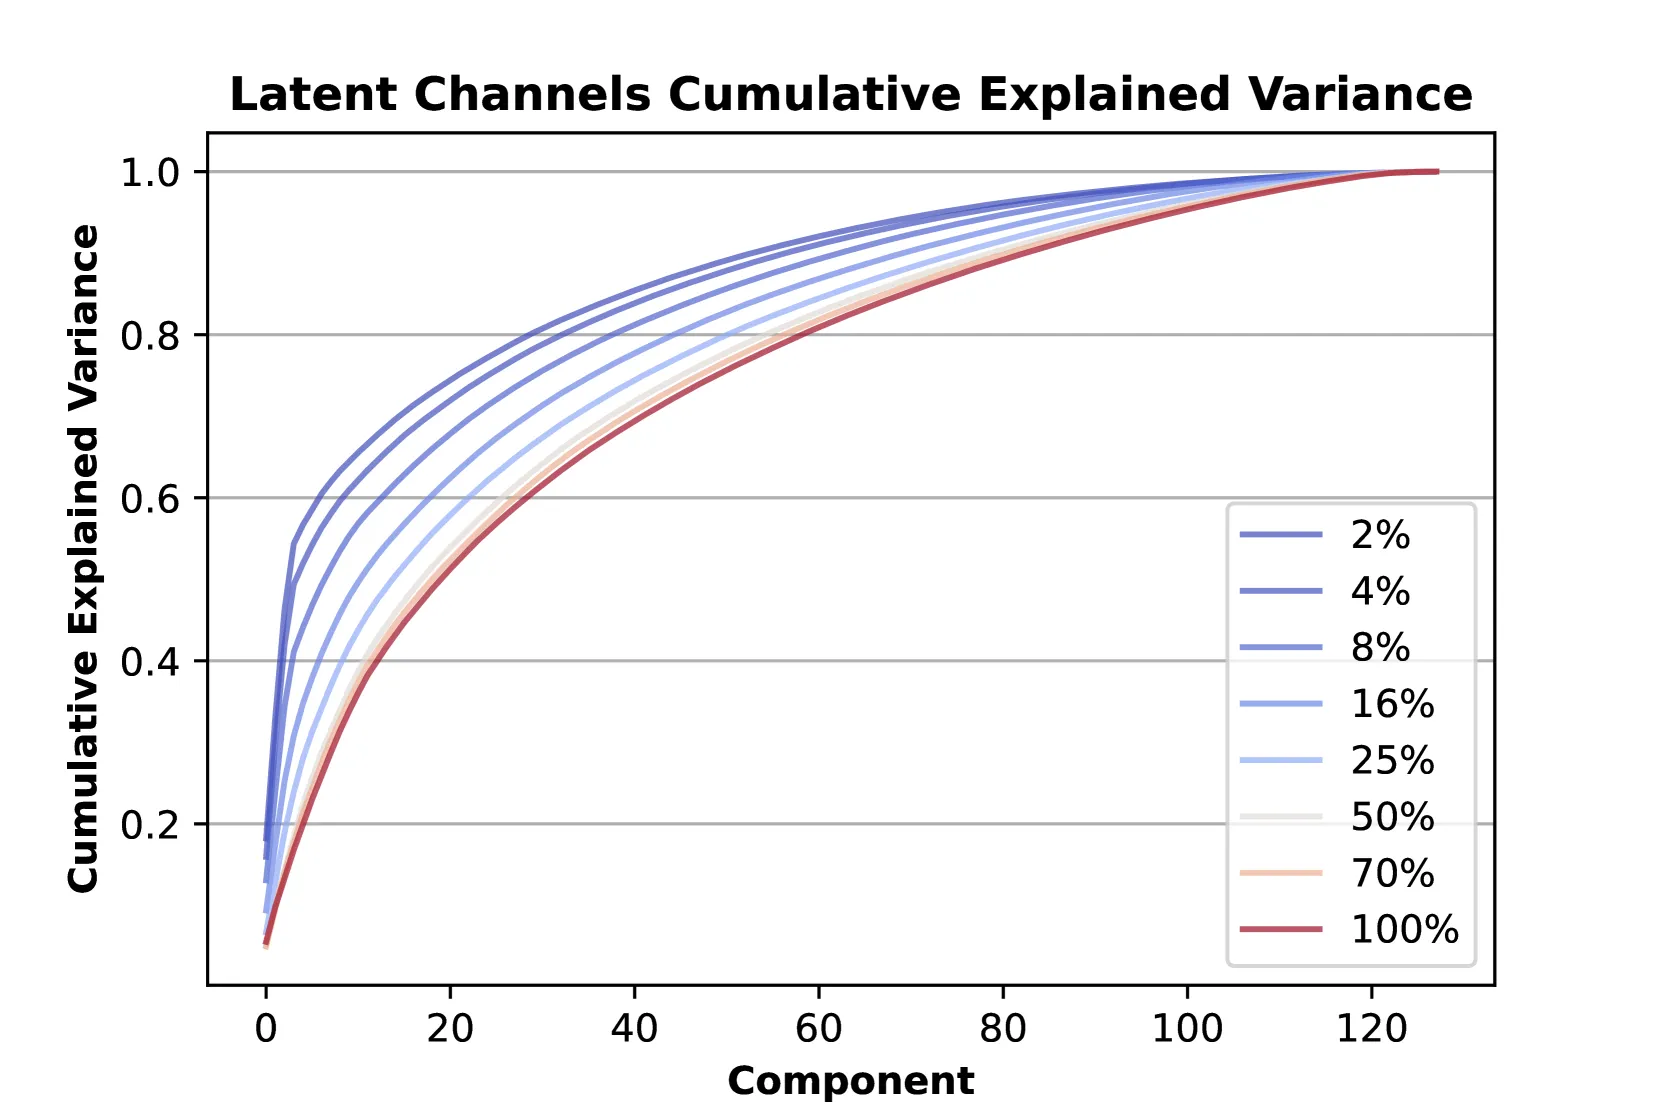
- 均匀对数方差(Uniform log-variance):在所有潜通道上使用统一的对数方差,防止部分通道”饥饿”(channel starvation),使潜空间分布更均衡、更利于扩散建模。
4.2 Video-VAE:去噪解码器
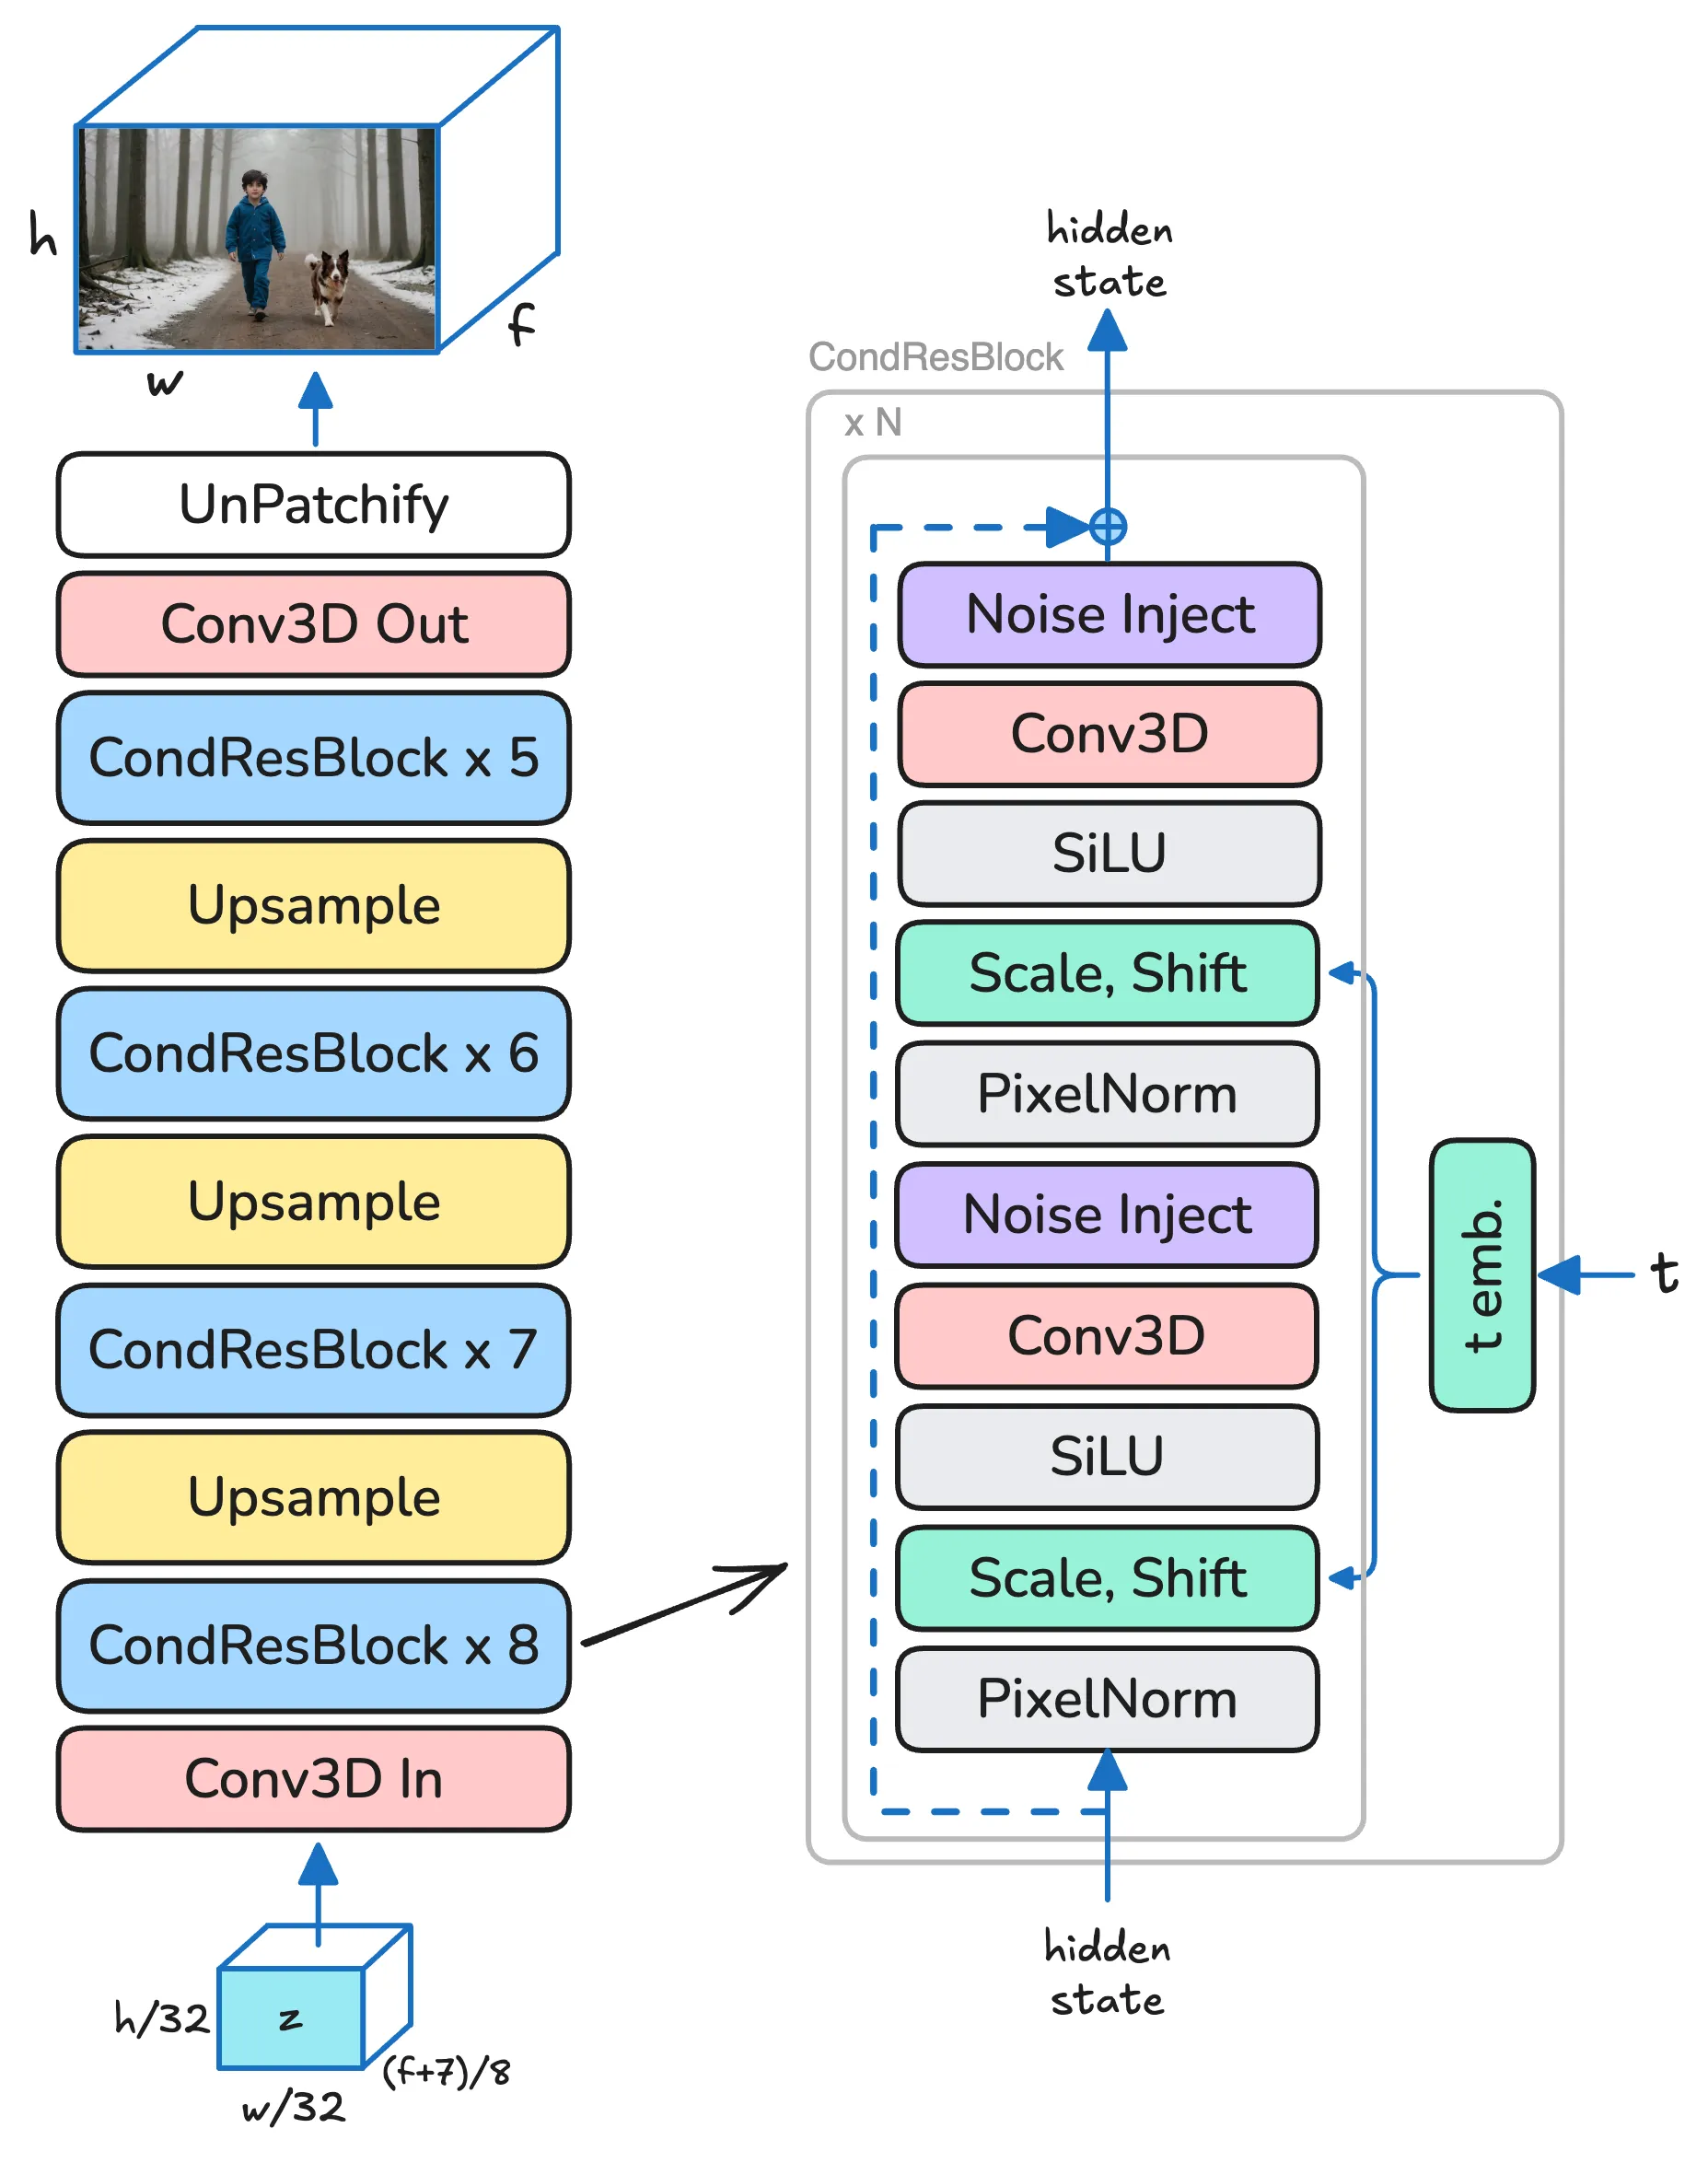
- 扩散时间步条件(diffusion-timestep conditioning):解码器接收扩散时间步作为条件,从而能执行”最后一步去噪”。
- 多层噪声注入(Multi-layer noise injection):借鉴 StyleGAN,在解码器多个层级注入噪声,帮助恢复高压缩下丢失的高频纹理细节。
- 损失函数组合:最终训练损失 = MSE + Video-DWT loss + LPIPS + Reconstruction-GAN。其中 Video-DWT(对视频做 8 个 3D 离散小波变换后取 L1)专门约束多尺度频域细节。
4.3 Reconstruction GAN(新型判别器)
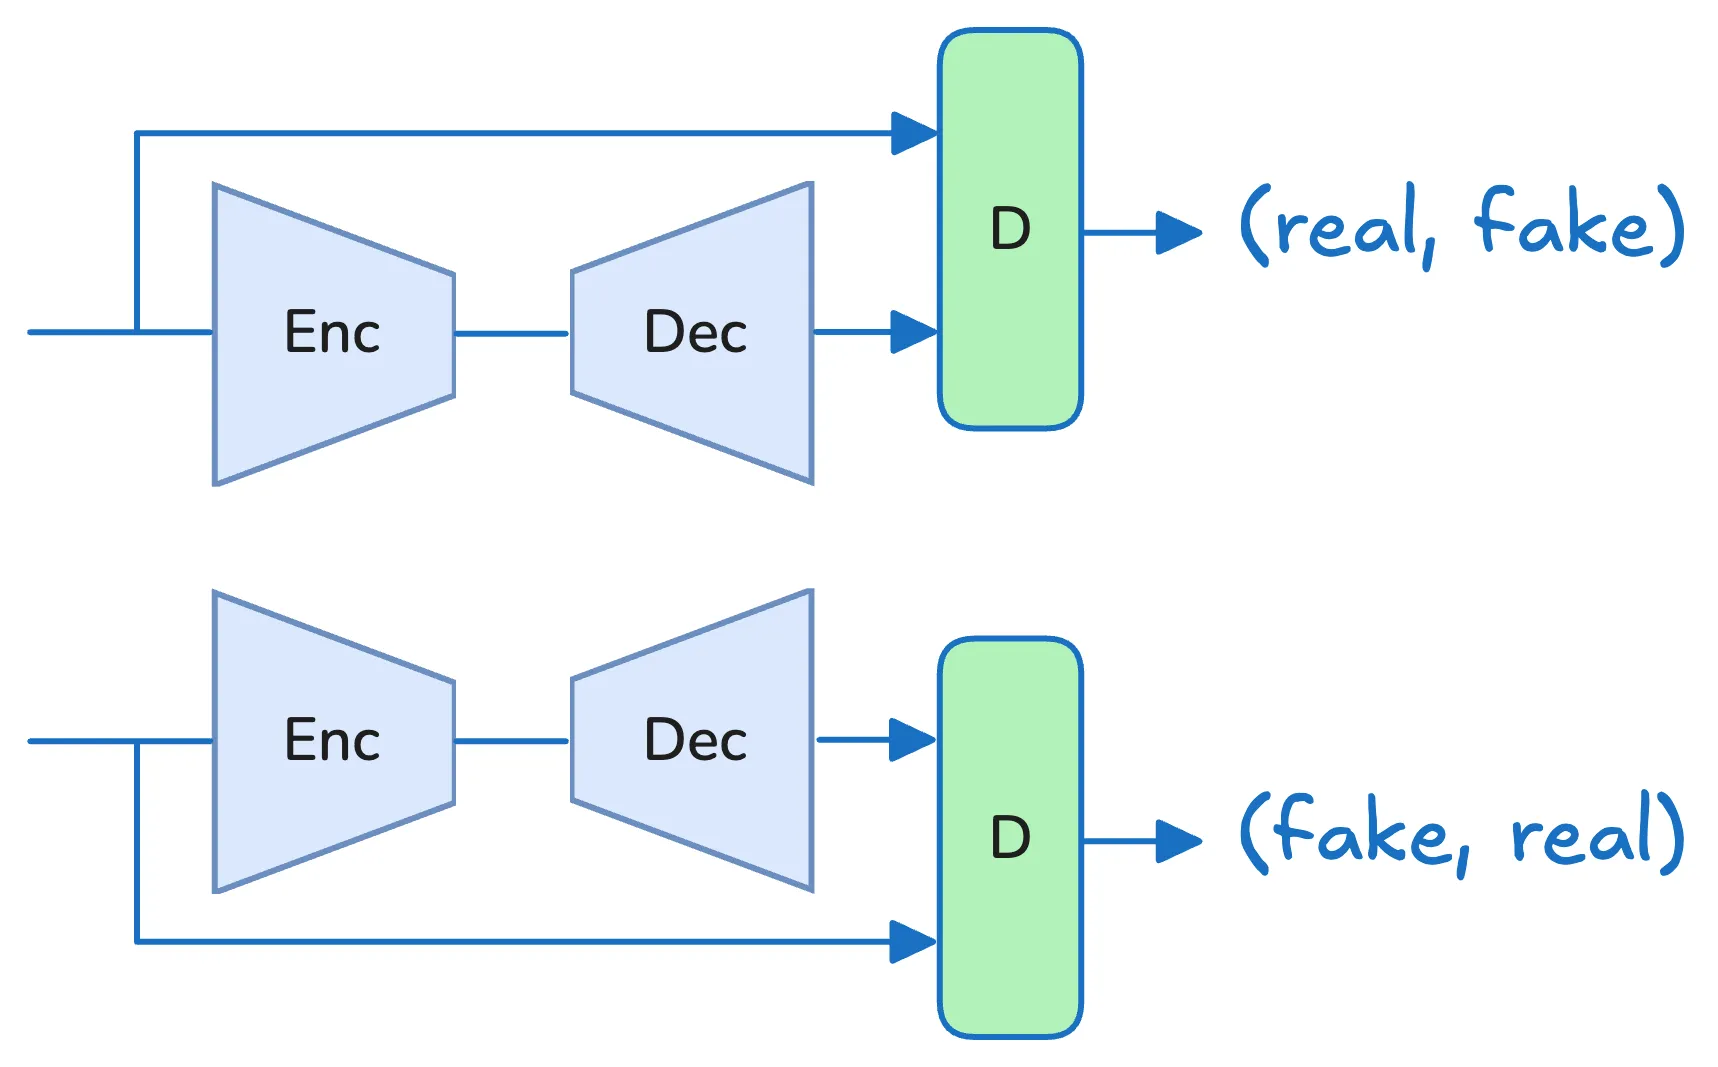
在 1:192 的极高压缩率下,传统”重建损失 + 标准 GAN 损失”难以稳定重建高频细节,尤其在”快速运动 + 复杂纹理”帧上会出现伪影或帧间不一致。
LTX-Video 提出 Reconstruction GAN:判别器同时看到输入帧和重建帧,任务是判断哪一个是真实的原始帧(而非孤立地判断真/假)。这种成对相对判别方式显著减少了可见伪影(见第五节 Fig 16 消融)。
4.4 Video Transformer 与位置编码
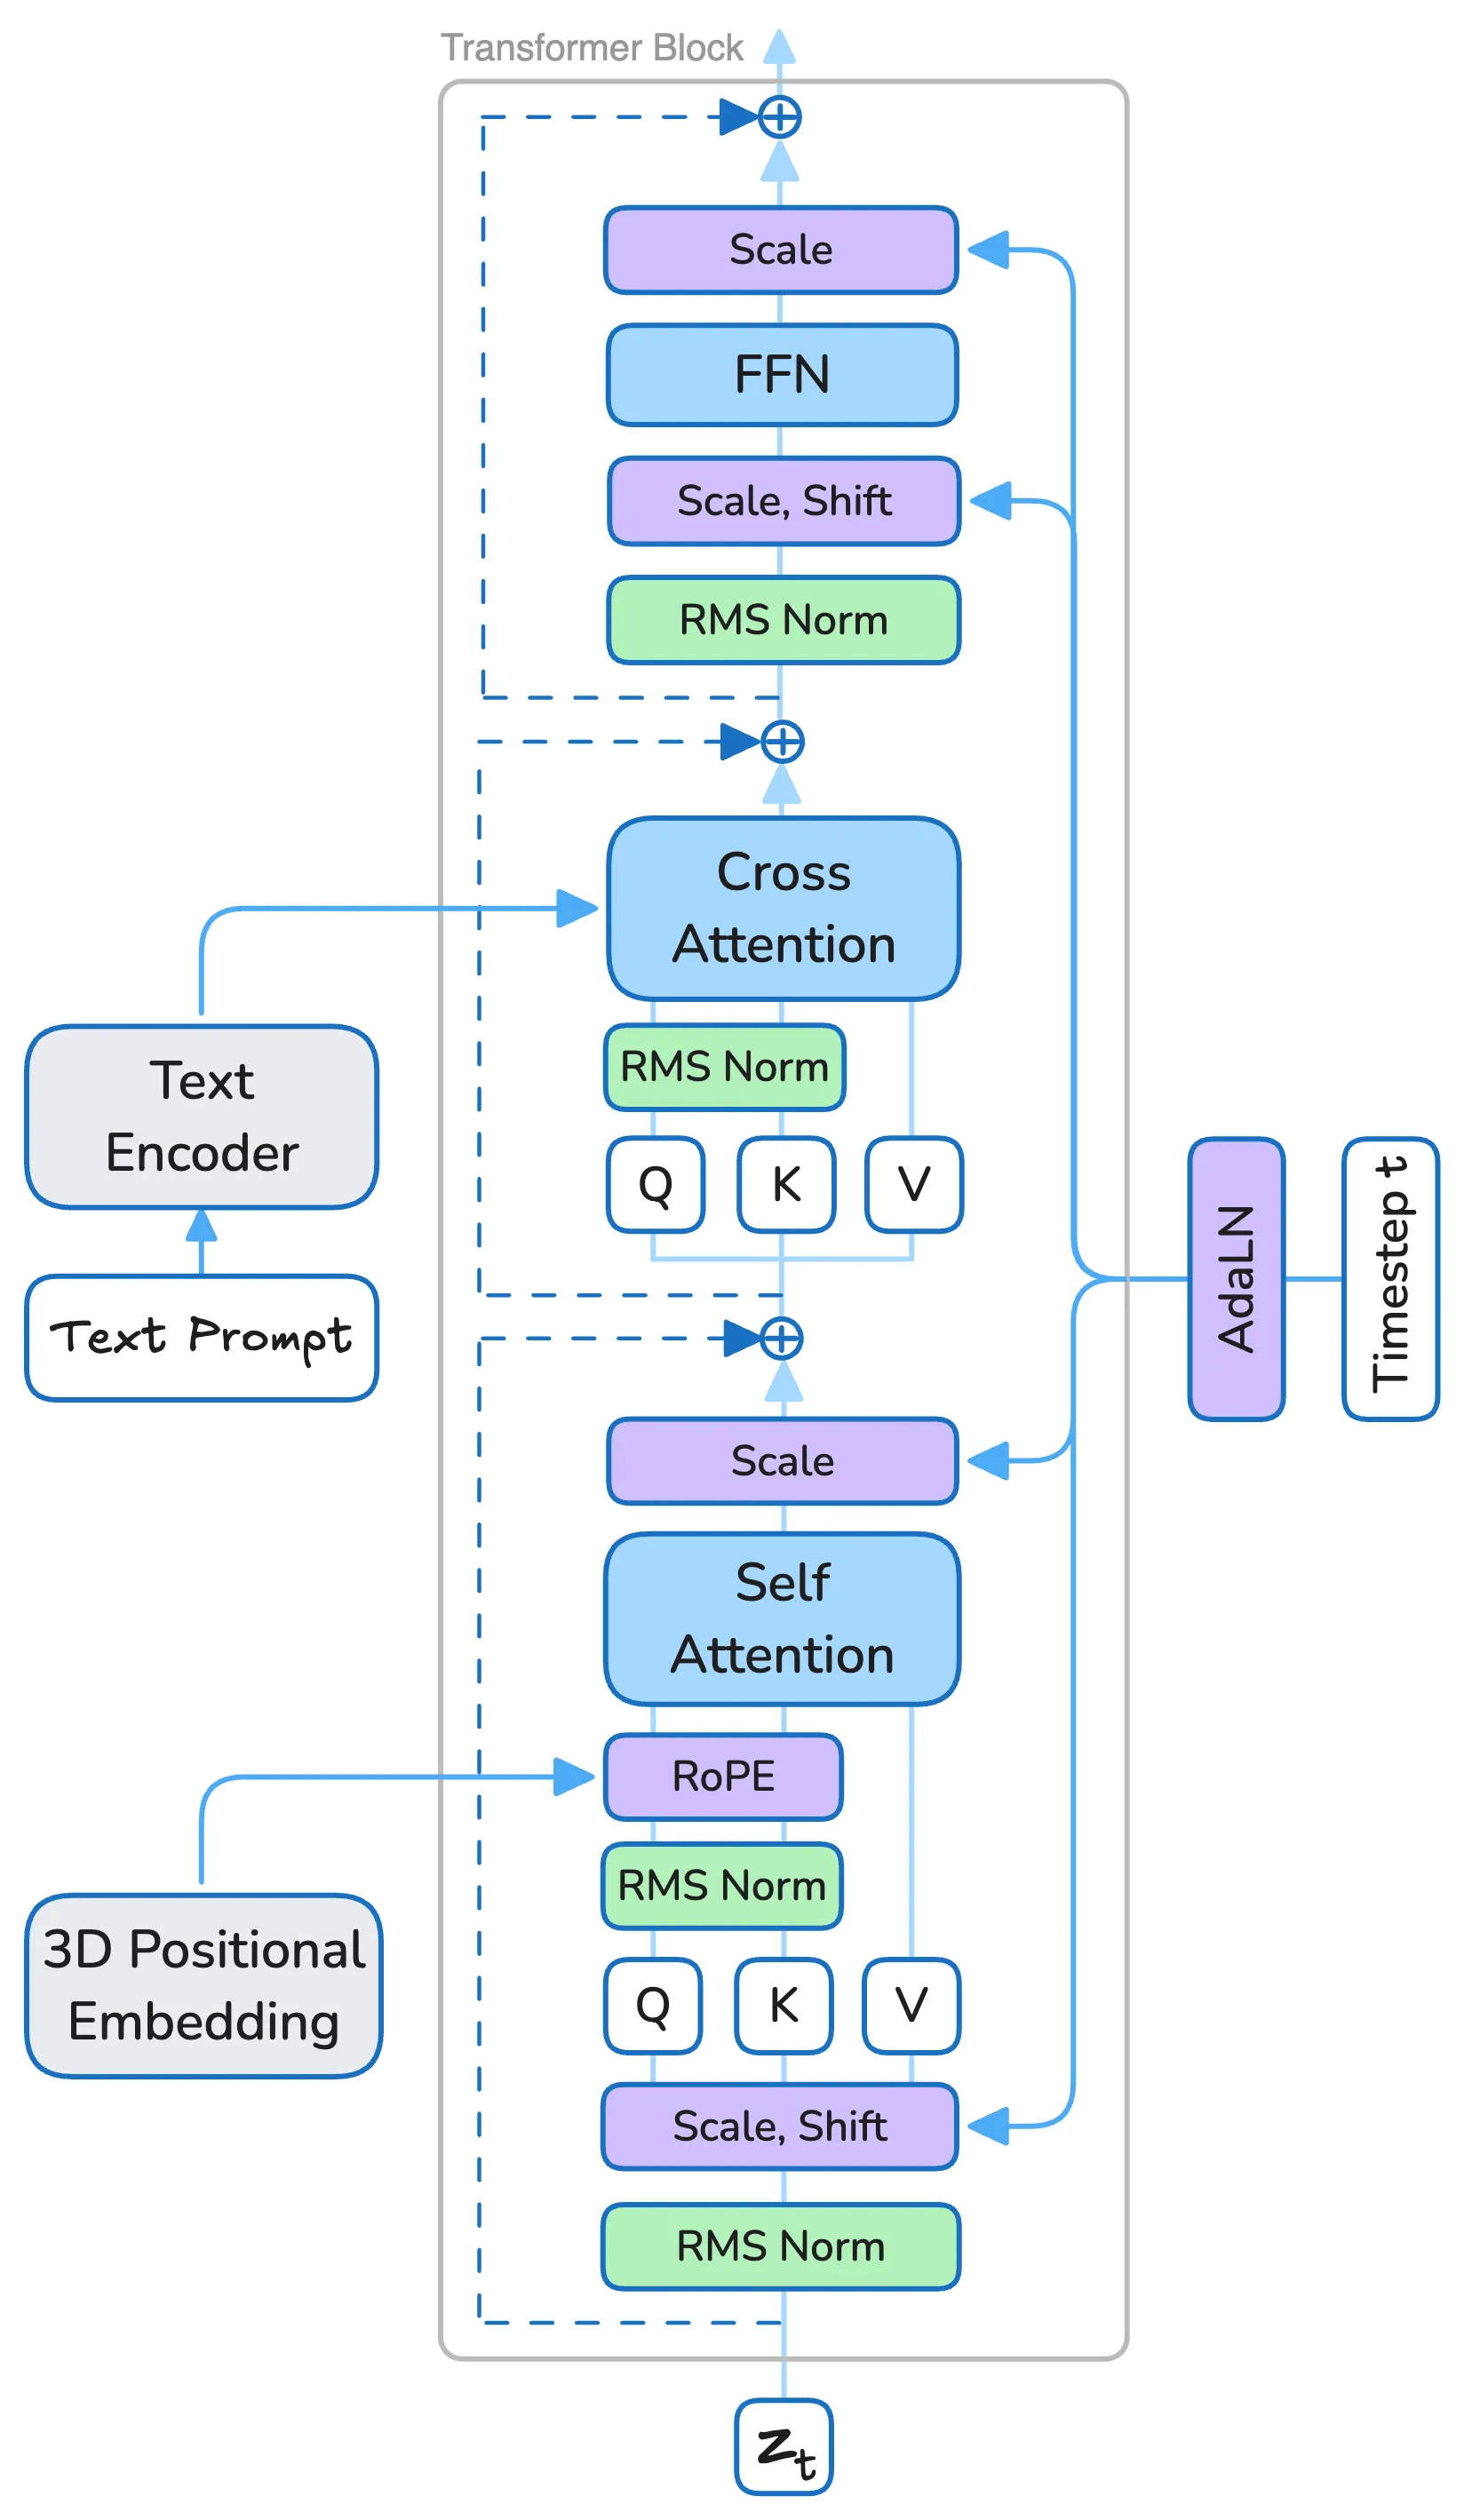
主干基于 Pixart-α 风格的 DiT,1.9B 参数、hidden dim 2048、28 个 Transformer block,采用 Self-Attention + Cross-Attention 结构。两个关键改进:
(1)归一化分数坐标的 RoPE
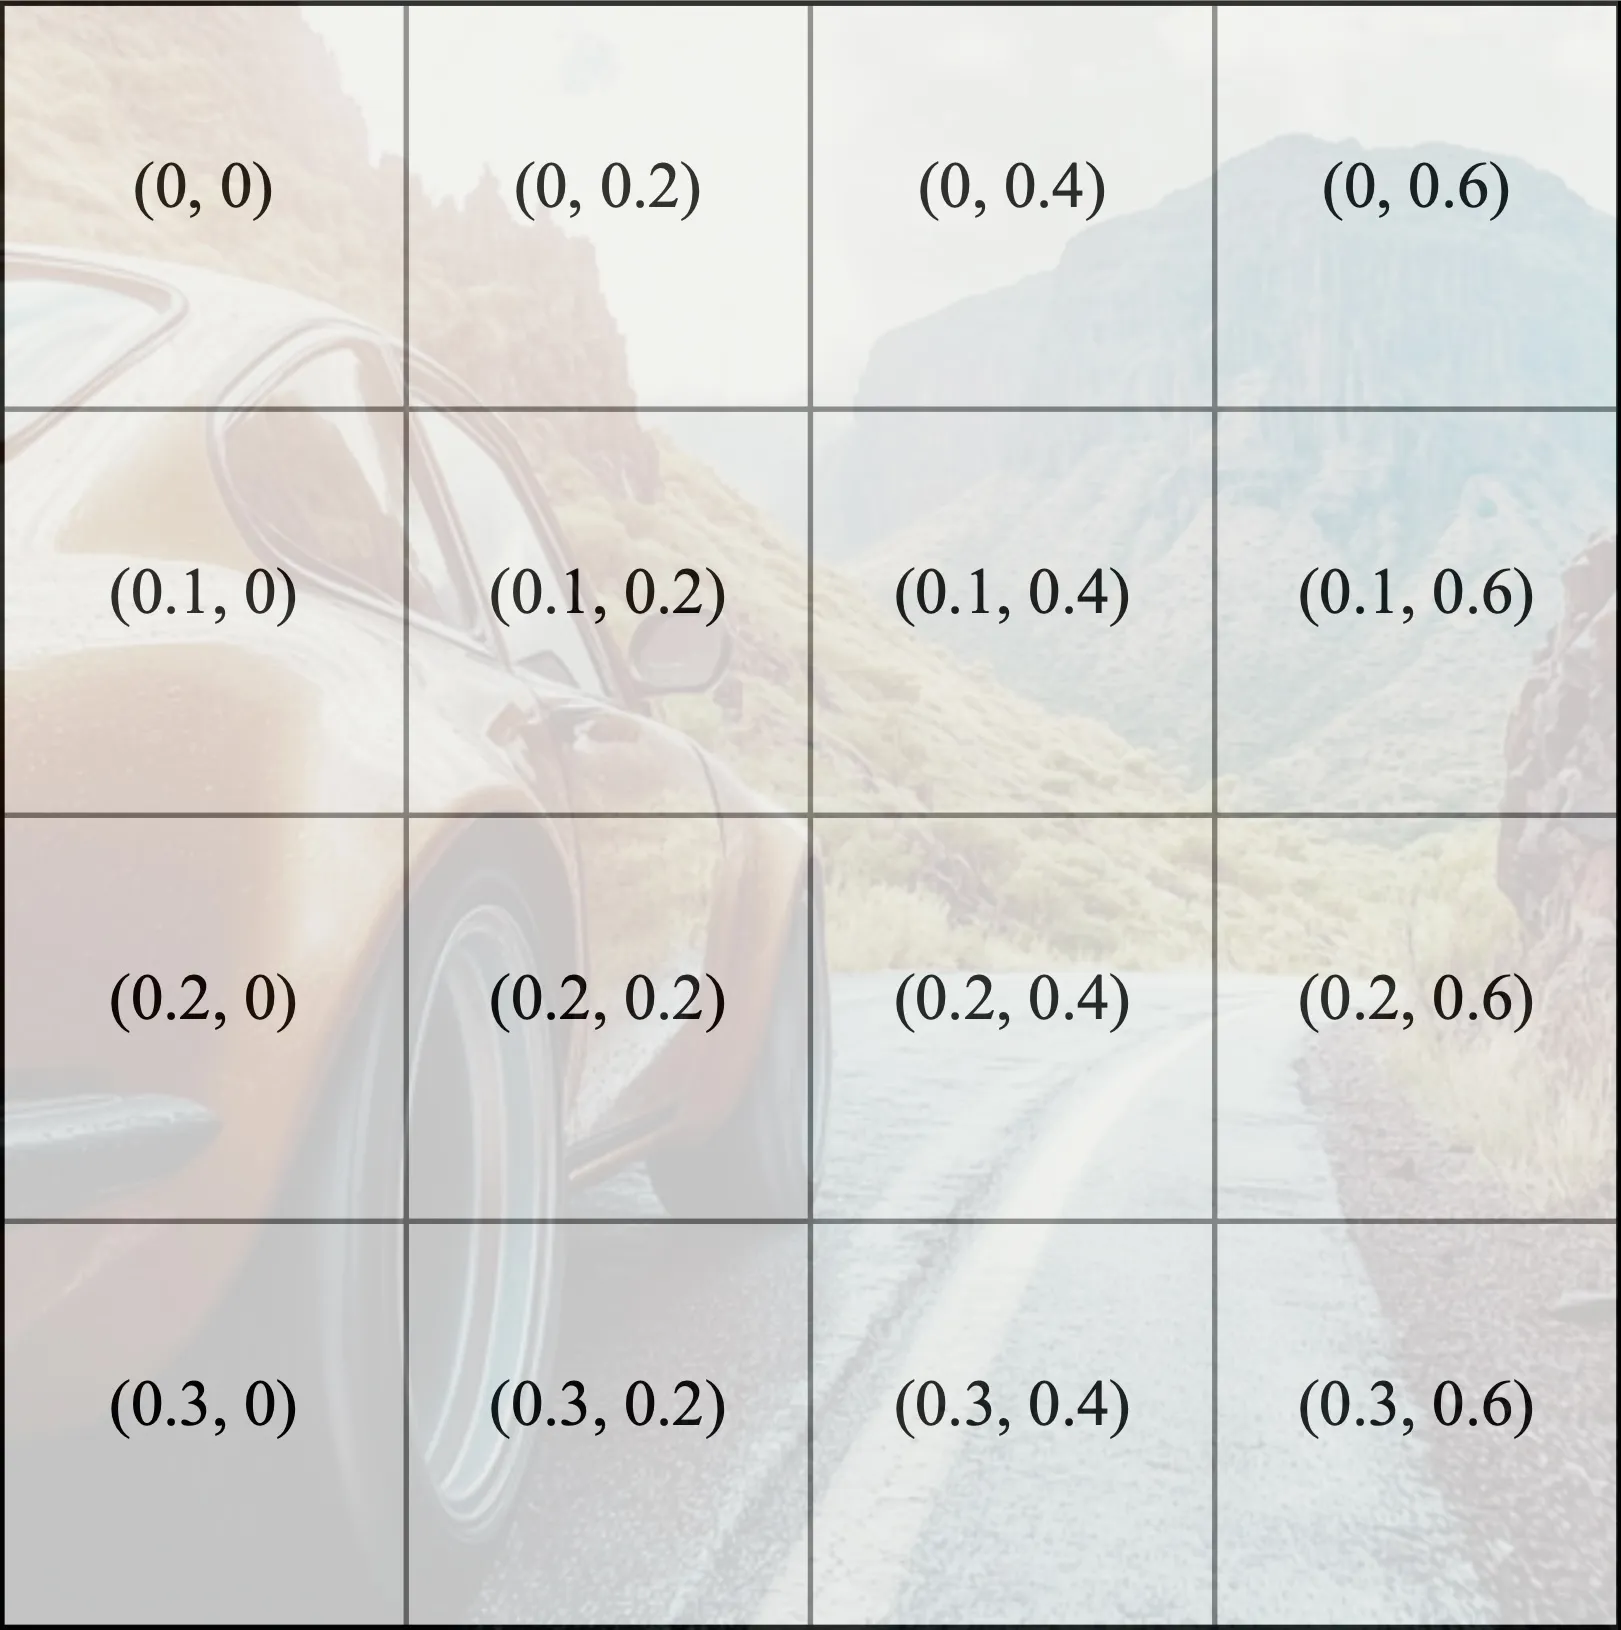
对时空 token 使用 RoPE,但坐标采用归一化的分数坐标:空间维度以像素为单位、时间维度以**秒(结合 FPS)**为单位。这样位置编码与真实物理尺度/时长挂钩,可在不同分辨率、不同帧率、不同时长间良好泛化。
(2)指数频率间隔(Exponential frequency spacing)
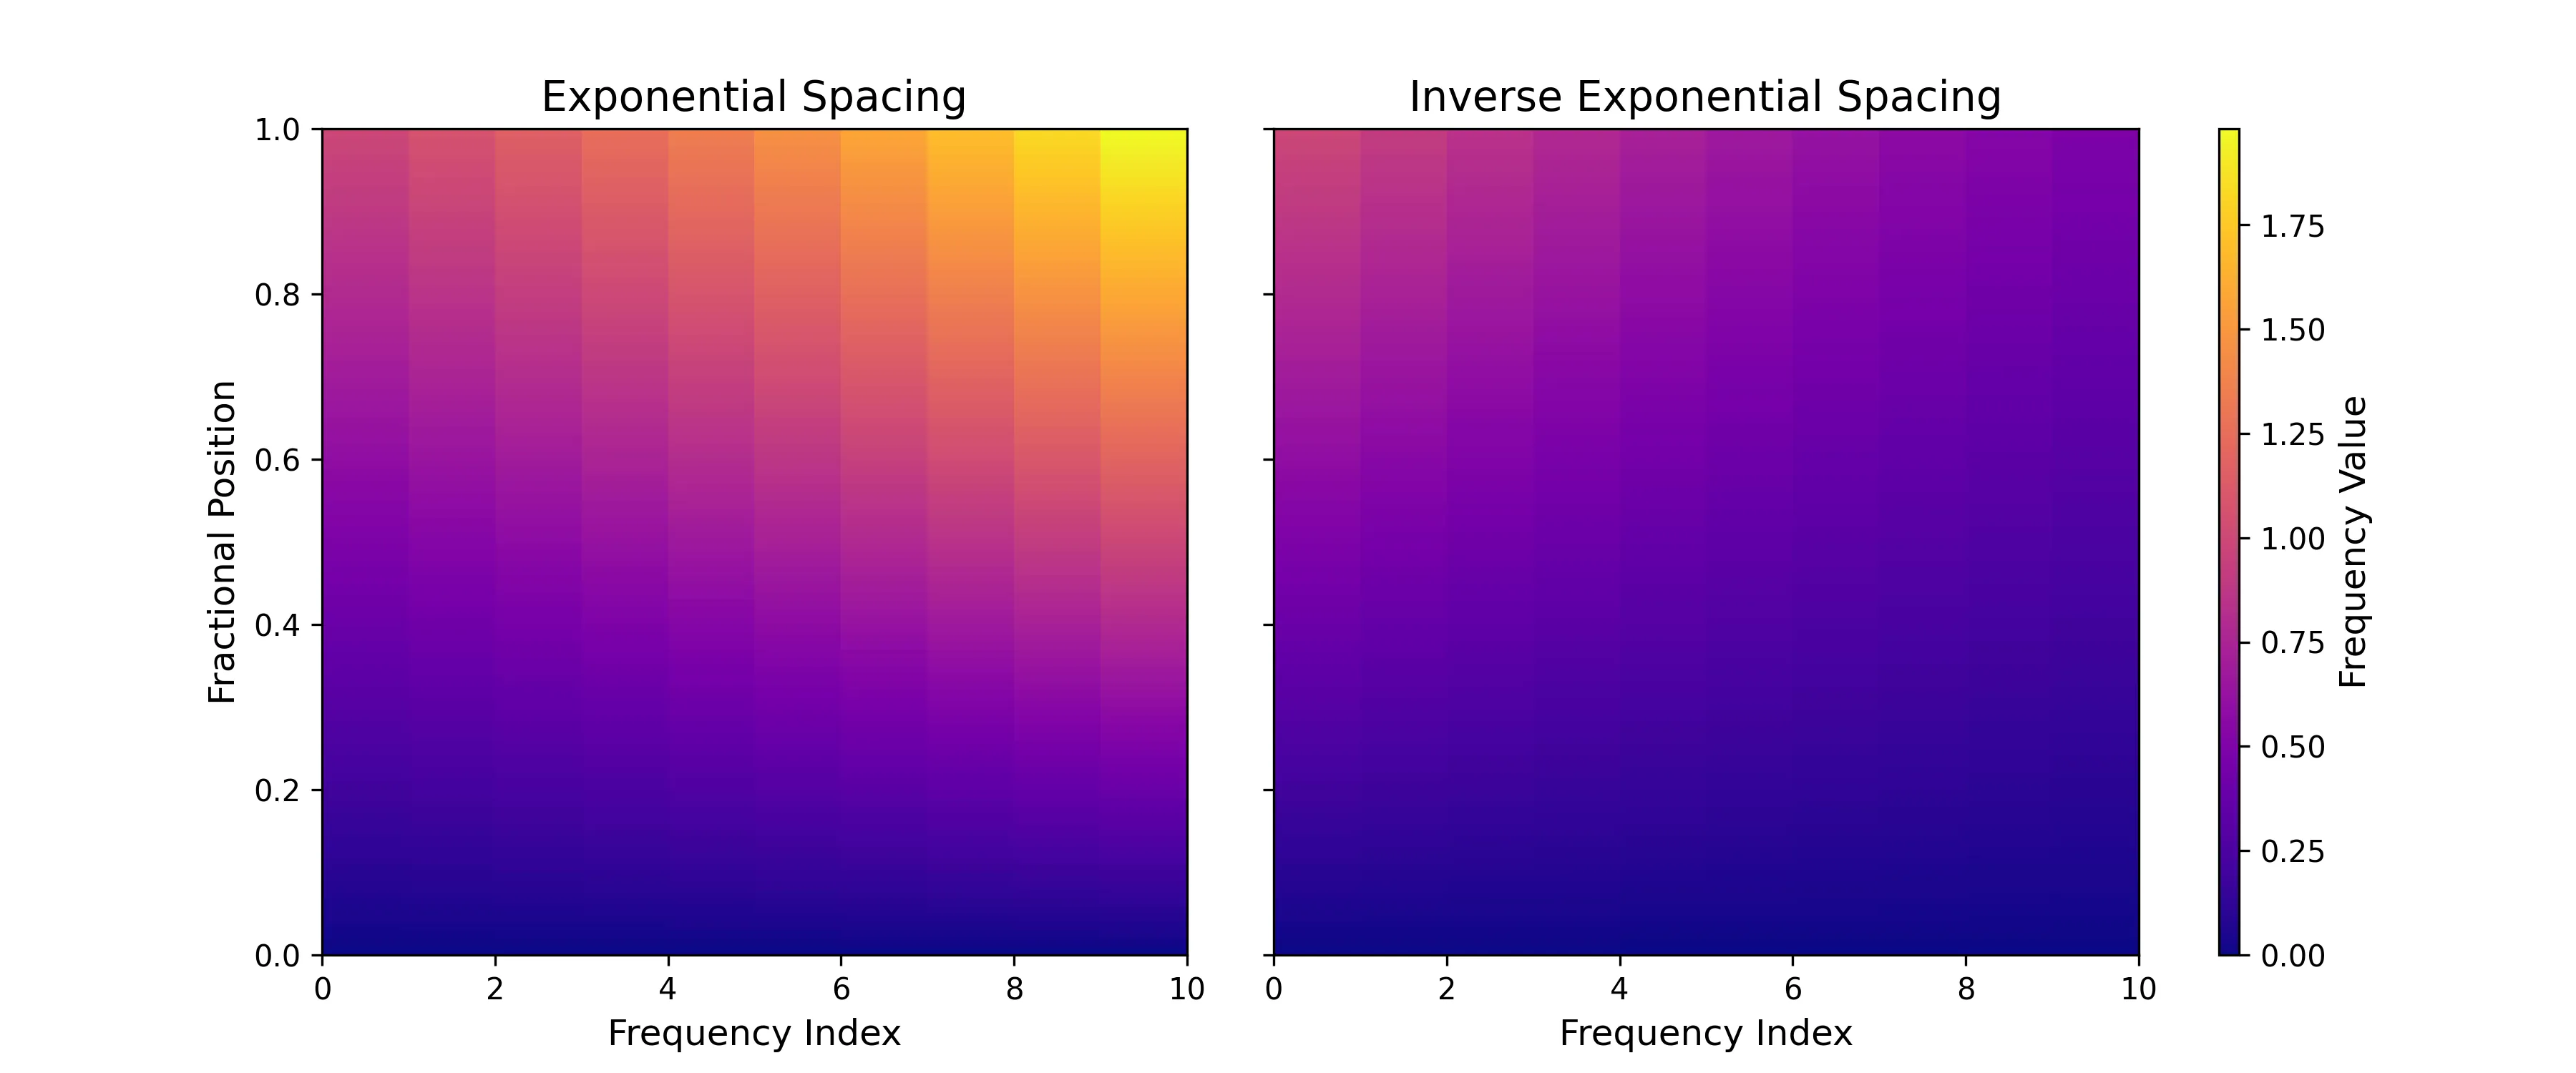
RoPE 的频率间隔采用指数而非常见的逆指数(inverse-exponential)间隔。消融(Fig 17)显示指数间隔的训练损失持续更低。
此外,注意力使用 QK-norm(RMSNorm) 稳定训练。
4.5 文本与图像条件
- 文本条件:T5-XXL 文本编码器 + Cross-Attention 注入。
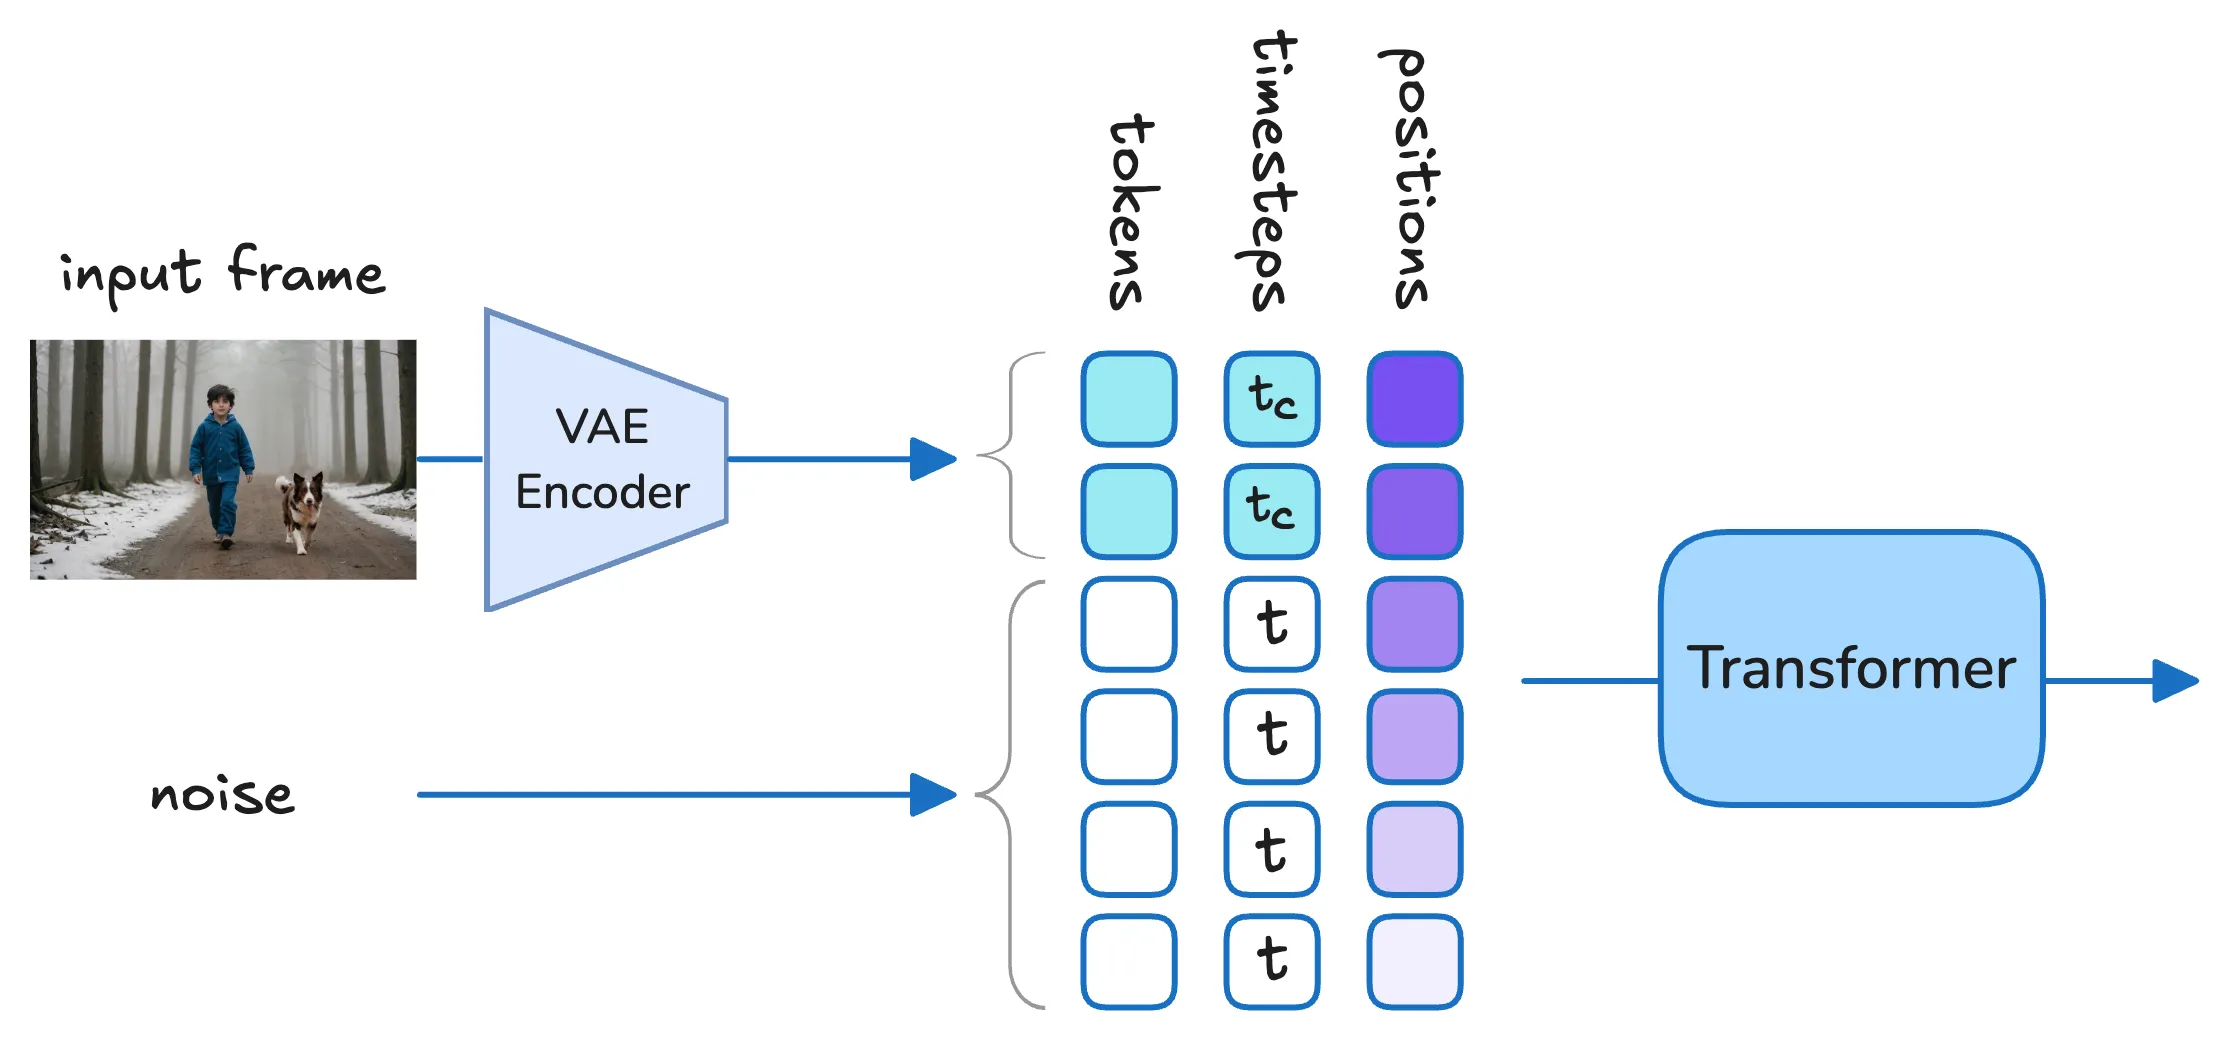
- 图像条件(I2V):基于 Open-Sora 的扩展,采用 per-token timestep(逐 token 时间步)——条件帧对应的 token 时间步设为 0(干净),其余 token 正常加噪,使模型能以任意帧作为条件生成视频。
4.6 Rectified-Flow 训练
- 速度预测(velocity prediction) 的 rectified flow 目标。
- 对数正态时间步采样,并针对高分辨率向高噪声侧偏移(高分辨率需要更强去噪能力),采样时钳制在 0.5–99.9 百分位区间。
- 多分辨率训练,配合 0–20% 的随机 token 丢弃(stochastic token dropping) 提升鲁棒性与效率。
4.7 数据准备
构建了专门的视频描述器(video captioner) 生成密集、详细的训练字幕(Fig 12–14 展示了字幕示例、词云与数据统计)。训练用 ADAM-W 优化器,预训练后在高美学子集上微调。
五、实验与结果
5.1 与同量级模型架构对比(Table 1)
| 模型 | 参数量 | VAE 压缩 | Patchifier | 像素:token | Transformer block | 注意力 | 需超分 |
|---|---|---|---|---|---|---|---|
| MovieGen | 30B | — | — | — | — | — | — |
| HunyuanVideo | 13B | — | — | — | — | — | — |
| PyramidFlow | 2B | — | — | — | — | — | — |
| CogVideoX | 2B/5B | 8×8×4 | 2×2×1 | — | — | Full/Expert | — |
| LTX-Video | 1.9B | 32×32×8 | 1×1×1(并入 VAE) | 1:8192 | 28 | Self+Cross | 否 |
LTX-Video 以最小的参数量、最高的压缩率、且无需超分模块,实现了极致的推理效率。
5.2 人评结果(Table 2)
遵循 MovieGen 的评测协议:1000 条 T2V prompt、1000 对 I2V(图像由 FLUX.1 生成),统一 5 秒 768×512、40 步扩散,20 名评测者盲测配对打分(分两组各 10 人,组间胜率差 <2%)。
胜率(wins/(wins+losses)):
| 任务 | Open-Sora Plan | CogVideoX 2B | PyramidFlow | LTX-Video |
|---|---|---|---|---|
| 文生视频 T2V | 20% | 38% | 51% | 85% |
| 图生视频 I2V | 20% | 47% | 35% | 91% |
LTX-Video 在两项任务上均显著领先同量级开源模型,同时具备巨大速度优势。
5.3 消融实验
(1)Reconstruction GAN vs 传统 GAN
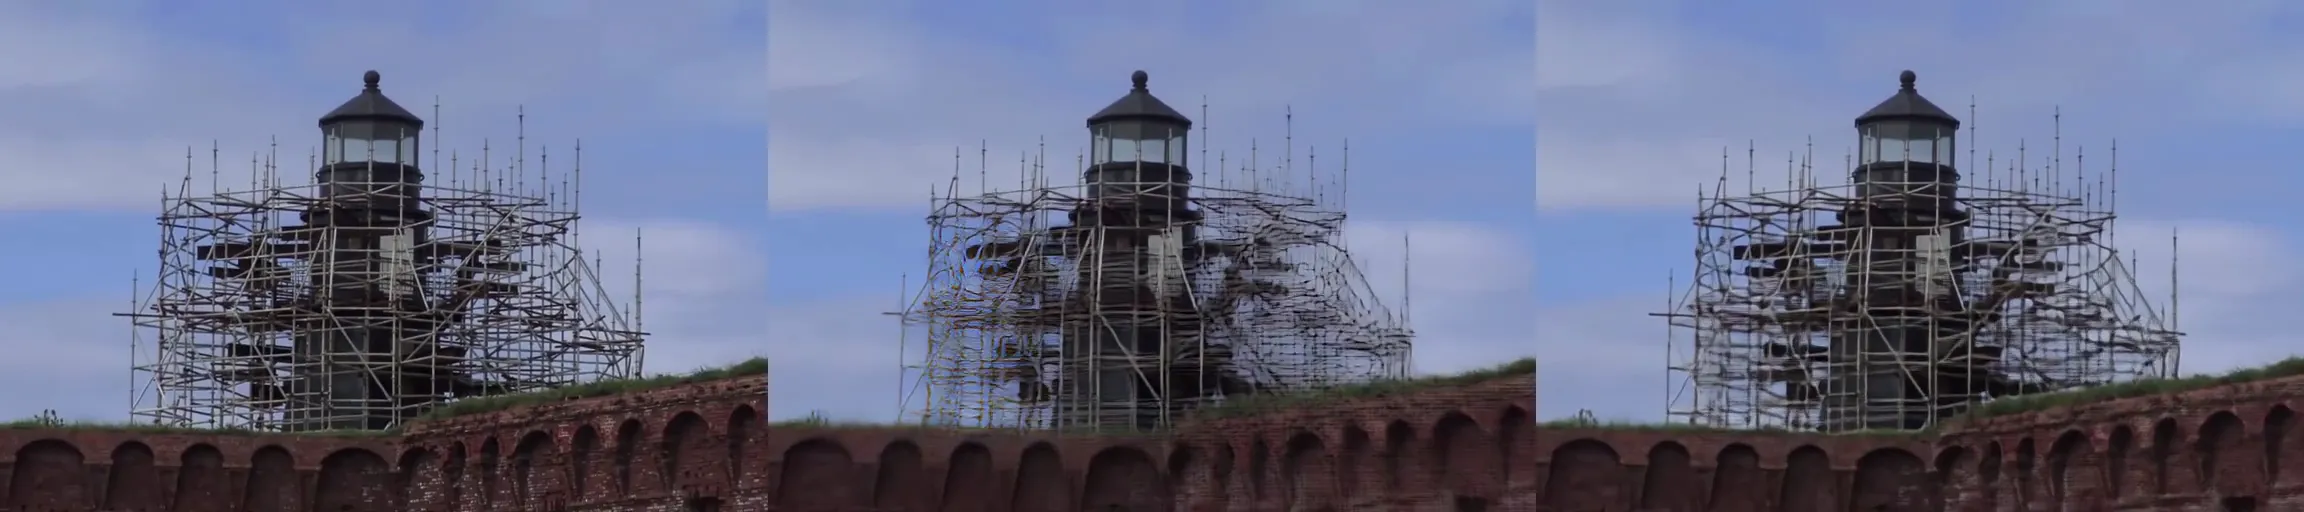
在 1:192 压缩下,标准 GAN 损失在快速运动 + 复杂细节帧上产生可见伪影(单帧可见,播放时帧间不一致更明显);Reconstruction GAN 显著减少这些伪影。
(2)RoPE 频率间隔:指数间隔的训练损失持续低于逆指数间隔(Fig 17)。
(3)去噪 VAE 解码器:内部用户研究对比”解码器条件 t=0.05(执行最后一步去噪)“与”t=0.0(不去噪)“。结果强烈偏好去噪方案,在高速运动视频上改善尤为明显——高压缩带来的伪影被解码器的最后一步去噪有效缓解,验证了 holistic 设计的核心价值。
六、核心创新与贡献
| 创新点 | 说明 |
|---|---|
| Holistic 潜在扩散 | 把 patchify 移入 VAE、VAE 解码器兼任最后一步去噪,VAE 与 Transformer 深度融合而非割裂 |
| 1:192 极高压缩 | 32×32×8 时空下采样 + 128 潜通道,像素:token = 1:8192,大幅降低计算量 |
| 免超分模块 | 最后一步去噪与潜转像素合并,直接输出精细细节,省去级联超分 |
| Reconstruction GAN | 判别器成对判别输入与重建,缓解极高压缩下的重建伪影 |
| 归一化分数坐标 RoPE + 指数频率间隔 | 位置编码挂钩真实物理尺度/时长,跨分辨率/帧率/时长泛化 |
| 实时、平民化 | 1.9B 参数、单 H100 2 秒生成 5 秒视频,可在消费级 GPU 运行,全部开源 |
七、局限性
- 对 prompt 敏感:措辞模糊或质量低的 prompt 会导致输出连贯性下降。
- 仅支持短视频:目前限于 ≤10 秒;长视频的时序一致性与 prompt 保真仍是开放问题。
- 领域泛化未充分验证:对多视角合成、细粒度编辑等专门任务的适配性尚未系统评估。
八、总结
LTX-Video 的核心洞见是:VAE 与扩散 Transformer 不必割裂。通过把 patchify 下沉到 VAE、并让 VAE 解码器承担最后一步去噪,模型得以在 1:192 的极高压缩潜空间中高效运行,用 1.9B 参数换来快于实时的生成速度与 SOTA 质量,且完全开源、可在消费级 GPU 部署。它为”高压缩 + holistic 去噪”这一效率路线提供了有力范例。
九、参考资源
- 论文(arXiv):LTX-Video: Realtime Video Latent Diffusion(arXiv:2501.00103)
- 关键引用:Pixart-α(arXiv:2310.00426)、DiT(Peebles & Xie, ICCV 2023)、RoFormer/RoPE(Su et al., 2024)、Rectified Flow(Esser et al., ICML 2024)、StyleGAN(Karras et al., CVPR 2019)、LPIPS(Zhang et al., CVPR 2018)、MovieGen(arXiv:2410.13720)、CogVideoX(arXiv:2408.06072)、PyramidFlow(arXiv:2410.05954)、Open-Sora-Plan
- 相关文档:
- Video LDM: 高分辨率视频合成的隐扩散模型(潜在扩散视频生成的奠基工作)
- HunyuanVideo: 大规模视频生成框架(13B 开源视频基础模型,同期对比)
- HunyuanVideo 1.5(8.3B 轻量化 + 稀疏注意力加速)
- Movie Gen: 媒体基础模型全家桶(本文人评协议参照对象)
- MagicVideo: 高效视频潜在扩散(另一高效视频 LDM 方向)
- LongCat-Video 技术报告(长视频生成方向)