LinGen: 线性复杂度的高分辨率分钟级文本到视频生成
LinGen 用线性复杂度的 MATE 模块(Bidirectional Mamba2 + TESA)替换 DiT 中二次复杂度的自注意力,首次实现单 GPU 上高分辨率分钟级视频生成,最高 15× FLOPs 加速。
LinGen: Towards High-Resolution Minute-Length Text-to-Video Generation with Linear Computational Complexity
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LinGen: Towards High-Resolution Minute-Length Text-to-Video Generation with Linear Computational Complexity |
| 机构 | Meta(Meta 暑期实习支持)、合作高校 |
| 论文 | https://arxiv.org/abs/2412.09856 (v2, 2025-05-24) |
| 发布 | 2024-12-13(v1),2025-05-24(v2) |
| 分类 | cs.CV (Computer Vision and Pattern Recognition) |
| 资助 | Meta 暑期实习 + NSF Grant CCF-2203399 |
摘要
文本到视频生成计算成本极高:Diffusion Transformer (DiT) 的计算成本随像素数二次增长,使得分钟级视频生成极其昂贵,大多数现有模型只能生成 10–20 秒的视频。LinGen 提出一个线性复杂度的文本到视频生成框架,成本随像素数线性增长。首次实现单 GPU 上高分辨率分钟级视频生成而不损失质量。
其核心是用一个线性复杂度的 MATE 模块替换 DiT 中计算主导、二次复杂度的自注意力。MATE 由两个分支组成:
- MA-branch:针对短-长程相关性,结合双向 Mamba2 与 token 重排(Rotary-Major Scan, RMS)+ review tokens
- TE-branch:TEmporal Swin Attention (TESA),捕获短程空间与中程时间相关性
生成分钟级 16fps 视频时相比 DiT-4B 获得最高 15× FLOPs 加速、11.5× 延迟加速。
二、核心思想
问题定义
高分辨率文本到视频生成是最具挑战的生成任务之一,原因有二:
- 预测数亿像素值的巨大复杂度
- 人眼对帧间不一致性的高度敏感
DiT 自注意力的计算成本随 token 数(=像素数)二次增长,成为分钟级视频生成的瓶颈。现有效率优化(采样蒸馏、分解注意力、SSM)要么保留二次复杂度,要么只能生成低分辨率短视频。
解决方案概述
LinGen 用线性复杂度的 MATE 块替换自注意力,实现整体线性复杂度。关键挑战是解决 Mamba 类模型的 adjacency preservation(相邻性保持)问题 —— 将 3D 视频张量扫描为 1D 序列时,原本相邻的 token 距离被拉远,导致 Mamba 相关性精度随距离衰减而产生失真。
三、技术架构
整体框架
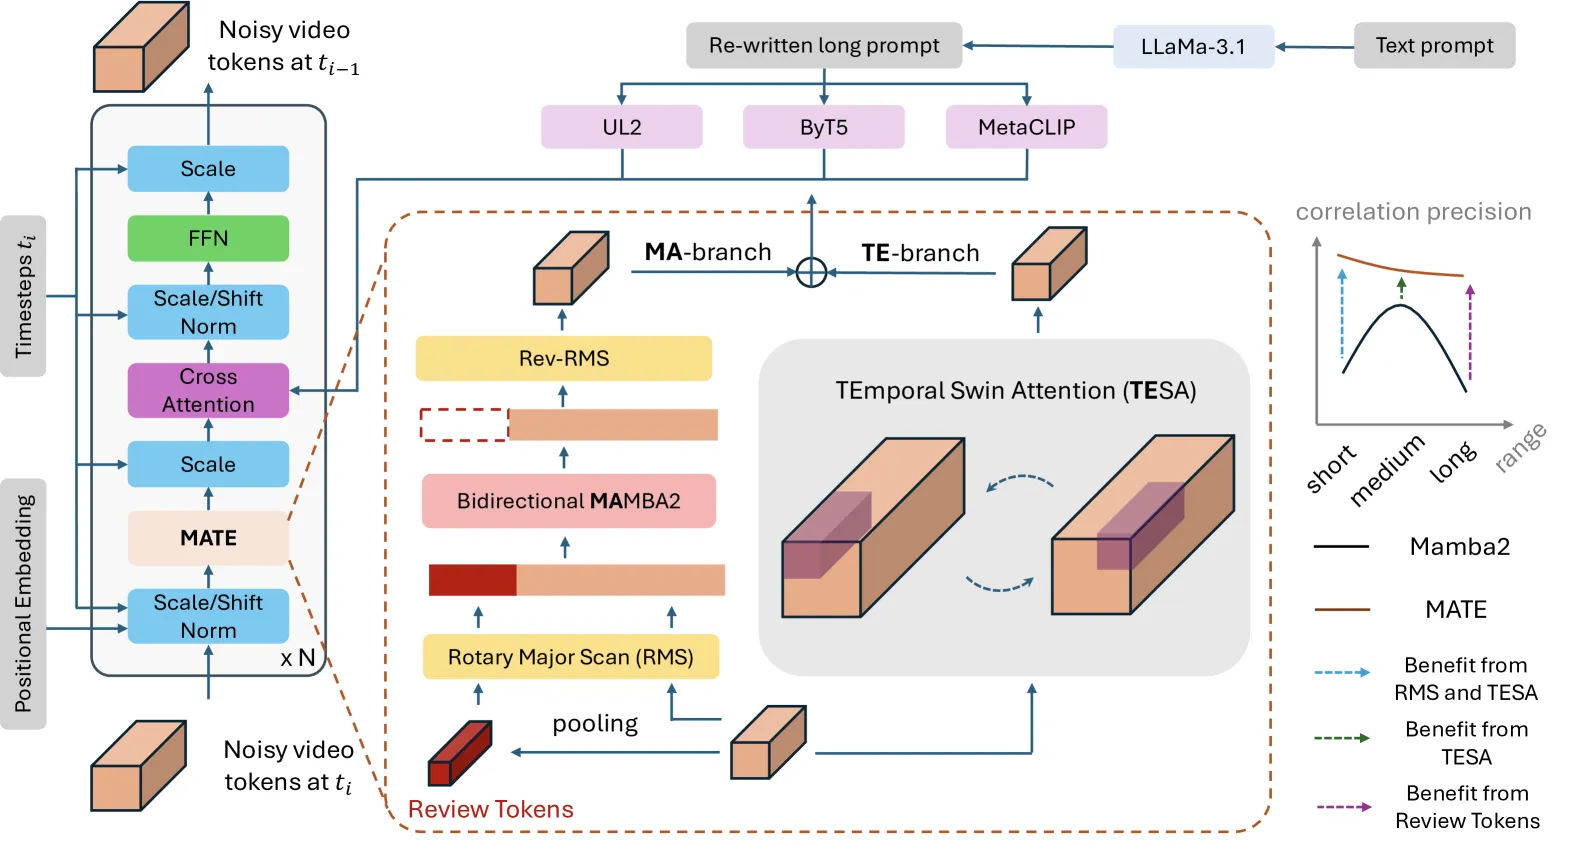
- 潜空间:采用类似 Movie Gen 的 Temporal AutoEncoder 设计
- 去噪:Flow Matching + linear-quadratic t-schedule(沿用 Movie Gen)
- 文本条件:cross-attention 层,条件于三个编码器 —— UL2、ByT5、MetaCLIP,输入为 LLaMa-3.1 重写的长 prompt
- 核心替换:将 vanilla DiT 的自注意力层替换为 MATE 块
MATE 块 = MA-branch(双向 Mamba2 + RMS + review tokens) + TE-branch(TESA)。
MA-Branch: 短-长程相关性
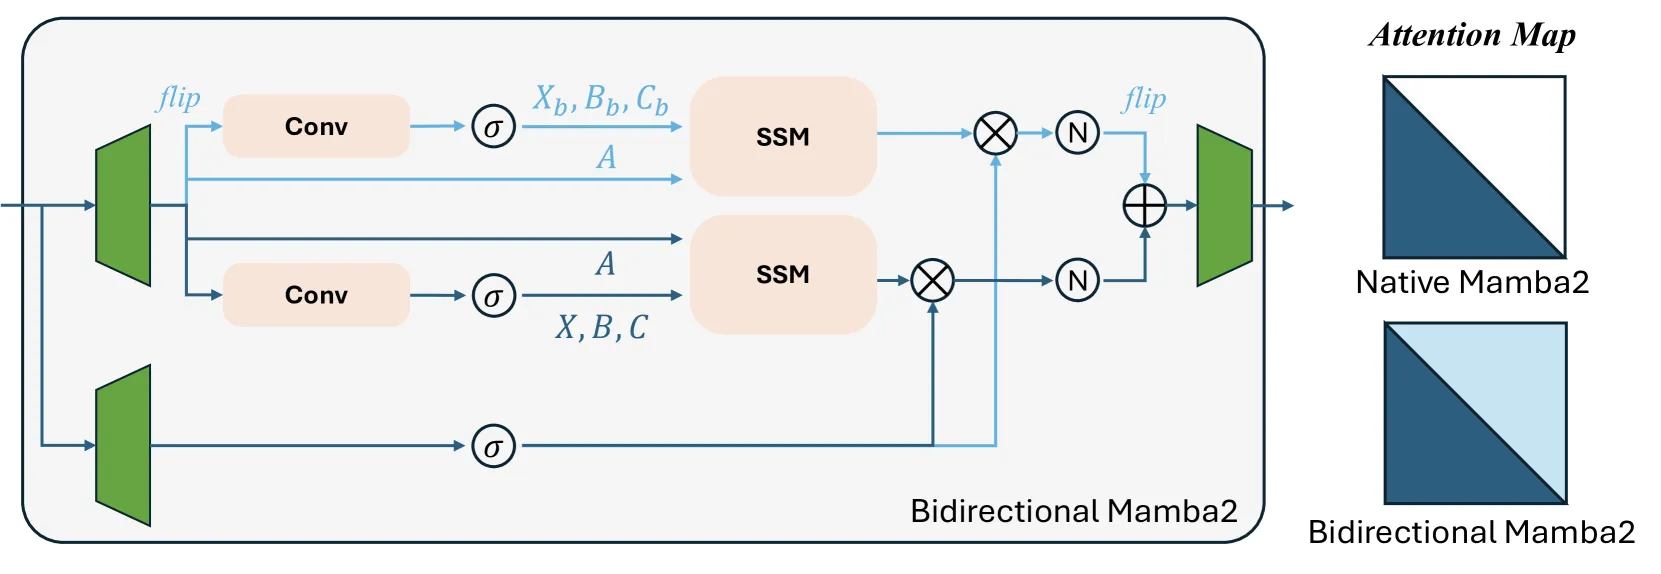
1. 双向 Mamba2:Mamba2 通过结构化状态空间对偶(SSD)统一了 SSM 与掩码高效注意力,比 Mamba 更硬件友好。原生 Mamba2 只生成注意力图的下三角部分,因此 LinGen 用双向版本获得完整相关性图。其 FLOPs:
其中 为扩展因子, 为 token 嵌入维度, 为 token 数, 为隐状态大小, 为头维度(默认 64)。 随 线性增长。
2. Rotary-Major Scan (RMS):
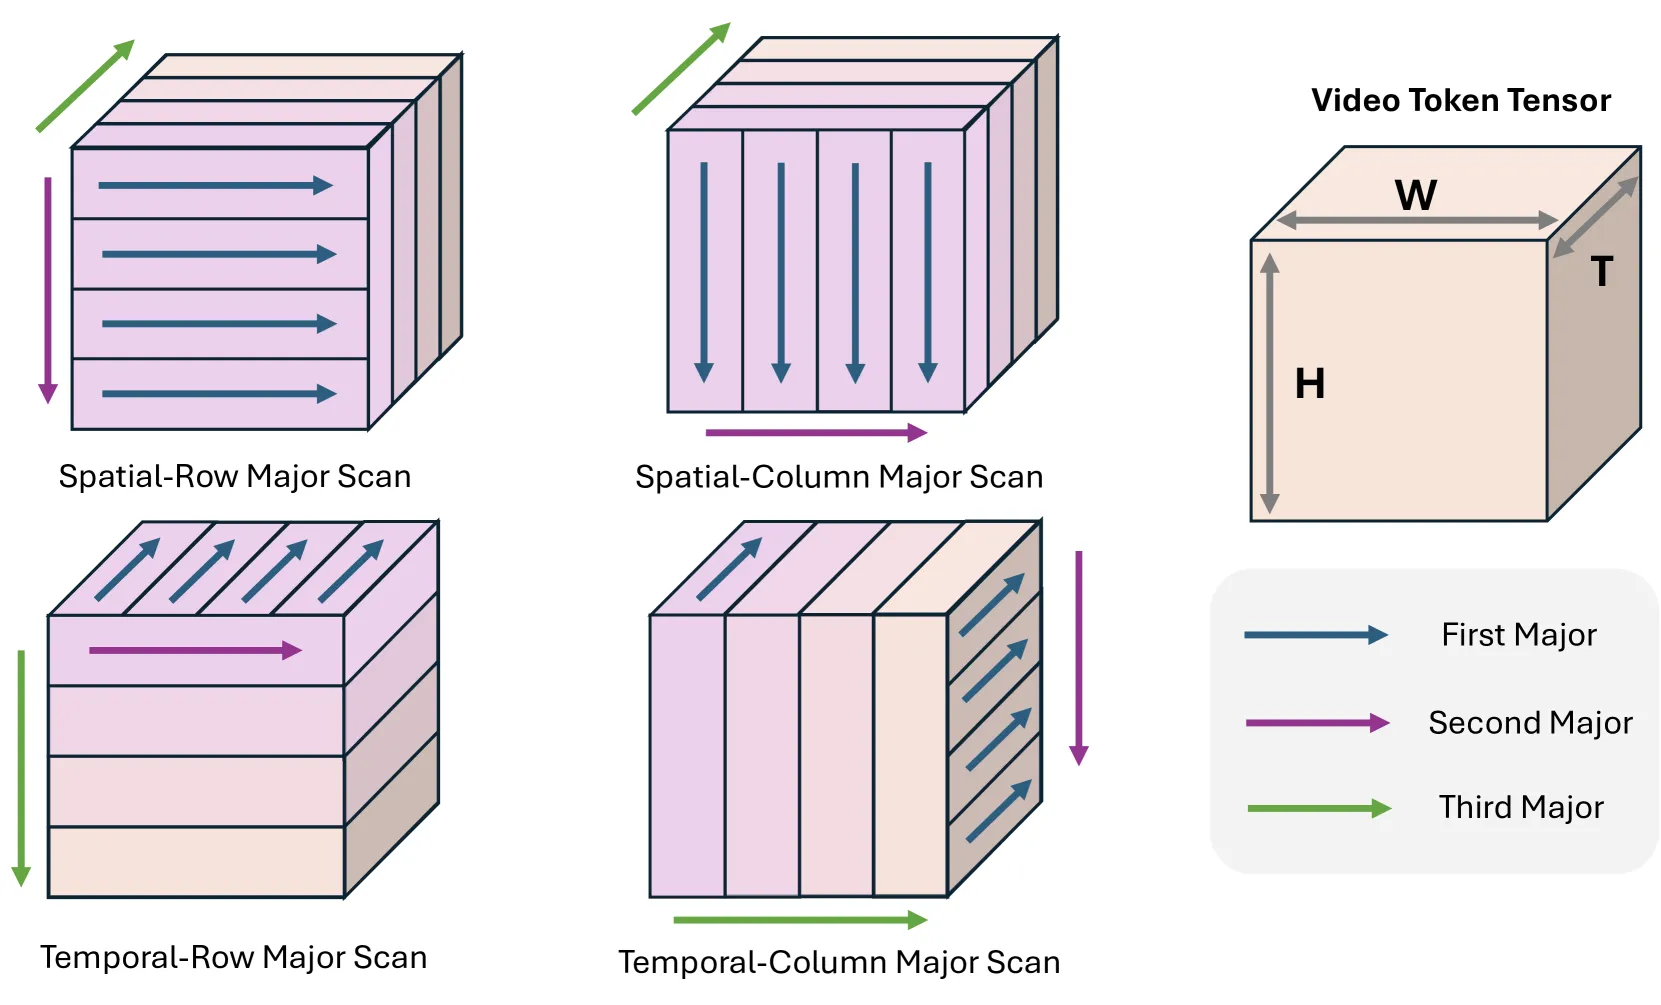
- 问题:默认 row-major 扫描下,同列相邻 token 距离为 ;Mamba 相关性精度随距离衰减 → adjacency preservation 失败 → 失真
- Zigzag scan 可缓解但重排巨大 3D 张量时延迟显著增加
- RMS:将 3D 潜视频张量以四种方式重排为 1D 序列(spatial-row major、spatial-column major、temporal-row major、temporal-column major),在不同层交替使用;每层扫描是双向的(同时存在翻转序列 )
- 仅需几行 reshape 代码,硬件友好;性能与 Zigzag 相当但额外延迟可忽略
3. Review Tokens:处理超长序列时,将 token 张量的平均池化版本(及其翻转版本)附加到 RMS 展开序列的开头,让 Mamba2 在处理序列前先将整体概览纳入隐状态,提升长视频的文本-视频对齐。不引入额外参数,额外 FLOPs 也随 线性增长。
TE-Branch: TEmporal Swin Attention (TESA)
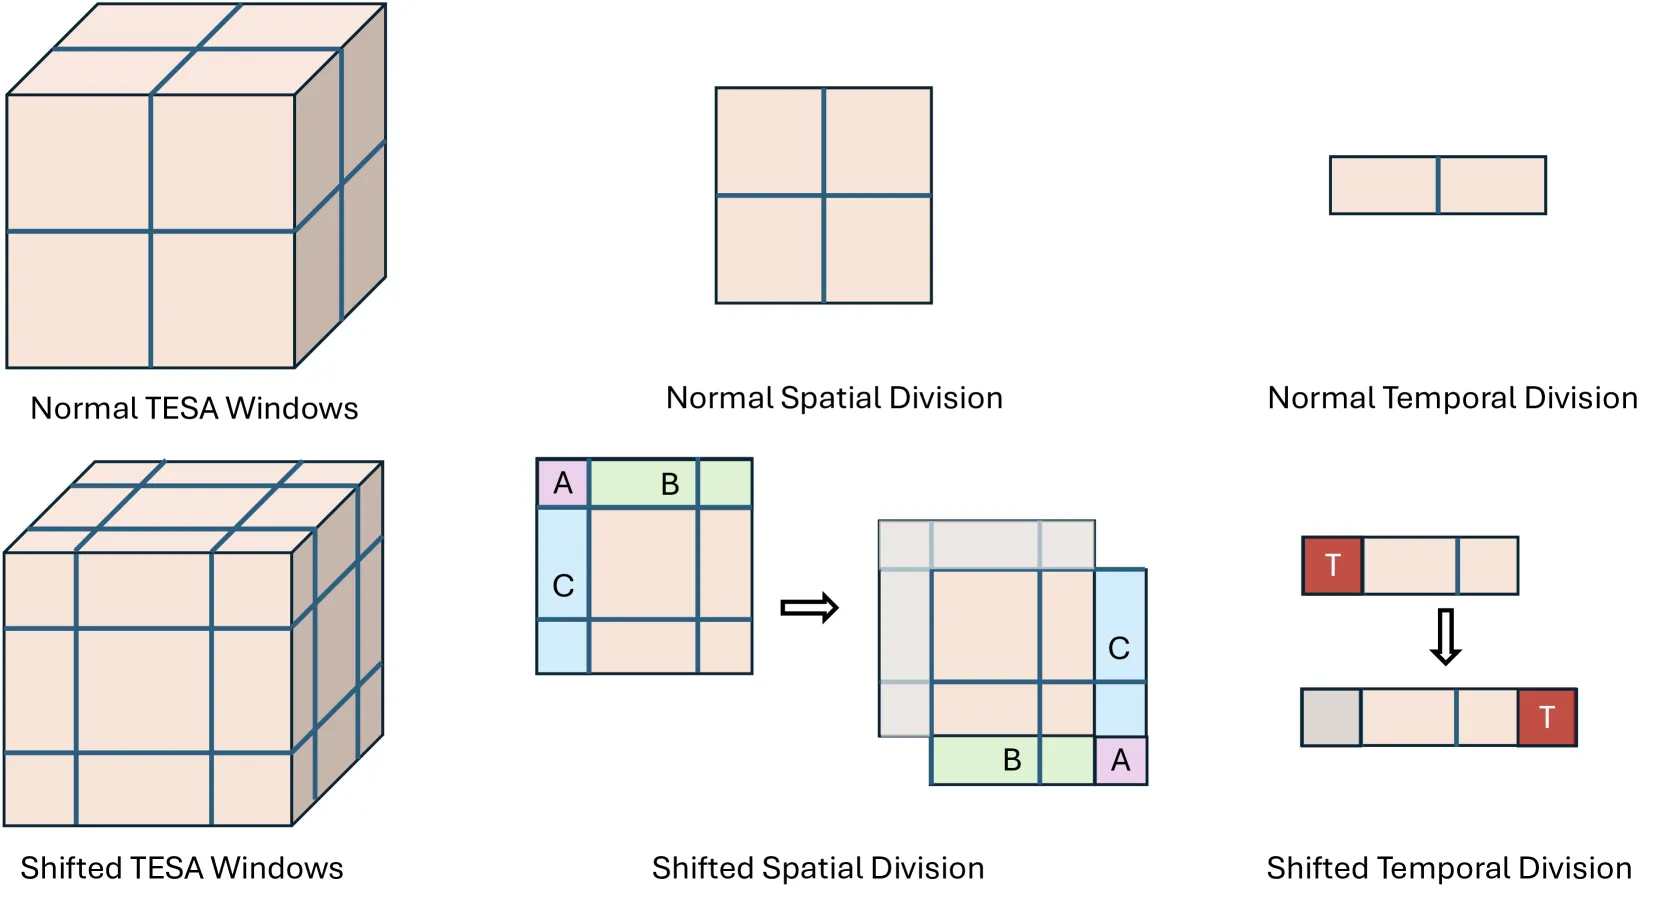
受窗口注意力(Swin)启发,将 3D 视频 token 张量划分为多个窗口(窗口大小 ),仅在同窗口内 token 间计算注意力:
- 沿空间维度收集短程信息
- 沿时间维度收集中程信息
- FLOPs 随 线性增长(窗口大小固定)
TESA 进一步缓解 adjacency preservation 问题、增强视频一致性。
训练配方
- 渐进式训练 (Progressive Training):先 256p 文生图 → 256p 文生视频(17s)→ 512p 逐步提高分辨率与时长(17s → 34s → 68s)
- 文生图/文生视频混合训练 (Hybrid Training):文生视频阶段掺入文-图对联合训练,改善部分失败情形的一致性
- 质量微调 (Quality Tuning):从预训练集选 3K 高质量视频微调,大幅提升生成质量
表 7:预训练配方(Nvidia H100)
| 阶段 | 步数 | Batch size | GPU days |
|---|---|---|---|
| 256p 文生图 | 118k | 8192 | 1189 |
| 256p 文生视频 17s | 125k | 1024 | 1919 |
| 512p 文生视频 17s | 32k | 512 | 2598 |
| 512p 文生视频 34s | 14k | 512 | 2392 |
| 512p 文生视频 68s | 6k | 256 | 1307 |
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| MATE 块 | 线性复杂度自注意力替代,双分支覆盖短/中/长程相关性 | 整体线性复杂度 |
| 双向 Mamba2 | 获得完整相关性图,比 Mamba 快 25% | 表 2:Mamba2 vs Mamba 延迟 127→102 |
| Rotary-Major Scan | 四种扫描交替,解决 adjacency preservation,延迟可忽略 | 图 11:接近 Zigzag 效果,延迟省 42s |
| Review Tokens | 序列概览注入隐状态,改善长视频对齐 | 无额外参数 |
| TESA | 窗口注意力捕获短空间+中时间相关性 | 表 2:仅 +3s 延迟 |
| 渐进+混合+质量微调 | 分阶段训练配方 | 快速适配长序列 |
五、实验结果
5.1 实验设置
- LinGen-4B:32 层,每层 20 头,嵌入维度 2560
- DiT-4B(基线):将 MATE 替换为全局自注意力,32 层,每层 24 头,嵌入维度 3072
- SOTA 对比:Runway Gen3、Kling、LumaLabs 等商业模型
- 数据:300M ShutterStock 文-图对 + 24M 文-视频对预训练;3K 视频(ShutterStock + RawFilm)微调
- 评测:VBench / VBench-Long,16 个解耦维度
5.2 效率:线性计算复杂度
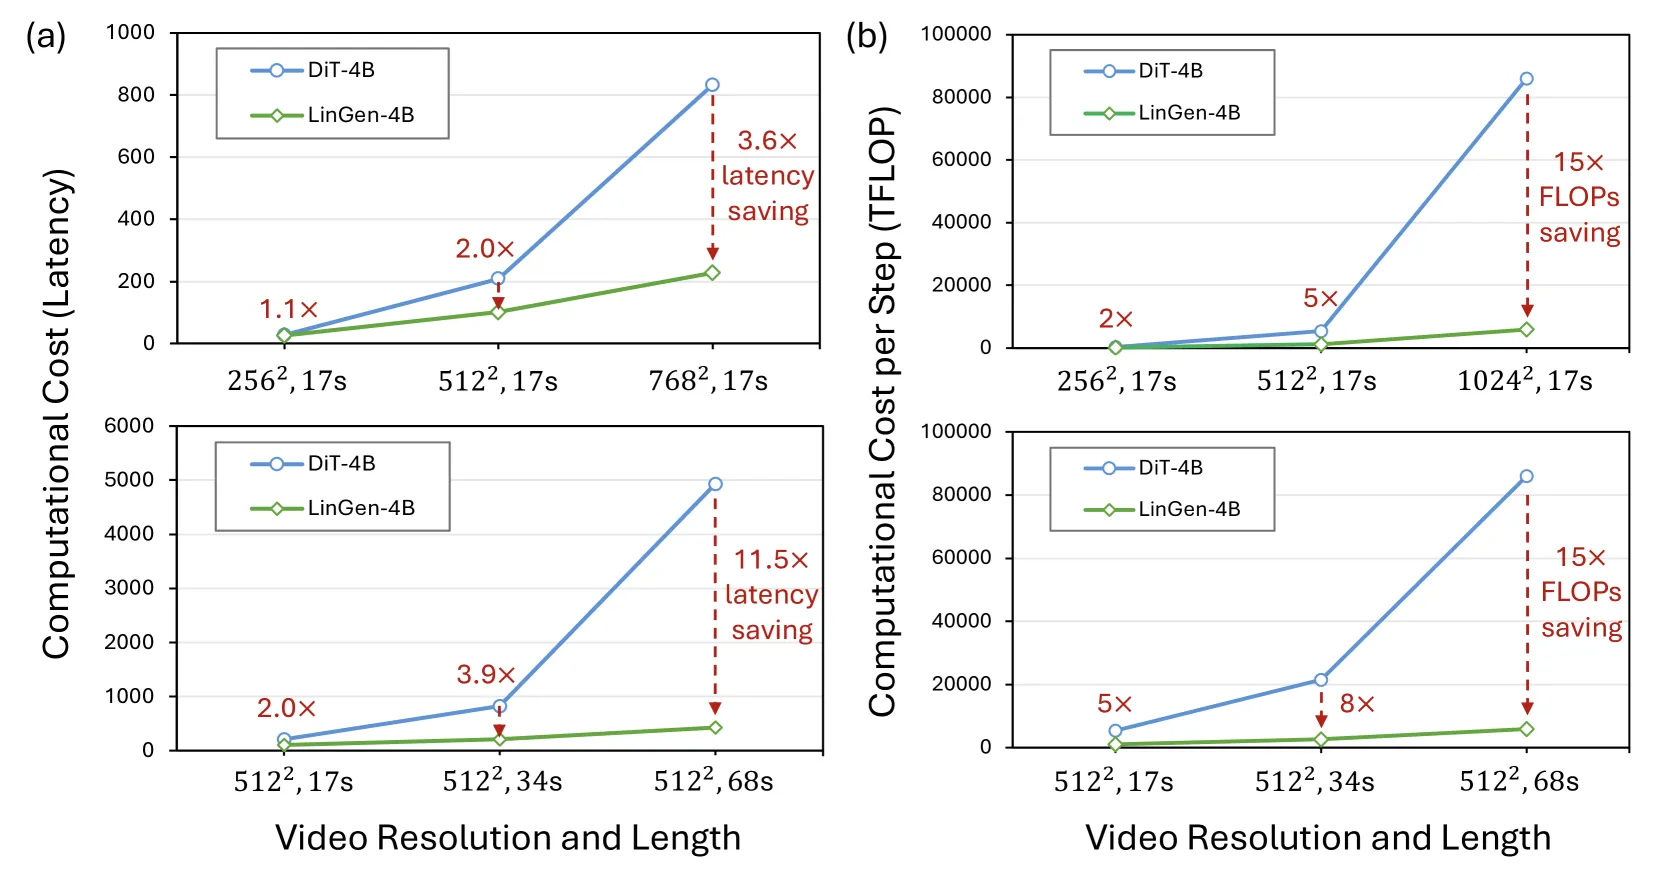
相比 DiT-4B:
- FLOPs:生成 512p 的 17s / 34s / 68s 视频分别加速 5× / 8× / 15×
- 延迟(单 H100):512p / 768p 的 17s 视频分别加速 2.0× / 3.6×;512p 的 17s / 34s / 68s 视频分别加速 2.0× / 3.9× / 11.5×
5.3 质量对比
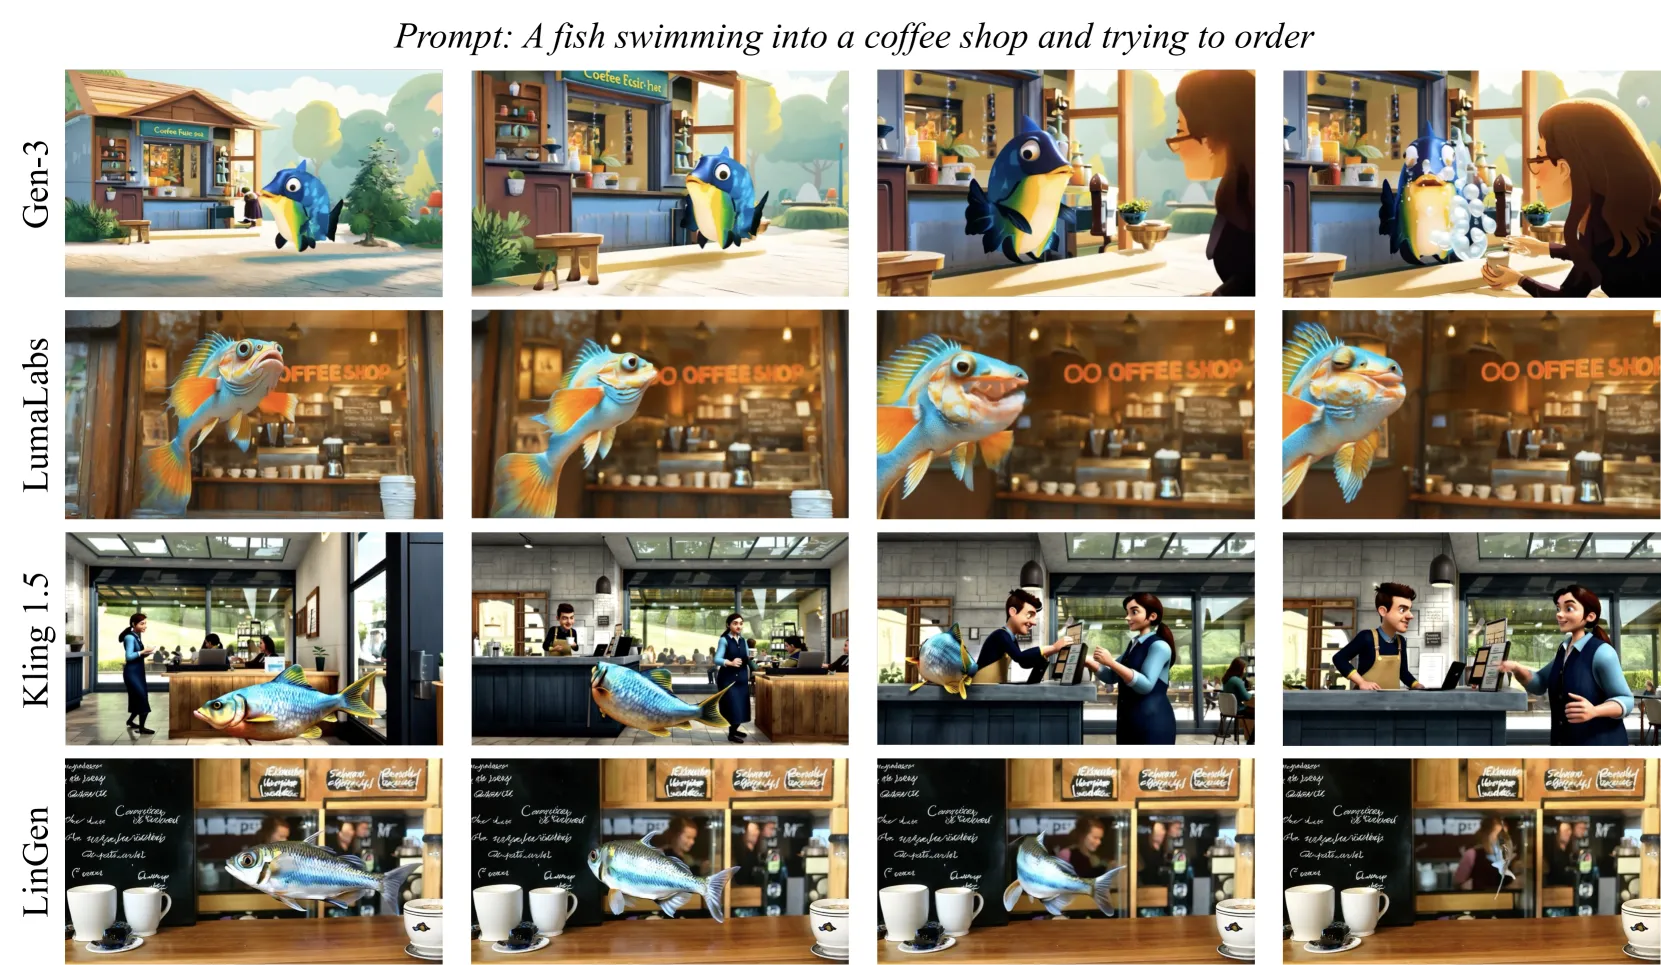
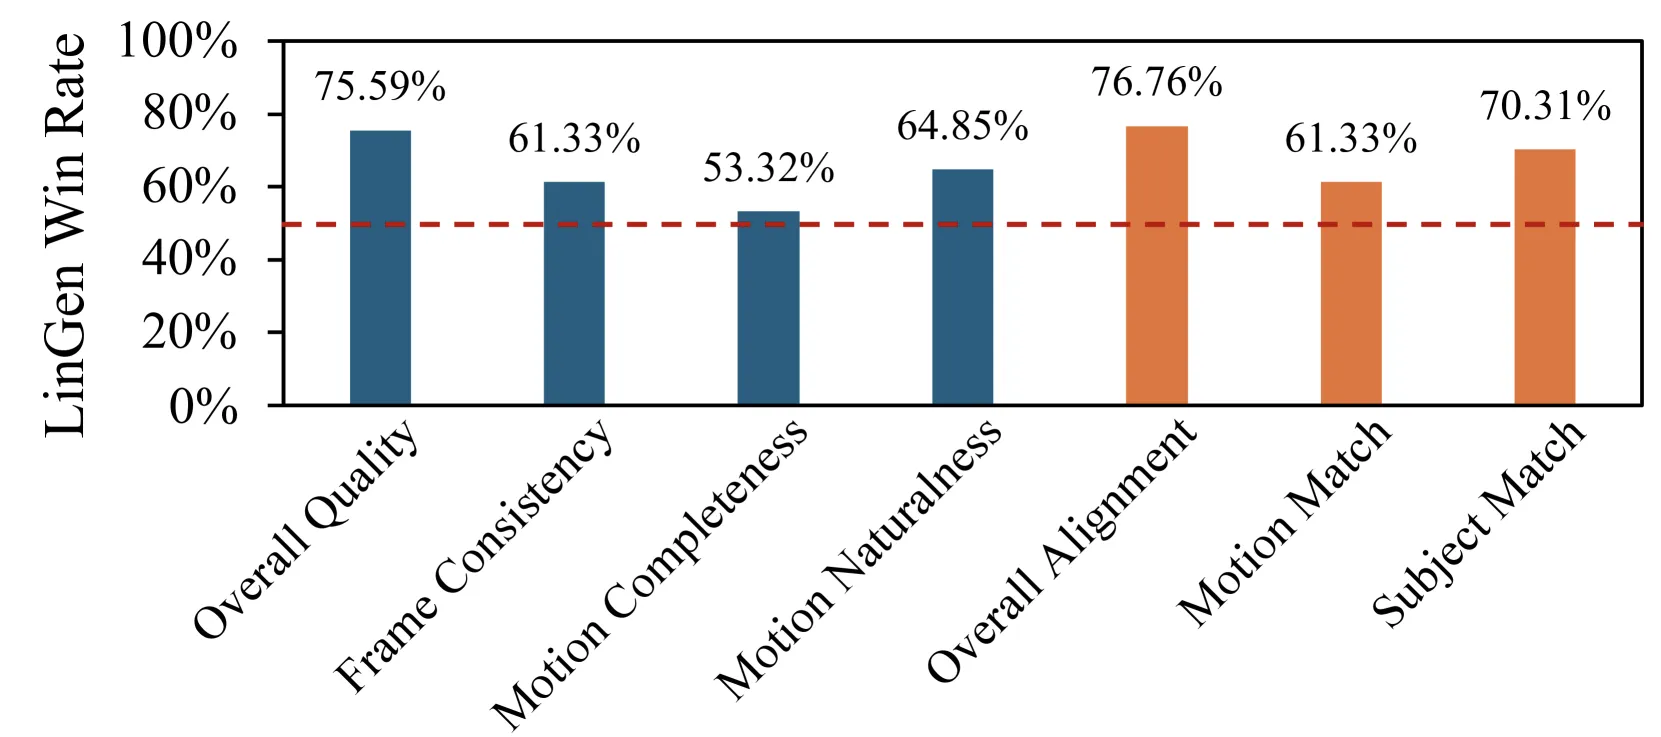
- 人工评估:256p、40K 步、batch 1024 训练后,LinGen-4B 在视频质量与文本对齐上均优于 DiT-4B,同时线性复杂度且显著加速
- VBench-Long 自动指标(表 1):LinGen 质量分超过 Kling,整体与 Gen-3、Kling 相近,且能在单 GPU 上生成千帧以上;显著优于 OpenSora
表 1 关键数值(VBench-Long)
| 模型 | Object Class | Human Action | Overall Semantic |
|---|---|---|---|
| Runway Gen-3 | 87.81% | 96.40% | 75.17% |
| Kling | 87.24% | 93.40% | 75.68% |
| OpenSora V1.2 | 82.22% | 91.20% | 73.39% |
| LinGen | 90.98% | 97.50% | 73.73% |
5.4 适配更长序列
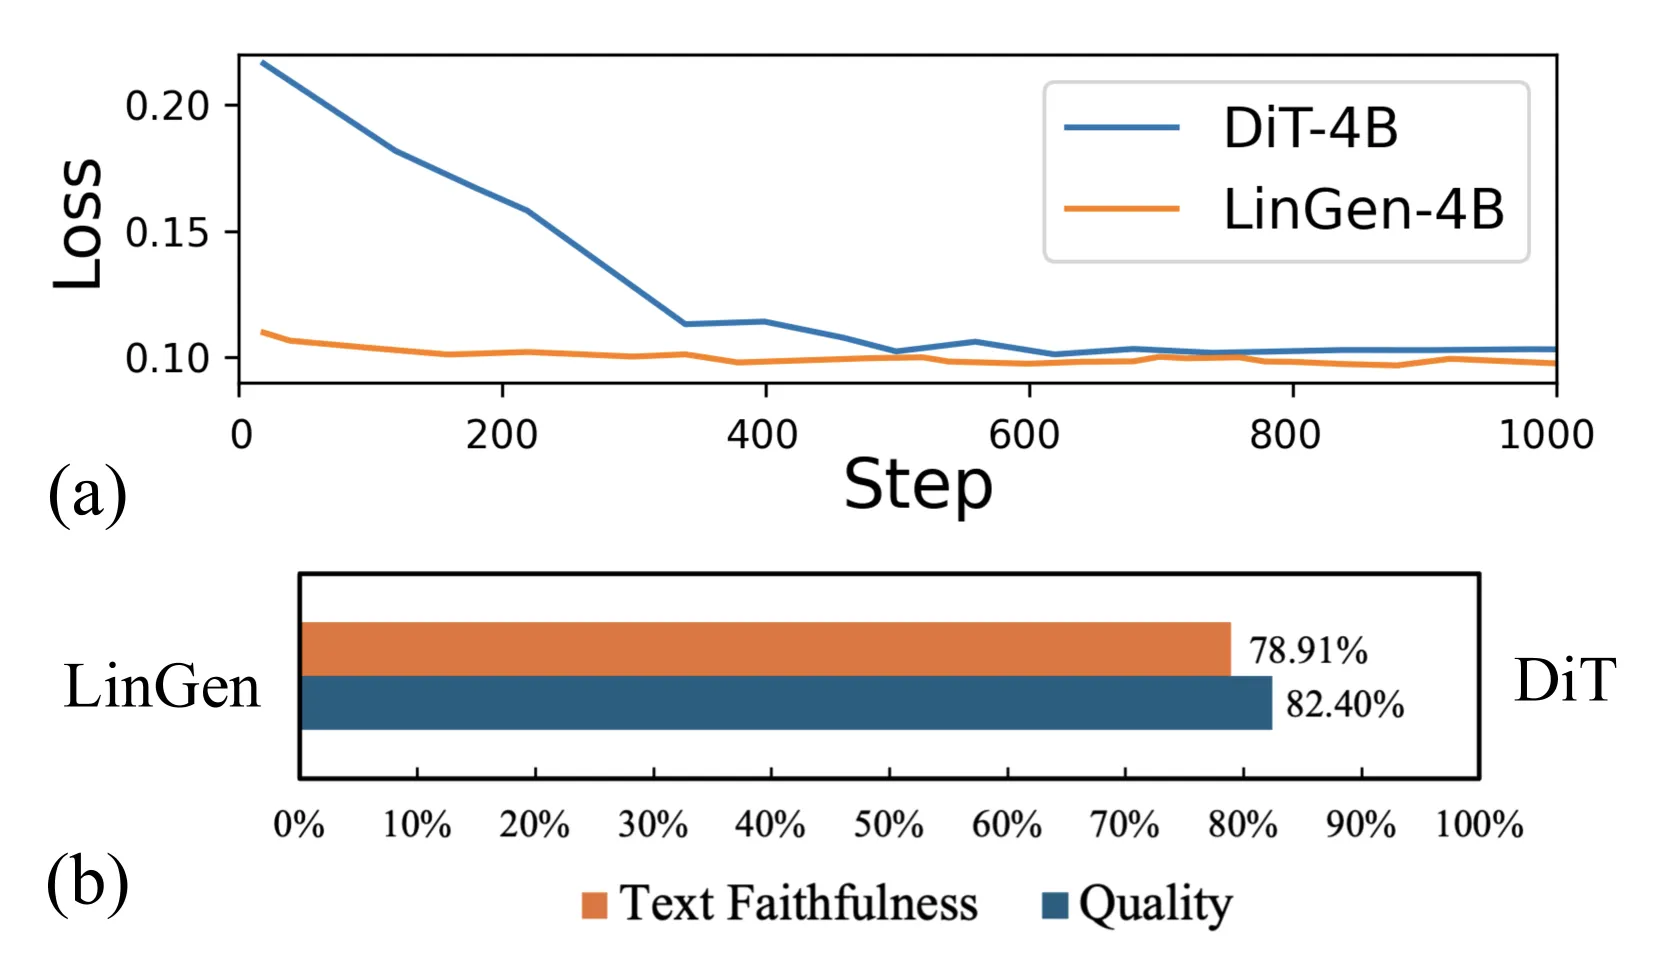
LinGen 比 DiT 更快适配更长的潜 token 序列(得益于 Mamba 对长序列的强适应能力,语言任务中也有类似观察)。256p→512p 迁移的损失曲线与早期 checkpoint 人工评估均验证此点。
5.5 消融实验
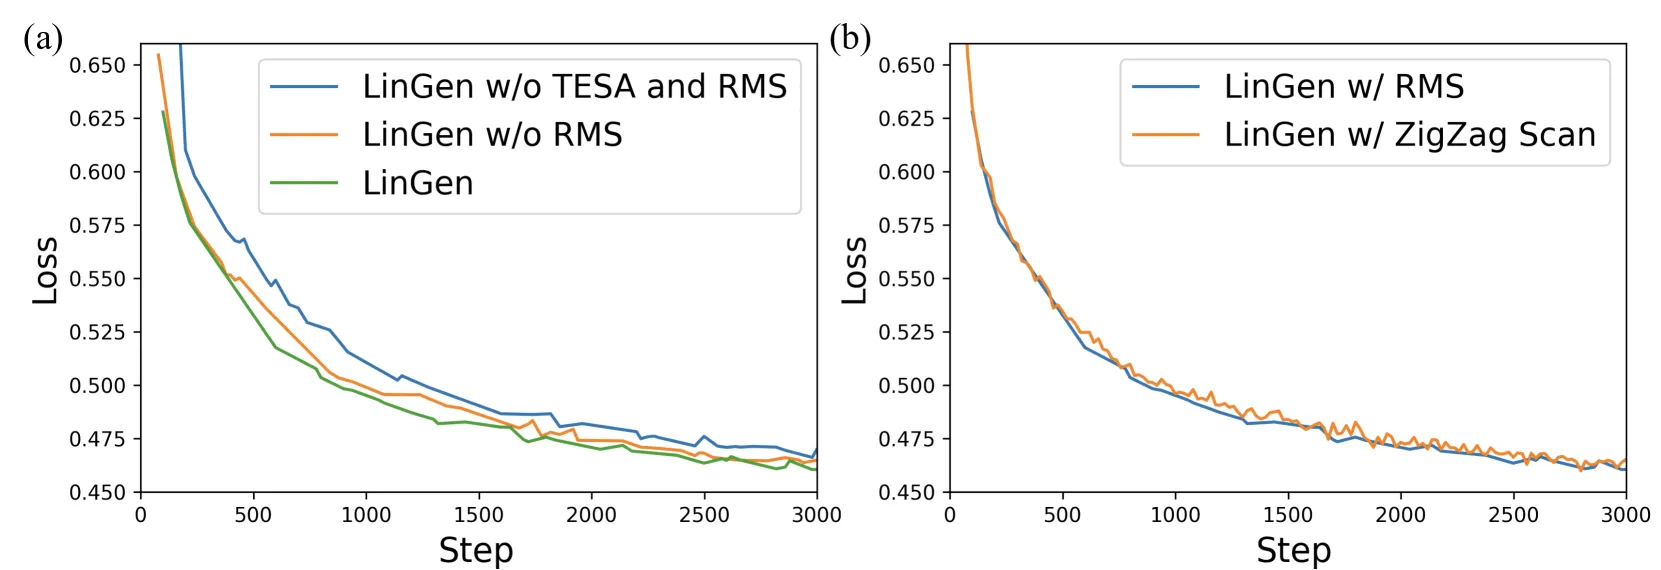
表 2:512p 17s 视频生成延迟(消融)
| TE-branch | 扫描方法 | Mamba 版本 | Review Tokens | 延迟/s |
|---|---|---|---|---|
| ✓ | RMS | Mamba2 | ✓ | 102(默认) |
| ✗ | RMS | Mamba2 | ✓ | 94 (-8) |
| ✓ | ✗ | Mamba2 | ✓ | 99 (-3) |
| ✓ | Zigzag | Mamba2 | ✓ | 144 (+42) |
| ✓ | RMS | Mamba | ✓ | 127 (+25) |
| ✓ | RMS | Mamba2 | ✗ | 98 (-4) |
| ✓(无MA) | ✗ | ✗ | ✗ | 65 (-37) |
- TESA:延迟增量小但对质量贡献显著
- RMS:有效缓解 adjacency preservation,接近 Zigzag 效果但省 42s 延迟
- Mamba2:比 Mamba 快 25%,质量几乎相同
- MA-branch:去掉虽大幅加速但严重损害质量,证明其必要性
六、相关工作
- 高质量视频生成:Sora(首个高分辨率高一致性)、Runway Gen3、LumaLabs、Kling、Movie Gen(30B DiT,二次复杂度昂贵)
- 高效视频生成:采样蒸馏(VideoLCM、T2V-Turbo);高效架构(分解注意力、SSM)—— 但保留二次复杂度或仅限低分辨率短视频
- 分钟级视频生成:Loong、PA-VDM 等早期探索,但受限于低帧率、低分辨率、扩展式生成导致的质量下降
七、总结
核心贡献
- 提出 LinGen,首个线性复杂度、单 GPU 高分辨率分钟级文本到视频生成框架
- 提出 MATE 块(MA-branch + TE-branch),全面覆盖短/中/长程相关性
- 提出 RMS(Rotary-Major Scan)解决 adjacency preservation,延迟可忽略
- 提出 Review Tokens 与 TESA,增强长视频一致性与对齐
- 实验证明相比 DiT-4B 最高 15× FLOPs 加速、11.5× 延迟加速,质量不降反升
技术影响
- 为长视频生成提供了打破二次复杂度瓶颈的可行架构范式(SSM + 窗口注意力混合)
- Mamba 对长序列的强适配能力在视频生成中得到验证
局限性
- VBench 自动指标与人工偏好未完全对齐(表 6:512p vs 256p 人工胜率 88.4% vs 11.6%,但 VBench 分接近)
- 仍依赖大规模授权数据(300M 图 + 24M 视频)与可观的 H100 GPU days
- 部分语义维度(如 Spatial Relation)低于商业模型
八、参考资源
- arXiv: https://arxiv.org/abs/2412.09856
- 关键依赖: Mamba2 (SSD)、Movie Gen (TAE / linear-quadratic schedule)、VBench
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | LinGen 生成的高分辨率长视频展示 | figure-1-teaser.png |
| Figure 2 | LinGen 去噪模块概览(MATE 块) | figure-2-lingen-overview.png |
| Figure 3 | 双向 Mamba2 模块 | figure-3-bidirectional-mamba2.png |
| Figure 4 | Rotary-Major Scan (RMS) | figure-4-rotary-major-scan.png |
| Figure 5 | TEmporal Swin Attention (TESA) | figure-5-tesa.png |
| Figure 6 | DiT-4B vs LinGen-4B 计算成本对比 | figure-6-cost-comparison.png |
| Figure 7 | 不同模型生成视频的视觉示例 | figure-7-visual-examples.png |
| Figure 8 | 质量与对齐的人工评估 | figure-8-human-eval.png |
| Figure 10 | LinGen 比 DiT 更快适配长序列 | figure-10-adaptation-loss.png |
| Figure 11 | 256p 预训练消融损失曲线 | figure-11-ablation-loss.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer