From Slow Bidirectional to Fast Autoregressive Video Diffusion Models (CausVid)
首个与双向扩散模型质量匹敌的自回归视频生成方法,通过非对称蒸馏将50步双向DiT蒸馏为4步因果生成器,实现9.4 FPS流式生成
From Slow Bidirectional to Fast Autoregressive Video Diffusion Models (CausVid)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | From Slow Bidirectional to Fast Autoregressive Video Diffusion Models |
| 简称 | CausVid |
| 作者 | Tianwei Yin, Qiang Zhang, Richard Zhang, William T. Freeman, Frédo Durand, Eli Shechtman, Xun Huang |
| 机构 | MIT, Adobe Research |
| 论文 | https://arxiv.org/abs/2412.07772 |
| 代码 | https://github.com/tianweiy/CausVid |
| 项目页 | https://causvid.github.io/ |
| 会议 | CVPR 2025 |
| 发布 | 2024-12-10 (v1), 最新 v4 (2025-09-23) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
当前视频扩散模型使用双向注意力,生成单帧需要处理整个序列(包括未来帧),导致:
| 问题 | 说明 |
|---|---|
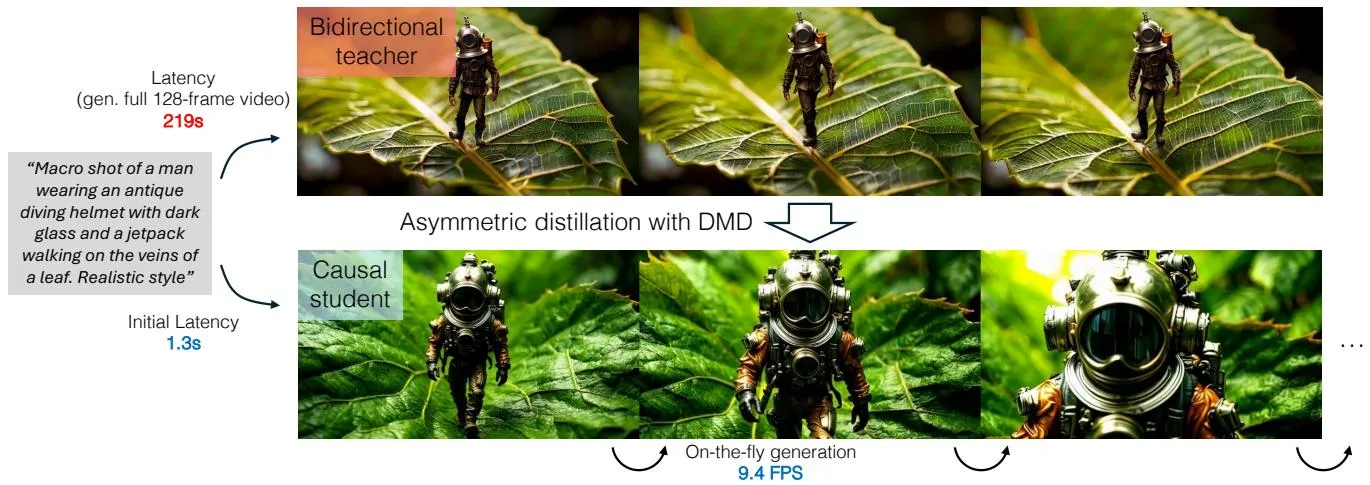
| 高延迟 | 生成128帧需要219秒 |
| 无法流式 | 必须等待全部帧完成才能观看 |
| 计算量大 | 复杂度与帧数平方成正比 |
| 不支持交互 | 无法响应实时用户输入 |
解决方案概述
CausVid 是首个与双向扩散模型质量匹敌的自回归视频生成方法。核心创新:
- 因果自回归架构:将预训练双向DiT适配为自回归Transformer,支持帧级流式生成
- 视频DMD蒸馏:将Distribution Matching Distillation扩展到视频,50步→4步
- 非对称蒸馏策略:用双向教师监督因果学生,显著减少误差累积
- SOTA性能:VBench-Long总分84.27,单GPU 9.4 FPS流式生成
三、技术架构
整体框架
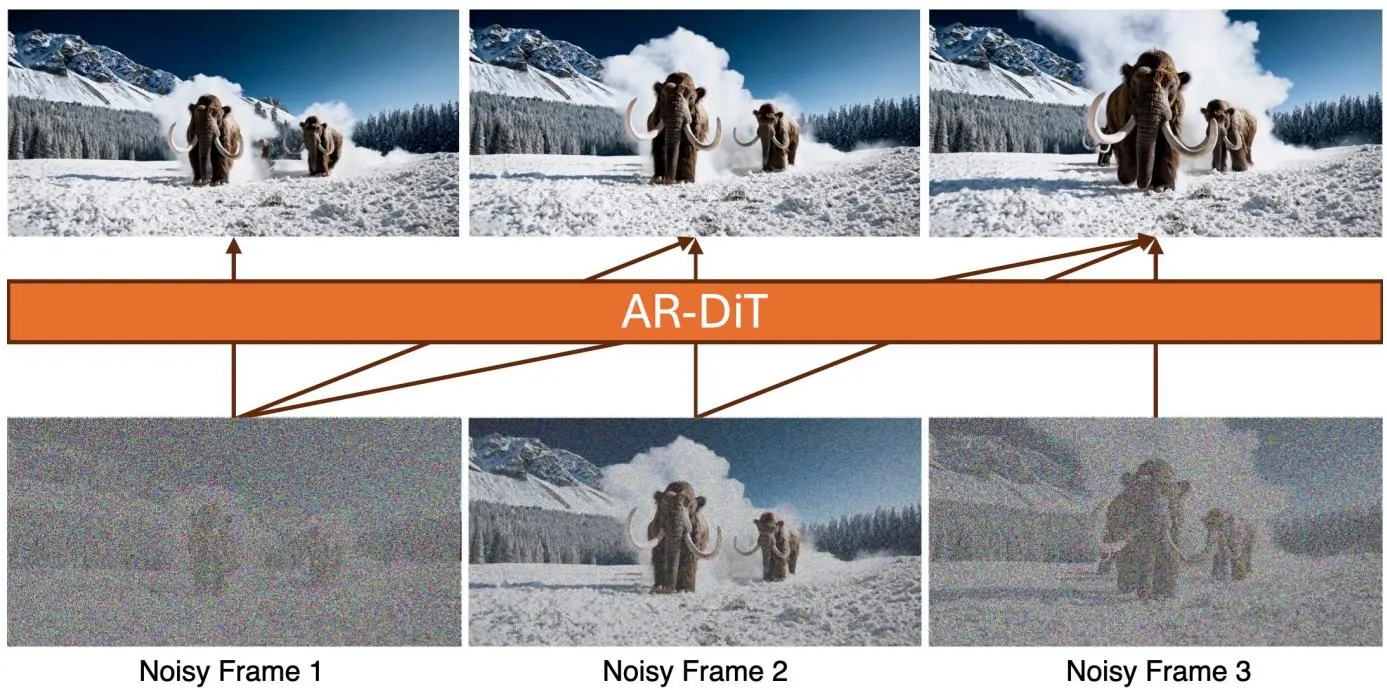
CausVid采用自回归扩散Transformer架构,在3D VAE压缩的潜在空间中生成视频帧。关键设计:
- 块级因果注意力:当前帧只关注当前和之前帧,不关注未来
- 块内双向注意力:每个chunk内部保持双向注意力以捕获局部时间依赖
- KV缓存:支持高效推理,避免重复计算
注意力掩码
其中 和 是帧索引, 是chunk大小, 是向下取整函数。
核心公式
扩散模型训练目标:
Score函数:
DMD蒸馏损失:
学生初始化损失:
非对称蒸馏策略
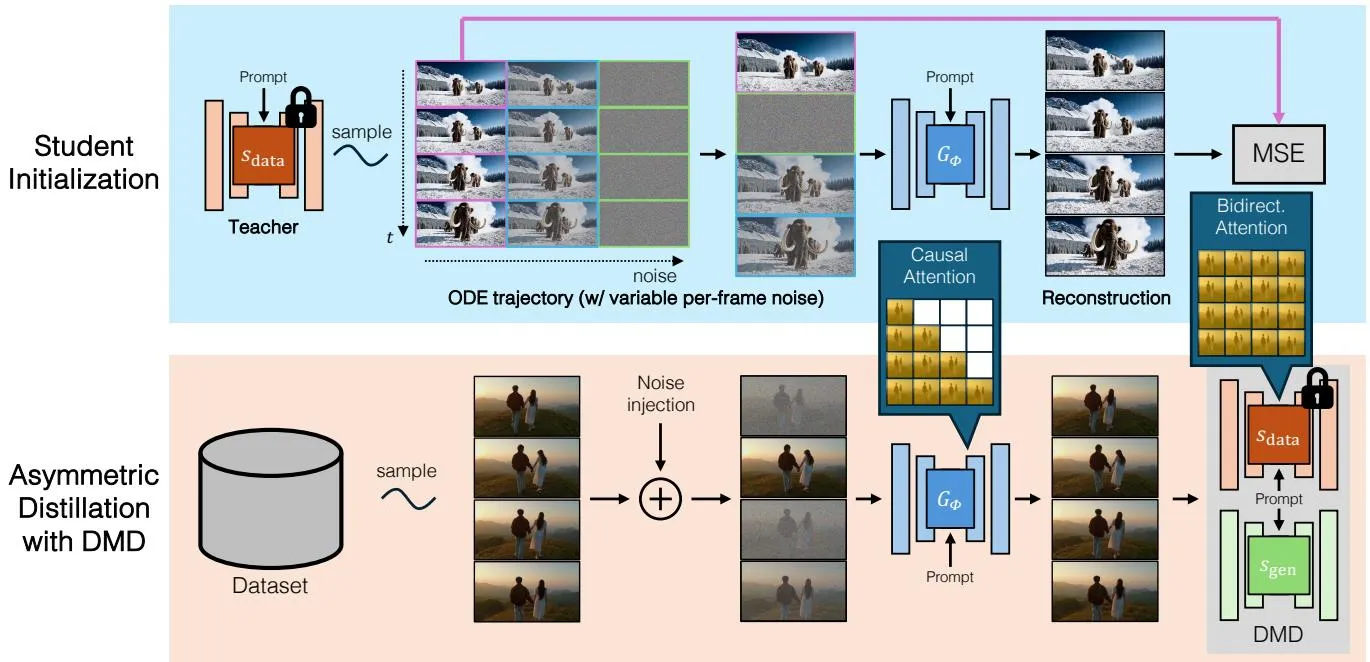
核心创新:用双向教师监督因果学生
教师(双向注意力)→ 学生(因果注意力)优势:
- 教师可以看到完整序列,提供更准确的监督
- 学生学习因果依赖,支持流式推理
- DMD的分布级匹配允许架构差异
- 显著减少自回归误差累积
学生初始化
基于教师ODE轨迹初始化:
- 从标准高斯分布采样噪声输入
- 使用预训练双向教师模拟ODE轨迹
- 选择与学生生成器匹配的t值子集
- 用回归损失训练学生模型
KV缓存推理
推理时生成视频帧序列,使用KV缓存避免重复计算:
- 每个chunk生成后,计算KV对并追加到缓存
- 后续chunk可以直接使用缓存的KV对
- 块级因果注意力在推理时不再需要,可使用快速双向注意力实现
四、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| 因果自回归架构 | 块级因果注意力 + 块内双向注意力 | 流式生成 + 局部一致性 |
| 视频DMD蒸馏 | 将DMD从图像扩展到视频 | 50步→4步,160×延迟降低 |
| 非对称蒸馏 | 双向教师 → 因果学生 | 减少误差累积,质量接近教师 |
| ODE轨迹初始化 | 基于教师ODE解初始化学生 | 稳定训练,提高最终质量 |
| KV缓存推理 | 高效自回归推理 | 9.4 FPS流式生成 |
五、训练流程
训练策略
阶段 1:ODE轨迹初始化(3000迭代)
  - 生成1000个ODE解对
  - AdamW优化器,学习率 5×10⁻⁶

阶段 2:非对称DMD蒸馏(6000迭代)
  - 双向教师 → 因果学生
  - AdamW优化器,学习率 2×10⁻⁶
  - 引导尺度 3.5
  - DMD2双时间尺度更新规则,比率5
训练数据
| 项目 | 值 |
|---|---|
| 分辨率 | 352×640 |
| 帧率 | 12 FPS |
| 视频时长 | 10秒 |
| 训练数据 | 混合图像和视频数据集 |
| 视频数量 | ~400K单镜头视频 |
| 训练硬件 | 64 H100 GPU |
| 训练时间 | ~2天 |
模型规格
| 规格 | 教师模型 | 学生模型 |
|---|---|---|
| 架构 | 双向DiT | 因果DiT |
| 注意力 | 全局双向 | 块级因果 |
| 去噪步数 | 50步 | 4步 |
| 推理时间步 | - | [999, 748, 502, 247] |
| VAE | 3D VAE (16帧→5潜在帧) | 同教师 |
| 基础模型 | CogVideoX风格 | 同教师 |
六、实验结果
VBench短视频评估
| 方法 | 时长 | 时间质量↑ | 帧质量↑ | 文本对齐↑ |
|---|---|---|---|---|
| CogVideoX-5B | 6s | 89.9 | 59.8 | 29.1 |
| OpenSORA | 8s | 88.4 | 52.0 | 28.4 |
| Pyramid Flow | 10s | 89.6 | 55.9 | 27.1 |
| MovieGen | 10s | 91.5 | 61.1 | 28.8 |
| CausVid | 10s | 94.7 | 64.4 | 30.1 |
CausVid在所有三个关键指标上均达到最优。
VBench长视频评估(~30s)
| 方法 | 时间质量↑ | 帧质量↑ | 文本对齐↑ |
|---|---|---|---|
| Gen-L-Video | 86.7 | 52.3 | 28.7 |
| FreeNoise | 86.2 | 54.8 | 28.7 |
| StreamingT2V | 89.2 | 46.1 | 27.2 |
| FIFO-Diffusion | 93.1 | 57.9 | 29.9 |
| Pyramid Flow | 89.0 | 48.3 | 24.4 |
| CausVid | 94.9 | 63.4 | 28.9 |
推理速度对比
| 方法 | 延迟(s)↓ | 吞吐量(FPS)↑ |
|---|---|---|
| CogVideoX-5B | 208.6 | 0.6 |
| Pyramid Flow | 6.7 | 2.5 |
| 双向教师 | 219.2 | 0.6 |
| CausVid | 1.3 | 9.4 |
CausVid实现160×延迟降低和16×吞吐量提升。
用户偏好研究
| 模型对比 | CausVid胜率 |
|---|---|
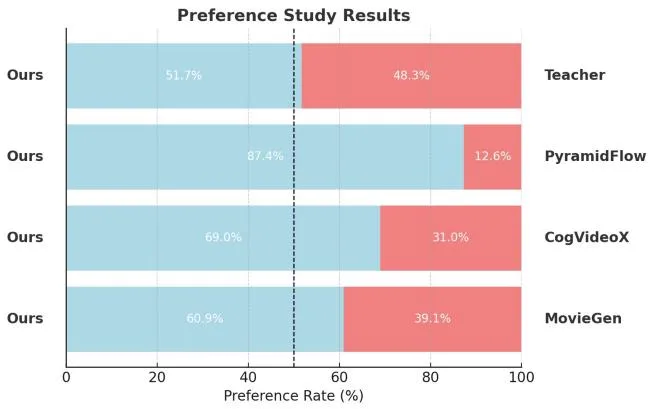
| vs 双向教师 | 51.7% |
| vs PyramidFlow | 87.4% |
| vs CogVideoX | 69.0% |
| vs MovieGen | 60.9% |
VBench-Long排行榜
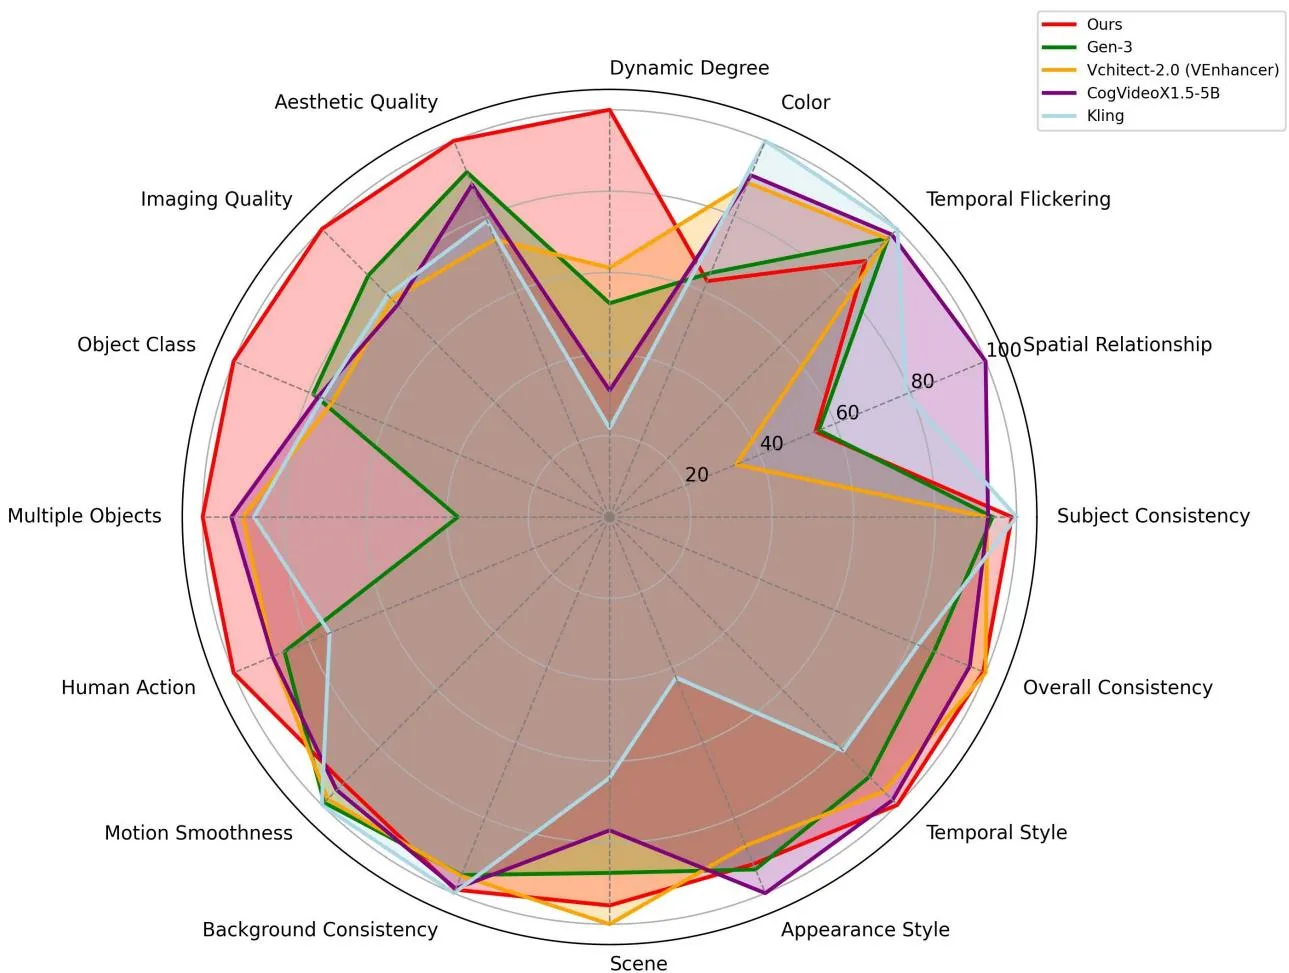
| 方法 | 总分 | 质量分 | 语义分 |
|---|---|---|---|
| Vchitect | 82.24 | 83.54 | 77.06 |
| Jimeng | 81.97 | 83.29 | 76.69 |
| CogVideoX | 81.61 | 82.75 | 77.04 |
| Vidu | 81.89 | 83.85 | 74.04 |
| Kling | 81.85 | 83.39 | 75.68 |
| CogVideoX1.5-5B | 82.17 | 82.78 | 79.76 |
| Gen-3 | 82.32 | 84.11 | 75.17 |
| CausVid | 84.27 | 85.65 | 78.75 |
CausVid以84.27总分排名第一,在动态程度(92.69)、物体类别(92.99)、人类动作(99.80)等维度显著领先。
消融实验
| 模型 | 时间质量 | 帧质量 | 文本对齐 |
|---|---|---|---|
| 双向(多步) | 94.6 | 62.7 | 29.6 |
| 因果(多步) | 92.4 | 60.1 | 28.5 |
| 无ODE初始化 + 双向教师 | 93.4 | 60.6 | 29.4 |
| ODE初始化 + 无教师 | 92.9 | 48.1 | 25.3 |
| ODE初始化 + 因果教师 | 91.9 | 61.7 | 28.2 |
| 完整CausVid | 94.7 | 64.4 | 30.1 |
关键发现:
- 因果教师导致误差累积传递给学生
- 双向教师显著优于因果教师
- ODE初始化进一步提升性能
质量随时间变化
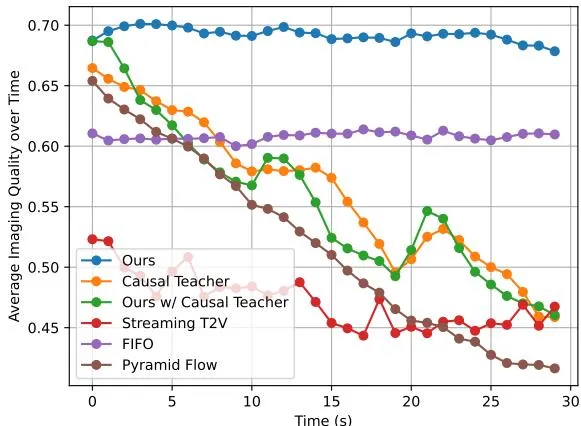
| 时间(s) | CausVid | 因果教师 | Causal Teacher (蒸馏) | StreamingT2V | FIFO | Pyramid Flow |
|---|---|---|---|---|---|---|
| 0 | 0.69 | 0.67 | 0.69 | 0.52 | 0.61 | 0.65 |
| 10 | 0.69 | 0.58 | 0.59 | 0.49 | 0.61 | 0.55 |
| 20 | 0.69 | 0.53 | 0.55 | 0.45 | 0.61 | 0.48 |
| 30 | 0.68 | 0.47 | 0.47 | 0.47 | 0.61 | 0.42 |
CausVid在30秒内保持稳定质量(0.68-0.69),而因果教师和PyramidFlow显著退化。
图像到视频评估
| 方法 | 时间质量↑ | 帧质量↑ | 文本对齐↑ |
|---|---|---|---|
| CogVideoX-5B | 87.0 | 64.9 | 28.9 |
| Pyramid Flow | 88.4 | 60.3 | 27.6 |
| CausVid | 92.0 | 65.0 | 28.9 |
CausVid零样本支持图像到视频生成,无需额外训练。
超长视频生成
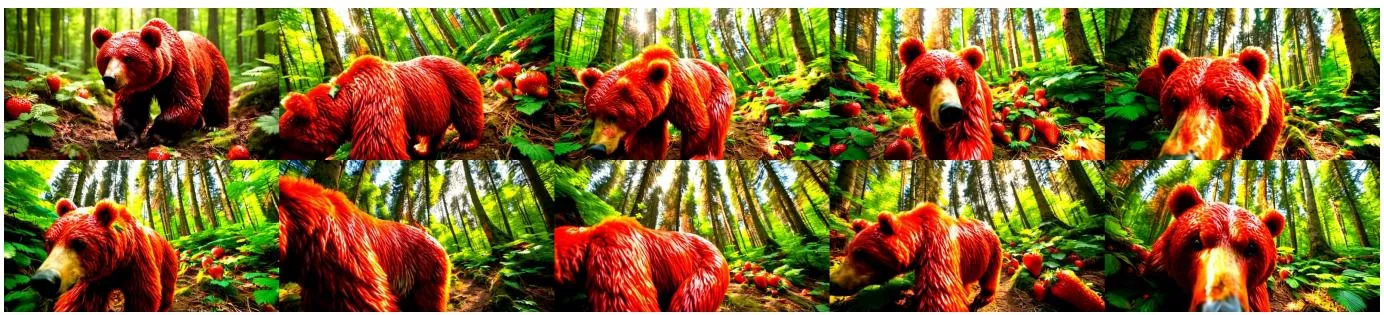
模型成功生成14分钟视频,虽有轻微过曝但整体质量保持良好。
七、应用场景
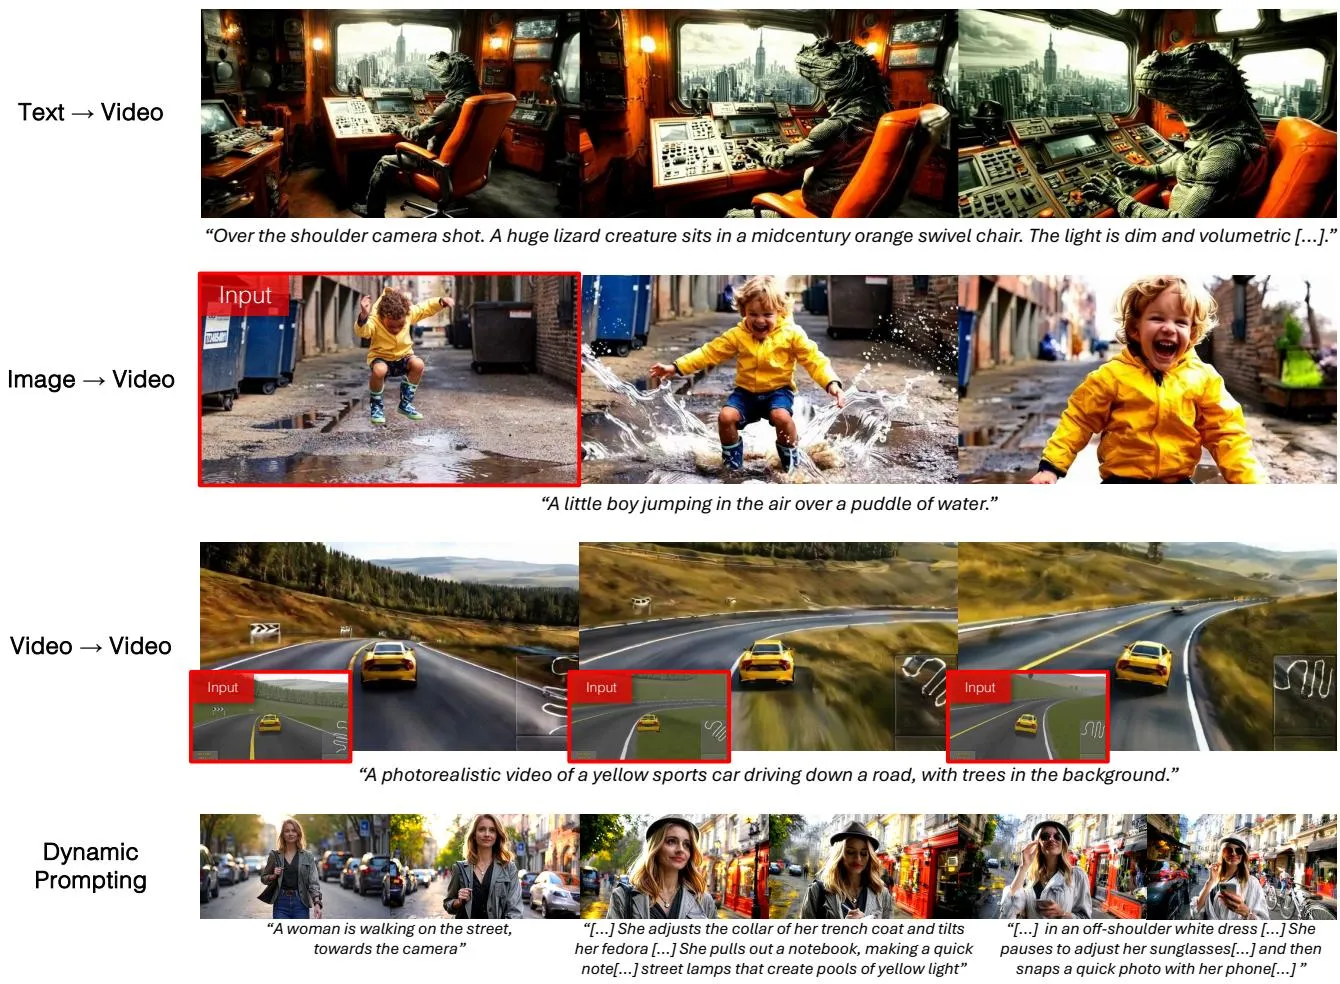
文本到视频
- 标准文本到视频生成
- 支持长视频(滑动窗口)
图像到视频
- 零样本支持(无需额外训练)
- 第一帧作为条件输入
流式视频到视频翻译
| 方法 | 时间质量 | 帧质量 | 文本对齐 |
|---|---|---|---|
| StreamV2V | 92.5 | 59.3 | 26.9 |
| CausVid | 93.2 | 61.7 | 27.7 |
动态提示
- 用户可随时输入新prompt
- 支持扩展叙事和情节变化
游戏引擎增强
- 为简单游戏引擎输出添加真实纹理和光照
- 实时响应用户输入
八、相关工作
自回归视频生成
- Diffusion Forcing:支持自回归采样的扩散模型
- FIFO-Diffusion:先进先出扩散模型
- StreamingT2V:流式文本到视频生成
长视频生成
- Gen-L-Video:长视频生成
- FreeNoise:自由噪声长视频
- Pyramid Flow:金字塔流匹配
扩散蒸馏
- DMD:Distribution Matching Distillation
- DMD2:多步DMD扩展
- Consistency Distillation:一致性蒸馏
- Progressive Distillation:渐进式蒸馏
CausVid的差异化
- 首个质量匹敌双向的自回归方法:之前方法均显著落后
- 非对称蒸馏:独特地用双向教师训练因果学生
- 流式生成:9.4 FPS,支持交互式应用
- 多任务支持:T2V、I2V、V2V、动态提示
九、总结
核心贡献
- 因果自回归架构:设计块级因果注意力的DiT,支持帧级流式生成,首次实现与双向模型质量匹敌
- 视频DMD蒸馏:将DMD从图像扩展到视频,50步→4步,160×延迟降低
- 非对称蒸馏策略:用双向教师监督因果学生,有效减少误差累积
- ODE轨迹初始化:稳定训练过程,提高最终质量
- SOTA性能:VBench-Long总分84.27排名第一,9.4 FPS流式生成
技术影响
- 视频生成新范式:证明自回归方法可以匹敌双向扩散模型
- 实时视频生成:为交互式应用(游戏、机器人、流式编辑)提供基础
- 蒸馏技术突破:非对称蒸馏策略可推广到其他架构差异场景
- 长视频生成:支持10分钟以上视频,质量退化可控
局限性
- 超长视频退化:生成极长视频时仍观察到质量下降
- VAE延迟瓶颈:当前VAE需要5个潜在帧才能输出像素,限制了延迟进一步降低
- 输出多样性降低:DMD基于反向KL,导致输出多样性下降
- 帧率限制:当前实现约10 FPS,需工程优化(编译、量化、并行化)才能实现实时
- 训练成本:64 H100 GPU训练2天,对资源要求较高
十、参考资源
论文
- 本文: https://arxiv.org/abs/2412.07772
- 代码: https://github.com/tianweiy/CausVid
- 项目页: https://causvid.github.io/
相关论文
- DMD: Distribution Matching Distillation (CVPR 2024)
- DMD2: 多步DMD扩展
- CogVideoX: 视频生成模型(教师模型基础)
- Diffusion Forcing: 自回归扩散模型
- VBench: 视频生成评估基准
- FlexAttention: 高效注意力计算