HunyuanVideo: A Systematic Framework For Large Video Generative Models
腾讯混元视频生成基础模型,130亿参数,涵盖数据清洗、架构设计、渐进缩放训练和高效基础设施,综合性能超越Runway Gen-3和Luma 1.6等闭源模型。
HunyuanVideo: A Systematic Framework For Large Video Generative Models
一、论文概述 (Overview)
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 标题 | HunyuanVideo: A Systematic Framework For Large Video Generative Models |
| arXiv ID | 2412.03603 |
| 作者 | Weijie Kong, Qi Tian, Zijian Zhang, Rox Min, Zuozhuo Dai, Jin Zhou, Jiangfeng Xiong, Xin Li, Bo Wu, Jianwei Zhang 等 |
| 机构 | 腾讯混元基础模型团队 (Tencent Hunyan Foundation Model Team) |
| 论文 | https://arxiv.org/abs/2412.03603 |
| 代码 | https://github.com/Tencent/HunyuanVideo |
| 发布日期 | 2024-12-04 |
1.2 摘要
视频生成领域的最新进展深刻影响了个人和工业界。然而,领先的视频生成模型仍然保持闭源状态,在行业能力与公共社区之间造成了显著的性能差距。本文介绍 HunyuanVideo——一种创新的开源视频基础模型,其视频生成性能可与甚至超越领先闭源模型相媲美。
HunyuanVideo 包含一个全面的框架,集成了多个关键要素:数据策展、先进架构设计、渐进式模型缩放与训练,以及为大规模模型训练和推理定制的高效基础设施。凭借这些技术,我们成功训练了一个超过 130亿参数 的视频生成模型,使其成为开源模型中最大的。我们通过专业人士评估,HunyuanVideo 优于之前的最先进模型,包括 Runway Gen-3、Luma 1.6 和三个顶级中国视频生成模型。
1.3 核心贡献
- 大规模数据策展: 分层数据过滤管道 + 结构化标注(VLM生成多维度JSON描述)+ 相机运动分类器
- Causal 3D VAE: 从 scratch 训练的时间因果3D变分自编码器,支持视频和图像联合重建
- 统一图文生成架构: 双流/单流 DiT 骨干网络,Full Attention 机制,MLLM 文本编码器
- 渐进式缩放策略: 图像预训练 → 视频-图像联合训练 → 高分辨率微调,减少 5× 计算资源需求
- 模型加速: 推理步数缩减(时间步偏移)、文本引导蒸馏、高效可扩展的训练基础设施
- 应用生态: 音频生成、图生视频、角色动画(口型/姿态/表情/混合驱动)
二、核心思想 (Core Ideas)
2.1 问题定义
开源视频生成模型社区与闭源模型之间存在巨大差距:
- 闭源模型(Runway Gen-3、Luma 1.6、Kling 等)性能遥遥领先
- MovieGen 等开源模型尚未建立里程碑式的开源发布
- 缺乏像文本到图像领域(FLUX、Stable Diffusion)那样成熟的开源基础模型生态
2.2 解决方案概述
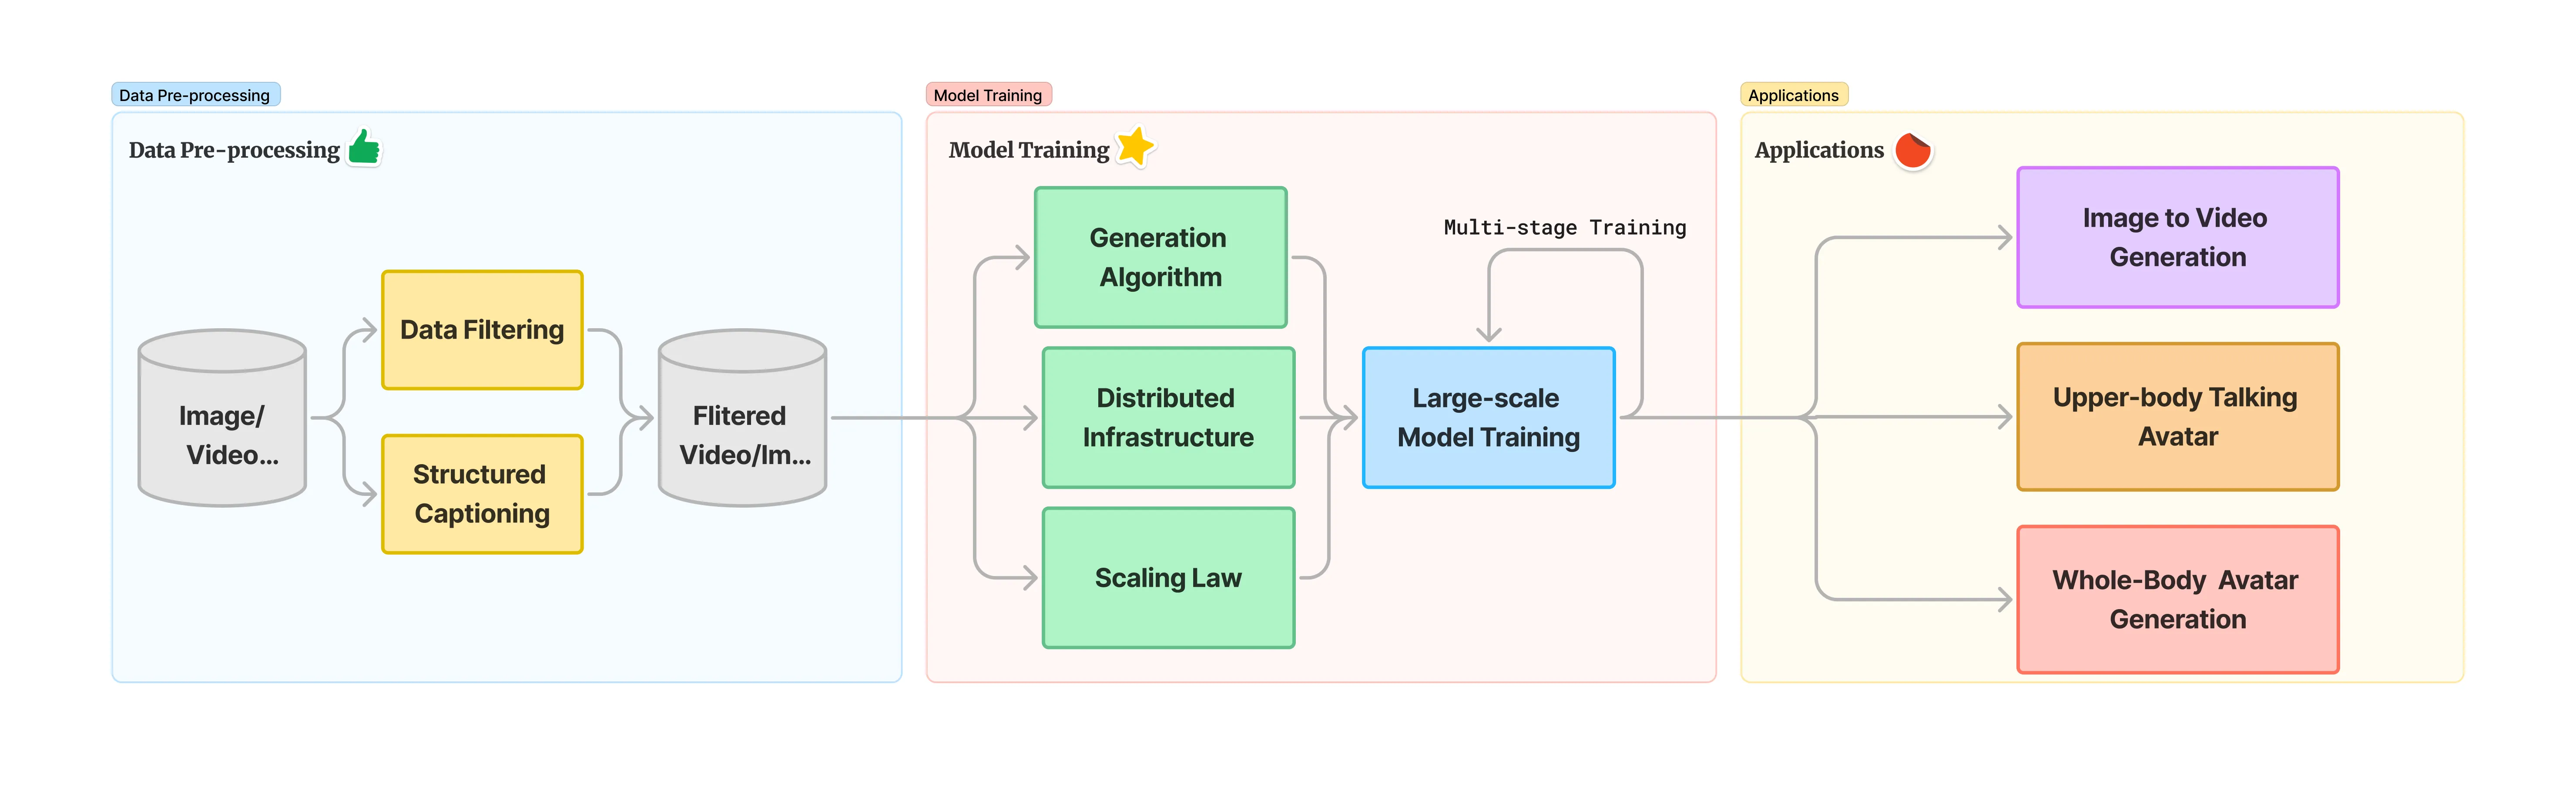
HunyuanVideo 的系统性框架涵盖:
- 数据层面: 多层次数据过滤管道(256p → 360p → 540p → 720p 渐进式)+ 结构化视频标注
- 架构层面: Causal 3D VAE + 统一 DiT 骨干 + MLLM 文本编码器
- 训练层面: 图像-视频联合训练 + 渐进式缩放 + 结构化提示词蒸馏
- 基础设施: 高效并行策略 + 自动容错 + 模型加速
2.3 数据预处理
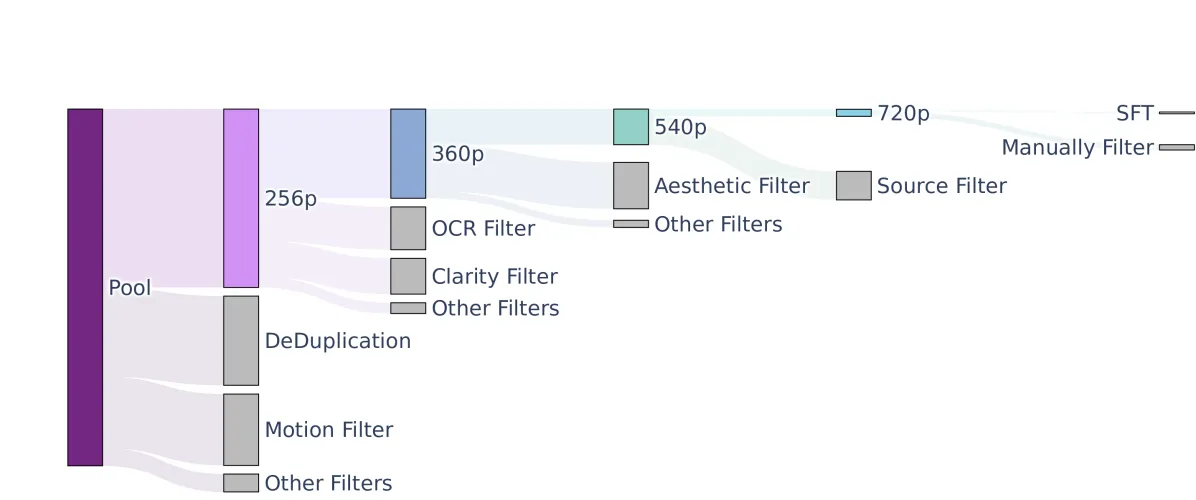
数据过滤管道(四层渐进式构建):
| 过滤器 | 方法 | 目的 |
|---|---|---|
| 场景分割 | PySceneDetect | 将视频拆分为单镜头片段 |
| 清晰度检测 | OpenCV Laplacian | 识别清晰帧作为起始帧 |
| 去重 | VideoCLIP Embedding + Cosine距离 | 去除相似片段 |
| 概念平衡 | k-means (~10K centroids) | 概念重采样和平衡 |
| 美学评分 | Dover | 评估视觉美学 |
| 模糊检测 | 内部训练模型 | 消除视觉模糊视频 |
| 运动检测 | 光流估计 | 过滤静止或慢动作视频 |
| 场景边界 | PySceneDetect + Transnet v2 | 获取场景边界信息 |
| OCR过滤 | 内部OCR模型 | 去除含过多文字的视频,定位裁剪字幕 |
| 水印检测 | YOLOX-like 模型 | 检测移除水印、边框、logo |
结构化标注(内部 VLM 生成 JSON 格式):
| 维度 | 说明 |
|---|---|
| Short Description | 捕捉场景主要内容 |
| Dense Description | 详细描述场景内容,包括场景转换和相机运动 |
| Background | 描述主体所处的环境 |
| Style | 视频风格(纪录片、电影、写实、科幻等) |
| Shot Type | 镜头类型(航拍、特写、中景、远景等) |
| Lighting | 光照条件 |
| Atmosphere | 氛围(舒适、紧张、神秘等) |
| Camera Movement | 14种相机运动类型(zoom in/out, pan, tilt, around等) |
通过 dropout + 排列组合策略合成多样化的提示词,防止过拟合并提高泛化能力。
三、技术架构 (Technical Architecture)
3.1 整体架构
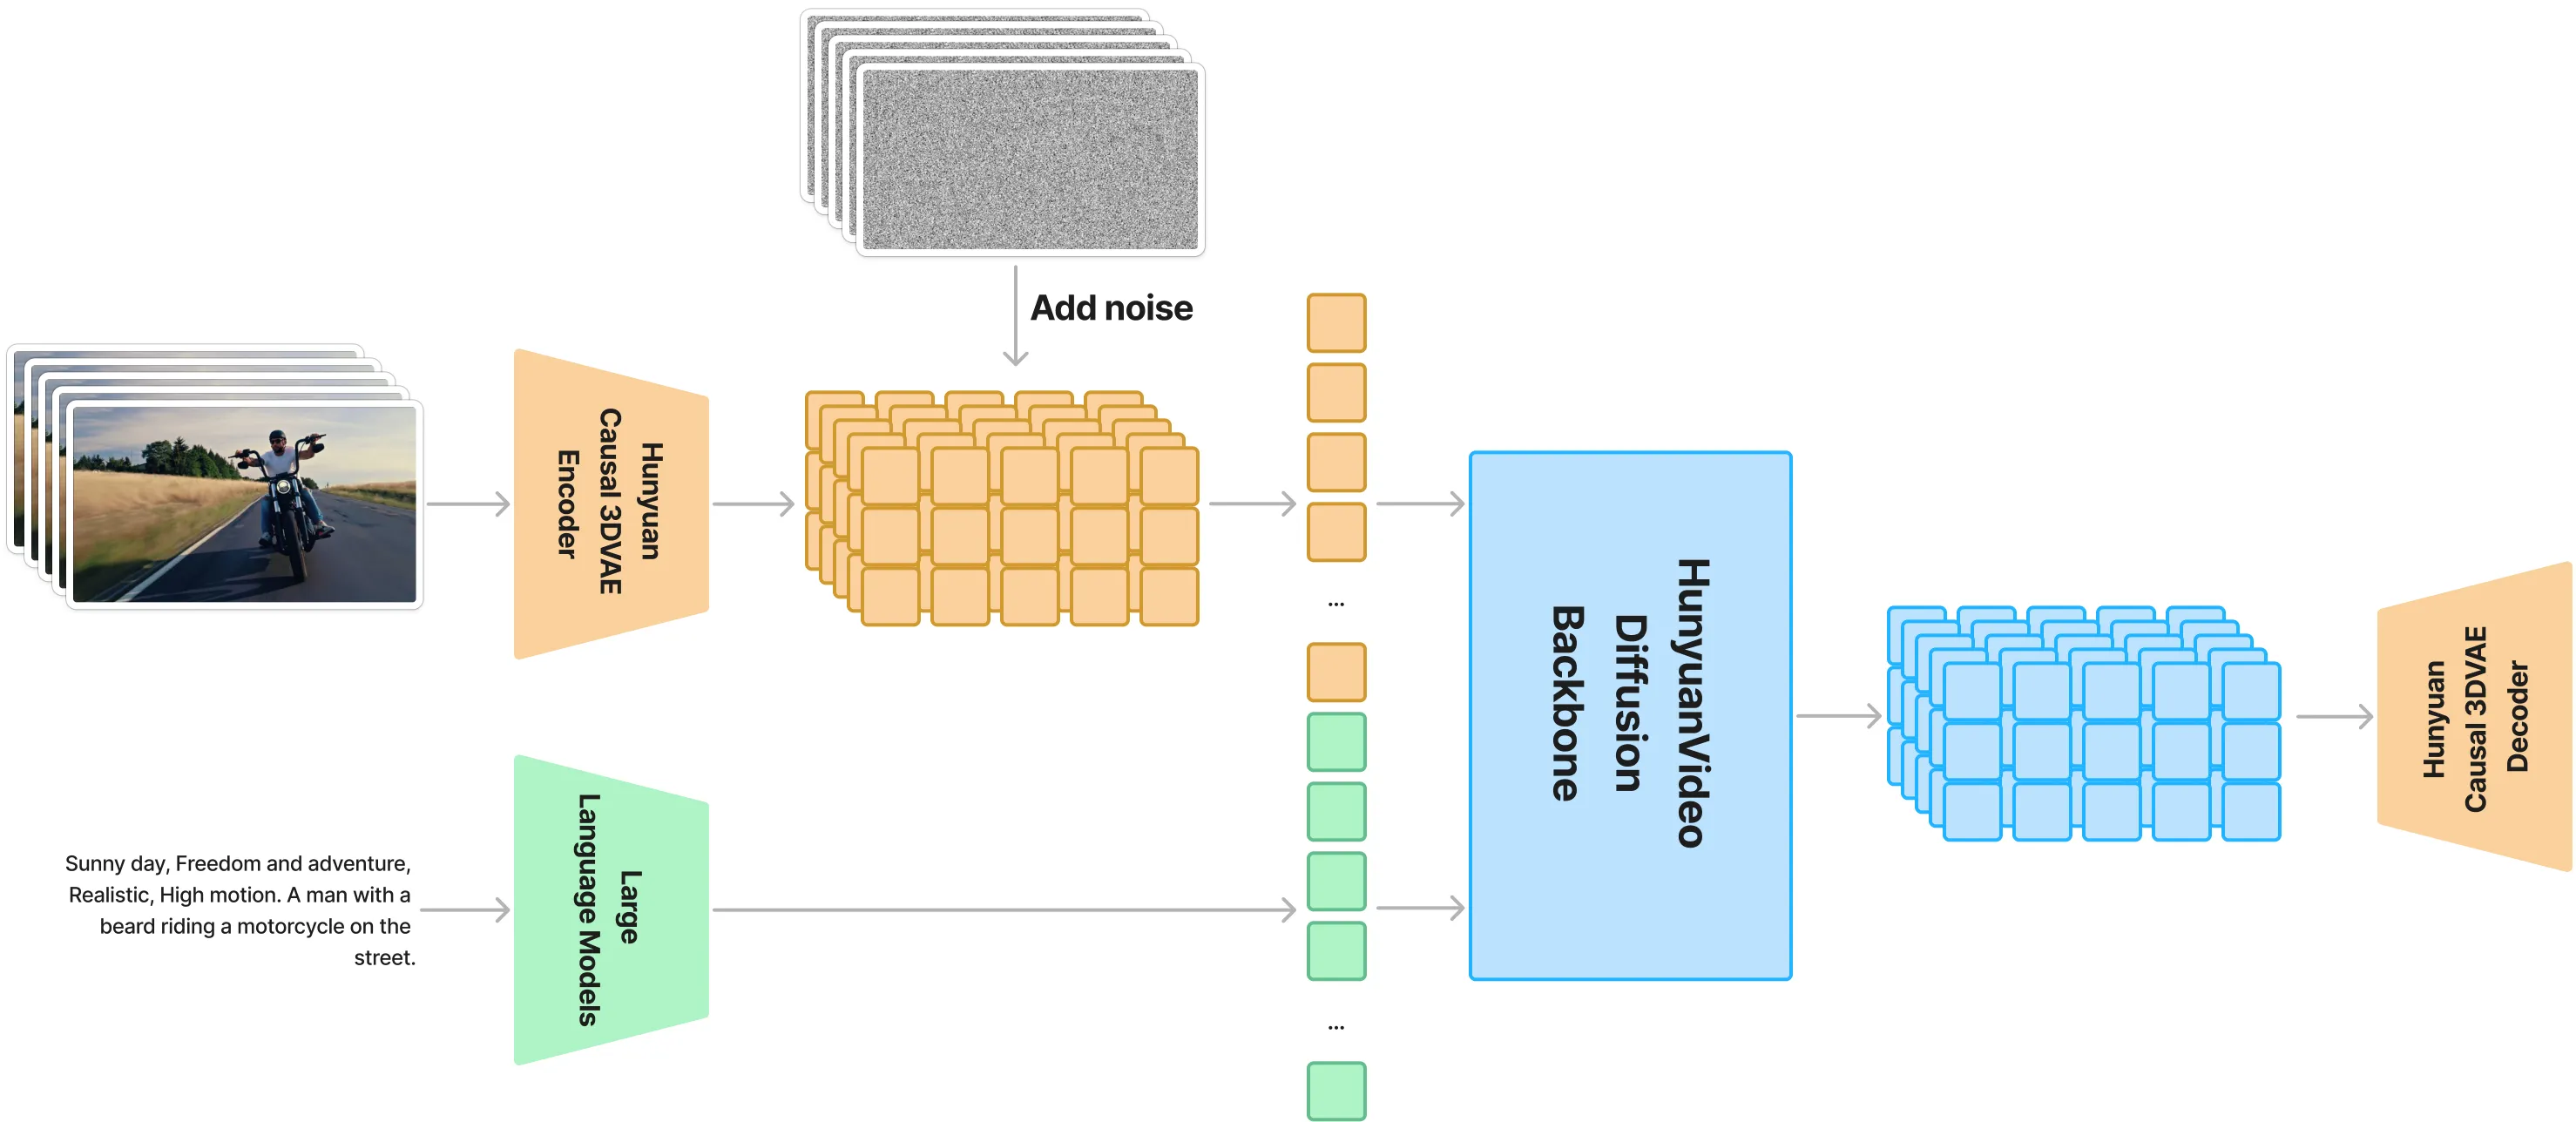
HunyuanVideo 在时空压缩的潜在空间上训练:
- 文本提示通过大型语言模型编码
- 高斯噪声和条件输入扩散骨干网络
- 输出潜在空间通过 3D VAE 解码为图像/视频
3.2 Causal 3D VAE
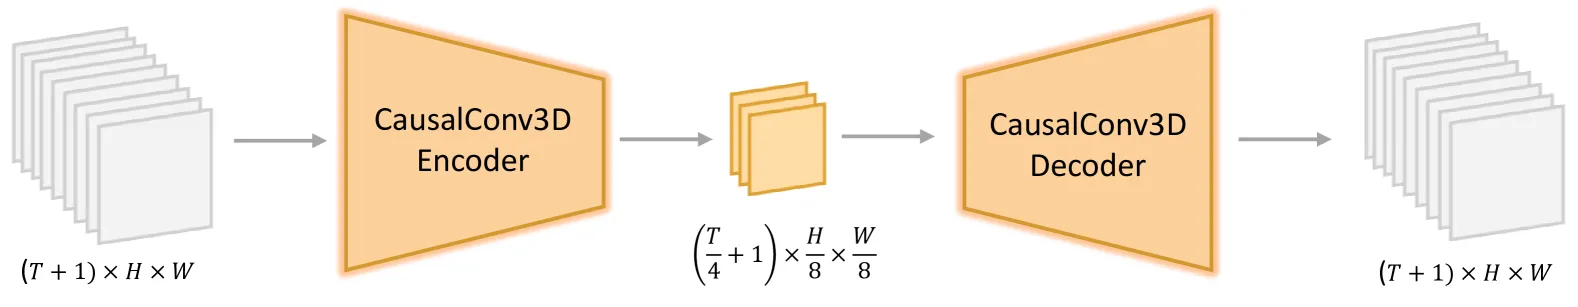
关键设计: 采用 CausalConv3D 处理视频和图像的联合压缩。
对于视频 (T+1) × 3 × H × W,压缩为 (T/c_t + 1) × C × (H/c_s) × (W/c_s),其中:
c_t = 4(时间压缩比)c_s = 8(空间压缩比)C = 16(潜在通道数)
训练损失:
Loss = L₁ + 0.1·L_lpips + 0.05·L_adv + 10⁻⁶·L_kl采用课程学习策略:从低分辨率短视频渐进到高分辨率长视频。为提高高运动视频重建质量,随机选择 1~8 的采样间隔均匀采样帧。
推理策略: 时空平铺(Spatial-Temporal Tiling)策略,将高分辨率长视频分割为重叠块分别编解码,重叠区域线性融合。训练时随机启用/禁用平铺策略以确保一致性。
VAE 性能对比:
| 模型 | 下采样 | |z| | ImageNet PSNR↑ | MCL-JCV PSNR↑ |
|---|---|---|---|---|
| FLUX-VAE | 1×8×8 | 16 | 32.70 | - |
| OpenSora-1.2 | 4×8×8 | 4 | 28.11 | 30.15 |
| CogvideoX-1.5 | 4×8×8 | 16 | 31.73 | 33.22 |
| Cosmos-VAE | 4×8×8 | 16 | 30.07 | 32.76 |
| Ours | 4×8×8 | 16 | 33.14 | 35.39 |
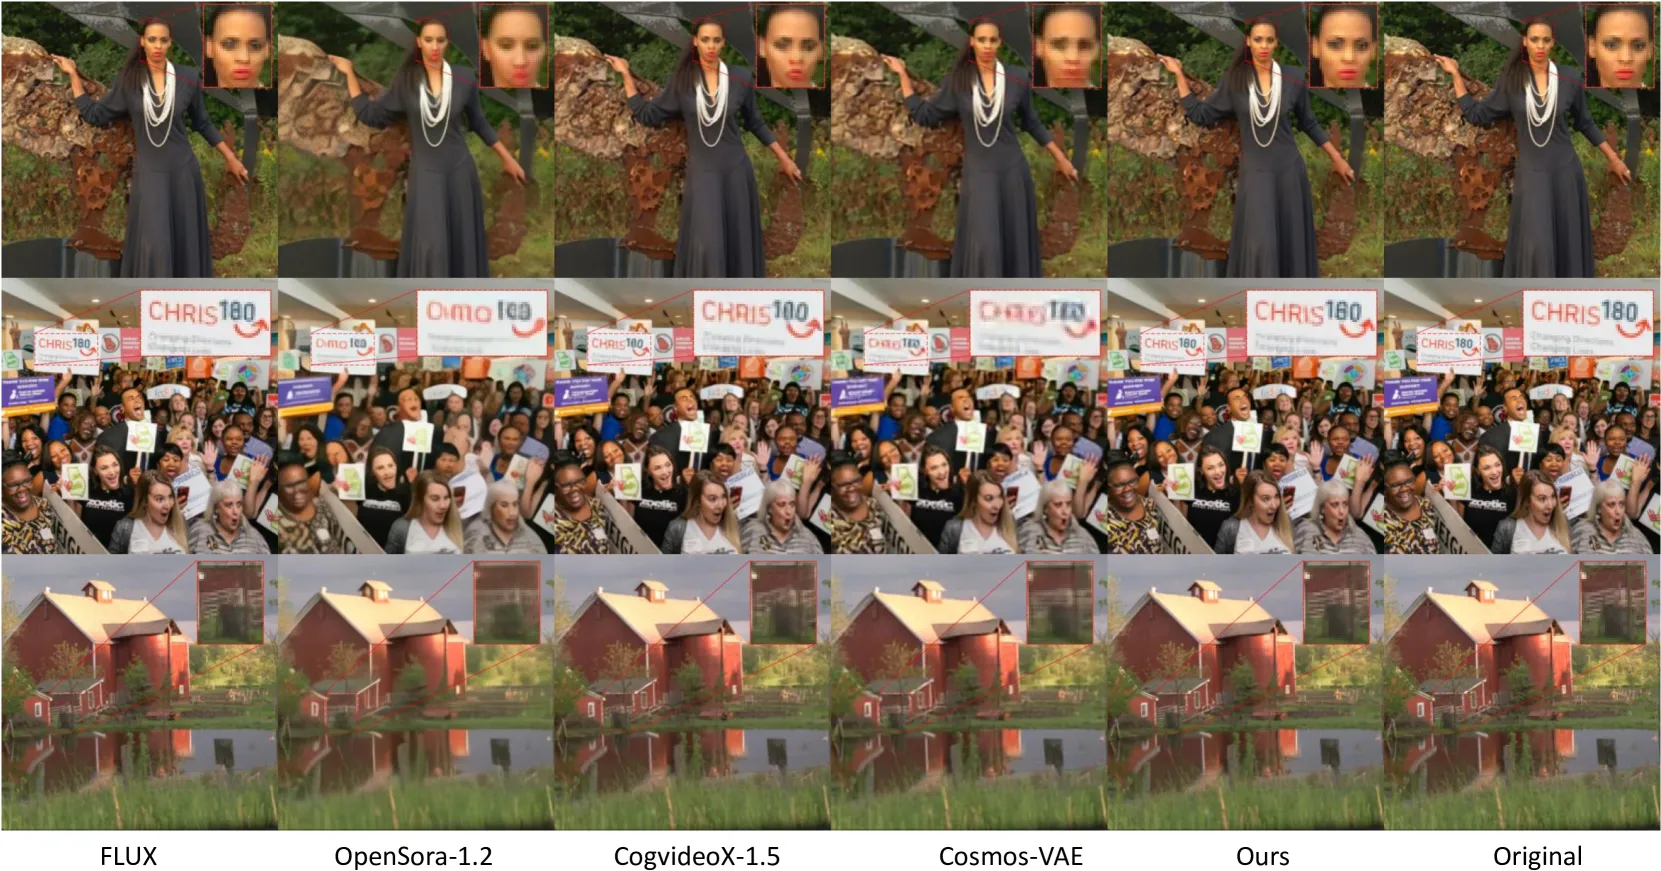
3.3 统一图文生成架构
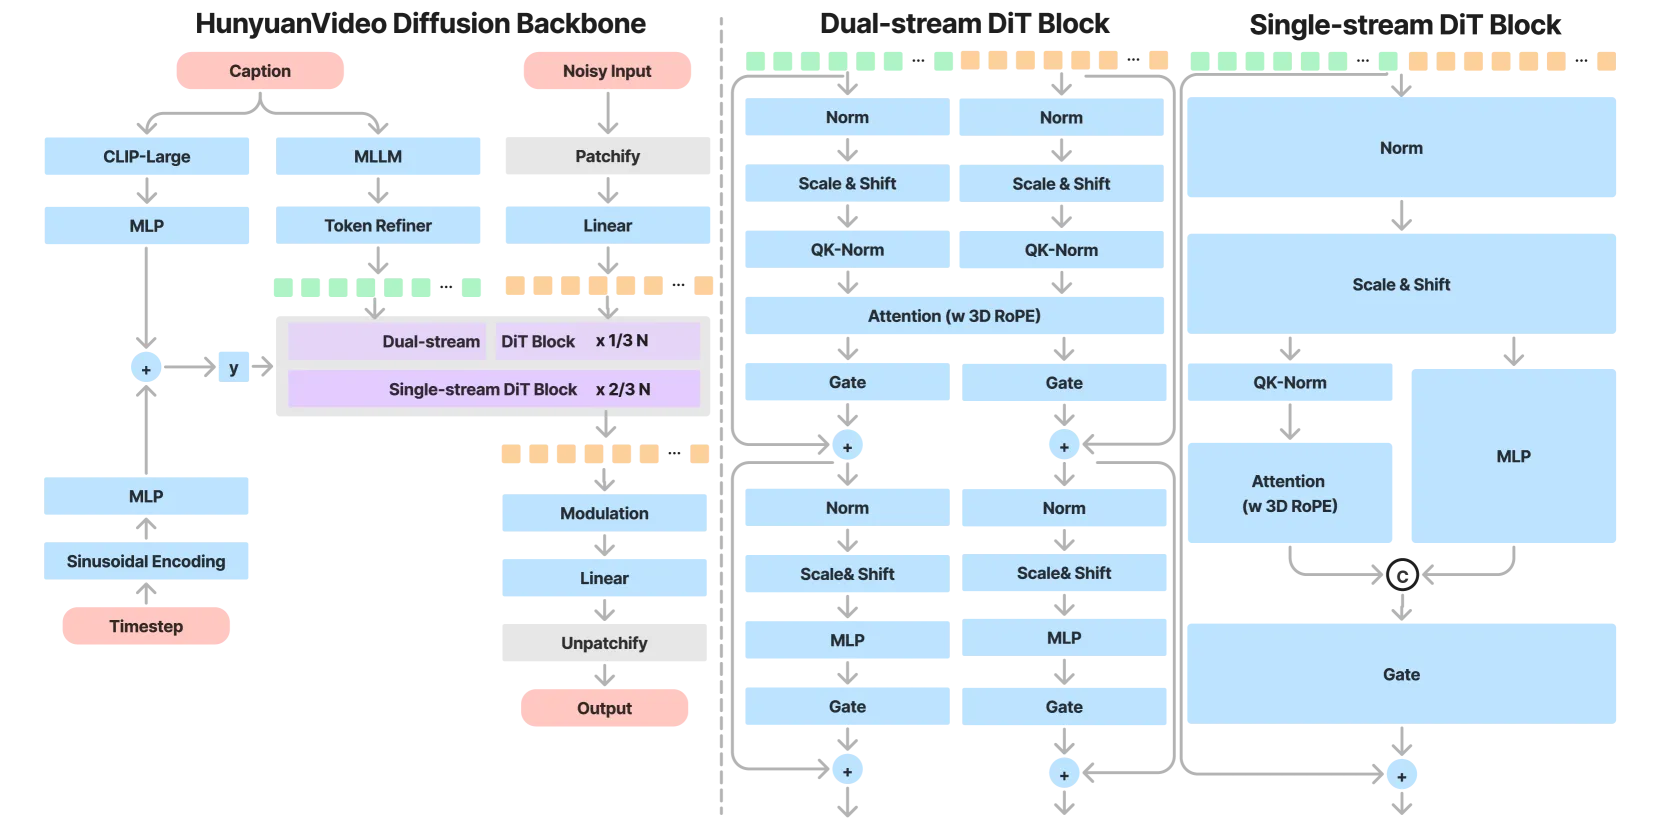
为什么选择 Full Attention:
- 相比分割时空注意力(Divided Spatiotemporal Attention)性能更优
- 支持图像和视频的统一生成,简化训练流程
- 更好地利用 LLM 相关加速能力
输入处理:
- 视频分支: 3D 潜在空间中的 latents → patchify → 1D token 序列(长度
T/k_t · H/k_h · W/k_w) - 文本分支: MLLM 编码文本 → 细粒度语义嵌入
- 统一处理: 图像视为单帧视频,统一输入管道
模型配置 (13B):
| 参数 | 值 |
|---|---|
| 模型大小 | 13B 参数 |
| 层数 | 70 |
| 隐藏维度 | 3072 |
| 注意力头数 | 24 |
| 上下文长度 | 支持长序列 |
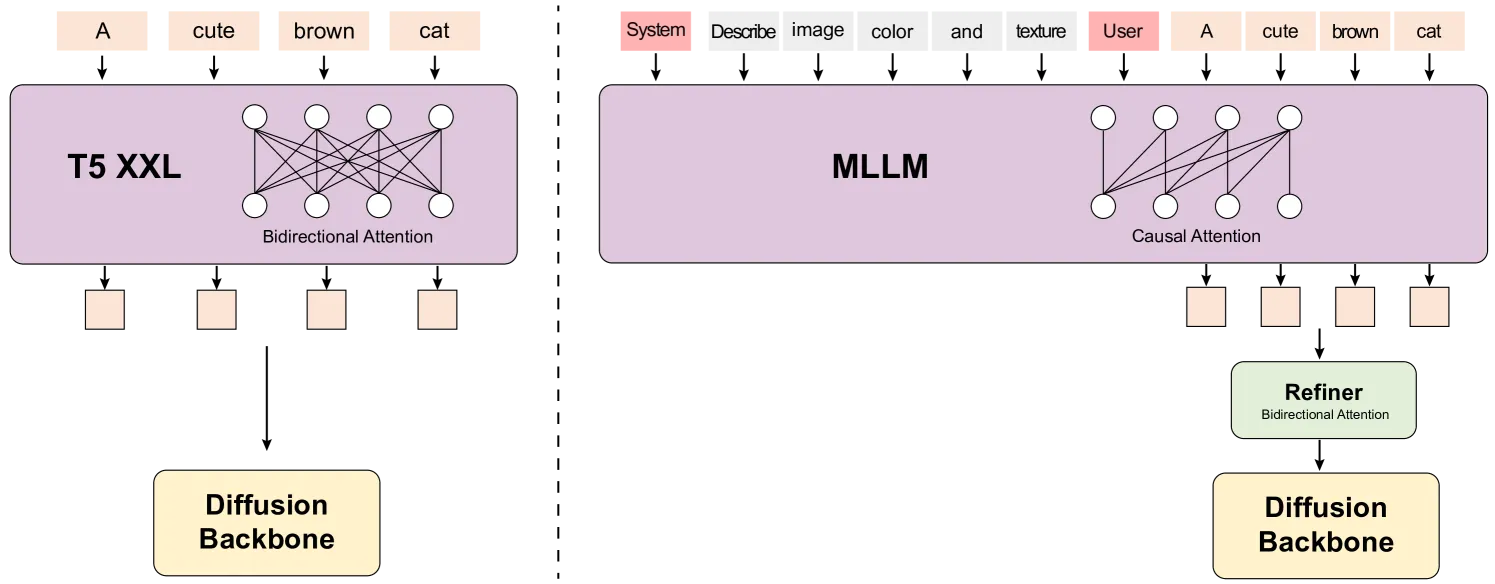
文本编码器选择 MLLM 而非 T5-XXL 的原因:
- MLLM 经视觉指令微调后,特征空间中图文对齐更好,减轻扩散模型的指令跟随难度
- 相比 CLIP,MLLM 在图像细节描述和复杂推理方面表现更优
- MLLM 可作为 zero-shot learner,通过系统提示帮助文本特征关注关键信息
- 引入额外的双向 token 细化器弥补因果注意力的不足
- CLIP 文本特征仍作为全局引导融入双流和单流 DiT 块
3.4 模型缩放策略
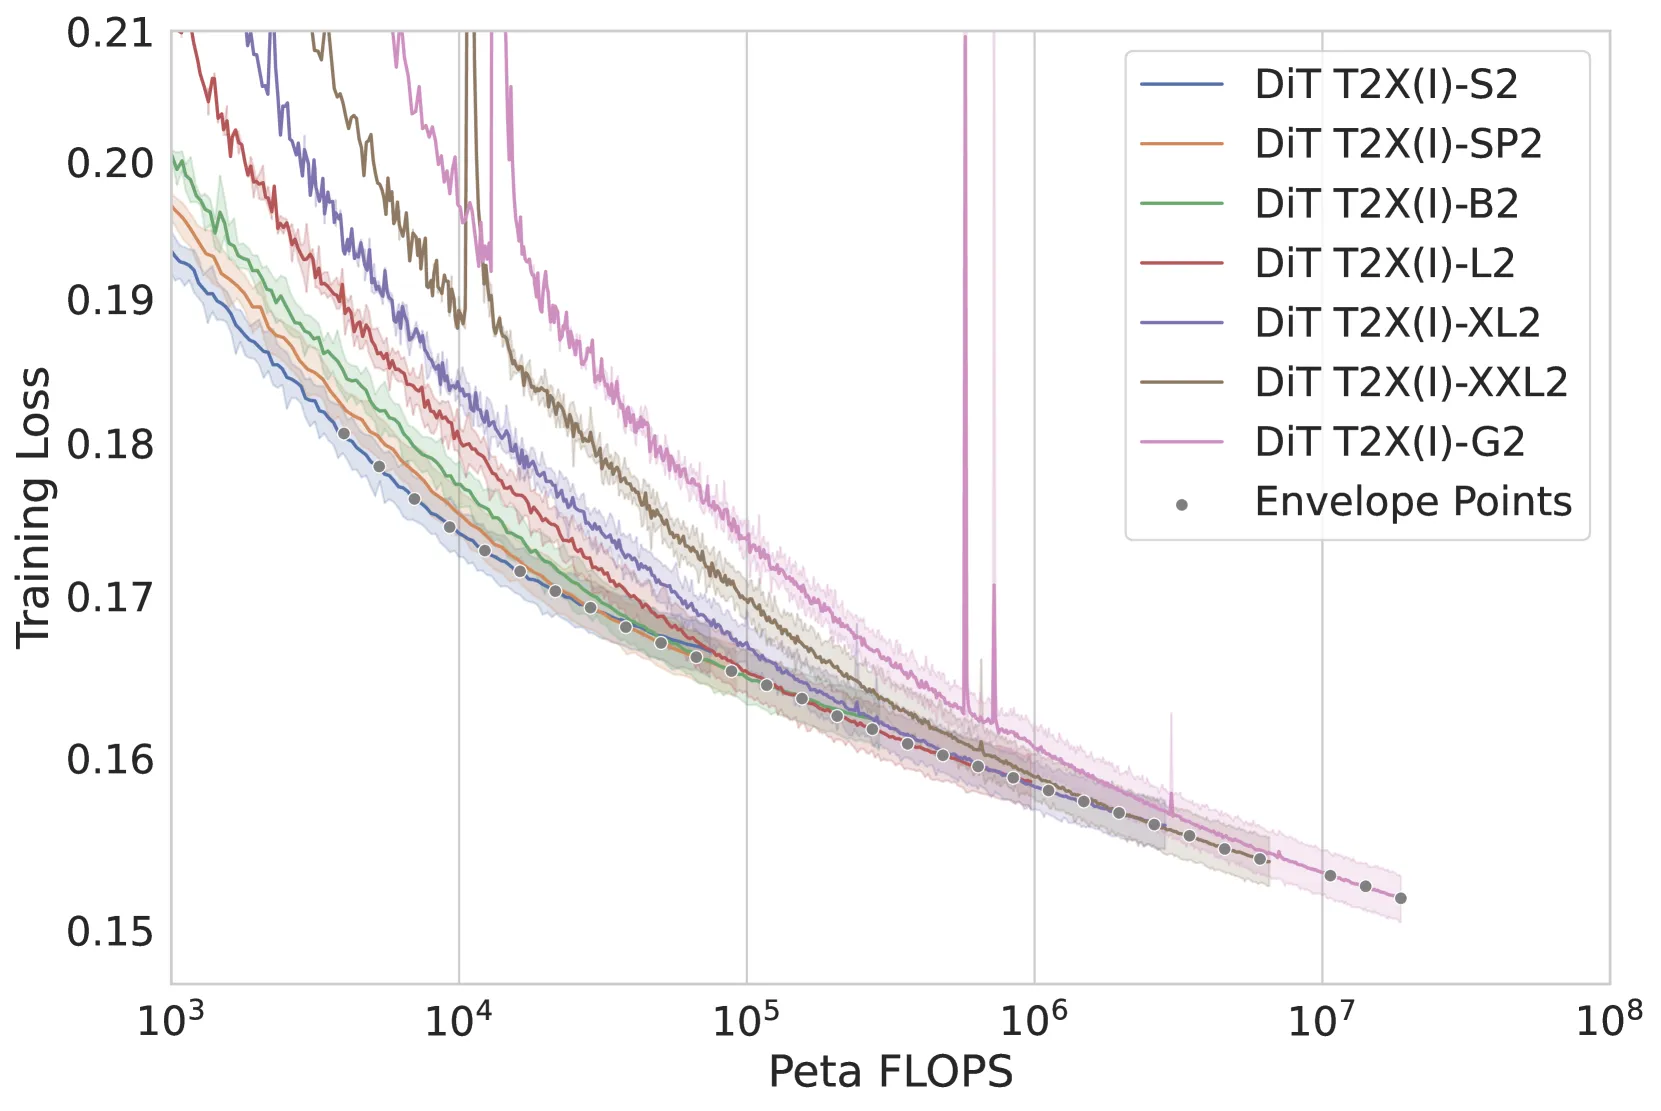
渐进式训练三阶段:
- 图像预训练: 基于预训练图像扩散模型,使用大规模图文数据训练基础架构
- 视频-图像联合训练: 引入视频数据,采用两阶段渐进式图像预训练加速收敛
- 高分辨率微调: 使用人工标注的 ~1M 高质量数据进行 SFT
缩放定律发现:
- 遵循 Chinchilla 定律的扩展规律
- 通过图像任务的缩放定律推导视频任务的配置
- 图像预训练为视频任务奠定基础,减少 5× 计算资源需求
3.5 Prompt Rewrite
使用 Hunyuan-Large + LoRA 微调模型进行提示词改写,加速简化应用流程。
四、核心创新 (Key Innovations)
| 创新点 | 说明 | 效果 |
|---|---|---|
| 分层数据过滤管道 | 4层渐进式构建(256p→360p→540p→720p)+ 多维度结构化标注 | 显著提升生成质量和多样性 |
| Causal 3D VAE | 从 scratch 训练,联合视频+图像重建,GAN+感知损失 | PSNR 超越所有开源竞品 |
| 统一图文架构 | Full Attention DiT,MLLM 文本编码器,双流/单流双模式 | 简化训练,提升生成质量 |
| 渐进式缩放 | 图像预训练 → 联合训练 → 高分微调 | 减少 5× 计算资源 |
| 时间步偏移 | 推理步数缩减,利用首步贡献最大的观察 | 高效推理 |
| 文本引导蒸馏 | 加速推理流程 | 减少采样步数 |
五、模型加速 (Model Acceleration)
5.1 推理步数缩减
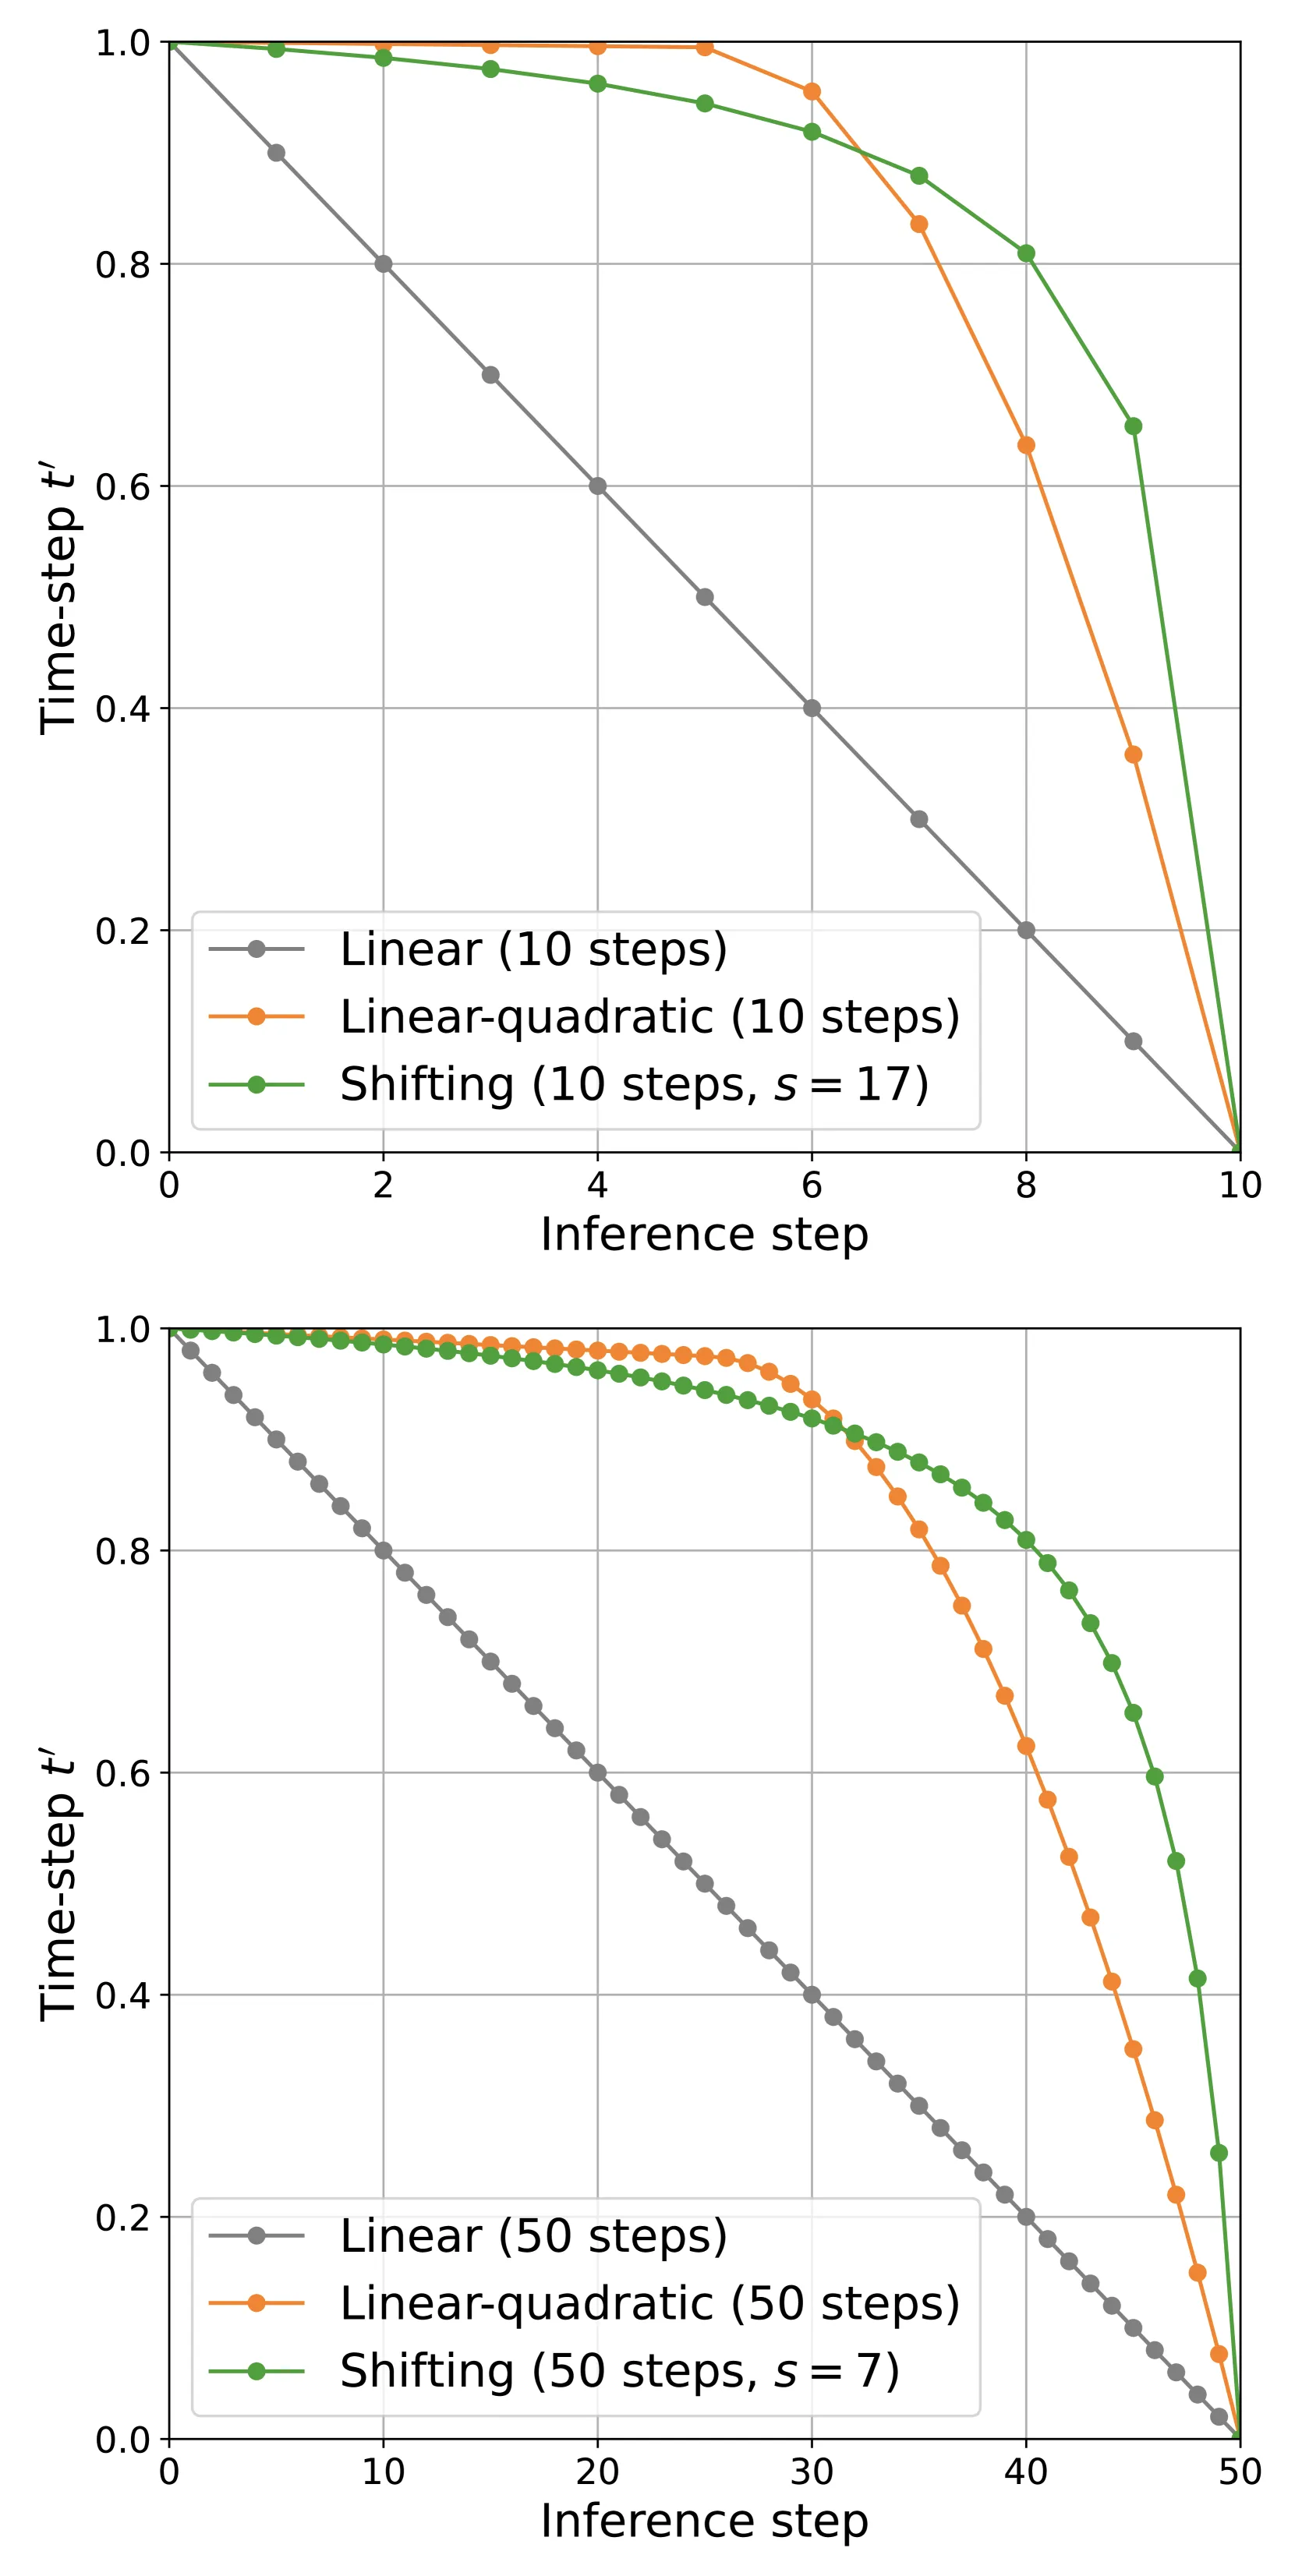
时间步偏移 (Time-step Shifting): 受启发于”前几步贡献最大变化”的观察,通过偏移时间步分布来处理低推理步数场景。给定推理步 q ∈ {1, 2, ..., Q},输入时间条件 t = 1 - q/Q。
5.2 文本引导蒸馏 (Text-guidance Distillation)
通过蒸馏技术进一步加速推理过程。
5.3 高效可扩展训练
- 硬件基础设施: 大规模 GPU 集群
- 并行策略: 数据并行 + 张量并行 + 流水线并行
- 优化: 混合精度训练 + 梯度累积
- 自动容错: 训练过程中的故障恢复机制
六、实验结果 (Experimental Results)
6.1 模型性能评估
专业人工评估结果(5秒视频生成):
| 模型 | 时长 | 文本对齐 | 运动质量 | 视觉质量 | 综合排名 |
|---|---|---|---|---|---|
| HunyuanVideo (Ours) | 5s | 61.8% | 66.5% | 95.7% | 41.3% |
| CNTopA (API) | 5s | 62.6% | 61.7% | … | … |
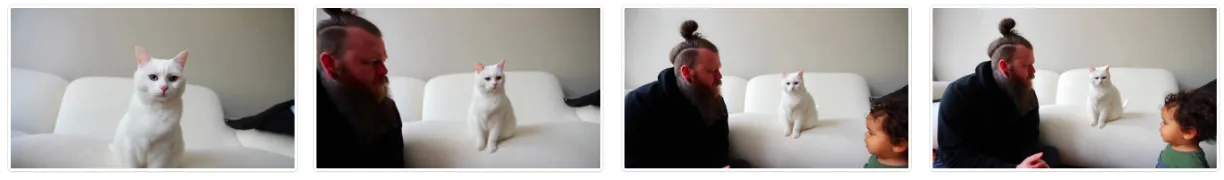
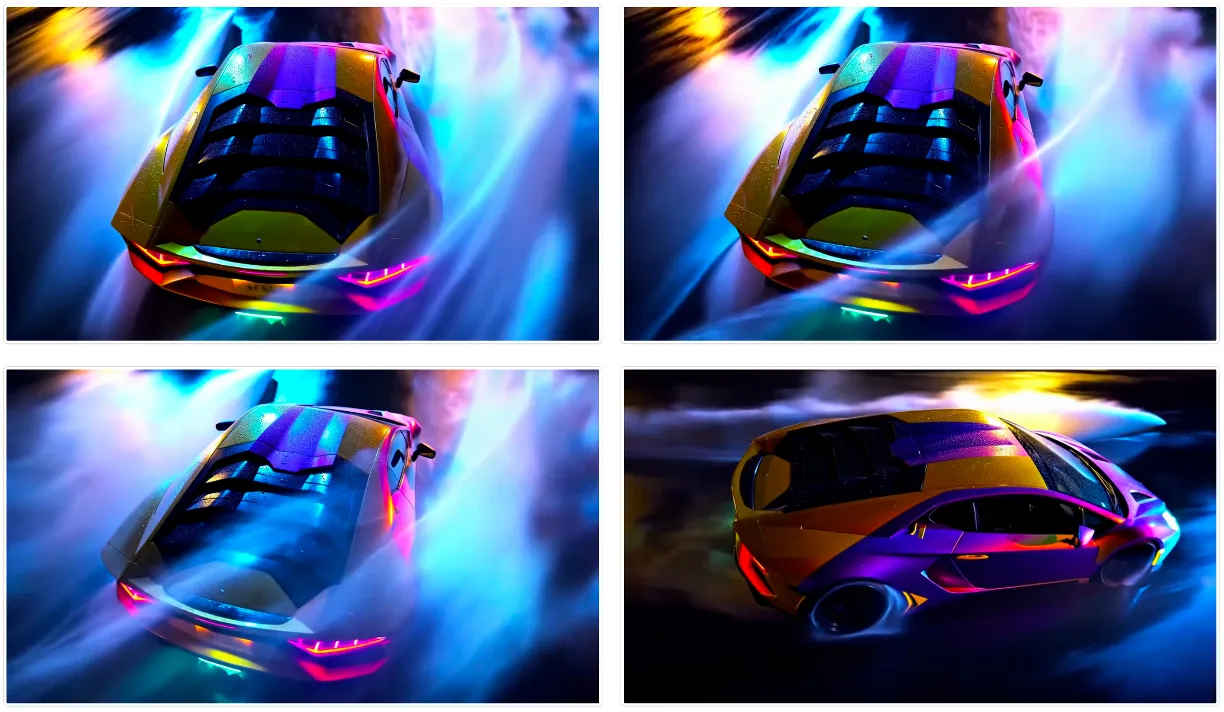
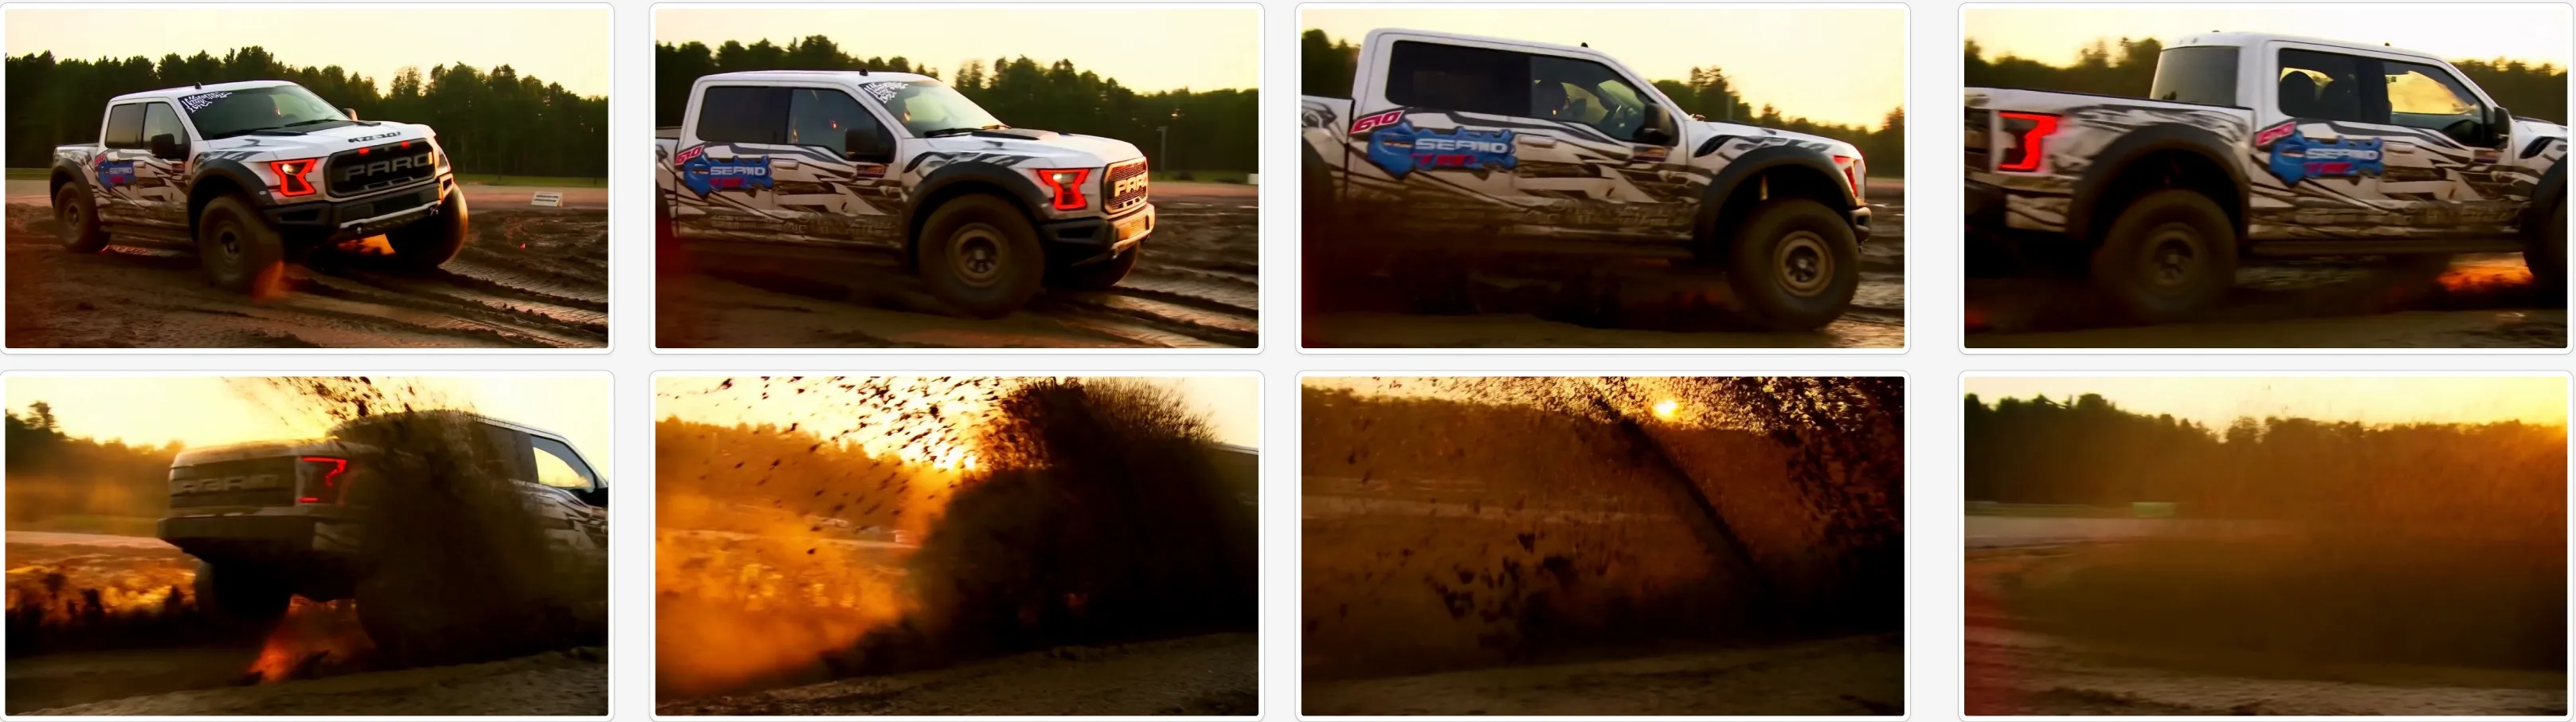
HunyuanVideo 在专业人士评估中排名第一,优于 Runway Gen-3、Luma 1.6 和三个顶级中国视频生成模型。
6.2 生成质量展示
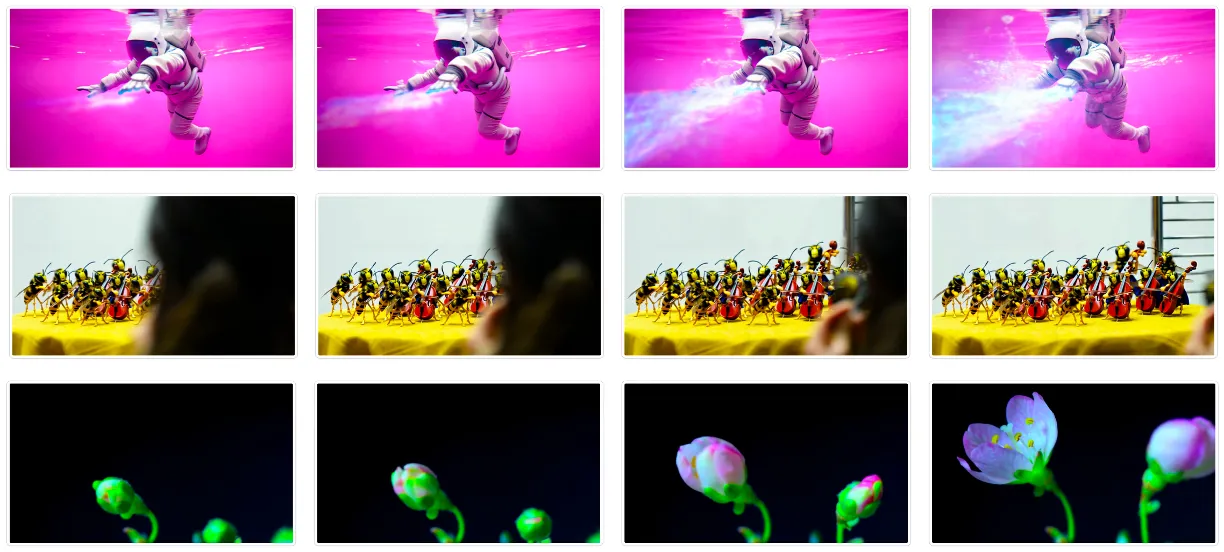
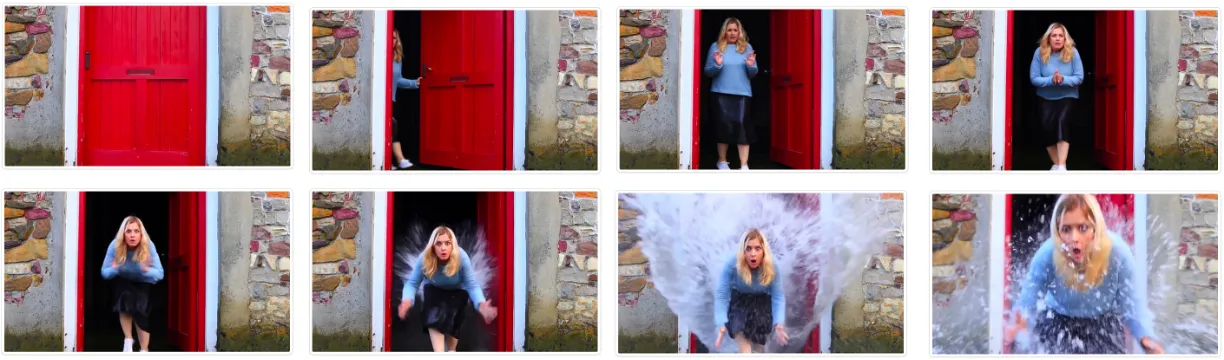
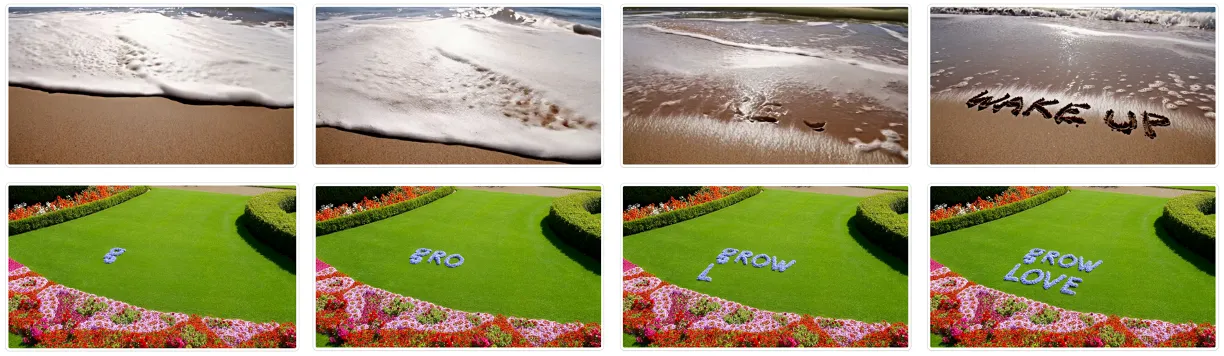
6.3 与 SOTA 对比
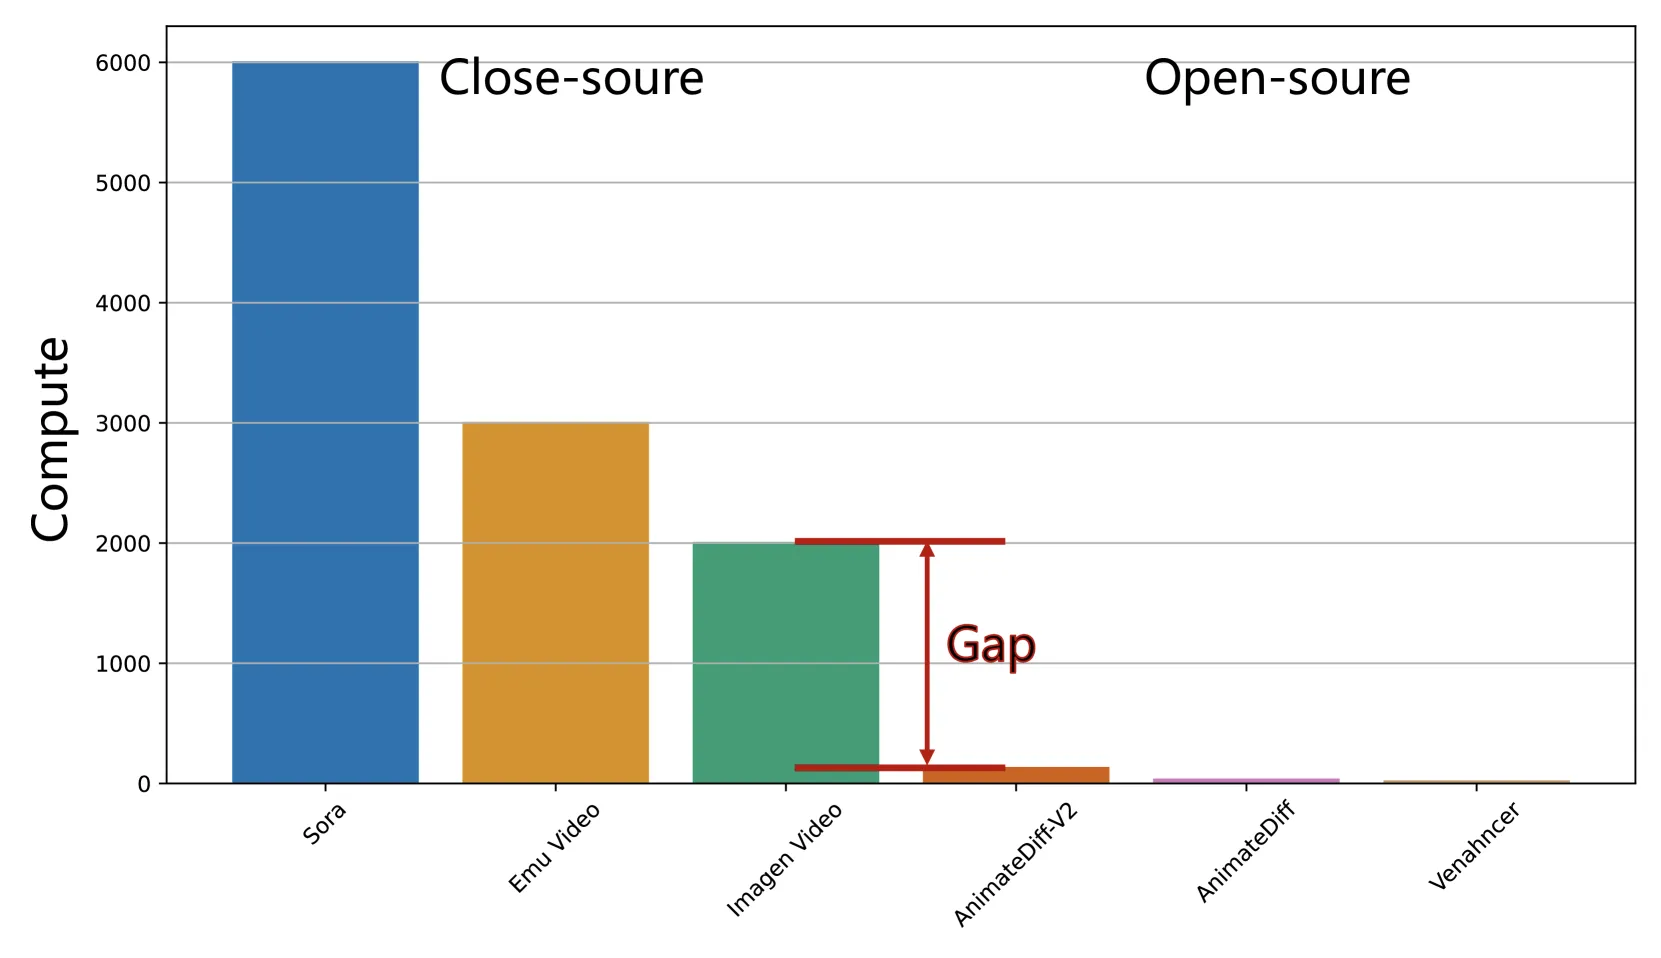
七、应用 (Applications)
7.1 基于视频的音频生成
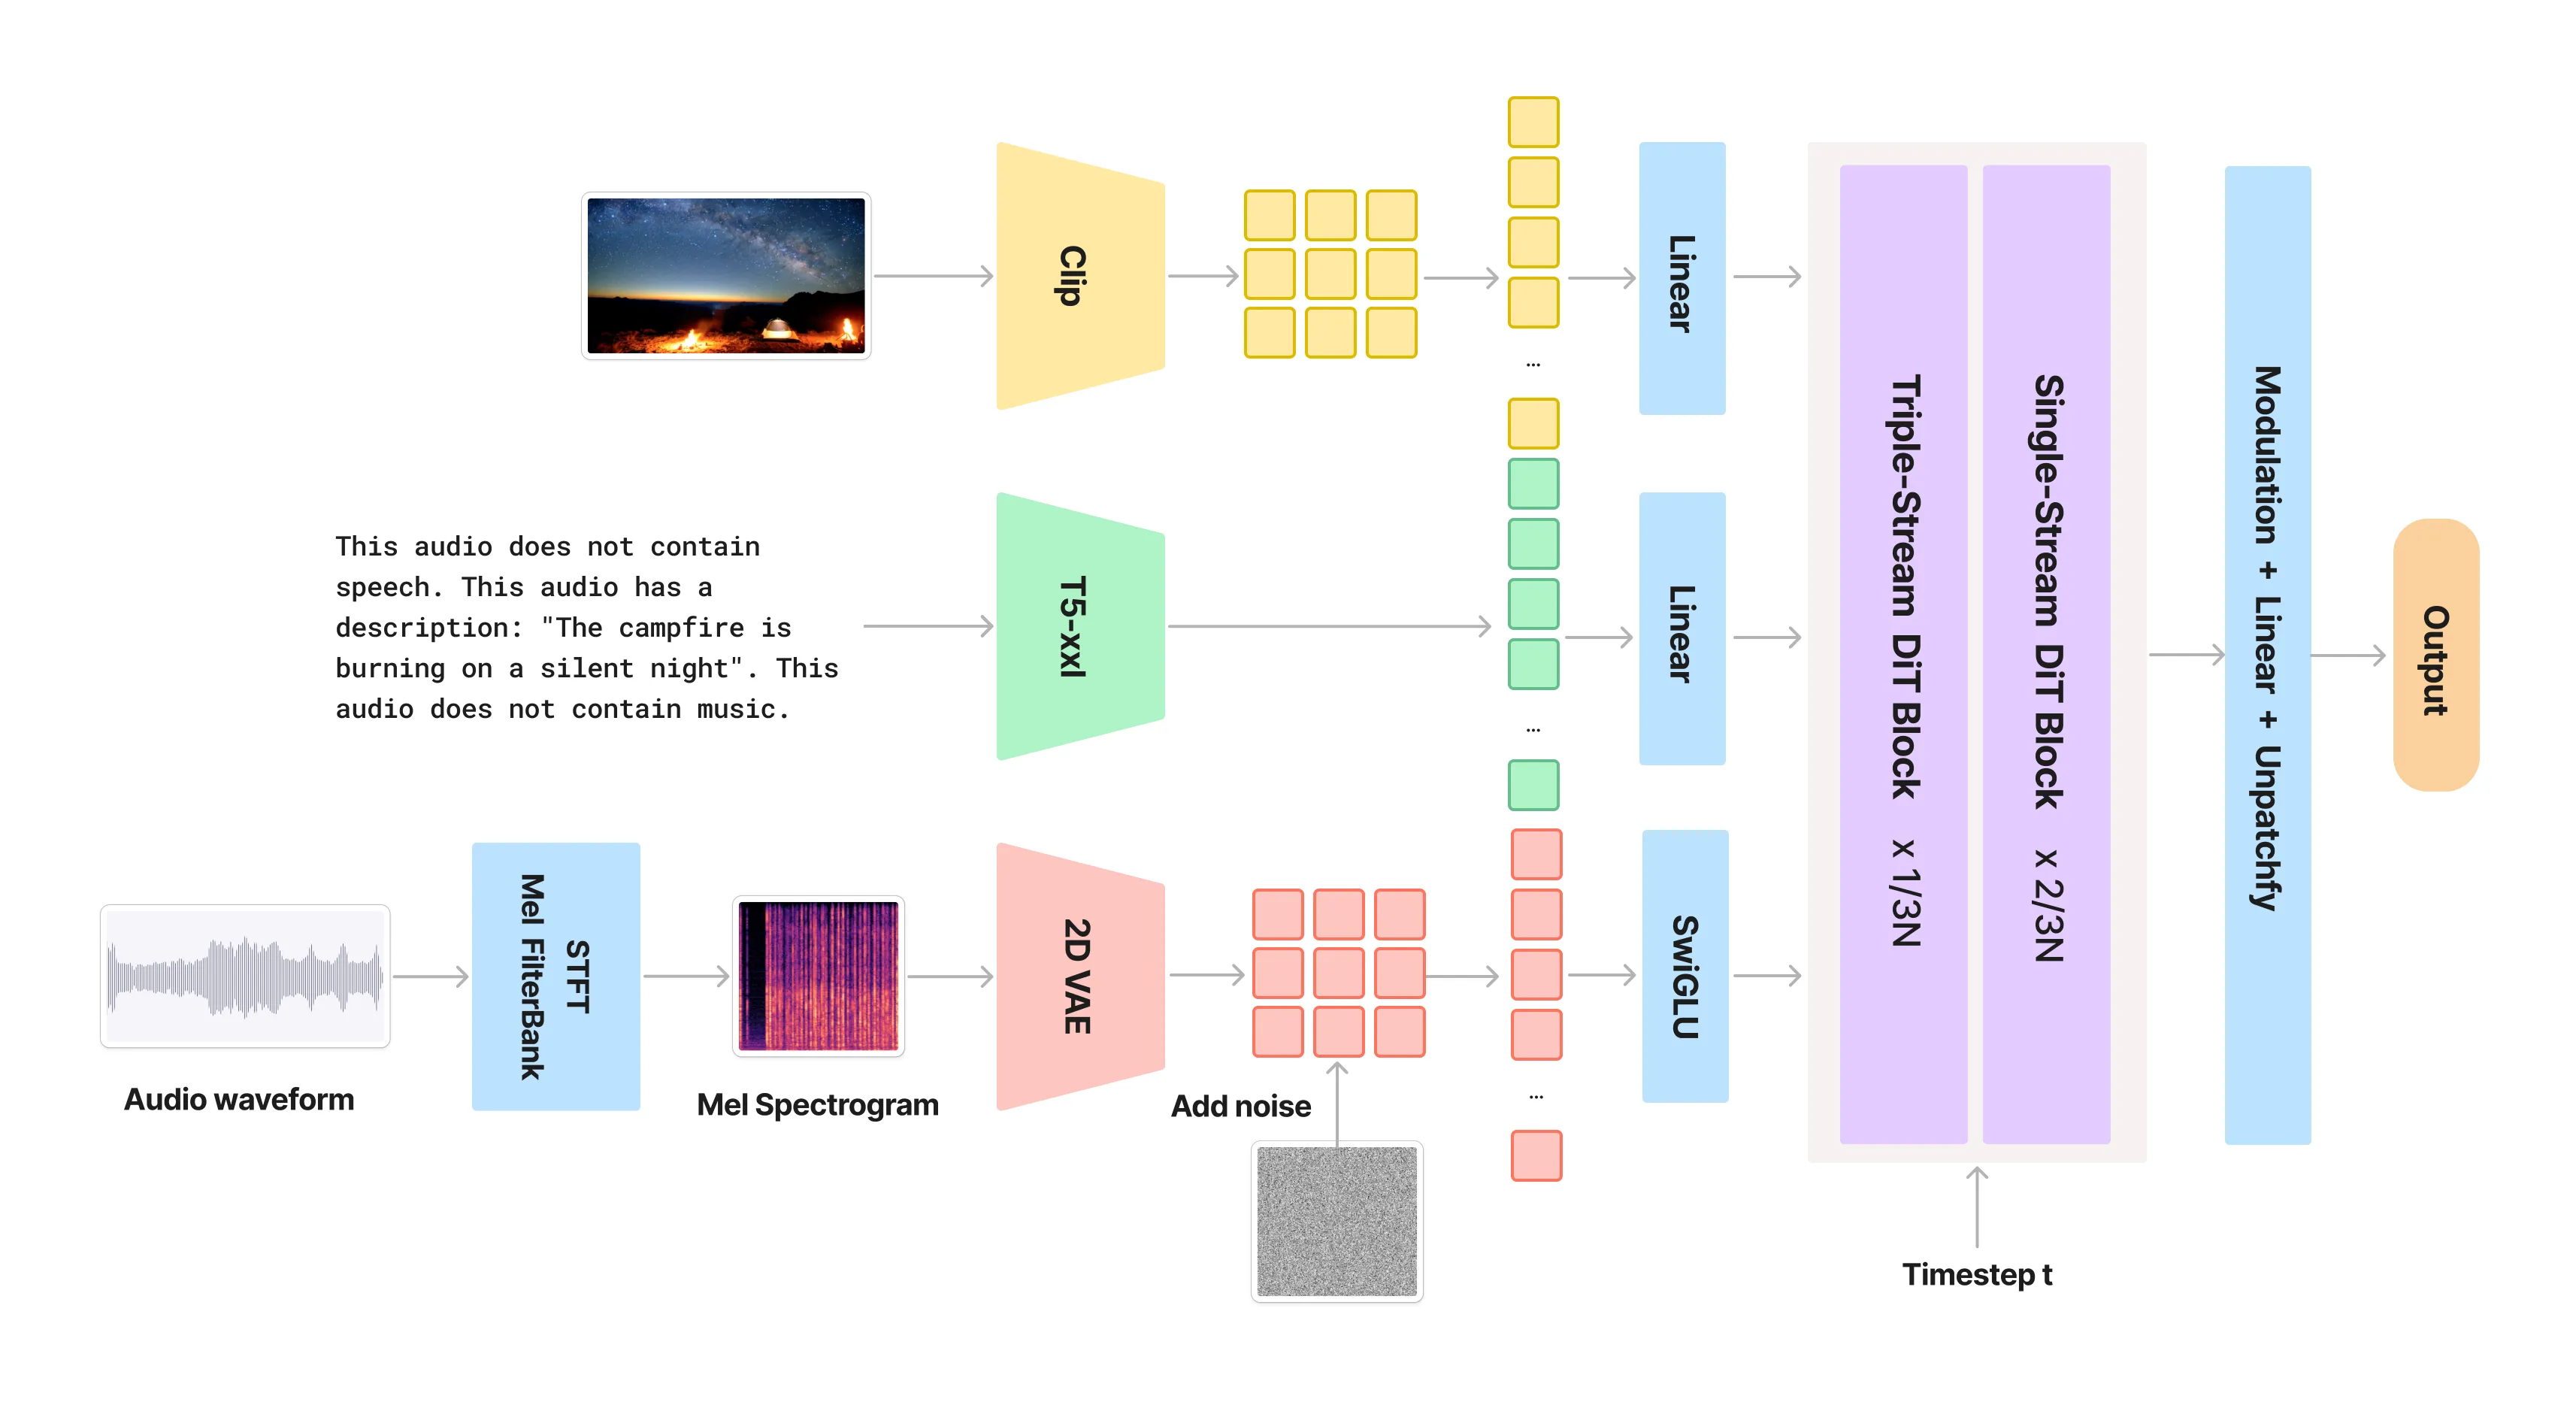
从生成的视频中同步生成音效和音乐。
7.2 Hunyuan 图生视频 (Image-to-Video)
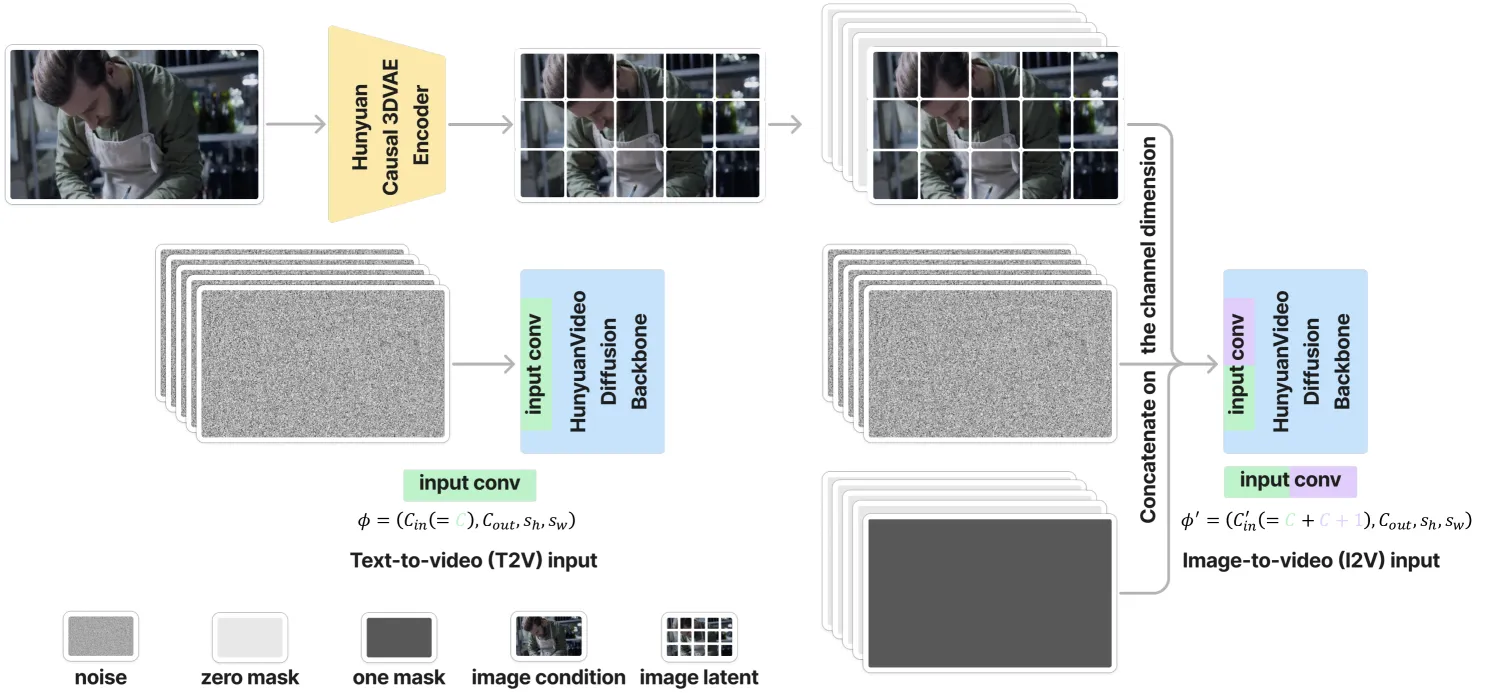
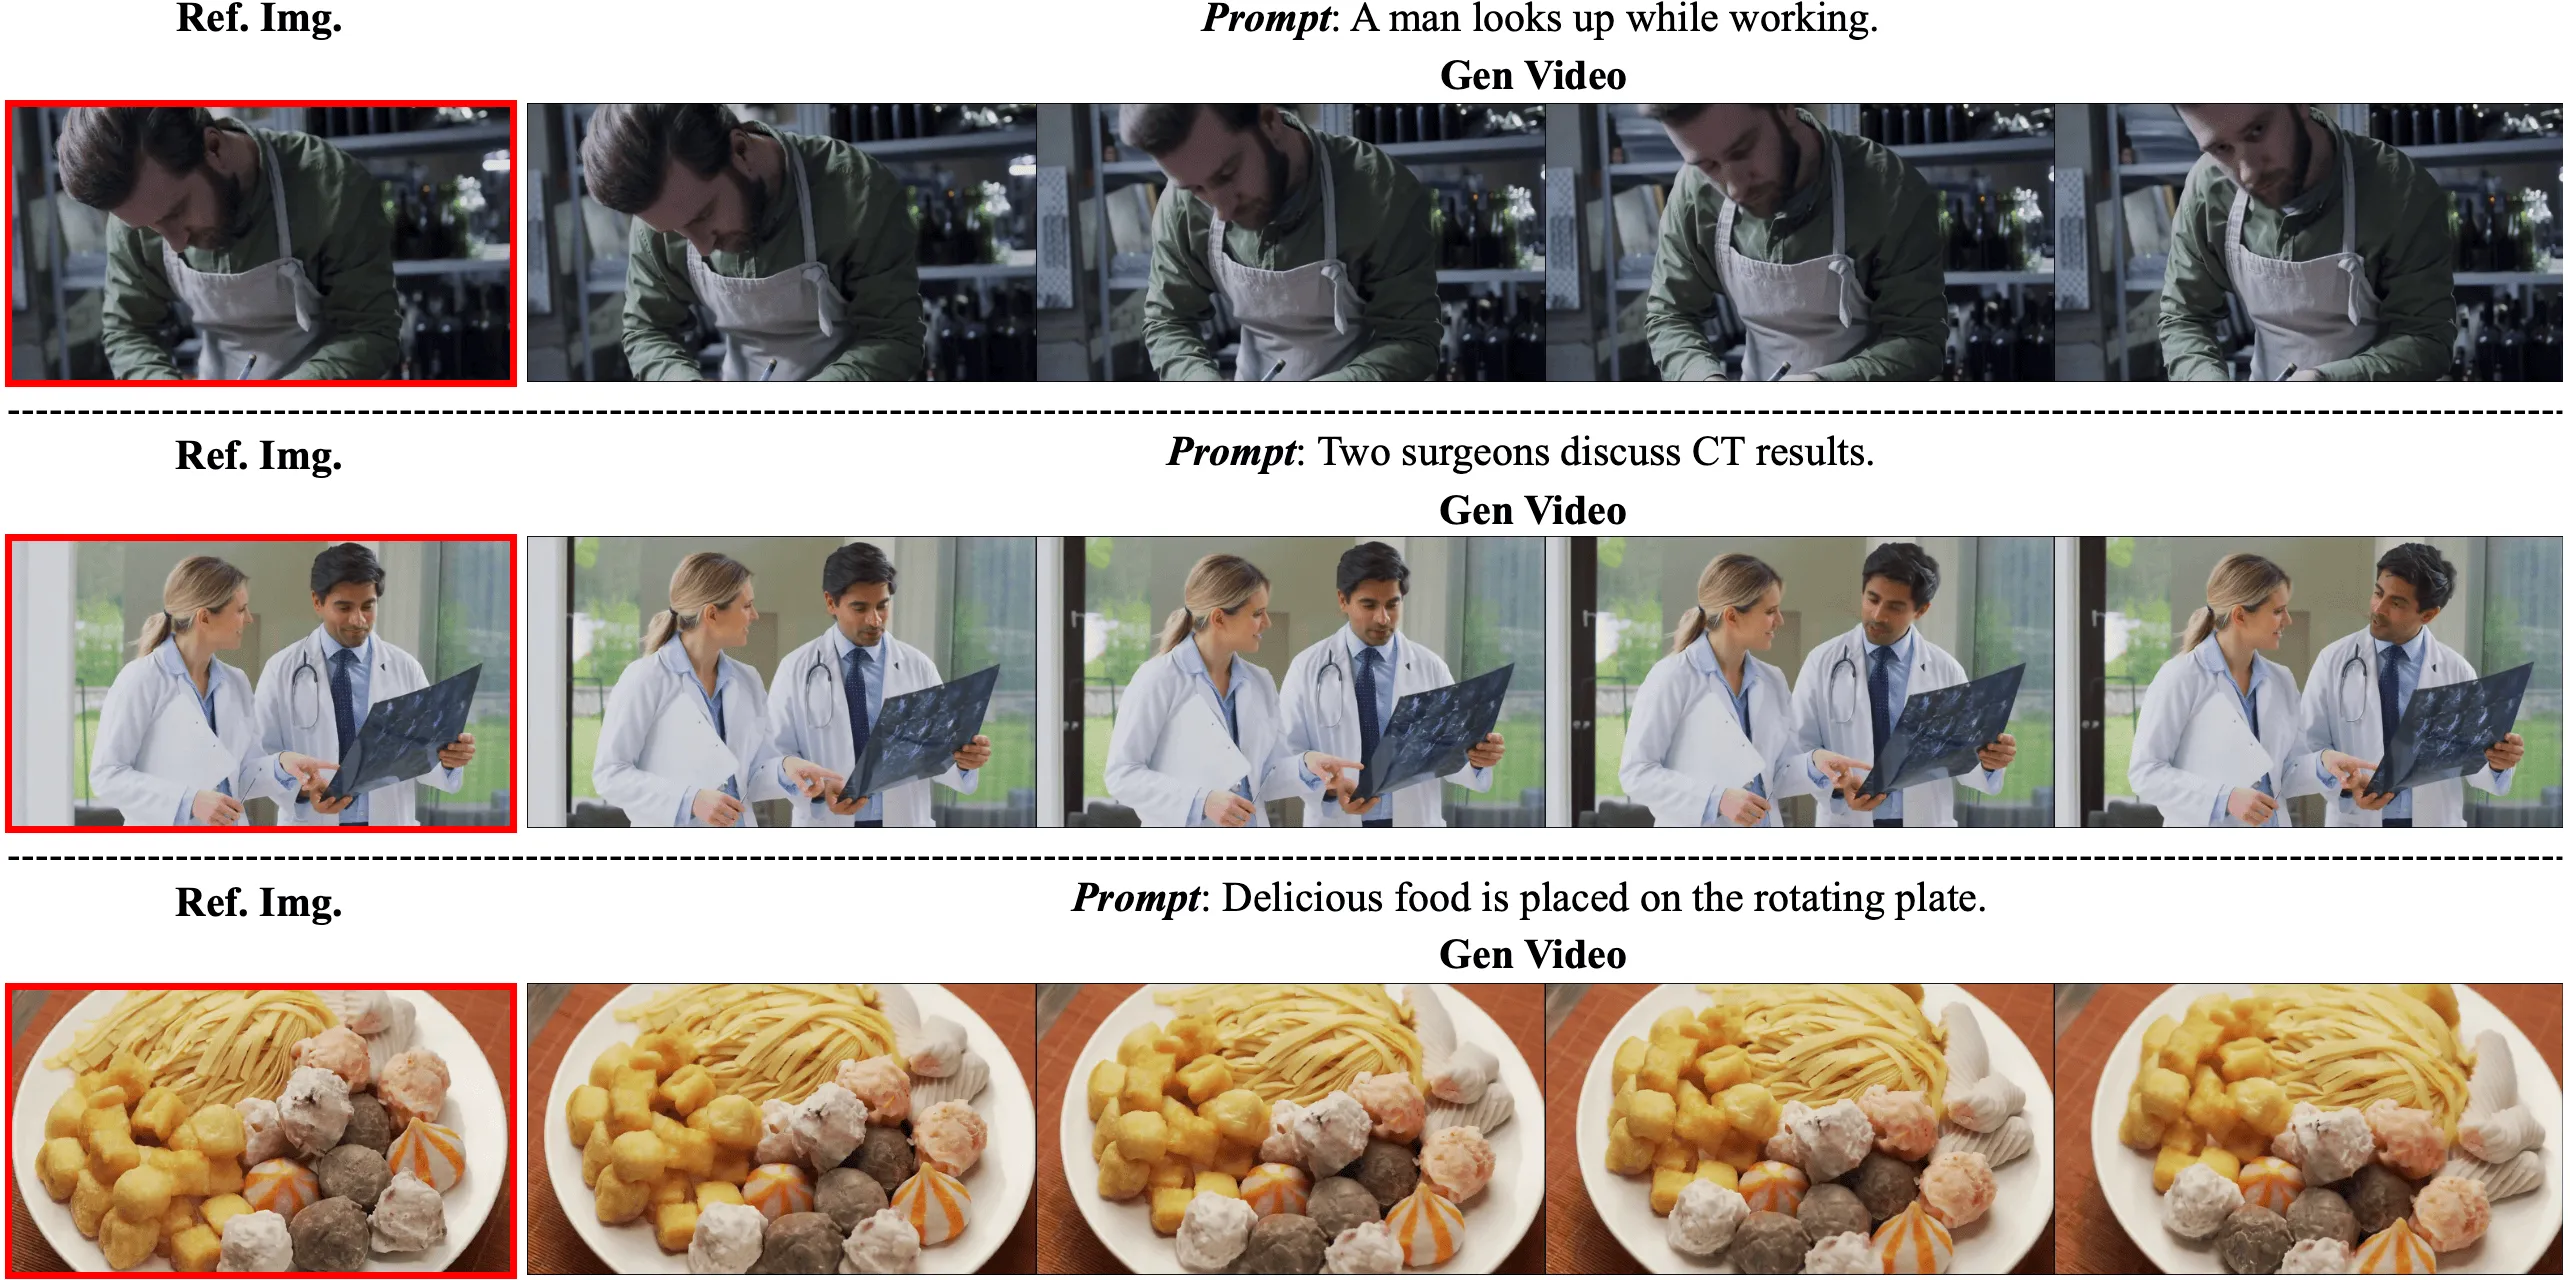
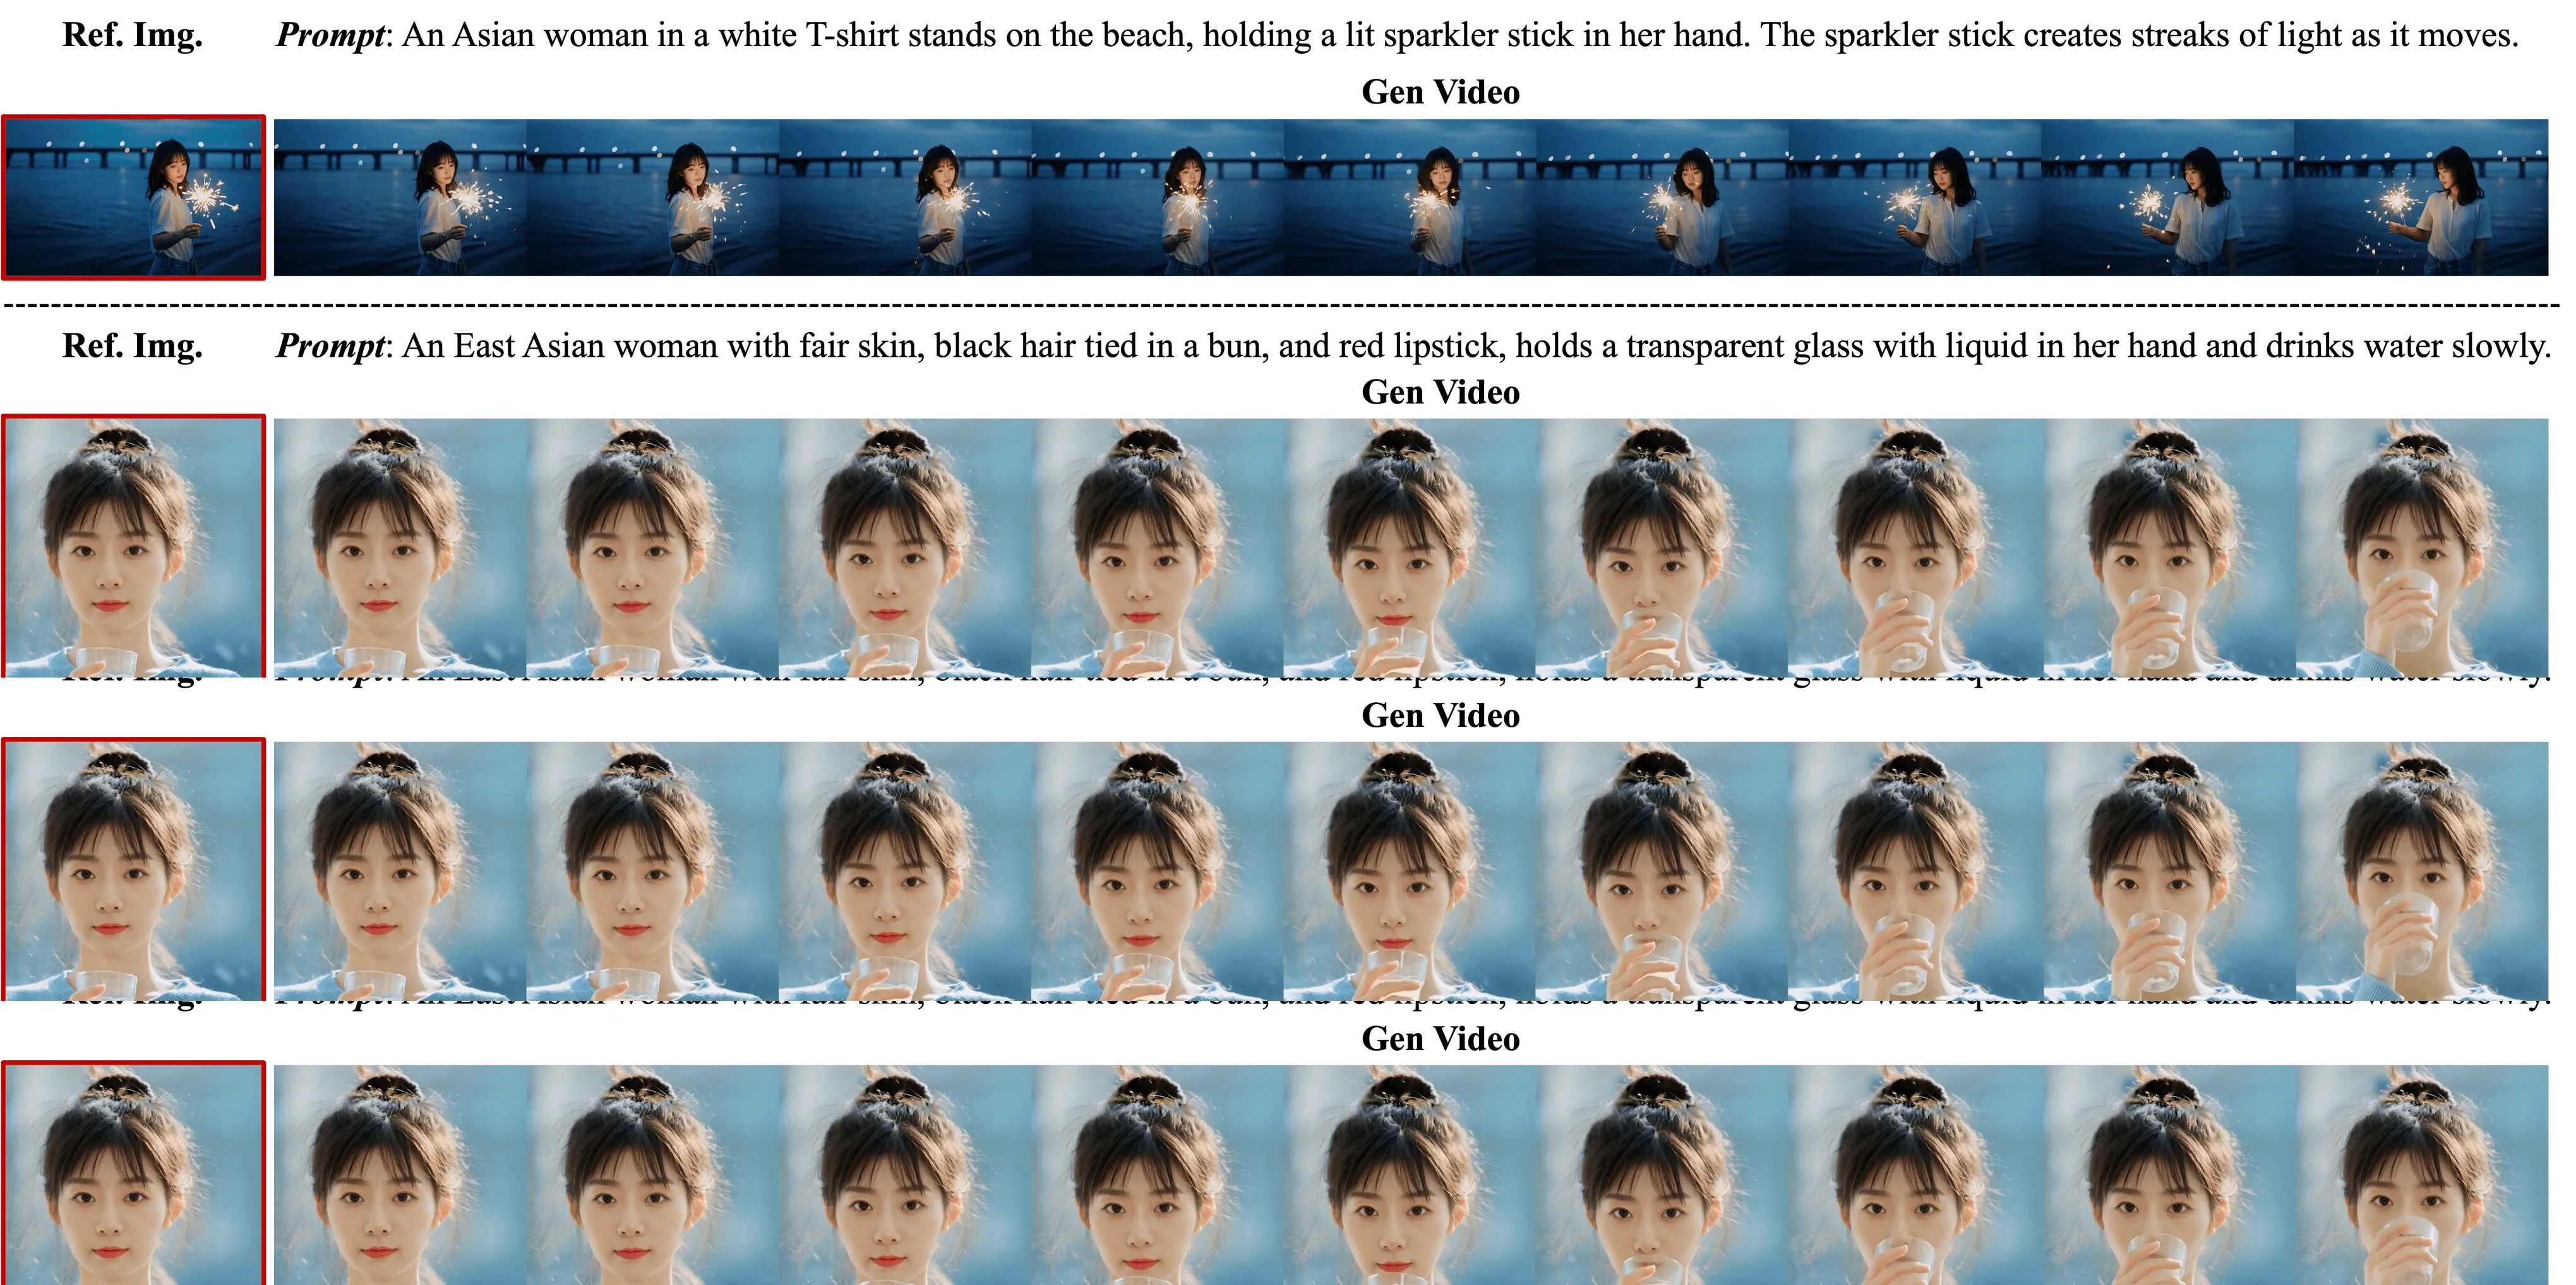
7.3 角色动画 (Avatar Animation)
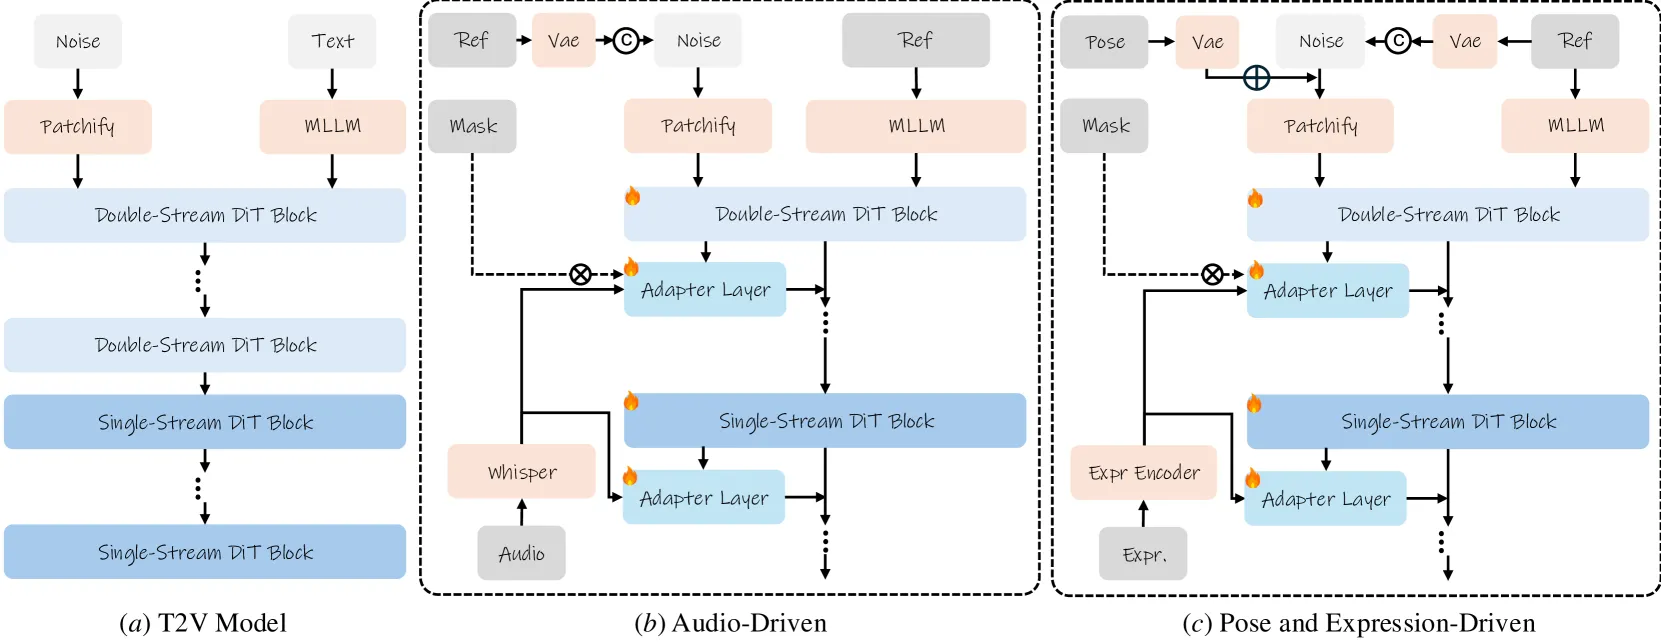
| 驱动方式 | 说明 |
|---|---|
| Audio-Driven | 音频驱动说话人视频生成 |
| Pose-Driven | 姿态驱动角色动画 |
| Expression-Driven | 表情驱动精细面部控制 |
| Hybrid-Driven | 多源混合驱动(音频+姿态+表情) |
注:图1为视频动画(无静态图片),图23-26已重新下载成功。
八、相关工作 (Related Work)
扩散模型
DDPM, DDIM, ADM, Stable Diffusion, FLUX 等奠定了图像生成的基础。HunyuanVideo 将扩散模型扩展到视频生成领域。
视频生成模型
MovieGen (Meta), Runway Gen-3, Luma 1.6, Kling 等闭源模型代表了当前视频生成的最高水平。HunyuanVideo 是首个在专业评估中超越这些模型的开源方案。
开源视频生成
OpenSora, CogVideoX, Cosmos 等开源模型在性能上与闭源模型仍有差距。HunyuanVideo (13B) 是目前最大的开源视频生成模型。
3D VAE
CogVideoX-VAE, FLUX-VAE, Cosmos-VAE 等。HunyuanVideo 的 VAE 在图像和视频重建 PSNR 上均超越这些开源方案。
九、总结 (Conclusion)
9.1 核心贡献
- 最大开源视频基础模型: 130亿参数,性能匹敌甚至超越 Runway Gen-3、Luma 1.6 等闭源模型
- 系统化框架: 从数据清洗、架构设计、缩放训练到基础设施的完整闭环
- Causal 3D VAE: 从 scratch 训练,PSNR 超越所有开源竞品
- 统一图文架构: Full Attention DiT + MLLM 文本编码器,支持图像和视频的统一生成
- 渐进式缩放: 图像预训练 → 联合训练 → 高分微调,减少 5× 计算资源
- 丰富的应用生态: 音频生成、图生视频、角色动画(口型/姿态/表情/混合驱动)
9.2 技术影响
- 弥合了开源和闭源视频生成模型之间的性能差距
- 为社区提供了研究和创新的基础设施
- 展示了系统化框架在视频生成中的重要性
9.3 局限性
- 模型规模大(13B),推理和部署成本较高
- 视频时长和分辨率仍受限于计算资源
- 结构化标注依赖内部 VLM,泛化性有待验证
- 相机运动控制依赖高置信度预测,可能存在误差传播
十、参考资源 (References)
论文链接
关键参考文献
| 编号 | 论文/模型 | 关键贡献 |
|---|---|---|
| [47] | FLUX | 开源图像生成模型 |
| [67] | MovieGen | Meta 视频生成模型 |
| [93] | CogVideoX-1.5 | 开源视频生成模型 |
| [102] | OpenSora-1.2 | 开源视频生成模型 |
| [64] | Cosmos-VAE | 视频 VAE |
| [52] | Flow Matching | 流匹配训练方法 |
| [20] | PagedAttention/vLLM | 块级 KV 缓存管理 |
| [39] | GDPR | 通用数据保护条例 |
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | 生成样本展示(视频动画) | 无静态图片,为视频动画 |
| Figure 2 | 性能对比(开源vs闭源) | figure-2-performance-comparison.png |
| Figure 3 | 训练系统总览 | figure-3-training-system.png |
| Figure 4 | 分层数据过滤管道 | figure-4-data-filtering-pipeline.png |
| Figure 5 | 模型架构总览 | figure-5-model-overview.png |
| Figure 6 | 3D VAE 架构 | figure-6-3dvae-architecture.png |
| Figure 7 | VAE 重建对比 | figure-7-vae-reconstruction.png |
| Figure 8 | 扩散骨干网络 | figure-8-diffusion-backbone.png |
| Figure 9 | 文本编码器对比 | figure-9-text-encoder-comparison.png |
| Figure 10 | 缩放定律(DiT-T2X模型族) | figure-10-scaling-laws.png |
| Figure 11 | 模型加速 | figure-11-model-acceleration.png |
| Figure 12 | 文本对齐生成 | figure-12-text-alignment.png |
| Figure 13 | 高质量样本 | figure-13-high-quality-samples.png |
| Figure 14 | 高运动样本 | figure-14-high-motion-samples.png |
| Figure 15 | 概念泛化 | figure-15-concept-generalization.png |
| Figure 16 | 概念QA | figure-16-concept-qa.png |
| Figure 17 | OCR生成 | figure-17-ocr-generation.png |
| Figure 18 | 音频生成架构 | figure-18-audio-generation.png |
| Figure 19 | I2V 模型对比 | figure-19-i2v-models.png |
| Figure 20 | I2V 预训练结果 | figure-20-i2v-pretraining.png |
| Figure 21 | 人像 I2V | figure-21-portrait-i2v.png |
| Figure 22 | 角色动画概览 | figure-22-avatar-animation.png |
| Figure 23 | 表情驱动 | figure-23-expression-driven.png |
| Figure 24 | 视频编辑 | figure-24-video-editing.png |
| Figure 25 | 多语言支持 | figure-25-multilingual.png |
| Figure 26 | 角色动画 | figure-26-character-animation.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer