TeaCache: Timestep Embedding Aware Cache for Video Diffusion Model
基于时间步嵌入感知的缓存策略加速视频扩散模型推理
TeaCache: Timestep Embedding Aware Cache for Video Diffusion Model
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Timestep Embedding Tells: It’s Time to Cache for Video Diffusion Model |
| 作者 | Feng Liu, Shiwei Zhang, Xiaofeng Wang, Yujie Wei, Haonan Qiu, Yuzhong Zhao, Yingya Zhang, Qixiang Ye, Fang Wan |
| 机构 | UCAS, Alibaba Group, Fudan University, NTU |
| 论文 | arXiv:2411.19108 |
| 代码 | Project Page |
| 发布 | 2024年11月28日 |
| 许可 | arXiv 非独占分发许可 |
二、核心思想
问题定义
视频扩散模型 (DiT) 因去噪过程的顺序性导致推理速度慢。现有缓存方法在均匀选择的时间步缓存模型输出,忽略了模型输出差异在不同时间步的非均匀性,导致推理效率和视觉质量之间难以平衡。
解决方案概述
TeaCache (Timestep Embedding Aware Cache) 是一种无需训练的缓存策略:
- 核心观察: 模型输入与输出之间存在强相关性,且输入计算成本极低
- 时间步嵌入调制: 使用时间步嵌入调制的噪声输入来近似模型输出差异
- 多项式拟合重缩放: 通过多项式拟合修正输入差异与输出差异之间的缩放偏差
- 选择性缓存: 基于累积相对 L1 距离决定是否缓存
核心性能
| 指标 | 数值 |
|---|---|
| 最大加速比 | 4.41× (Open-Sora-Plan) |
| 质量损失 | -0.07% VBench 分数 |
| 训练需求 | 无需训练 |
| 兼容性 | Open-Sora, Latte, OpenSora-Plan |
三、技术架构
整体框架图
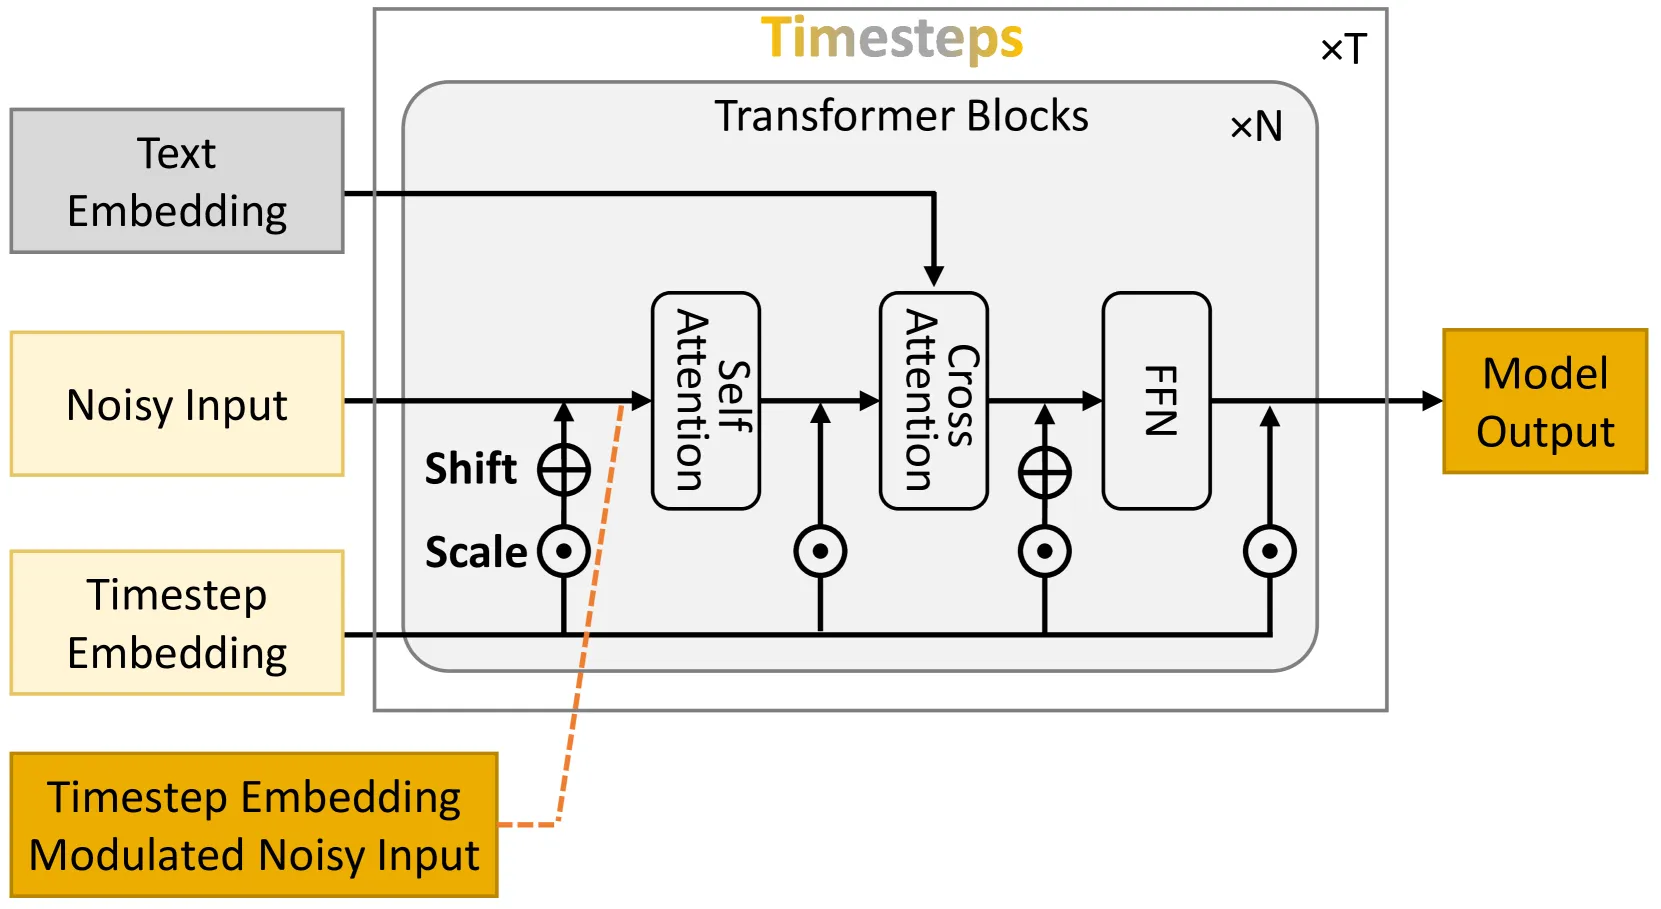
Figure 2: TeaCache 与传统均匀缓存策略对比。TeaCache 能够选择性缓存信息量大的中间模型输出,在保持性能的同时加速 DiT 模型。
核心公式
扩散模型前向过程
扩散模型反向过程
时间步嵌入
相对 L1 距离 (输出差异度量)
大值表示 相对于 信息量大,应缓存;小值表示两者相似,可复用。
朴素缓存策略
多项式拟合重缩放
其中 是估计的模型输出差异, 是时间步嵌入调制噪声输入的差异。
最终缓存指标
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 时间步嵌入 | 正弦嵌入 + MLP | 标量 → 向量 |
| 调制层 | 时间步嵌入调制噪声输入 | 控制输入输出幅度 |
| 差异估计器 | 相对 L1 距离计算 | 标量差异 |
| 多项式拟合 | numpy poly1d | 4 阶多项式 |
| 缓存决策器 | 累积阈值比较 | 阈值 |
缓存流程
- 校准阶段: 在第一个样本上计算输入差异和输出差异,拟合多项式
- 推理阶段: 计算时间步嵌入调制噪声输入的相对 L1 距离
- 重缩放: 使用拟合的多项式修正差异估计
- 决策: 累积差异超过阈值时计算新输出,否则复用缓存
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 时间步嵌入感知缓存 | 利用时间步嵌入调制的噪声输入估计输出差异 | 输入输出相关性分析 (Fig. 3) |
| 多项式拟合重缩放 | 修正输入差异与输出差异的缩放偏差 | 4 阶多项式拟合效果最佳 (Table 3) |
| 选择性缓存 | 非均匀策略,信息量大时计算,小时复用 | 优于均匀缓存 (Table 1) |
| 无需训练 | 完全兼容 DiT 扩散模型 | 校准阶段开销可忽略 |
五、实验结果
质量-延迟对比
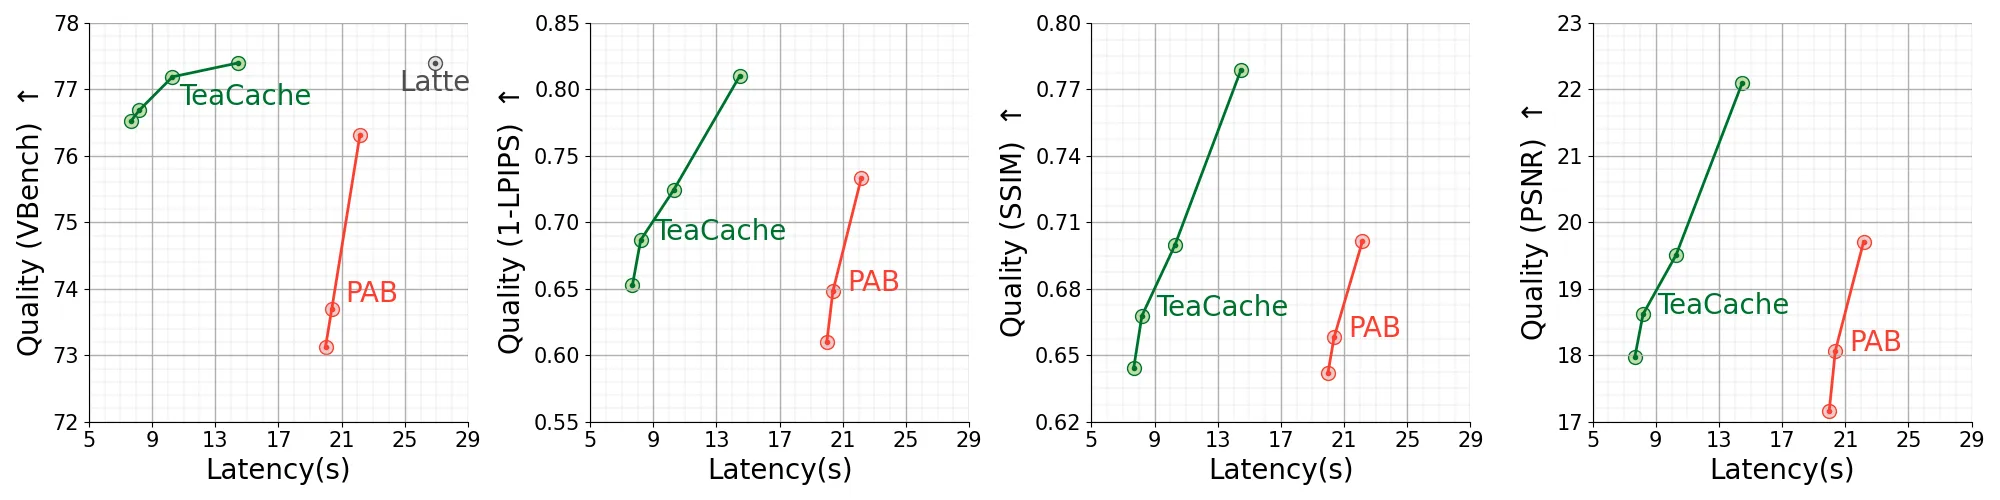
Figure 1: 视频扩散模型质量-延迟对比。TeaCache 在视觉质量和效率上显著优于 PAB。
主要结果 (Latte, 16帧, 512×512)
| 方法 | FLOPs (P) ↓ | 加速比 ↑ | 延迟 (s) ↓ | VBench ↑ |
|---|---|---|---|---|
| Latte (T=50) | 3.36 | 1× | 26.90 | 77.40% |
| Δ-DiT | 3.36 | 1.02× | - | 52.00% |
| T-GATE | 2.99 | 1.13× | - | 75.42% |
| PAB-slow | 2.70 | 1.21× | 22.16 | 76.32% |
| PAB-fast | 2.52 | 1.34× | 19.98 | 73.13% |
| TeaCache-slow | 1.86 | 1.86× | 14.46 | 77.40% |
| TeaCache-fast | 1.52 | 2.21× | 12.16 | 77.22% |
输入输出相关性分析
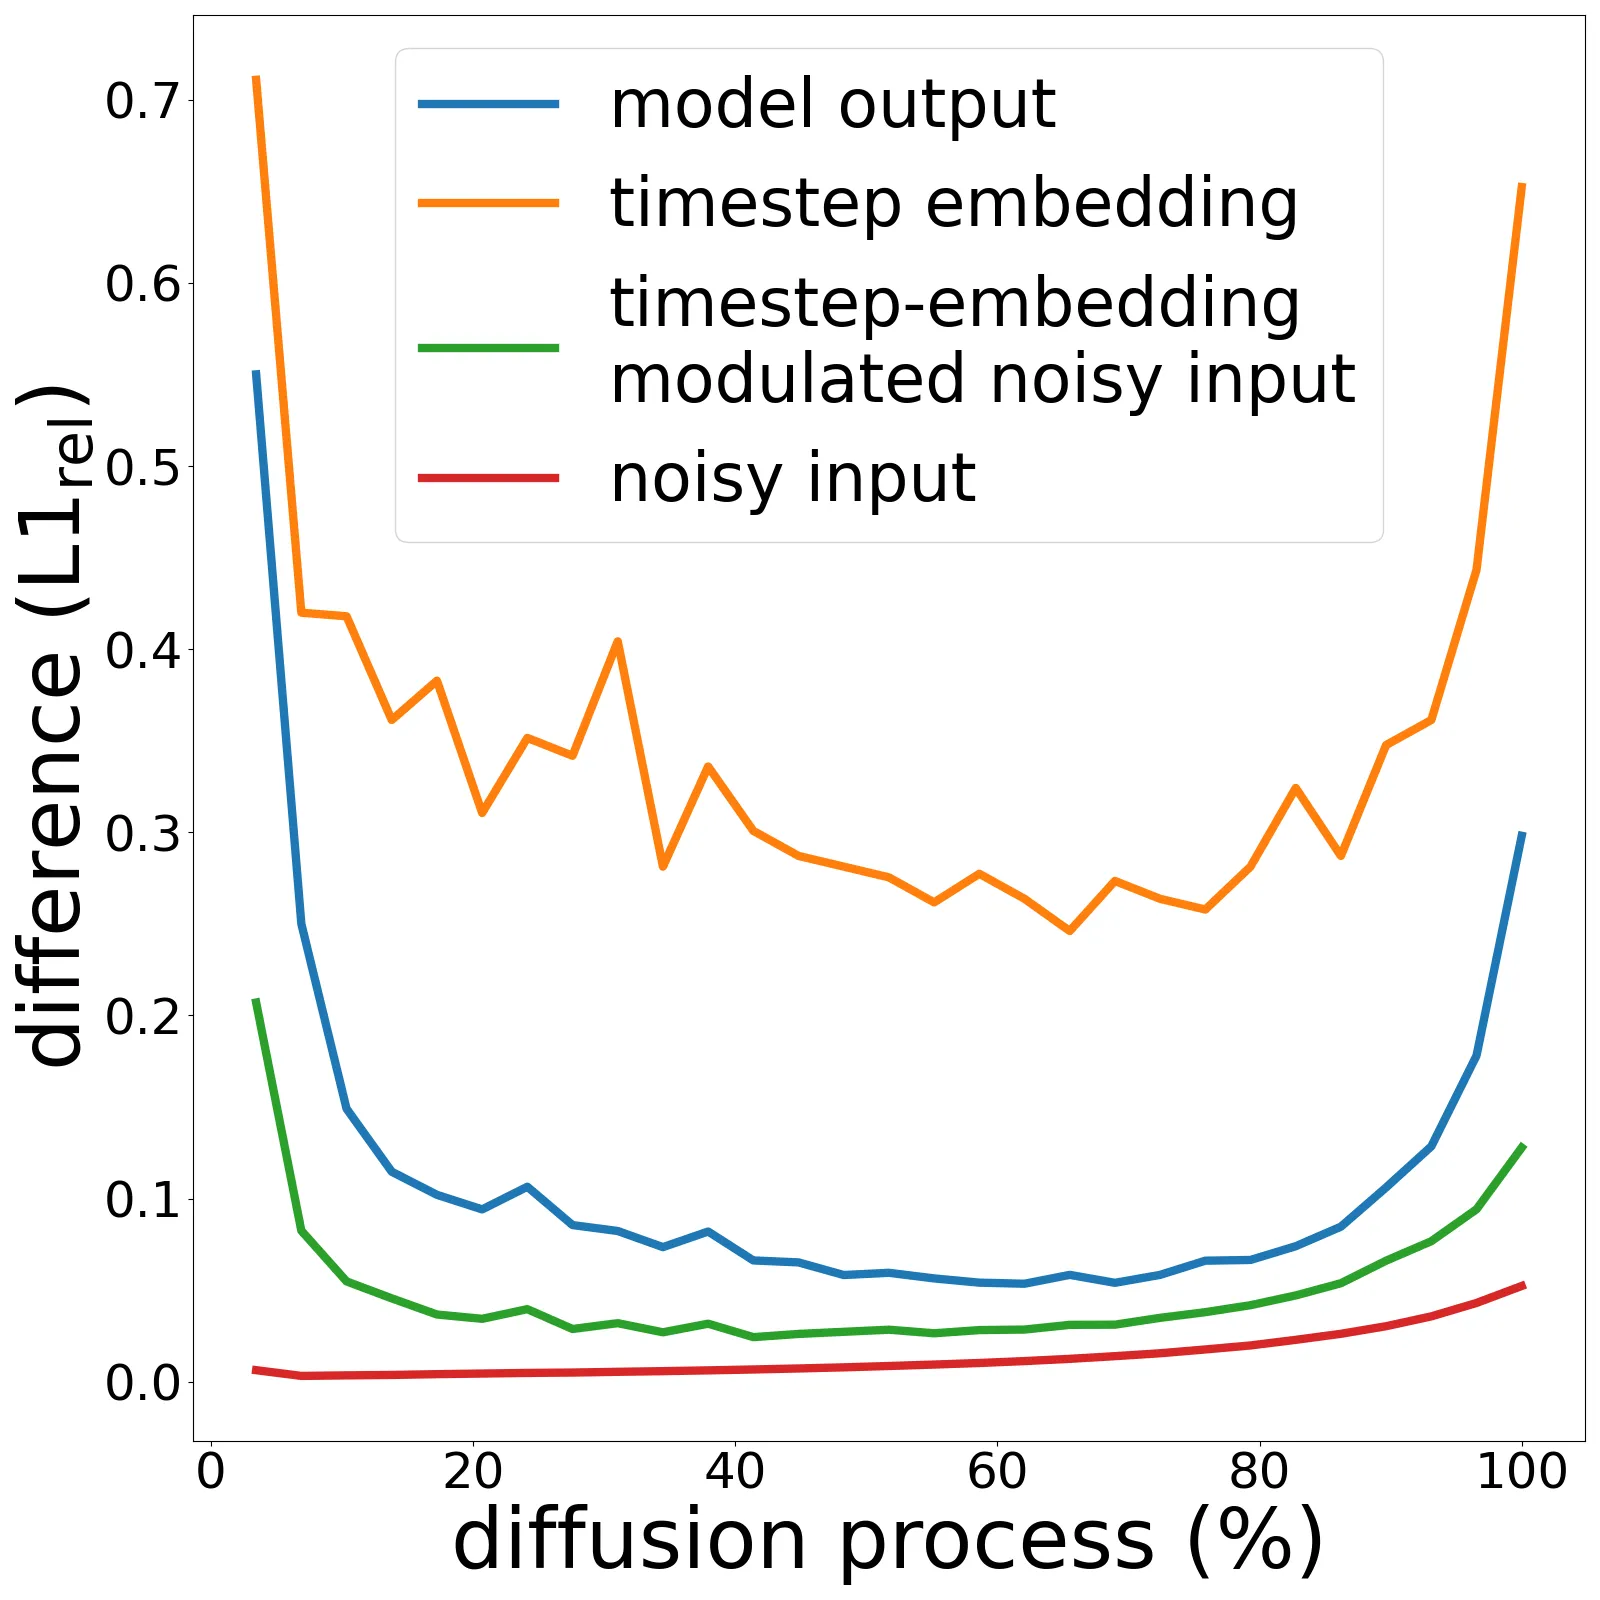
Figure 3: Open Sora、Latte 和 OpenSora-Plan 的连续时间步输入差异和输出差异可视化。时间步嵌入和时间步嵌入调制噪声输入与模型输出有强相关性。
多项式拟合效果
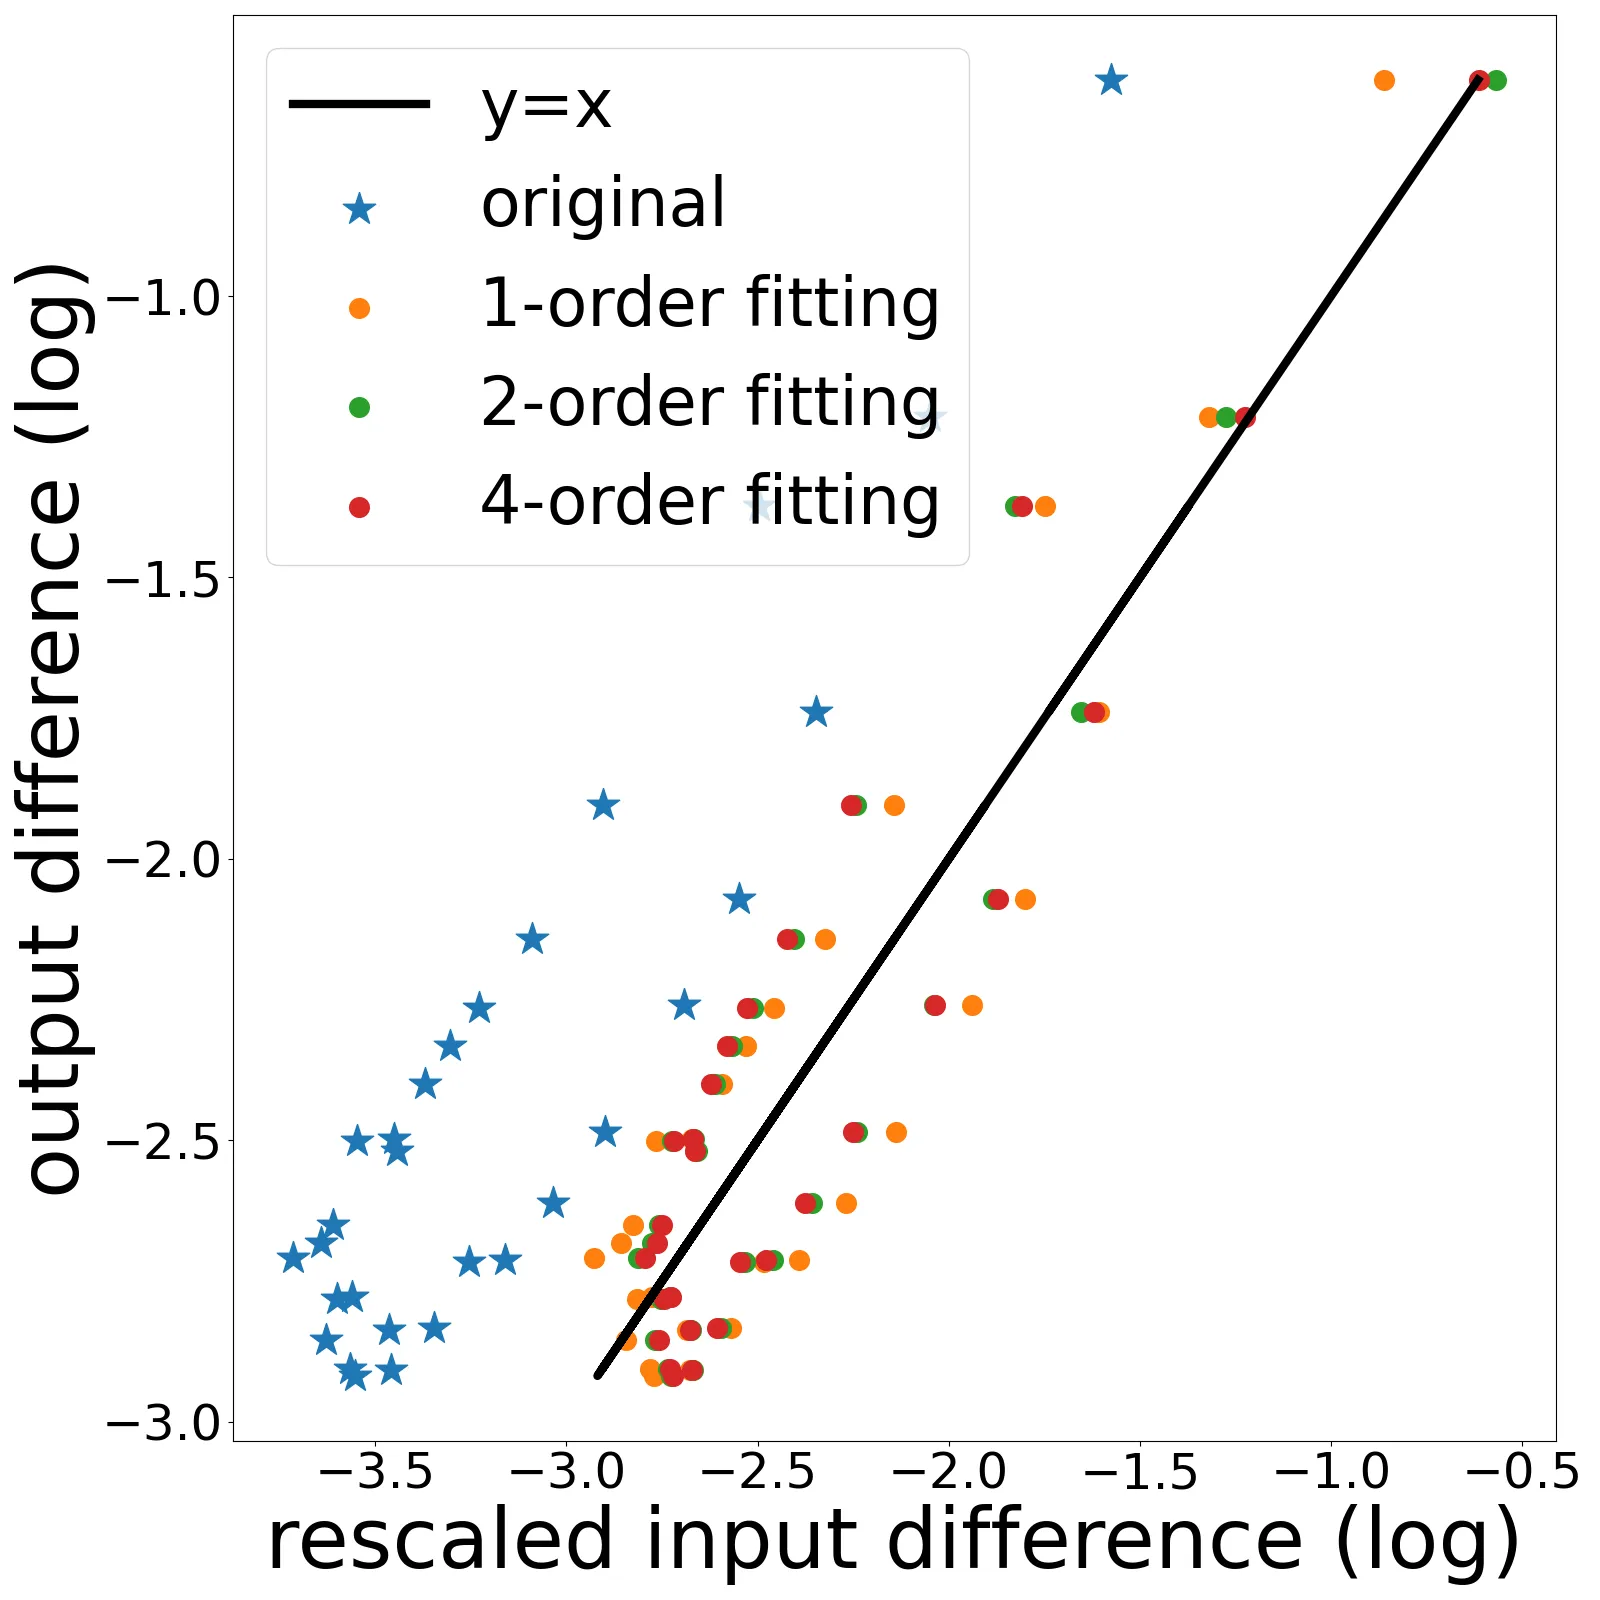
Figure 5: 输入差异与输出差异的相关性可视化。原始数据点偏离线性相关,多项式拟合减少偏差。
不同模型加速效果
| 模型 | 原始延迟 | TeaCache 延迟 | 加速比 | VBench 变化 |
|---|---|---|---|---|
| Open-Sora | - | - | 2.50× | -0.78% |
| Latte | 26.90s | 12.16s | 2.21× | -0.18% |
| Open-Sora-Plan | - | - | 4.41× | -0.07% |
缓存 vs 减少时间步
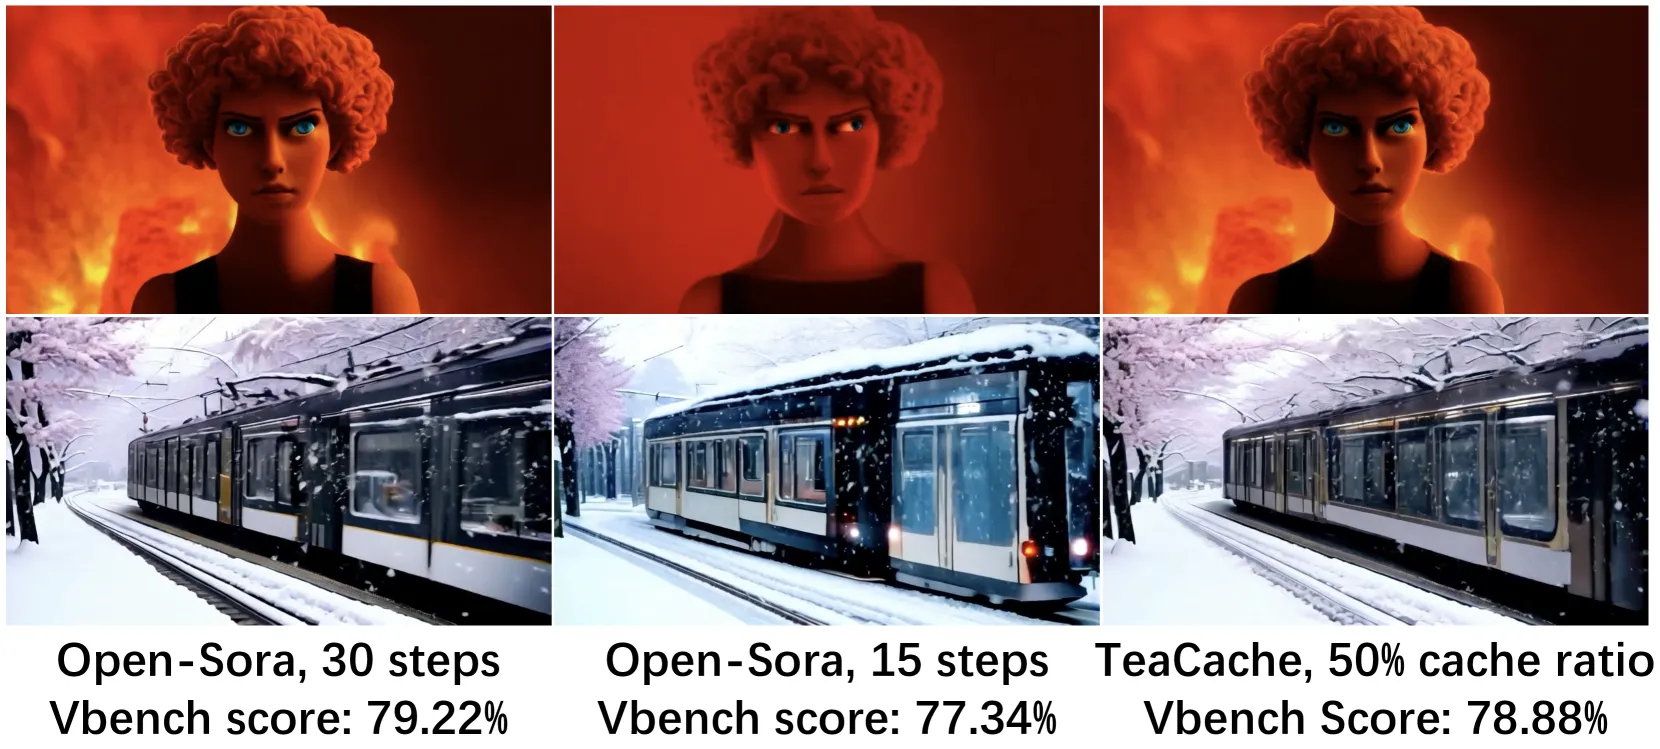
Figure 6: 缓存机制 vs 减少时间步。减少推理时间步会导致视觉质量下降,而 TeaCache 保持视觉质量。
不同分辨率和视频长度
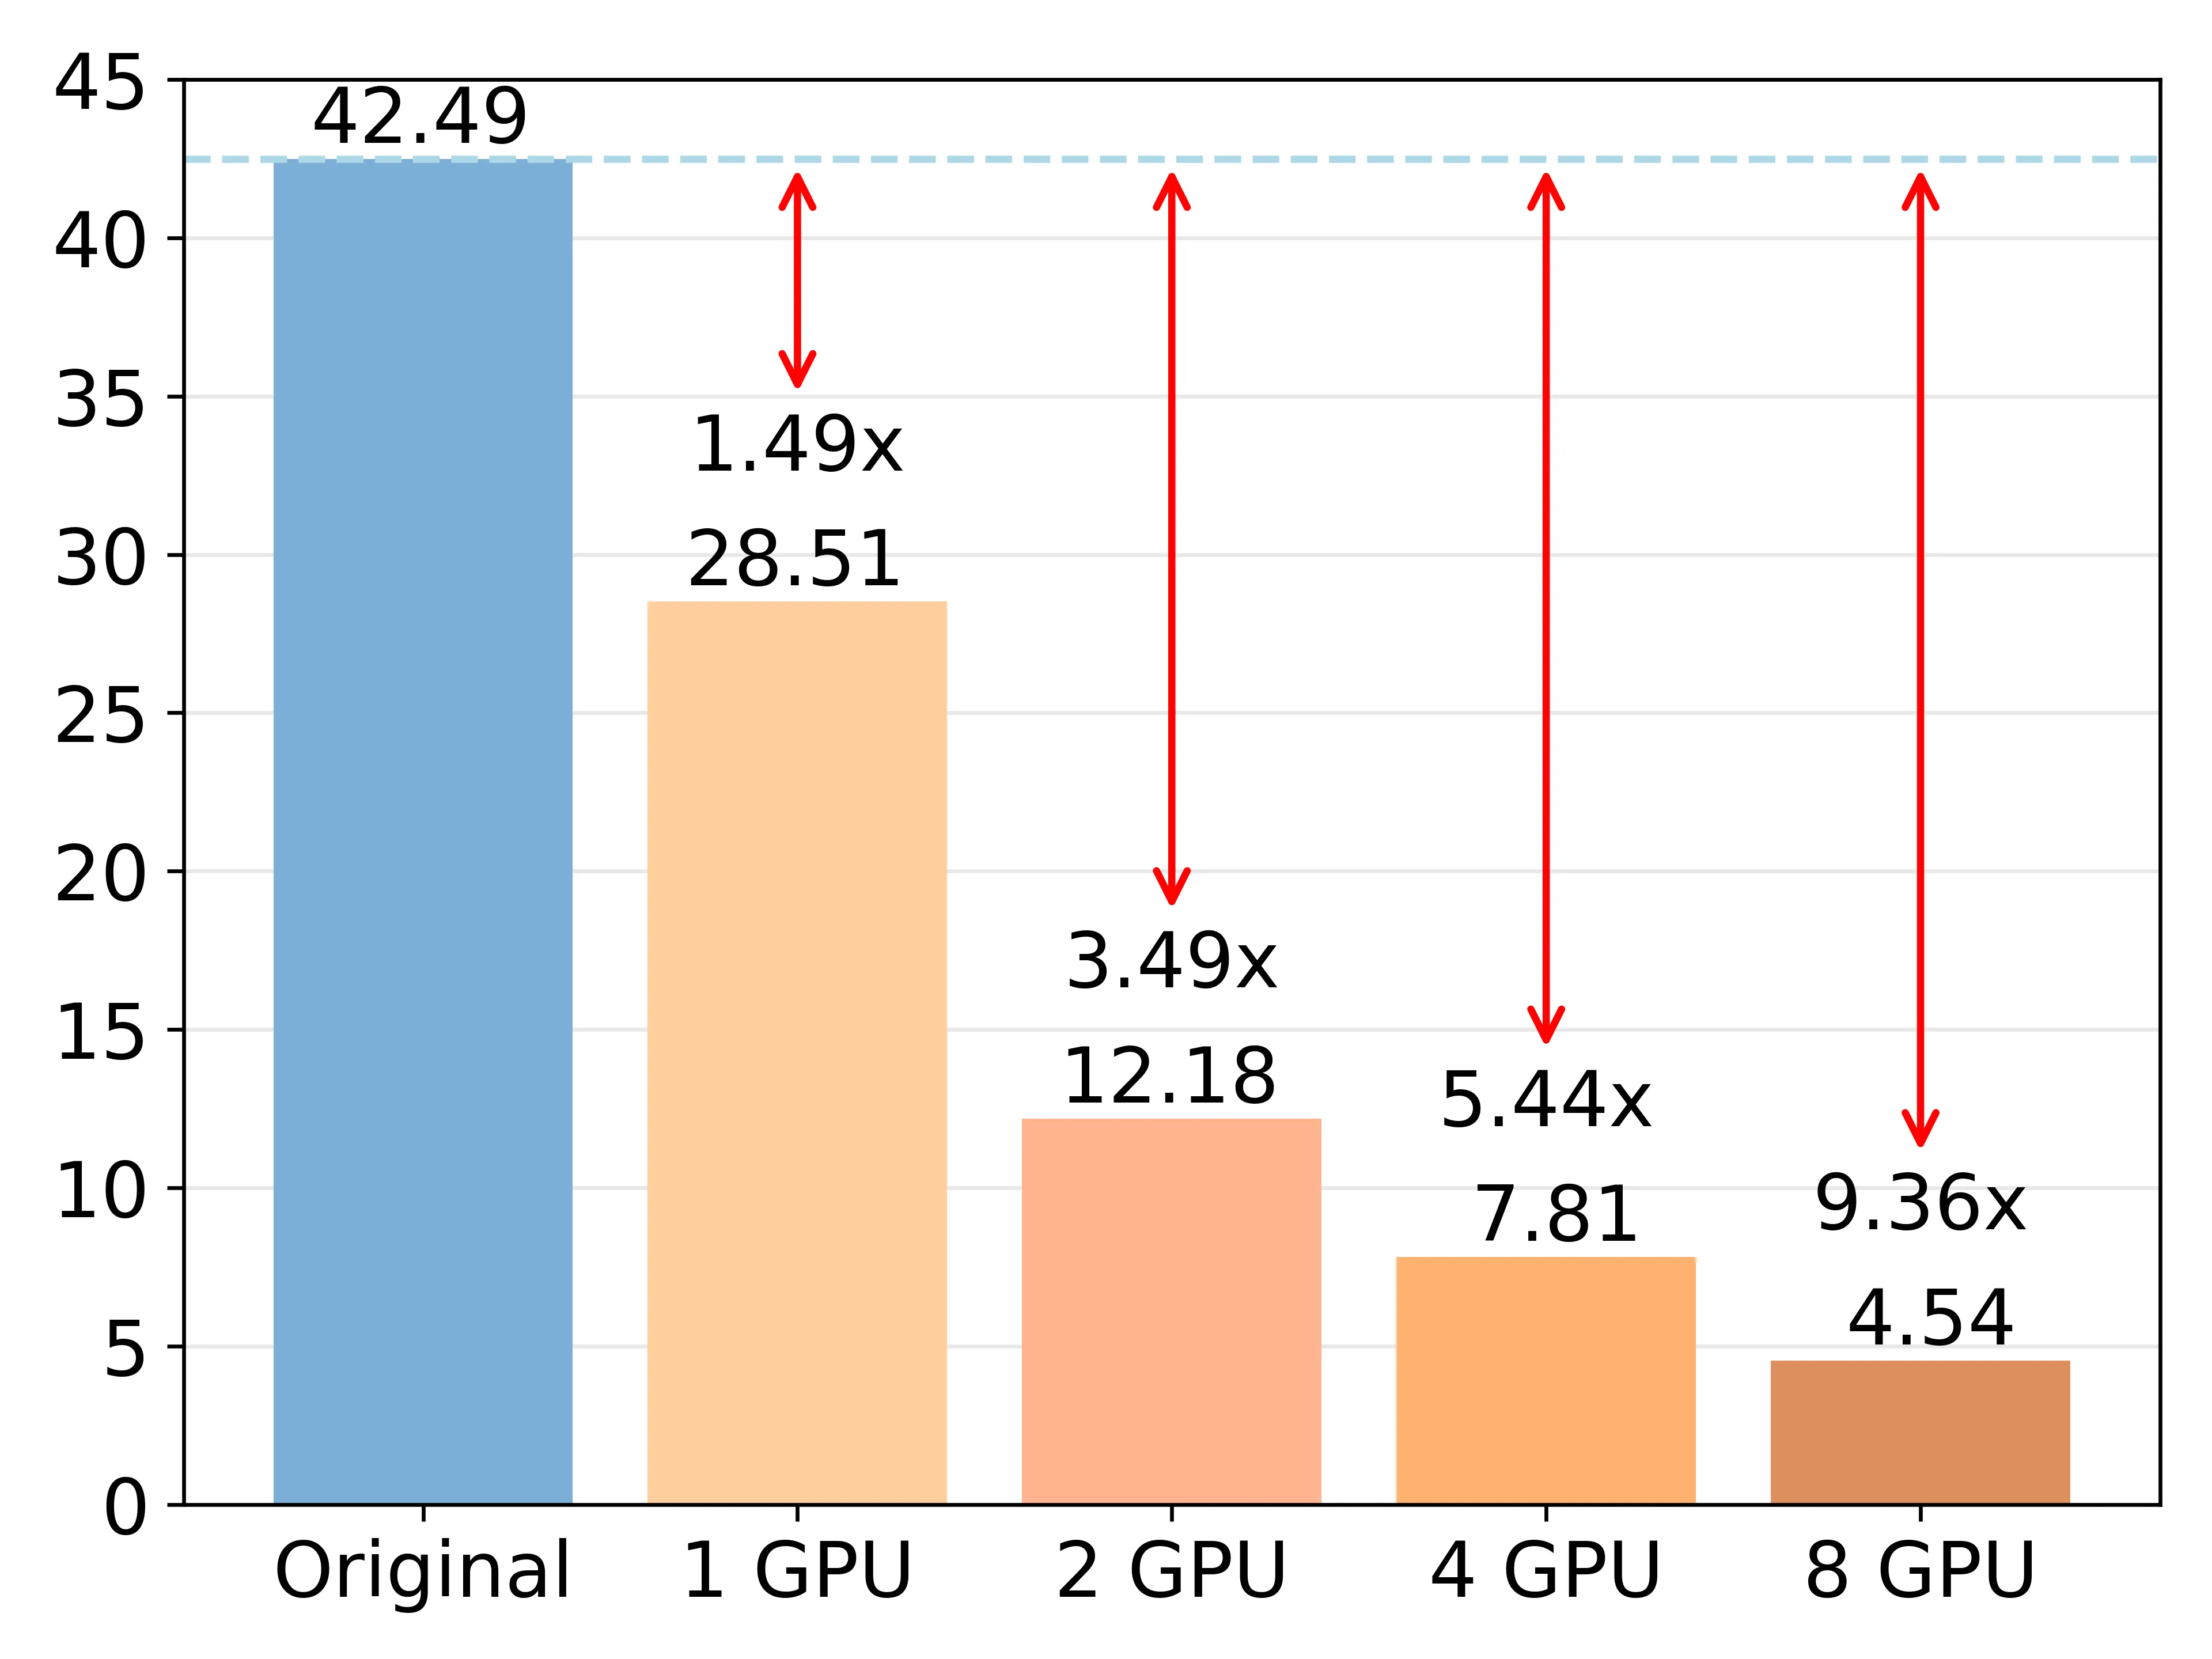
Figure 8: TeaCache 在不同视频长度和分辨率下的推理效率。
消融实验
缓存指标消融 (Table 2)
| 指标 | VBench ↑ | LPIPS ↓ | SSIM ↑ | PSNR ↑ |
|---|---|---|---|---|
| Timestep embedding | 76.30% | 0.1904 | 0.7218 | 19.44 |
| Timestep embedding modulated input | 77.22% | 0.1831 | 0.7248 | 19.49 |
多项式拟合消融 (Table 3)
| 阶数 | VBench ↑ | LPIPS ↓ | SSIM ↑ | PSNR ↑ |
|---|---|---|---|---|
| 无拟合 | 76.50% | 0.1879 | 0.7196 | 19.45 |
| 1 阶 | 76.80% | 0.1852 | 0.7221 | 19.47 |
| 2 阶 | 77.06% | 0.1841 | 0.7235 | 19.48 |
| 3 阶 | 77.18% | 0.1835 | 0.7244 | 19.49 |
| 4 阶 | 77.22% | 0.1831 | 0.7248 | 19.49 |
多 GPU 扩展 (Table 4)
| 设置 | 加速比 | VBench ↑ |
|---|---|---|
| 单 GPU | 2.21× | 77.22% |
| 2 GPU (DSP) | 3.84× | 77.21% |
| 4 GPU (DSP) | 6.49× | 77.18% |
六、与现有方法对比
| 方面 | 均匀缓存 (DeepCache) | PAB | FasterCache | TeaCache |
|---|---|---|---|---|
| 缓存策略 | 均匀间隔 | 按注意力块特性 | CFG 冗余优化 | 时间步嵌入感知 |
| 训练需求 | 无需训练 | 无需训练 | 无需训练 | 无需训练 |
| 自适应性 | 无 | 部分 | 部分 | 完全自适应 |
| 最大加速 | ~2× | 1.34× | ~2× | 4.41× |
| 质量损失 | 中等 | 较大 | 较小 | 极小 |
| 兼容性 | UNet | DiT | DiT | DiT |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| DeepCache | UNet 缓存启发,TeaCache 扩展到 DiT |
| PAB | DiT 缓存基线,TeaCache 显著优于 |
| Δ-DiT | DiT 缓存基线,质量损失大 |
| FasterCache | CFG 冗余优化,互补方法 |
| AdaCache | 自适应缓存,但需要内容复杂度评估 |
| DiT (Peebles & Xie) | 基础架构,TeaCache 完全兼容 |
八、总结
核心贡献
- TeaCache: 首个基于时间步嵌入感知的训练无关缓存策略
- 两阶段估计: 粗估计 (时间步嵌入调制) + 精炼 (多项式拟合)
- 4.41× 加速: 在 Open-Sora-Plan 上实现 4.41× 加速,质量损失仅 -0.07%
- 广泛兼容: 适用于 Open-Sora、Latte、OpenSora-Plan 等多种 DiT 模型
技术影响
- 视频生成加速: 为 DiT 视频扩散模型提供高效推理方案
- 无需训练: 零额外训练成本,即插即用
- 自适应缓存: 根据时间步动态调整缓存策略
- 多 GPU 扩展: 与 DSP 结合实现 6.49× 加速
局限性
- 需要校准阶段 (第一个样本)
- 多项式拟合阶数需要手动选择
- 仅在视频生成任务上验证
- 未与蒸馏方法结合
九、参考资源
- 论文: arXiv:2411.19108
- 项目: TeaCache Project Page
- 主题: cs.CV
- 页数: 约 15 页
十、关键公式速查
| 公式 | 说明 |
|---|---|
| 时间步嵌入 | |
| 相对 L1 距离 | |
| 多项式拟合 | |
| 缓存决策 |
十一、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 质量-延迟对比 | latency.png |
| Figure 2 | TeaCache vs 均匀缓存框架 | x2.png |
| Figure 3 | 输入输出差异可视化 | opensora-diff.png, latte-diff.png, opensora-plan-diff.png |
| Figure 4 | DiT 扩散模块结构 | x1.png |
| Figure 5 | 多项式拟合效果 | opensora-fit.png, latte-fit.png, opensora-plan-fit.png |
| Figure 6 | 缓存 vs 减少时间步 | x3.png |
| Figure 7 | 定性对比 | x4.png |
| Figure 8 | 不同分辨率效率 | 480p-48f.png, 480p-192f.png, 360p-240f.png, 720p-48f.png |