Efficient Track Anything
高效视频目标分割与跟踪模型
Efficient Track Anything
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Efficient Track Anything |
| 作者 | Yangming Cheng, Liulei Li, Yuanyou Xu, Xiaodi Li, Zongxin Yang, Wenguan Wang, Yi Yang |
| 机构 | Zhejiang University, ETH Zürich |
| 论文 | arXiv:2411.18933 |
| 代码 | 未公开 |
| 发布 | 2024年11月28日 |
| 主题 | cs.CV |
二、核心思想
问题定义
Segment Anything Model 2 (SAM 2) 在视频目标分割和跟踪方面表现出色,但存在严重的效率问题:
- 大型多阶段图像编码器 (HieraB+ ~80M 参数) 计算复杂度高
- 记忆模块 的记忆 token 过长 (~30K),导致交叉注意力计算昂贵
- 移动部署困难: SAM 2 tiny 版本与 base 版本速度相当 (47.2 vs 43.8 FPS)
解决方案概述
EfficientTAM 是一个轻量级的视频目标分割和跟踪模型:
- 使用 plain ViT 替代 hierarchical encoder: ViT-Tiny/Small 作为图像编码器
- 高效记忆交叉注意力: 利用记忆空间 token 的局部性进行粗粒度表示
- 在 SA-1B 和 SA-V 数据集上训练: 统一图像和视频分割
核心性能
| 指标 | 数值 |
|---|---|
| 速度提升 | A100 上 ~2x 速度提升(相比 SAM 2) |
| 参数减少 | ~2.4x 参数减少 |
| 精度 | SA-V test: 74.5% vs SAM 2 的 74.7% |
| 移动部署 | iPhone 15 Pro Max 上 ~10 FPS |
| 图像分割 | SA-23: 60.7% vs SAM 的 59.1% |
三、技术架构
整体框架图
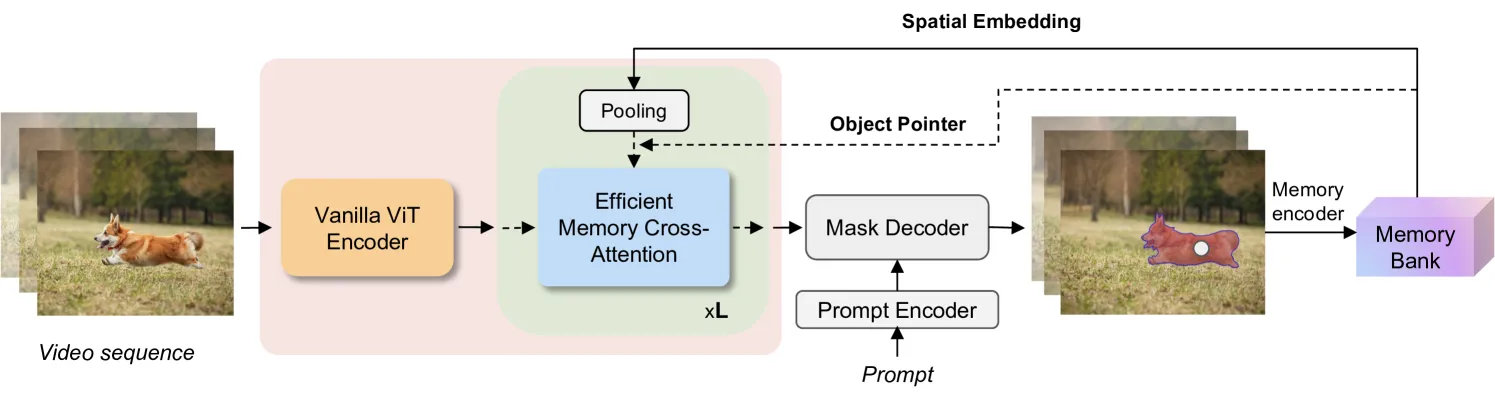
Figure 2: EfficientTAM 架构。使用 vanilla lightweight ViT 图像编码器进行帧特征提取,提出高效记忆交叉注意力。
核心设计
1. 高效图像编码器
问题: SAM 2 的 HieraB+ 编码器参数量大 (~80M),层次化设计导致效率低下。
解决方案: 使用 plain, non-hierarchical ViT (ViT-Tiny/Small):
- ViT-Tiny: ~18M 参数
- ViT-Small: ~34M 参数
- 相比 HieraB+ 减少 ~2.4x 参数
2. 高效记忆交叉注意力
问题: SAM 2 的记忆 token 过长 (~30K),交叉注意力计算昂贵。
关键观察: 记忆空间 token 具有强局部性,粗粒度表示可以作为好的代理。
解决方案: 利用记忆空间 token 的局部性进行池化:
将记忆 token 从 ~30K 减少到 ~7.5K,显著降低计算复杂度。
3. 记忆 Token 结构
记忆 token 包含两部分:
- 空间嵌入 token (): 来自记忆编码器的空间特征
- 对象指针 token (): 来自掩码解码器的对象级特征
交叉注意力机制
标准交叉注意力:
高效交叉注意力:仅对空间 token 进行池化,保留对象指针 token。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Plain ViT 编码器 | 使用非层次化 ViT 替代 Hiera | ~2x 速度提升,~2.4x 参数减少 |
| 高效记忆注意力 | 利用空间 token 局部性进行池化 | 2×2 窗口池化,~1% 精度损失 |
| 对象指针保留 | 池化仅作用于空间 token | 2.3% 精度提升(相比全部池化) |
| 移动部署 | 支持 iPhone 15 Pro Max | ~10 FPS 视频分割 |
五、实验结果
实验设置
| 项目 | 配置 |
|---|---|
| 预训练 | SA-1B (11M 图像, 1.1B 掩码), 90K steps |
| 全训练 | SA-V (51K 视频) + 10% SA-1B, 300K steps |
| 硬件 | 256× A100-80G GPU |
| 输入分辨率 | 1024×1024 |
| 优化器 | AdamW (β1=0.9, β2=0.999) |
| 批量大小 | 256 |
半监督视频目标分割结果
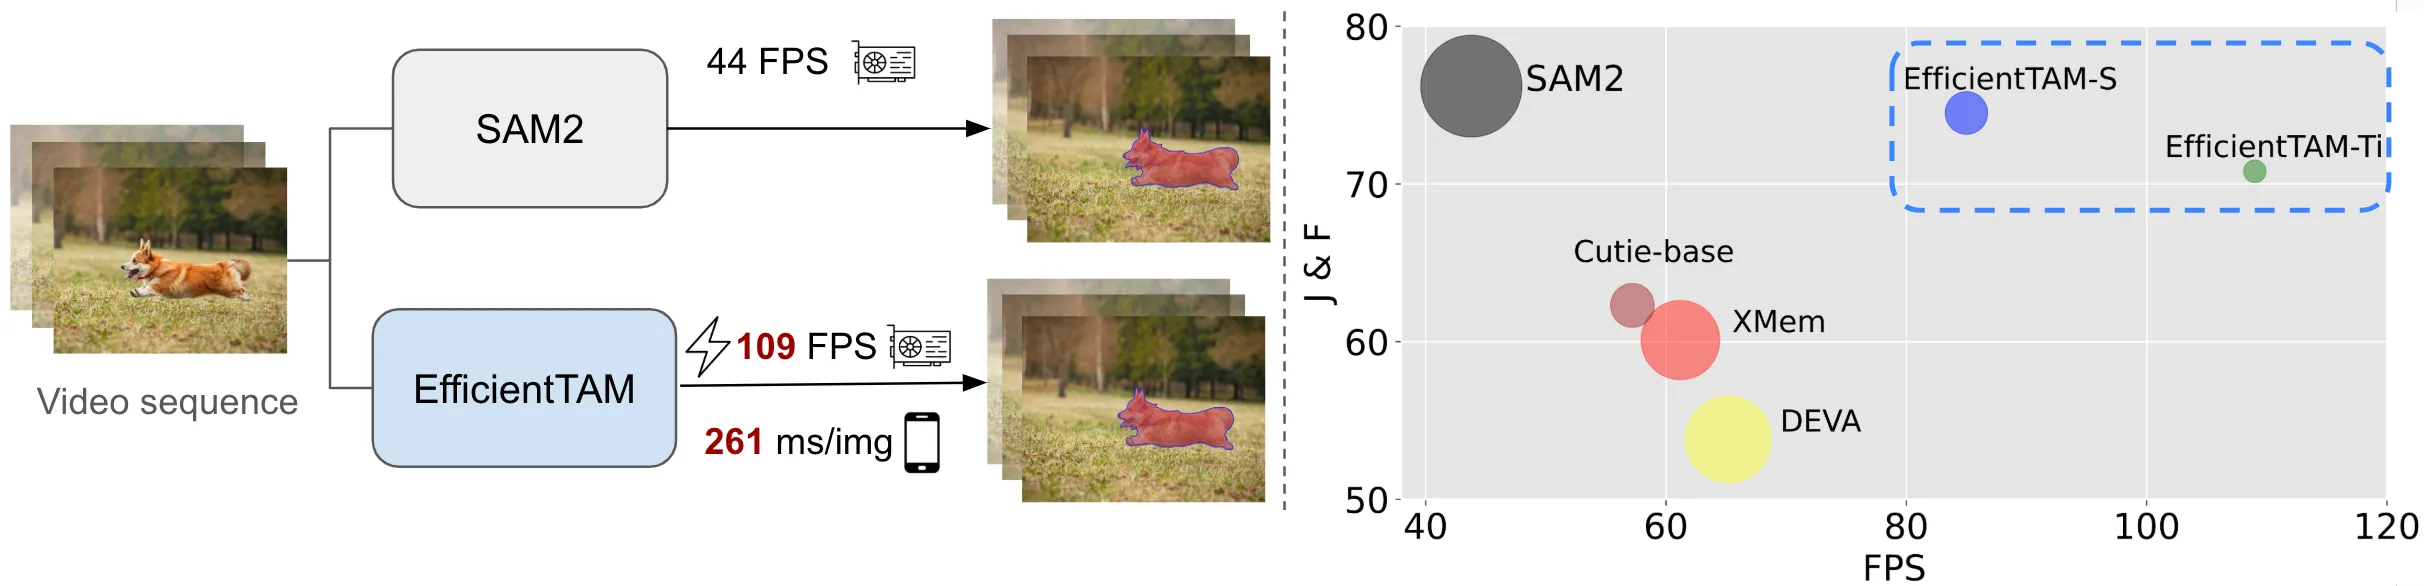
Figure 1: 比较分析。(左) EfficientTAM 与 SAM 2 在 A100 上的速度比较。(右) FPS/参数/性能比较。
| 方法 | MOSE val | DAVIS val | LVOS val | SA-V test | YTVOS val | 参数(M) | FPS |
|---|---|---|---|---|---|---|---|
| STCN | 52.5 | 85.4 | - | 57.3 | 82.7 | 54 | 62.8 |
| XMem | 59.6 | 86.0 | - | 60.1 | 85.6 | 62 | 61.2 |
| DEVA | 66.0 | 87.0 | 55.9 | 53.8 | 85.4 | 69 | 65.2 |
| Cutie-base | 69.9 | 87.9 | 66.0 | 61.6 | 87.0 | 35 | 65 |
| SAM 2 | 72.8 | 88.9 | 76.2 | 74.7 | 87.9 | 81 | 43.8 |
| EfficientTAM-Ti | 69.3 | 89.1 | 69.6 | 70.7 | 86.7 | 18 | 96.2 |
| EfficientTAM-S | 71.4 | 89.2 | 73.4 | 74.5 | 87.2 | 34 | 85.0 |
| EfficientTAM-S/2 | 70.8 | 88.6 | 72.1 | 74.0 | 87.2 | 34 | 109.4 |
关键结果:
- EfficientTAM-S 在 SA-V test 上达到 74.5% vs SAM 2 的 74.7%,仅差 0.2%
- EfficientTAM-S 参数量 34M vs SAM 2 的 81M,减少 ~2.4x
- EfficientTAM-S/2 在 A100 上达到 109.4 FPS vs SAM 2 的 43.8 FPS,提升 ~2.5x
移动设备性能
| 方法 | 延迟 (ms) | FPS |
|---|---|---|
| EfficientTAM-Ti | 840.5 | ~1.2 |
| EfficientTAM-Ti/2 | 261.4 | ~3.8 |
| EfficientTAM-S | 1010.8 | ~1.0 |
| EfficientTAM-S/2 | 450.0 | ~2.2 |
关键结果: EfficientTAM-Ti/2 在 iPhone 15 Pro Max 上达到 ~3.8 FPS。
图像分割结果
| 方法 | SA-23 mIoU |
|---|---|
| SAM | 59.1% |
| SAM 2 | 61.9% |
| EfficientTAM | 60.7% |
关键结果: EfficientTAM 在 SA-23 上达到 60.7%,超越 SAM 的 59.1%。
消融实验
对象指针 token 的影响
| 配置 | SA-V test (J&F) |
|---|---|
| 无对象指针 | 72.1 |
| 有对象指针 | 74.5 |
结论: 对象指针 token 显著提升性能 (+2.4%)。
记忆 Token 结构
| 配置 | SA-V test (J&F) |
|---|---|
| 全部池化 | 72.2 |
| 仅空间 token 池化 | 74.5 |
结论: 仅对空间 token 池化,保留对象指针,避免 2.3% 精度损失。
窗口大小影响
| 窗口大小 | SA-V test (J&F) | 速度提升 |
|---|---|---|
| 1×1 (原始) | 74.5 | 1x |
| 2×2 | 74.0 | ~1.3x |
| 4×4 | 73.0 | ~1.5x |
结论: 2×2 窗口在精度和效率之间取得最佳平衡。
线性交叉注意力
| 方法 | SA-V test (J&F) |
|---|---|
| 线性注意力 | ~64 |
| 高效交叉注意力 | 74.0 |
结论: 线性注意力导致 >10% 精度损失,高效交叉注意力更有效。
六、与现有方法对比
| 方面 | SAM 2 (HieraB+) | EfficientTAM-S | 改进 |
|---|---|---|---|
| 图像编码器 | HieraB+ (层次化) | ViT-Small (plain) | 更高效 |
| 参数量 | 81M | 34M | ~2.4x 减少 |
| FPS (A100) | 43.8 | 85.0 | ~2x 提升 |
| SA-V test | 74.7% | 74.5% | -0.2% |
| 移动部署 | 困难 | ~10 FPS | 可行 |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| SAM | 图像分割基础模型,EfficientTAM 继承其架构 |
| SAM 2 | 视频分割基础模型,EfficientTAM 是其高效版本 |
| EfficientSAM | 高效图像分割,EfficientTAM 扩展到视频 |
| Hiera | 层次化 ViT,EfficientTAM 使用 plain ViT 替代 |
| Cutie | 视频分割基线,EfficientTAM 超越其性能 |
| XMem | 视频分割基线,EfficientTAM 超越其性能 |
八、总结
核心贡献
- Plain ViT 编码器: 证明非层次化 ViT 可用于视频分割,实现 ~2x 速度提升
- 高效记忆注意力: 利用空间 token 局部性,降低计算复杂度
- 移动部署: 首次在 iPhone 15 Pro Max 上实现实时视频分割 (~10 FPS)
- SOTA 效率-质量权衡: 在精度接近 SAM 2 的同时,显著提升效率
技术影响
- 移动部署: 使视频目标分割在移动设备上成为可能
- 效率优化: 为 SAM 2 提供互补的高效替代方案
- 架构设计: 证明 plain ViT 在视频分割中的有效性
- 实际应用: 可用于实时视频编辑、AR/VR、自动驾驶等场景
局限性
- 精度略低于 SAM 2 (~0.2%)
- 移动设备上 FPS 仍较低 (~10 FPS)
- 未探索混合精度量化
- 未在更多移动设备上验证
九、参考资源
- 论文: arXiv:2411.18933
- 主题: cs.CV
- 页数: 约 15 页, 2 图, 5 表