FasterCache: Training-Free Video Diffusion Model Acceleration with High Quality
无需训练的视频扩散模型加速策略,通过动态特征复用和 CFG-Cache 实现 1.67x 加速同时保持高质量生成
FasterCache: Training-Free Video Diffusion Model Acceleration with High Quality
论文信息: arXiv:2410.19355 [cs.CV] 12 Mar 2025
作者: Zhengyao Lv, Chenyang Si, Junhao Song, Zhenyu Yang, Yu Qiao, Ziwei Liu, Kwan-Yee K. Wong
机构: The University of Hong Kong, S-Lab NTU, Shanghai AI Lab
代码: https://github.com/Vchitect/FasterCache
许可: arXiv.org perpetual non-exclusive license
一、论文概述
1.1 研究背景
扩散变换器(DiT)在图像和视频生成中取得了显著成功。然而,迭代去噪、无分类器引导(CFG)和 Transformer 注意力机制导致推理计算成本高昂,特别是视频生成通常需要 2-5 分钟来合成 6 秒 480P 视频,限制了其实际应用。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 计算成本高 | 视频扩散模型推理需要大量计算资源 |
| 推理延迟长 | 6 秒 480P 视频需要 2-5 分钟合成 |
| 特征复用局限 | 现有缓存方法直接复用相邻步特征导致质量下降 |
| CFG 冗余 | 条件和非条件输出在同时间步高度相似,存在冗余 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 动态特征复用策略 | 保留特征区分性和时间连续性,避免直接复用导致的质量下降 |
| CFG-Cache | 优化条件和非条件输出的复用,进一步提升推理速度 |
| 无需训练 | 方法无需额外训练成本,可直接应用于现有模型 |
| 显著加速 | 在 Vchitect-2.0 上实现 1.67x 加速,同时保持高质量 |
二、核心思想
2.1 问题定义
现有缓存加速方法存在两个关键问题:
问题 1:直接复用相邻步特征导致质量下降
- 虽然同一注意力模块的特征在相邻步之间高度相似
- 但存在细微而可察觉的差异
- 直接复用会导致视频细节丢失
问题 2:CFG 计算冗余
- CFG 需要计算条件和非条件输出,几乎使推理时间翻倍
- 同时间步的条件和非条件输出高度相似
- 相邻步的非条件输出相似度较低
2.2 解决方案概述
FasterCache 通过两个核心策略解决上述问题:
- 动态特征复用策略:计算相邻缓存特征的差异作为偏差,动态调整特征复用
- CFG-Cache:缓存条件和非条件输出之间的高频和低频偏差,优化 CFG 计算
三、技术架构
3.1 动态特征复用策略
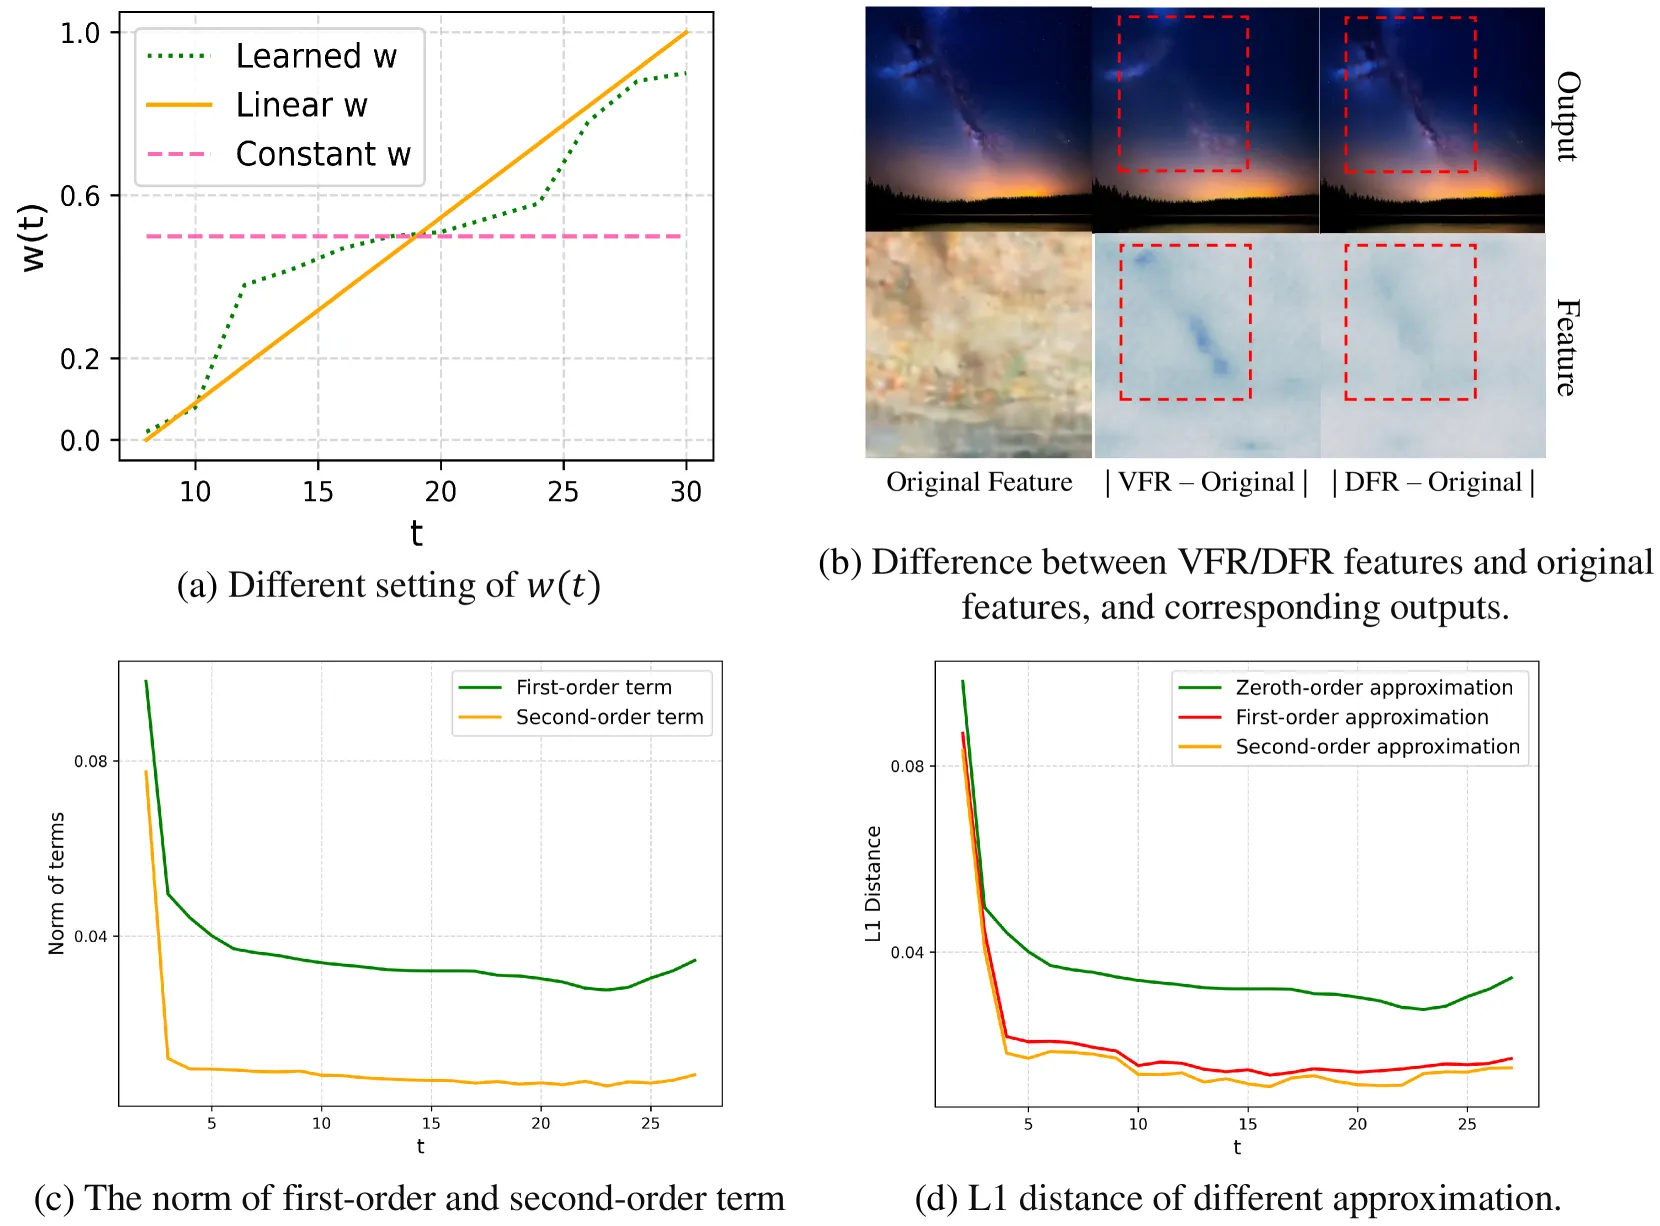 图 13:动态特征复用的设计选择和与 Vanilla Feature Reuse 的比较。
核心公式:
对于中间时间步 的特征计算:
其中:
- :时间步 的缓存特征
- :时间步 的缓存特征
- :权重函数,从 0 线性增加到 1
关键特性:
- 每隔 2 步计算一次完整注意力输出
- 利用相邻缓存特征的差异作为偏差
- 动态捕捉时间步间的演变细节
3.2 CFG-Cache
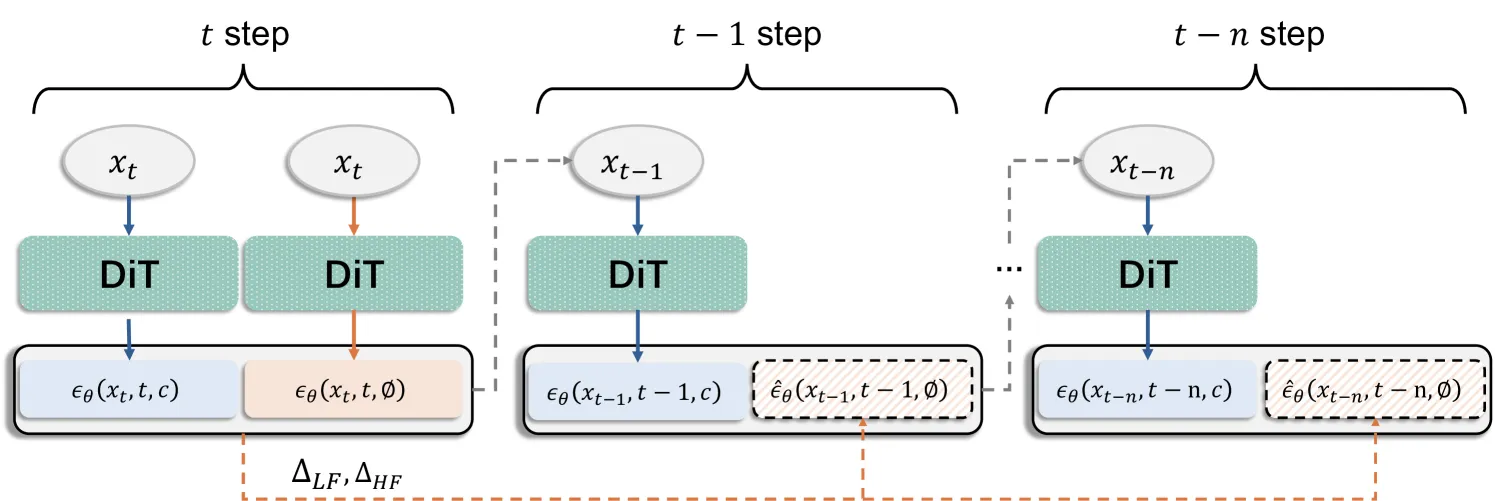 图 8:CFG-Cache 概览。通过缓存条件和非条件输出之间的高频和低频偏差来加速非条件输出的计算。
核心思想:
- 缓存条件和非条件输出之间的高频和低频偏差
- 在后续时间步中利用这些偏差快速计算非条件输出
- 避免完整的非条件前向传播
CFG 公式:
其中 是引导尺度。
3.3 CFG 冗余分析
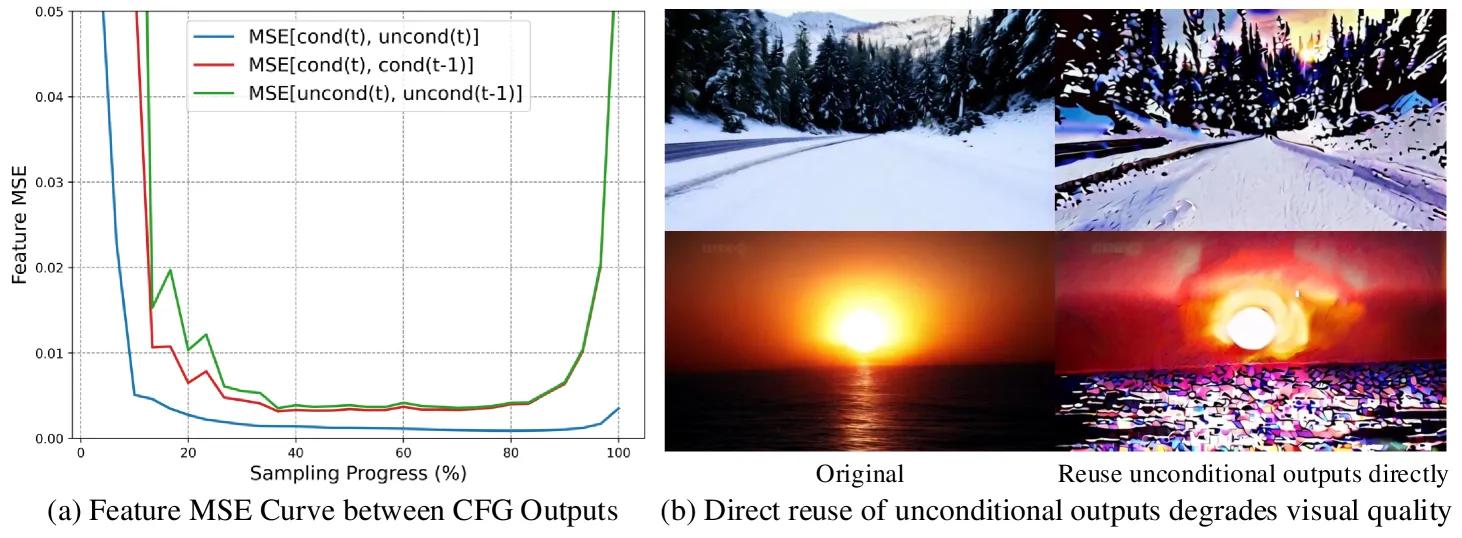 图 6:(a) 同时间步和跨时间步的条件和非条件输出之间的 MSE。(b) 直接复用前时间步的非条件输出会导致显著的视觉质量下降。
关键发现:
- 采样中后期,同时间步的条件和非条件输出相似度极高
- 跨时间步的非条件输出相似度较低
- 直接复用前时间步的非条件输出会导致误差累积
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 动态特征复用 | 利用相邻缓存特征差异作为偏差 | 特征 MSE 分析和视觉质量对比 |
| CFG-Cache | 缓存条件/非条件输出的高频/低频偏差 | CFG 冗余分析和消融实验 |
| 无需训练 | 方法无需额外训练成本 | 直接应用于多个视频扩散模型 |
| 通用性 | 适用于多种视频扩散模型架构 | 在 Open-Sora、Latte、CogVideoX 等模型上验证 |
4.2 技术细节
特征相似性分析:
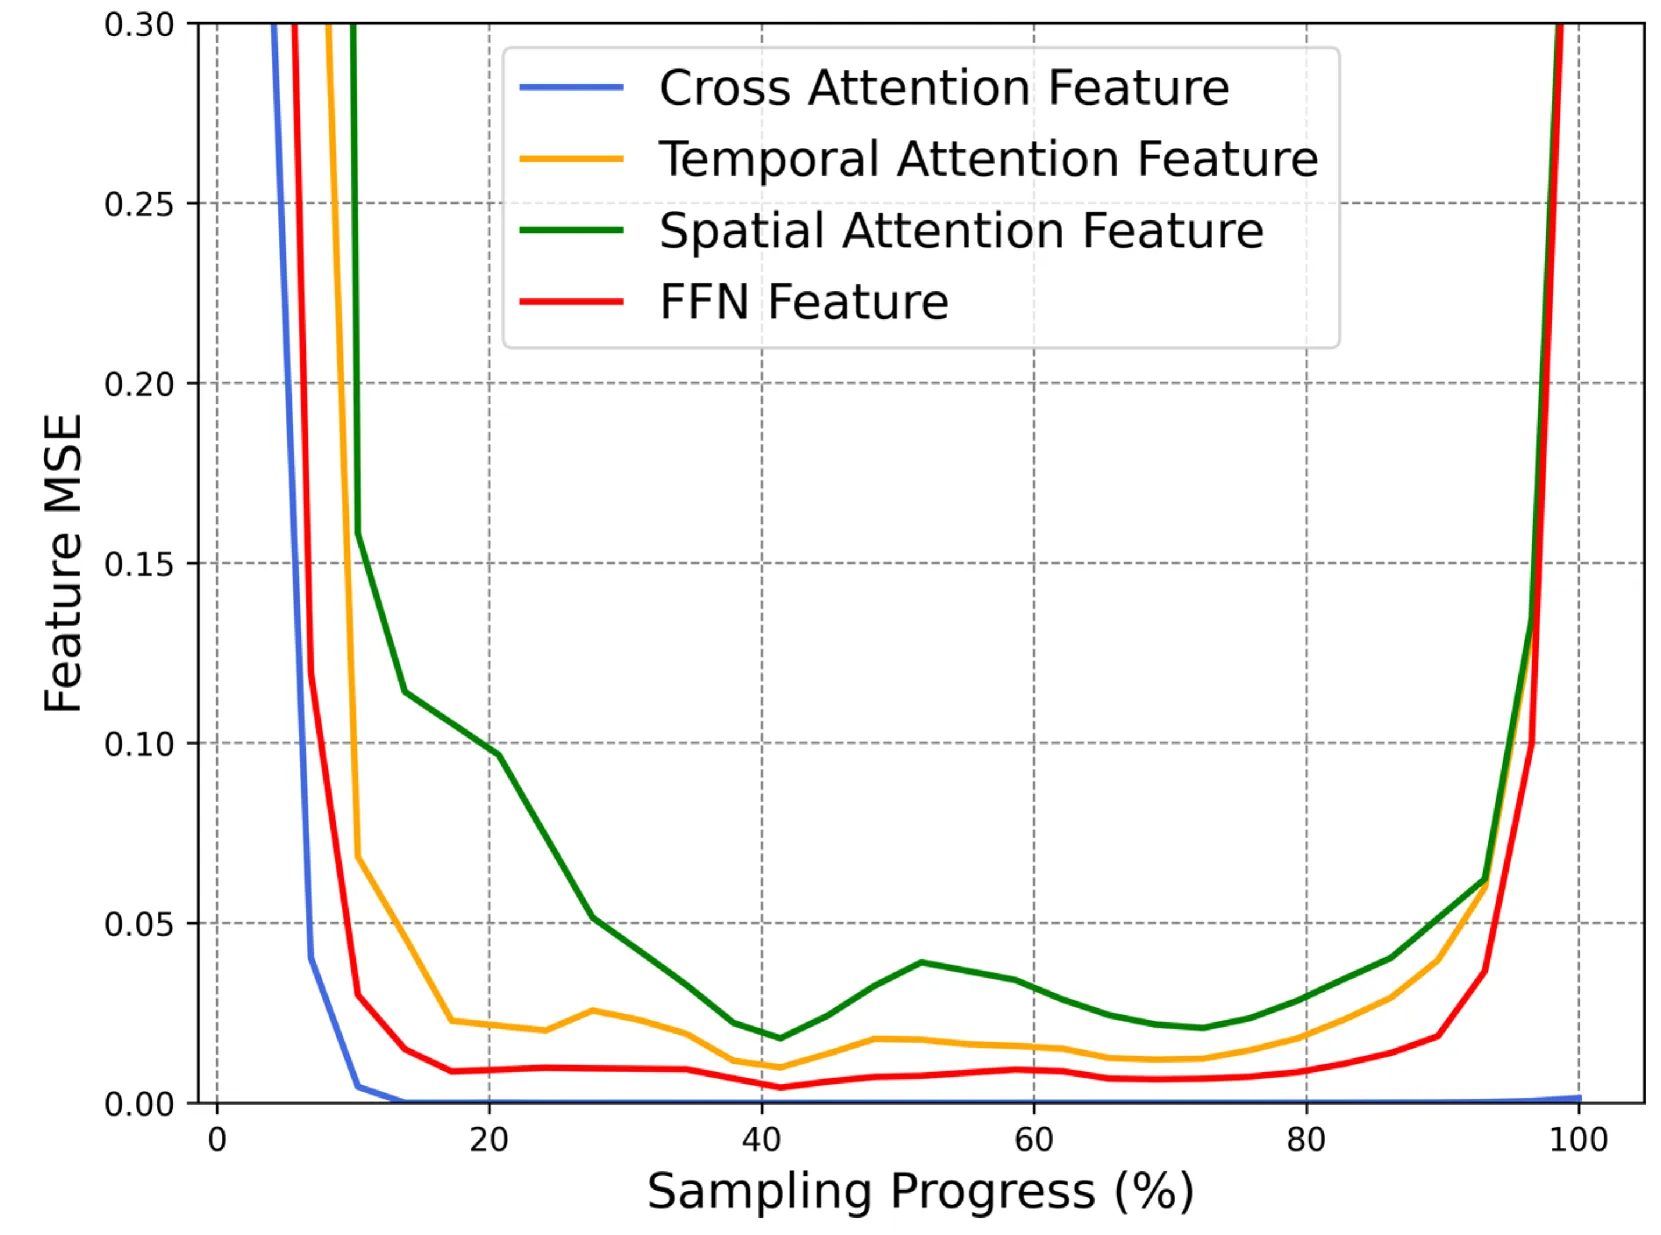 图 4:当前和前一扩散步骤之间注意力特征的均方误差(MSE)比较。较小的值表示较高的相似性。
质量退化分析:
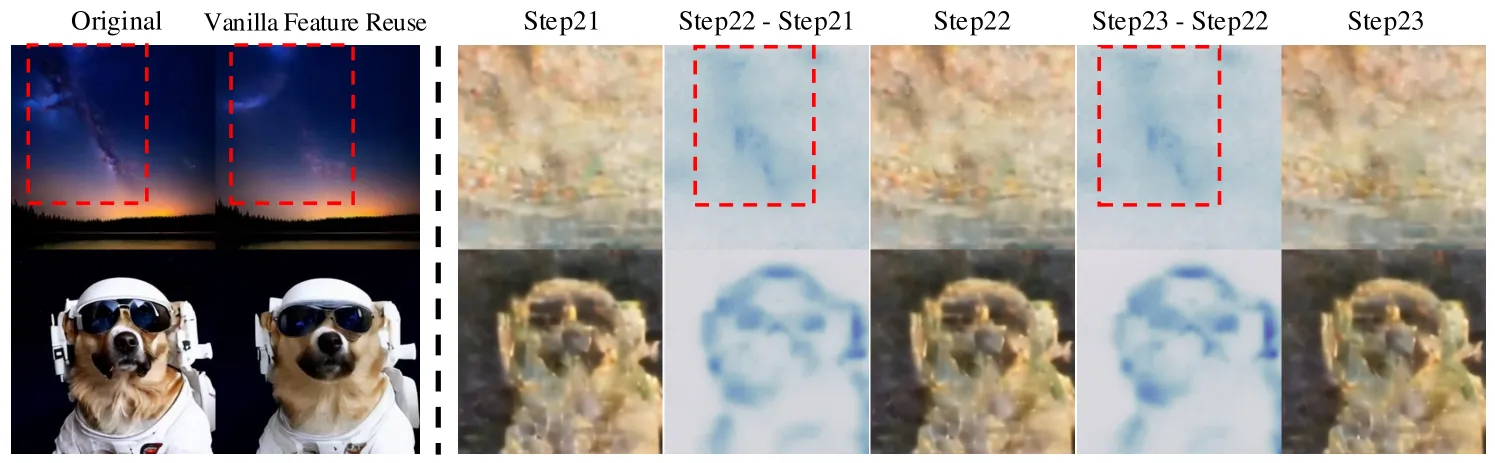 图 5:Vanilla Feature Reuse 导致的视觉质量退化(左)和相邻时间步之间的特征差异(右)。
五、代码实现分析
5.1 项目结构
| 组件 | 说明 |
|---|---|
| FasterCache 核心 | 动态特征复用和 CFG-Cache 实现 |
| 模型适配 | 支持 Open-Sora、Latte、CogVideoX 等模型 |
| 评估工具 | VBench、LPIPS、PSNR、SSIM 指标计算 |
5.2 实现细节
- 注意力计算:每 2 步进行一次完整空间和时间注意力推理
- 权重函数: 从 0 线性增加到 1
- CFG 复用:从总采样步数的 1/3 开始,每 5 步进行一次完整推理
- 超参数:(默认值)
六、实验结果
6.1 主要结果
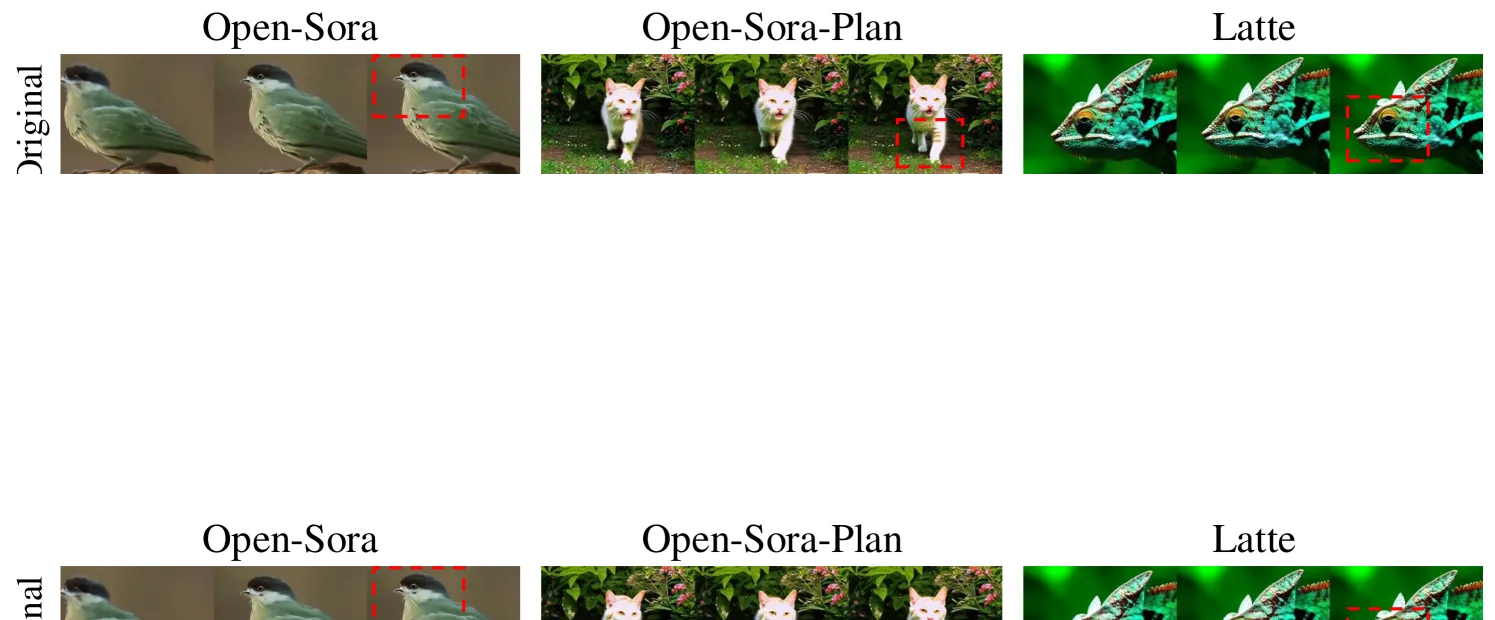 图 9:不同方法的视觉质量比较。差异在红框中突出显示。
Open-Sora 1.2 (192 frames, 480P):
| 方法 | MACs (P) | 加速比 | 延迟 (s) | VBench | LPIPS | SSIM | PSNR |
|---|---|---|---|---|---|---|---|
| 原始模型 | 6.30 | 1× | 192.07 | 78.79% | - | - | - |
| Δ-DiT (Nc=14, N=2) | 5.51 | 1.14× | 168.69 | 77.43% | 0.2834 | 0.7403 | 17.77 |
| Δ-DiT (Nc=28, N=2) | 4.72 | 1.34× | 143.14 | 76.60% | 0.3321 | 0.7092 | 16.24 |
| PAB | 5.33 | 1.23× | 156.73 | 78.15% | 0.1041 | 0.8821 | 26.43 |
| FasterCache | 4.13 | 1.62× | 118.44 | 78.46% | 0.0835 | 0.8932 | 27.03 |
Vchitect-2.0 (40 frames, 480P):
| 方法 | MACs (P) | 加速比 | 延迟 (s) | VBench | LPIPS | SSIM | PSNR |
|---|---|---|---|---|---|---|---|
| 原始模型 | 14.57 | 1× | 260.32 | 80.80% | - | - | - |
| Δ-DiT (Nc=6, N=3) | 13.00 | 1.11× | 233.59 | 79.98% | 0.4153 | 0.5837 | 14.26 |
| Δ-DiT (Nc=12, N=3) | 11.79 | 1.24× | 209.78 | 79.50% | 0.4534 | 0.5519 | 13.68 |
| PAB | 12.20 | 1.26× | 206.23 | 79.56% | 0.0489 | 0.8806 | 27.38 |
| FasterCache | 8.67 | 1.67× | 156.13 | 80.84% | 0.0282 | 0.9224 | 31.45 |
6.2 消融实验
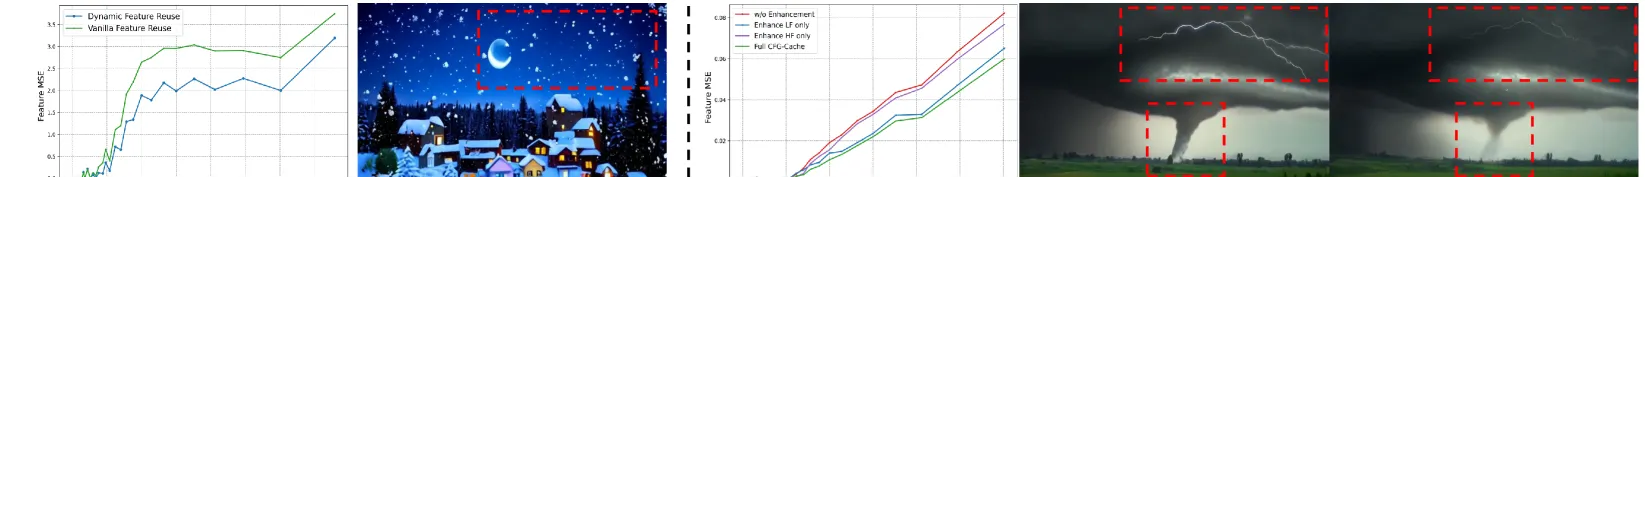 图 10:消融研究中的特征 MSE 曲线和视觉结果比较。
效率消融:
| 变体 | MACs (P) | 延迟 (s) | Δ 延迟 (s) |
|---|---|---|---|
| 原始模型 | 1.54 | 41.28 | - |
| + Vanilla FR | 1.33 | 33.25 | -8.03 |
| + Vanilla FR + CFG | 1.33 | 33.50 | -7.78 |
| + Dynamic FR | 1.16 | 31.32 | -9.96 |
| + Dynamic FR + CFG-Cache | 1.01 | 26.12 | -15.16 |
关键发现:
- 动态特征复用策略和 CFG-Cache 独立贡献显著的推理成本降低
- 与 Vanilla Feature Reuse 相比,动态特征复用策略对效率的影响可忽略不计
6.3 可扩展性和泛化性
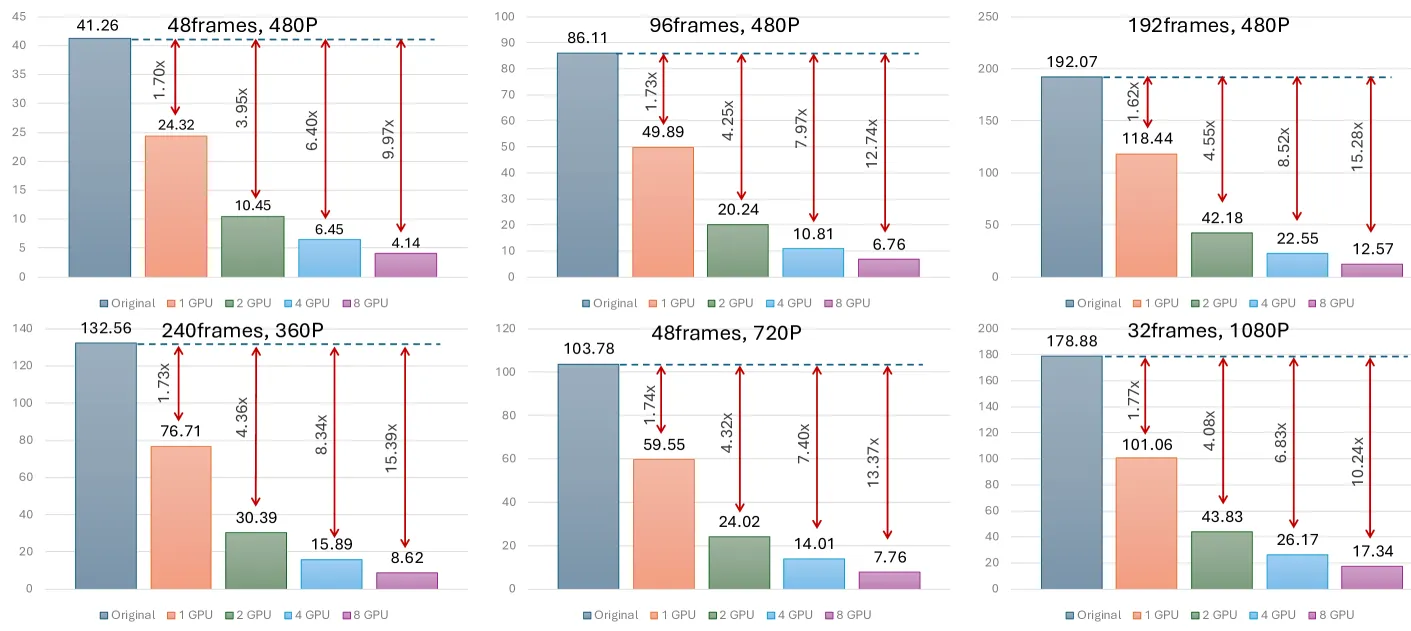 图 11:方法在不同视频分辨率和长度下的加速效率。
关键发现:
- 方法在不同视频分辨率和长度下保持稳定的加速效率
- 可泛化到多种视频扩散模型架构
七、相关工作
7.1 视频扩散模型
| 方法 | 类型 | 特点 |
|---|---|---|
| Open-Sora | DiT 架构 | 开源视频生成模型 |
| Latte | DiT 架构 | 视频扩散模型 |
| CogVideoX | DiT 架构 | 视频生成模型 |
| Vchitect-2.0 | DiT 架构 | 视频生成模型 |
7.2 加速方法
| 方法 | 类型 | 特点 |
|---|---|---|
| PAB | 金字塔注意力复用 | 层级注意力缓存 |
| Δ-DiT | 残差缓存 | Transformer 特征复用 |
| FasterCache | 动态特征复用 + CFG-Cache | 无需训练,高质量加速 |
八、总结
8.1 核心贡献
- 动态特征复用策略:通过计算相邻缓存特征差异作为偏差,保留特征区分性和时间连续性
- CFG-Cache:缓存条件和非条件输出之间的高频和低频偏差,优化 CFG 计算
- 无需训练:方法无需额外训练成本,可直接应用于现有模型
- 显著加速:在多个视频扩散模型上实现 1.54×-1.67× 加速
- 高质量保持:在加速的同时保持与原始模型相当的视觉质量
8.2 技术影响
- 实时视频生成:使视频扩散模型更接近实时应用
- 资源效率:减少视频生成所需的计算资源
- 即插即用:方法可直接应用于现有视频扩散模型
- 研究方向:为缓存加速方法提供了新的研究思路
8.3 局限性
- 超参数敏感:需要调整权重函数和缓存策略的超参数
- 模型依赖:不同模型可能需要不同的超参数设置
- 质量权衡:在极高加速比下仍可能存在质量损失
九、参考资源
9.1 论文链接
- arXiv: https://arxiv.org/abs/2410.19355
- PDF: https://arxiv.org/pdf/2410.19355
- 代码: https://github.com/Vchitect/FasterCache
9.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | 方法比较 | figure-1-comparison.png |
| 图 4 | 特征 MSE 比较 | figure-4-mse-comparison.png |
| 图 5 | 质量退化分析 | figure-5-quality-degradation.png |
| 图 6 | CFG 冗余分析 | figure-6-cfg-redundancy.png |
| 图 8 | CFG-Cache 概览 | figure-8-cfg-cache-overview.png |
| 图 9 | 视觉质量比较 | figure-9-visual-comparison.png |
| 图 10 | 消融实验 MSE | figure-10-ablation-mse.png |
| 图 11 | 分辨率缩放 | figure-11-resolution-scaling.png |
| 图 13 | 动态特征复用 | figure-13-dynamic-feature-reuse.png |


9.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| PAB | Zhao et al. | 2024 | 金字塔注意力缓存方法 |
| Δ-DiT | Chen et al. | 2024 | 残差缓存方法 |
| Open-Sora | Zheng et al. | 2024 | 视频扩散模型 |
| Latte | Ma et al. | 2024 | 视频扩散模型 |
9.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 扩散变换器 | Diffusion Transformer (DiT) | 基于 Transformer 的扩散模型骨干 |
| 无分类器引导 | Classifier-Free Guidance (CFG) | 增强生成质量的技术 |
| 动态特征复用 | Dynamic Feature Reuse | 保留特征区分性的复用策略 |
| CFG-Cache | CFG-Cache | 优化 CFG 计算的缓存策略 |
| 视频扩散模型 | Video Diffusion Model | 用于视频生成的扩散模型 |
| 特征缓存 | Feature Cache | 存储中间特征以加速推理 |
分析完成时间:2026年6月23日 分析工具:Claude Code + paper-analyzer skill