Movie Gen: 媒体基础模型全家桶
Meta 的 Movie Gen 媒体基础模型全家桶:30B 文生视频 + 13B 视频音频生成,Flow Matching + LLaMa3 风格 Transformer,支持 1080p HD 视频、同步音频、个性化与指令式视频编辑,多任务达到 SOTA。
Movie Gen: A Cast of Media Foundation Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Movie Gen: A Cast of Media Foundation Models |
| 机构 | Meta AI |
| 论文 | https://arxiv.org/abs/2410.13720 (v2, 2025-02-26) |
| 发布 | 2024-10-17(v1),2025-02-26(v2) |
| 分类 | cs.CV (Computer Vision and Pattern Recognition) |
| 规模 | Movie Gen Video 30B / Movie Gen Audio 13B |
摘要
Movie Gen 是一套基础模型全家桶(cast of foundation models),可生成高质量 1080p HD 视频(多种宽高比)+ 同步音频,并支持精确的指令式视频编辑、基于用户图像的个性化视频生成。模型在多个任务上刷新 SOTA:文生视频合成、视频个性化、视频编辑、视频到音频生成、文本到音频生成。
- Movie Gen Video:最大 30B 参数 Transformer,最大上下文 73K 视频 token,对应 16fps 下 16 秒视频
- Movie Gen Audio:13B 参数,视频/文本到音频生成,48kHz 电影级音效与音乐,支持数分钟长音频
论文公开了两个基准(Movie Gen Video Bench、Movie Gen Audio Bench)及架构、训练、推理、实验设置的详尽细节。
二、核心思想
核心理念:简单化 + 规模化
发现:用 Flow Matching 训练一个简单的、基于 Transformer 的模型,扩展训练数据、算力和模型参数,即可得到高质量的视频/音频生成模型。
设计哲学是刻意保持简单,所有组件(训练目标、骨干架构、TAE 时空压缩)都尽量简单并与 LLM(尤其是 LLaMa3)相似,从而能用类似 LLM 的技术自信地扩展模型规模与训练效率。经验上,该架构与专门设计的模块性能相当或更优,且训练更稳定。
五大能力
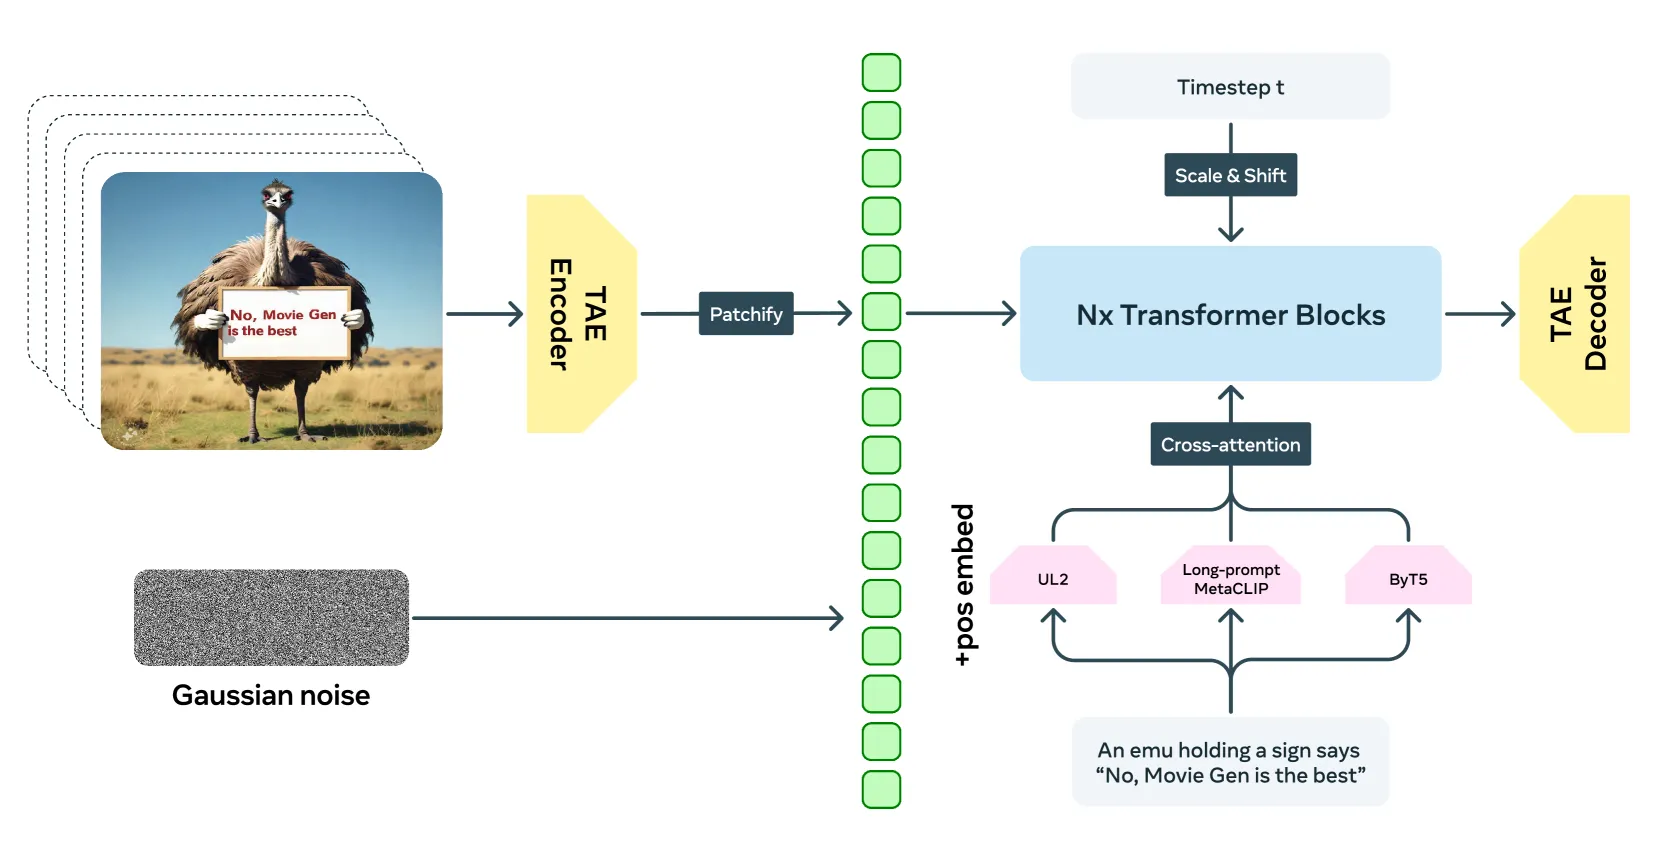
- 文生视频/图(单一联合模型,图像视为单帧视频)
- 视频个性化(PT2V,条件于人物图像 + 文本)
- 指令式精确视频编辑(Movie Gen Edit,无需监督编辑数据)
- 视频到音频生成(同步音效/音乐)
- 文本到音频生成
三、技术架构:Movie Gen Video (30B)
3.1 时序自编码器 (TAE)
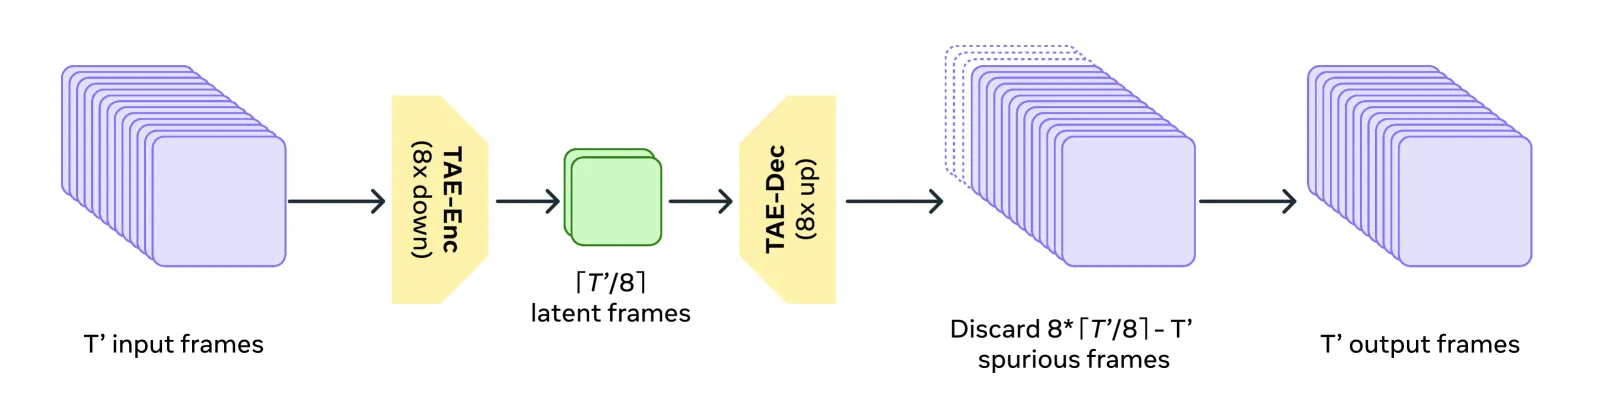
- 基于 VAE,将像素空间视频 ()压缩到时空压缩潜空间,压缩比 8×8×8
- 架构:沿用图像自编码器(Rombach et al. 2022)并”膨胀”——每个 2D 空间卷积后加 1D 时序卷积,每个空间注意力后加 1D 时序注意力;时序下采样用 stride=2 卷积,上采样用最近邻插值+卷积
- Outlier Penalty Loss (OPL):标准目标会产生 “spot” 伪影(潜码某些空间位置范数过高,即 “latent dots”,属捷径学习)。不改架构,而是加惩罚项让潜值不偏离均值太远:
其中 (默认 3)为标准差倍数阈值,加到 VAE 常规损失(重建+判别器+感知)上即可消除 dot 伪影。
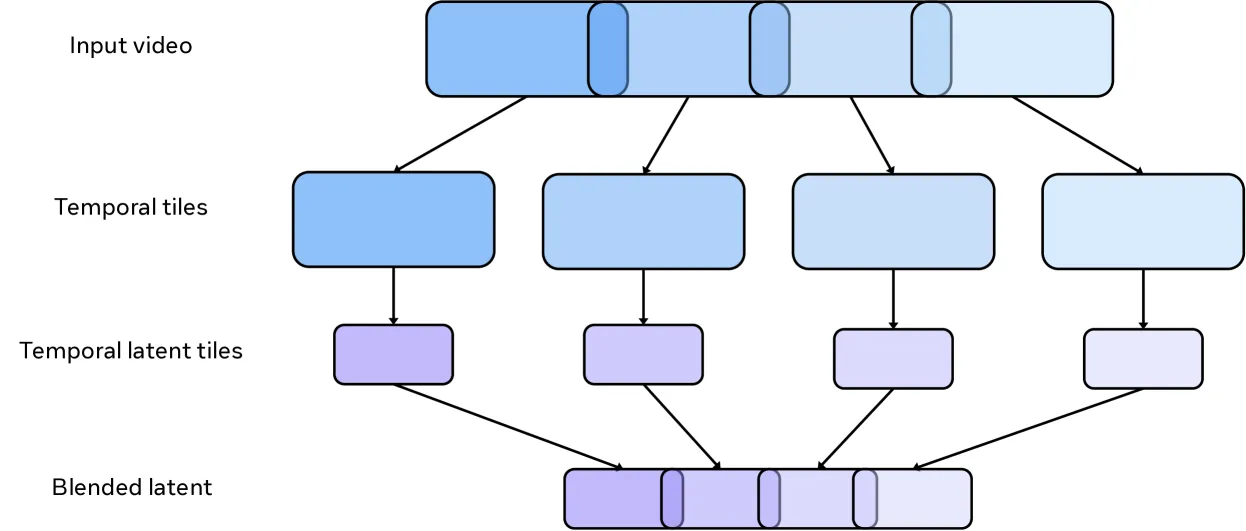
- 时序分块推理 (Temporal Tiling):高分辨率长视频(如 1024×1024、256 帧)直接编解码内存不可行,故沿时间维度分块编解码后拼接。
3.2 训练目标:Flow Matching
采用 Flow Matching 框架,通过迭代将先验分布(高斯)样本变为目标数据分布样本。构造 用简单线性插值(最优传输路径):
真值速度 ,模型预测速度 ,训练最小化 MSE:
- 从 logit-normal 分布采样(底层高斯零均值单位标准差)
- 零终端 SNR: 时 SNR 为零,训练时模型接收纯高斯噪声并学习预测其速度
- 推理:先采 ,用 ODE solver 计算
3.3 骨干架构(LLaMa3 风格)
- 潜码 先经 3D 卷积 patchify 再展平为 1D 序列
- 因子化可学习位置嵌入,支持任意尺寸/宽高比/时长
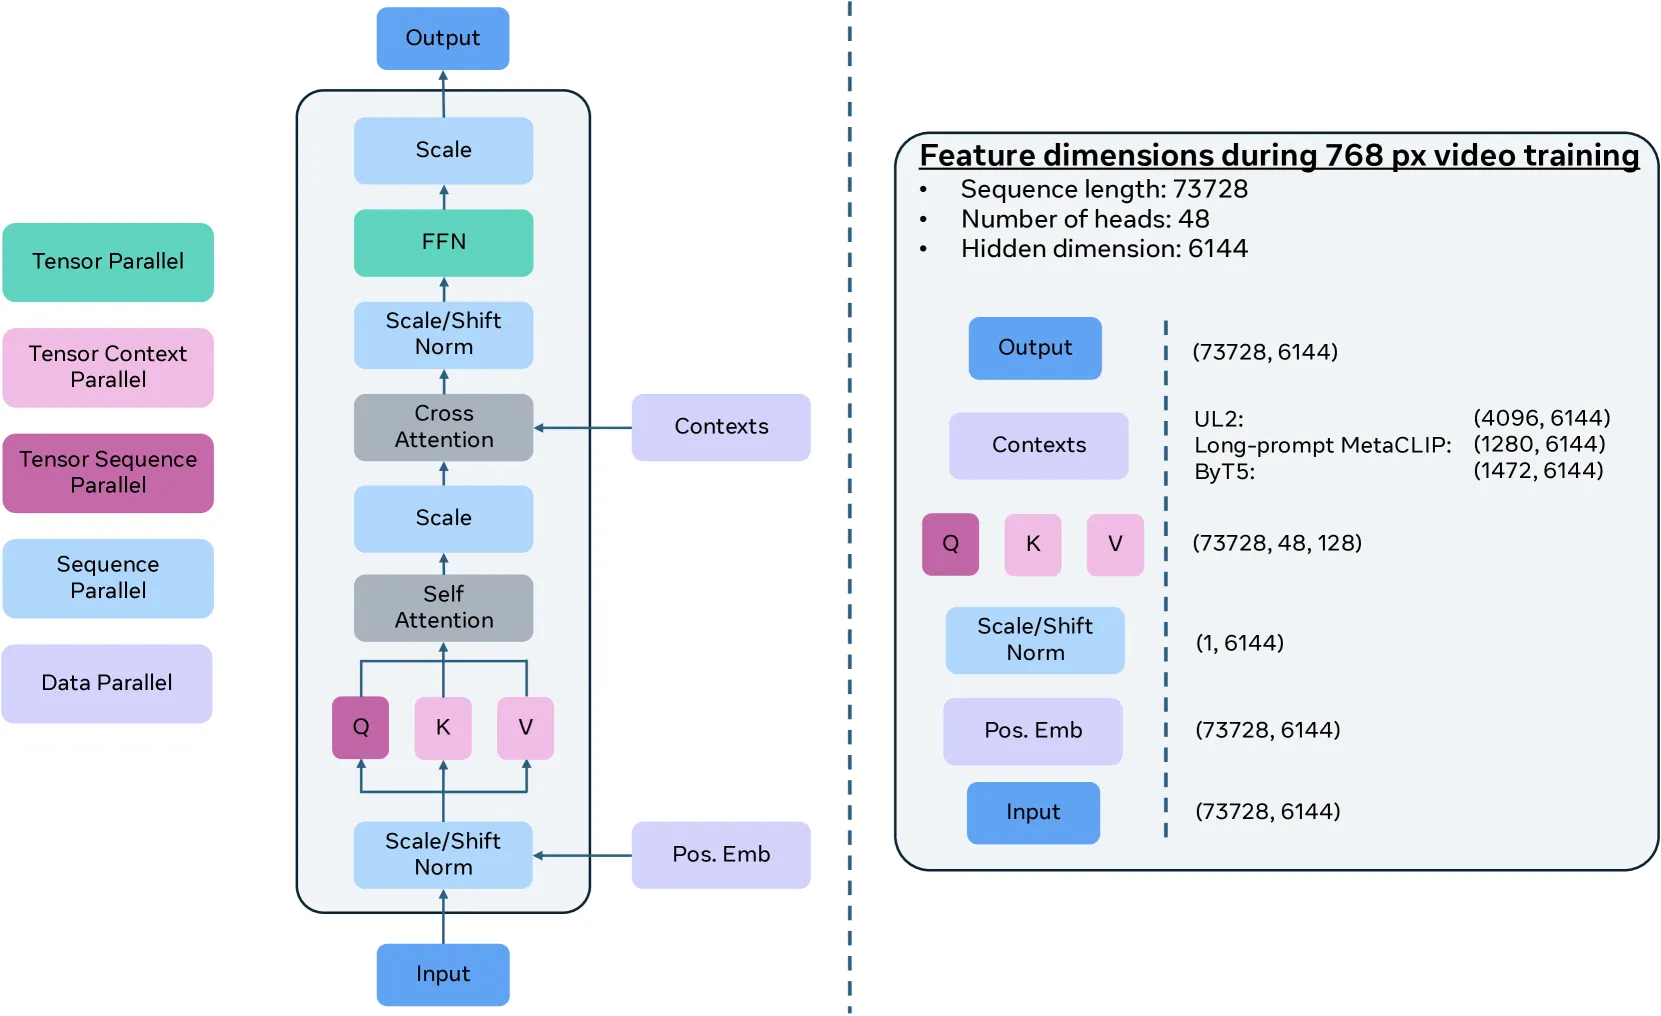
- 骨干紧随 LLaMa3 Transformer block:RMSNorm + SwiGLU,对视频生成做三处修改:
- 在 self-attention 与 FFN 之间加 cross-attention 融入文本条件
- 加 adaptive layer norm 融入时间步 (沿用 DiT)
- 全双向注意力(非因果)
3.4 富文本嵌入
用三个互补文本编码器拼接构成 :
- UL2(语义级)
- ByT5(字符级,用于视觉文本生成)
- Long-prompt MetaCLIP
FPS 条件控制:在输入 prompt 前追加采样 FPS 值(如 “FPS-16”)控制生成视频长度;预训练用原始 FPS(≥16),微调用固定 16/24 FPS。
3.5 空间上采样器 (Spatial Upsampler)
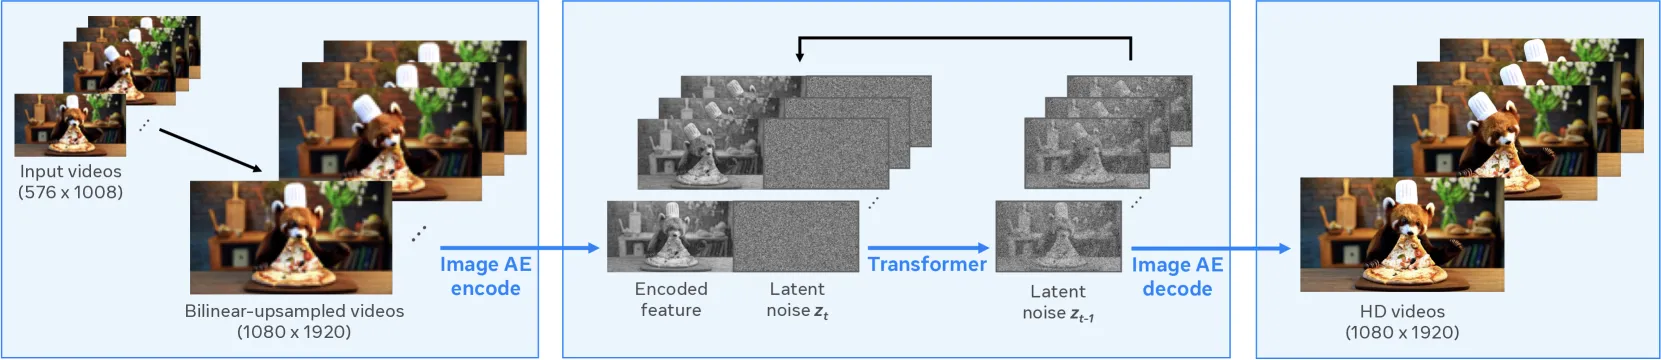
- 独立 7B 模型,将 768px 视频转为全 HD (1080p),降低高分辨率生成的总计算成本(基础模型处理更少 token)
- 形式化为视频到视频生成任务:低分辨率视频先双线性插值到目标分辨率 → VAE 编码 → 逐帧 VAE 解码
- 从 1024px 文生图模型初始化
- MultiDiffusion:滑窗上采样边界不一致问题用免训练优化解决
3.6 模型缩放与训练效率
- 基础设施:最多 6,144 张 H100(700W TDP,80GB HBM3),Meta Grand Teton 平台;服务器内 8 GPU NVSwitch 互联,跨服务器 400Gbps RoCE RDMA
- 上下文长度:768px 训练达 ~73K token(768×768、256 帧,经 TAE 8×8×8 + patchify 2×2 压缩)
- 3D 并行:FSDP + 张量并行(TP) + 序列并行(SP) + 上下文并行(CP)
- 与 LLM 对比:Movie Gen 用全双向注意力(无因果掩码),CP 的扩展特性因 Q 与 K,V 行为分离而不同于用 GQA 的 LLaMa3
3.7 预训练与微调
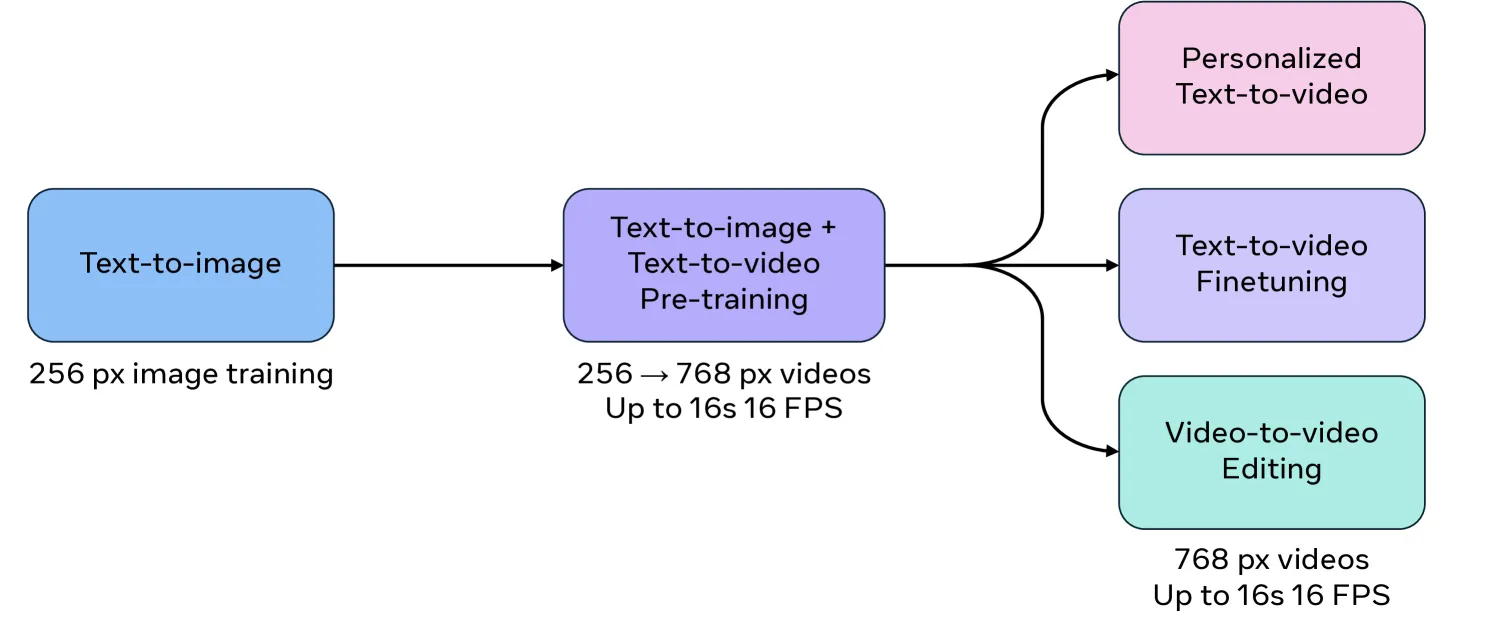
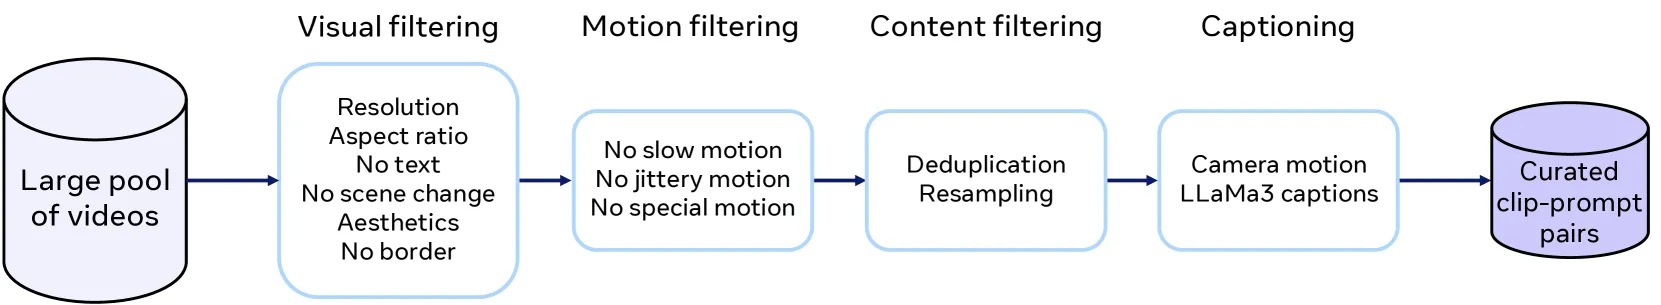
- 预训练数据:𝒪(100)M 视频 + 𝒪(1)B 图像
- 训练流程:先文生图预训练 → 联合文生图/文生视频预训练(渐进提高分辨率 256px→768px)
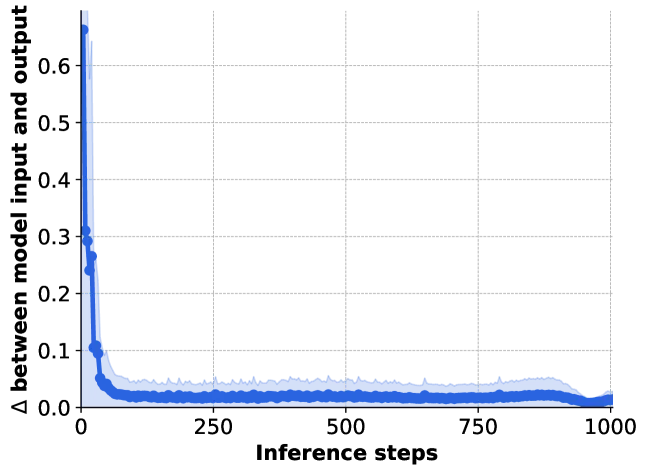
- linear-quadratic t-schedule:加速推理的时间步调度
- 微调:在高质量视频集上微调(表 7 显示微调净胜率 +34.65% Overall Quality)
- 推理:prompt 重写 + 提高推理效率
四、视频个性化 (Personalized Movie Gen Video, PT2V)
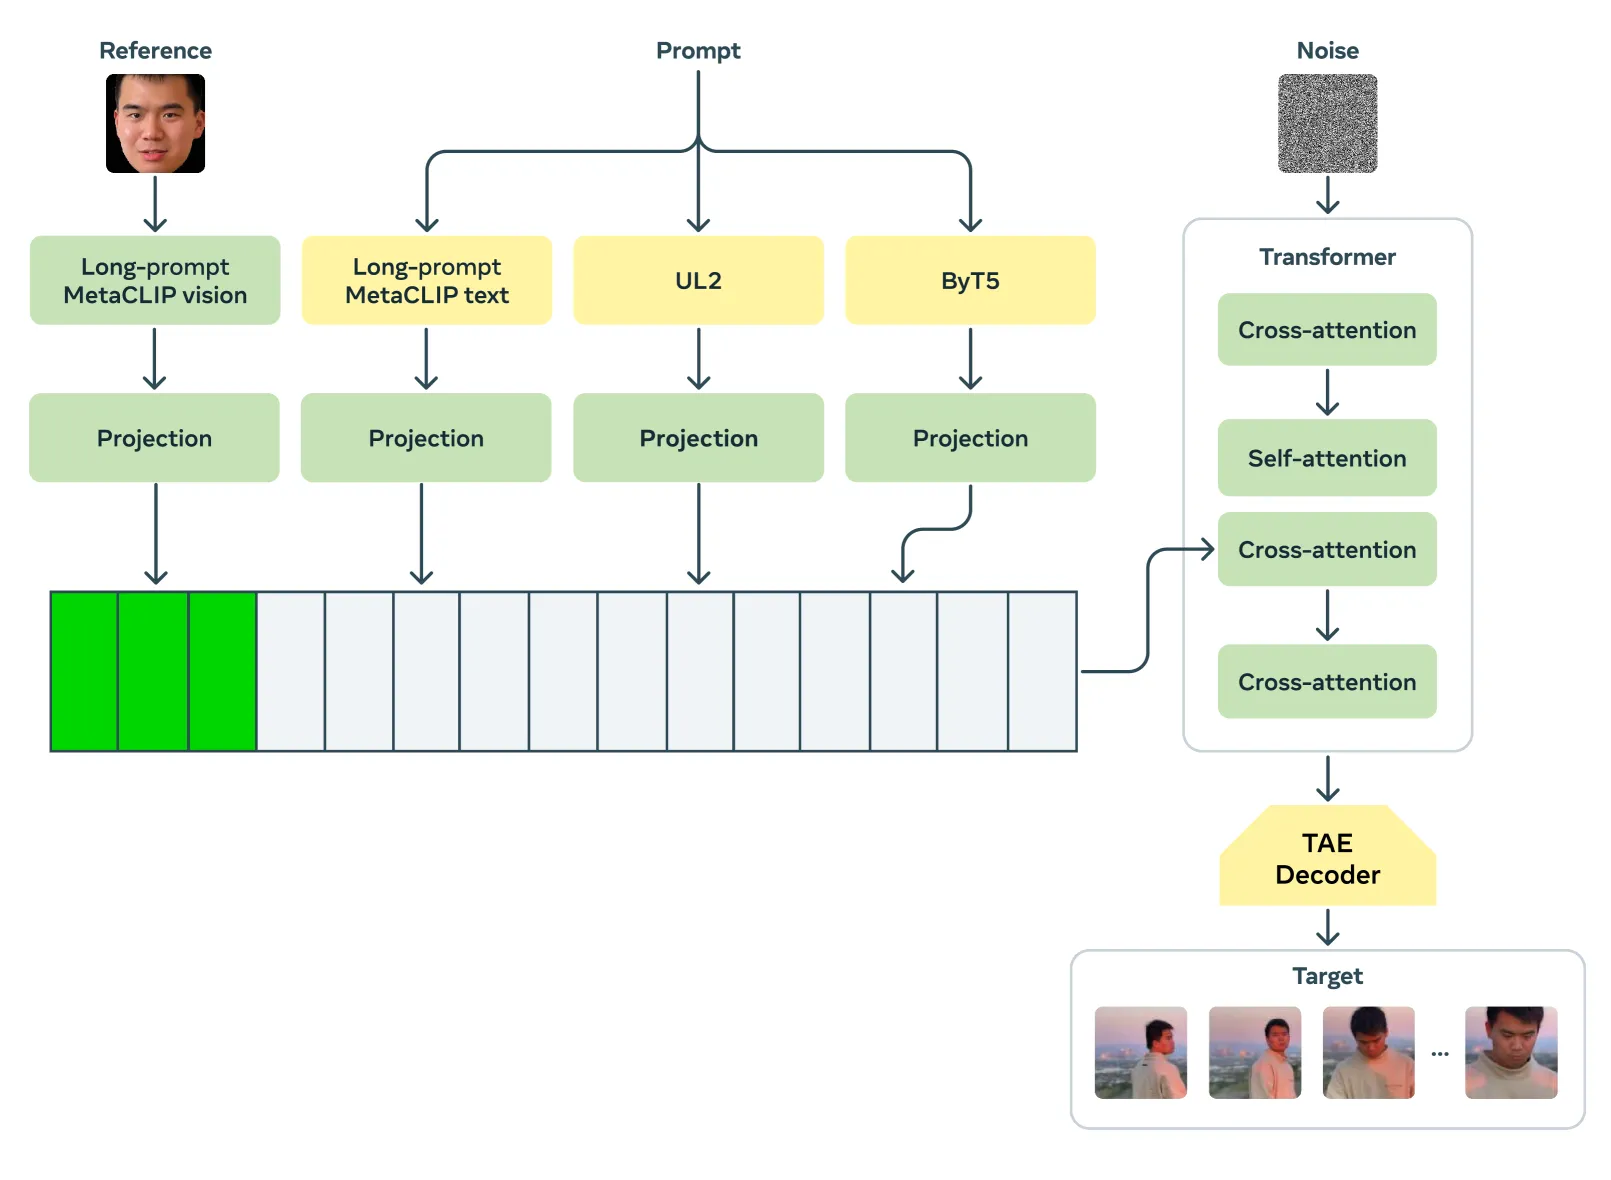
- 条件于文本 + 人物图像生成保持身份的个性化视频
- 用含人物的视频子集,自动构造 (图像, 文本)→视频 训练对
- 后训练策略:预训练 + 监督微调
表 15:身份保持消融 —— 可训练视觉编码器显著优于冻结:
| 方法 | Identity_best↑ | Identity_worst↑ | Face Consistency↑ |
|---|---|---|---|
| Frozen Vision Encoder | 73.93% | 66.67% | 83.50% |
| Trainable Vision Encoder | 90.10% | 87.22% | 99.69% |
| Cross-Paired Training | 71.79% | 66.36% | 97.53% |
五、指令式精确视频编辑 (Movie Gen Edit)
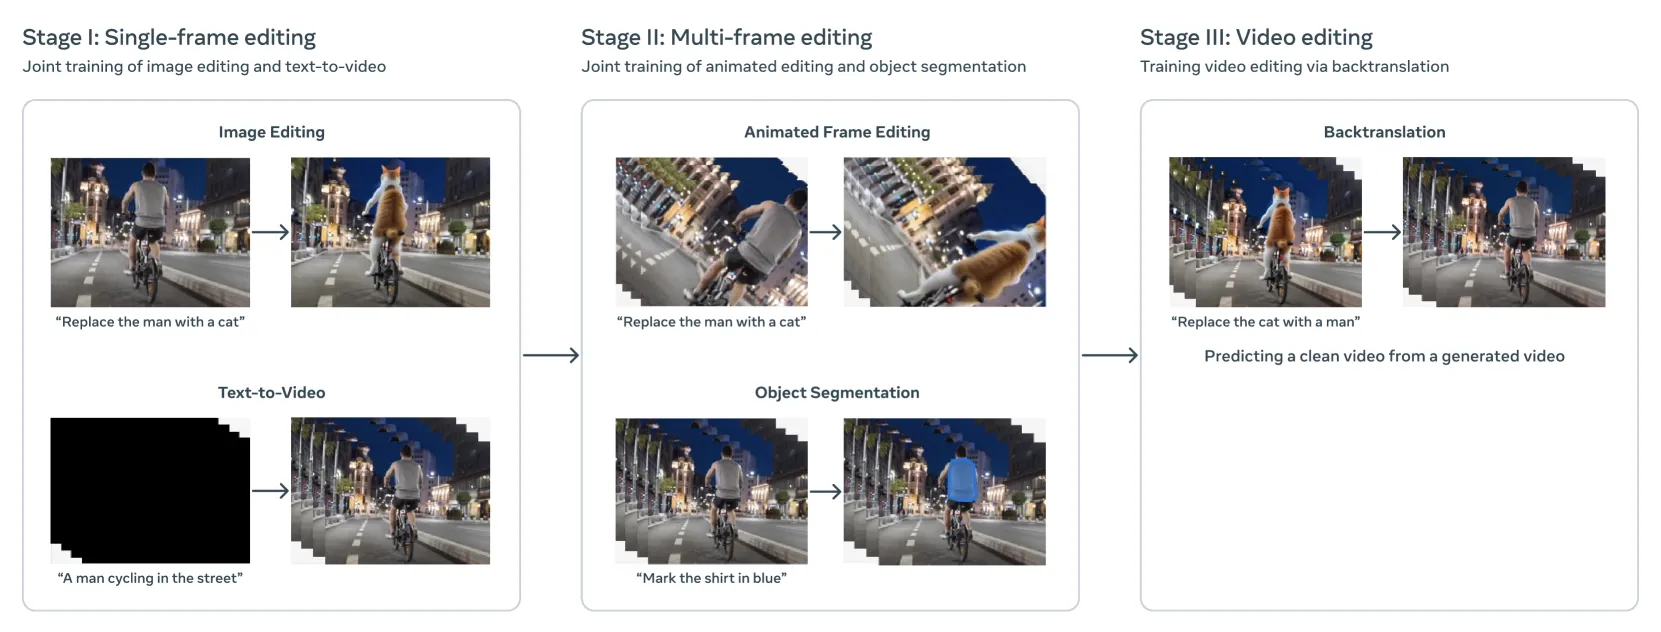
难点:大规模监督视频编辑数据难获取。创新:无需监督编辑数据的训练方法,三阶段:
- Stage I:单帧视频编辑(从图像编辑能力迁移)
- Stage II:多帧视频编辑(在合成多帧编辑对上训练)
- Stage III:Backtranslation(反向翻译)——训练模型对干净输入视频去噪,从而在多帧高质量输出视频上训练
结果:TGVE+ 基准上人类标注者 >74% 时间更偏好 Movie Gen Edit(相比先前 SOTA)。
六、联合音效与音乐生成 (Movie Gen Audio, 13B)
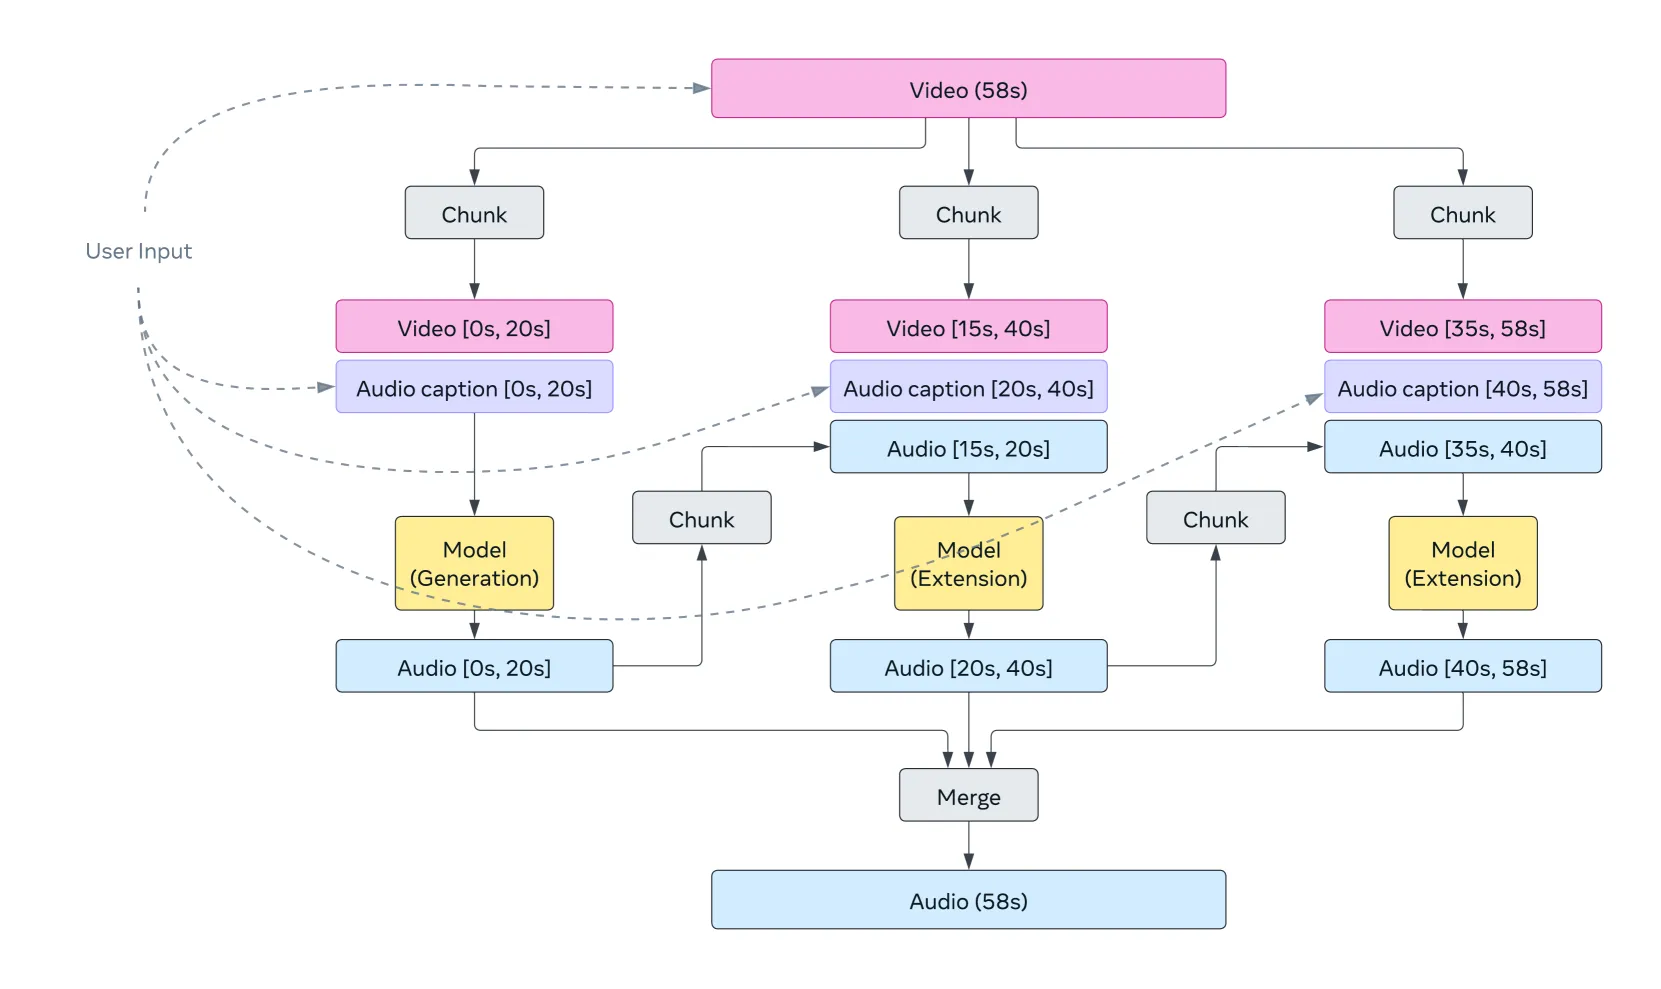
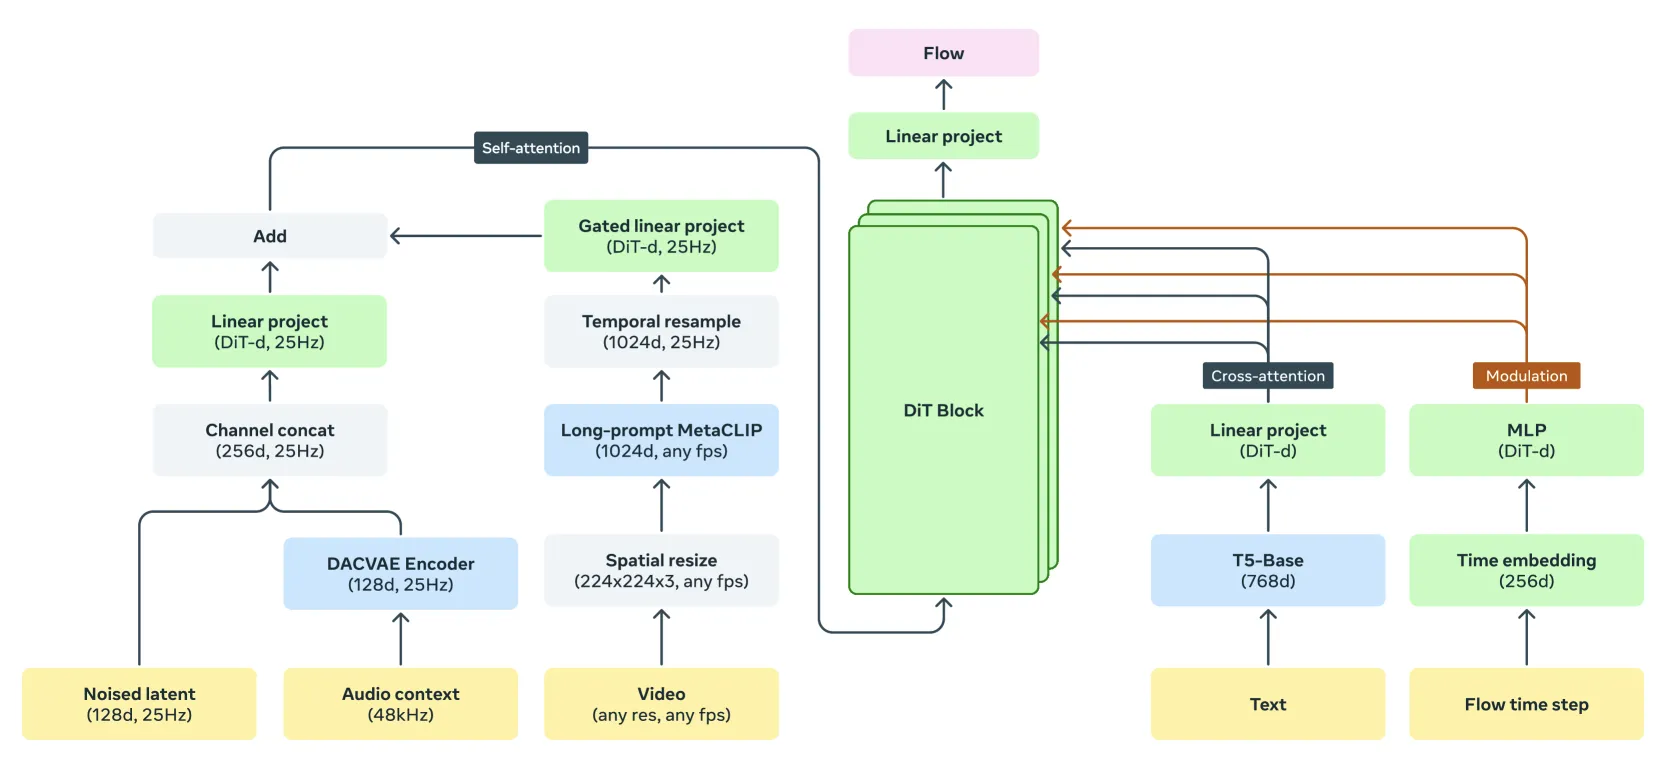
- 13B DiT,视频/文本到音频,生成 48kHz 电影级音效与音乐,与视频同步
- Flow Matching 训练
- 预训练 𝒪(1)M 小时音频
- 音频扩展 (audio extension):通过扩展技术为数分钟长视频生成连贯长音频(用户提供如 58s 视频,音频分段生成后拼接,采用 triangle window 加权融合而非均匀加权)
七、实验结果
文生视频 SOTA(表 6:Movie Gen Video 净胜率 vs 先前工作)
| 指标 | vs Runway Gen3 | vs LumaLabs | vs OpenAI Sora | vs Kling1.5 |
|---|---|---|---|---|
| Overall Quality | +35.02 | +60.58 | +8.23 | +3.87 |
| Consistency | +33.1 | +42.14 | +8.22 | +13.5 |
| Motion Naturalness | +19.27 | +29.33 | +4.43 | +0.52 |
| Motion Completeness | -1.72 | +23.59 | +8.86 | -10.04 |
| Text-alignment | +10.45 | +12.23 | +17.72 | -1.99 |
| Realness | +48.49 | +61.83 | +11.62 | +37.09 |
| Aesthetics | +38.55 | +48.19 | +6.45 | +26.88 |
(正值表示 Movie Gen 胜率更高;在 Overall Quality 上全面领先所有对比系统。)
关键消融
- 微调(表 7):Overall Quality 净胜率 +34.65%,验证高质量微调的重要性
- 验证损失与人类评估相关(图 15):损失曲线可作为人类质量评估的代理
- 视频编辑:TGVE+ 上 >74% 偏好率
八、总结
核心贡献
- Movie Gen 全家桶:30B 文生视频 + 13B 视频音频,覆盖 5 大媒体生成任务,均达 SOTA
- 简单化设计:Flow Matching + LLaMa3 风格 Transformer,便于规模化与稳定训练
- TAE + OPL:时空 8×8×8 压缩,Outlier Penalty Loss 消除 spot 伪影
- 无监督数据的视频编辑:三阶段 + backtranslation,>74% 偏好率
- 长音频生成:48kHz 同步音频 + 音频扩展技术
- 公开基准:Movie Gen Video Bench + Movie Gen Audio Bench
技术影响
- 证明”简单 Transformer + Flow Matching + 规模化”是媒体生成的强范式,与 LLM 训练技术栈对齐
- 空间上采样器解耦策略大幅降低高分辨率生成成本
- 为后续工作(如 LinGen 沿用其 TAE 与 linear-quadratic schedule)奠定基础
局限性
- 30B + 73K 上下文训练需高达 6,144 张 H100,成本极高
- 全双向注意力二次复杂度昂贵(LinGen 等后续工作针对此改进)
- Motion Completeness 部分场景弱于 Kling1.5
九、参考资源
- arXiv: https://arxiv.org/abs/2410.13720
- 基准: Movie Gen Video Bench、Movie Gen Audio Bench
- 关键技术: Flow Matching、LLaMa3 架构、UL2/ByT5/MetaCLIP 文本编码器
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 2 | Movie Gen Video 训练配方 | figure-2-training-recipe.png |
| Figure 3 | 联合图像视频生成流水线概览 | figure-3-generation-pipeline.png |
| Figure 4 | TAE 变长视频编解码 | figure-4-tae-encoding.png |
| Figure 7 | 空间上采样器概览 | figure-7-spatial-upsampler.png |
| Figure 8 | Transformer 骨干与模型并行 | figure-8-transformer-parallelism.png |
| Figure 9 | 预训练数据清洗流水线 | figure-9-data-curation.png |
| Figure 10 | linear-quadratic t-schedule | figure-10-linear-quadratic-schedule.png |
| Figure 21 | 个性化 (PT2V) 架构与推理 | figure-21-personalization-arch.png |
| Figure 25 | 扩展为视频编辑 | figure-25-video-editing.png |
| Figure 28 | Movie Gen Audio 扩展 | figure-28-audio-extension.png |
| Figure 29 | Movie Gen Audio 模型 | figure-29-audio-model.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer