Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion
通过为每个 token 分配独立噪声级别,统一自回归预测与全序列扩散,在视频生成、决策规划和机器人控制中实现稳定长序列生成和灵活引导
Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion |
| 作者 | Boyuan Chen, Diego Marti Monso, Yilun Du, Max Simchowitz, Russ Tedrake, Vincent Sitzmann |
| 机构 | MIT CSAIL, Technical University of Munich |
| 论文 | https://arxiv.org/abs/2407.01392 |
| 项目 | https://boyuan.space/diffusion-forcing |
| 发布 | 2024-07-01 (v4: 2024-12-10) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
序列建模存在两种主流范式,各有优劣:
| 范式 | 优势 | 劣势 |
|---|---|---|
| 自回归 Next-Token Prediction | 变长生成、树搜索、在线反馈控制 | 无法引导采样、连续数据易发散 |
| 全序列扩散 (Full-Seq Diffusion) | 可引导采样到高奖励轨迹、擅长连续信号 | 固定长度、非因果架构、帧间不连续 |
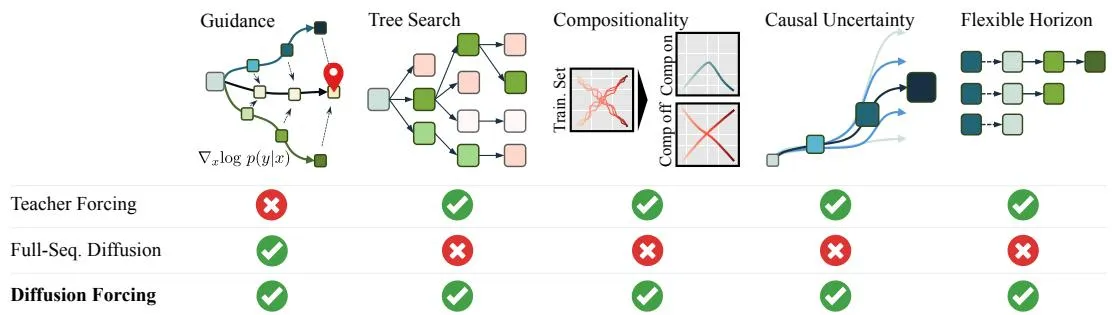
核心矛盾:将 next-token 模型直接用于全序列扩散会导致生成质量差——因为模型无法建模”早期 token 的小不确定性必然导致后期 token 的高不确定性”这一因果关系。
解决方案概述
Diffusion Forcing (DF) 是一种新的训练和采样范式:为序列中每个 token 分配独立的噪声级别,通过共享的因果 next-token 预测模型对任意长度的噪声序列进行去噪。
核心洞察:加噪是一种部分遮蔽(partial masking)——零噪声意味着 token 未被遮蔽,纯噪声意味着完全遮蔽。DF 迫使模型学习对任意噪声级别的 token 集合进行”解遮蔽”。
三、技术架构
方法总览
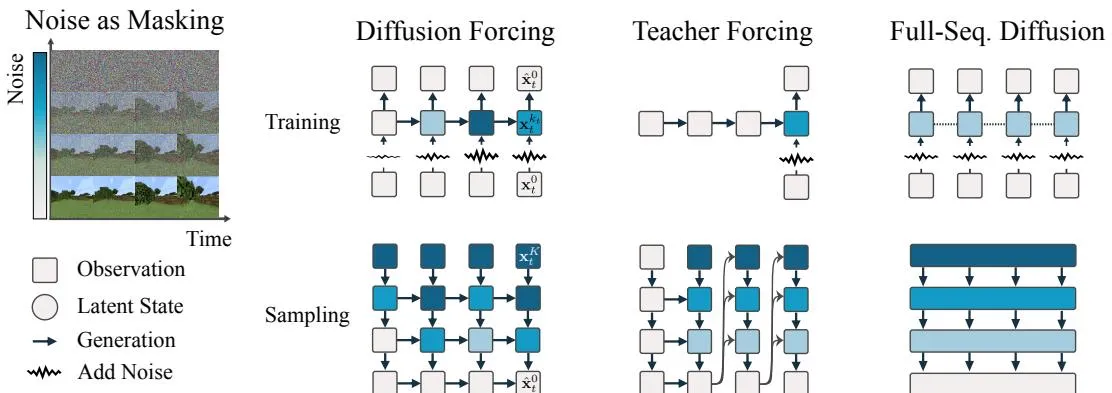
DF 对比两种传统范式:
- Teacher Forcing:从 ground-truth 序列预测单个 next token
- 全序列扩散:非因果架构对所有帧使用相同噪声级别去噪
- Diffusion Forcing:交错序列时间轴和扩散噪声轴,统一两者优势
核心公式
前向扩散过程(每个 token 独立加噪):
反向去噪过程(参数化模型):
DF 训练目标(核心损失函数):
\mathcal{L}(\theta) = \mathbb{E}_{\mathbf{z}_t \sim p_\theta(\mathbf{z}_t | \mathbf{z}_{t-1}, \mathbf{x}_t^{k_t}, k_t)} \sum_{t=1}^{T} \left[ \| \boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\mathbf{z}_{t-1}, \mathbf{x}_t^{k_t}, k_t) \| ^2 \right] \tag{3.1}
其中:
- 从 均匀采样(每个 token 独立噪声级别)
- 从训练数据采样
- 是 RNN 隐状态,捕获过去 token 的影响
理论保证(Theorem 3.1):DF 训练过程优化的是所有噪声级别序列的期望对数似然的 ELBO 的重加权版本。在适当条件下,优化 (3.1) 同时最大化所有噪声级别序列的似然下界。
采样过程
DF 采样由 噪声调度矩阵 定义:
- 列对应时间步
- 行(索引 )决定噪声级别
- 表示第 行第 列 token 的目标噪声级别
采样流程:
- 初始化所有 token 为白噪声()
- 逐行从上到下迭代,每行内从左到右去噪
- 最后一行 时所有 token 干净()
训练算法(Algorithm 1)
1: loop
2:   采样轨迹 (x_1, ..., x_T)
3:   for t = 1,...,T do
4:     采样独立噪声级别 k_t ∈ {0,1,...,K}
5:     x_t^{k_t} = ForwardDiffuse(x_t, k_t)
6:     更新隐状态 z_t ~ p_θ(z_t | z_{t-1}, x_t^{k_t}, k_t)
7:     计算噪声 ε_t = ε_θ(z_{t-1}, x_t^{k_t}, k_t)
8:   end for
9:   L = MSE Loss([ε_1,...,ε_T], [ε_1,...,ε_T])
10:  反向传播更新 θ
11: end loop
采样算法(Algorithm 2)
1: 输入: 模型 θ, 调度矩阵 K, 初始隐状态 z_0, 引导代价 c(·)
2: 初始化 x_1,...,x_T ~ N(0, σ_K² I)
3: for m = M-1,...,0 do        # 逐行去噪
4:   for t = 1,...,T do        # 行内从左到右
5:     z_t^new ~ p_θ(z_t | z_{t-1}, x_t, K_{m+1,t})
6:     k ← K_{m,t}, w ~ N(0, I)
7:     x_t^new ← 1/√α_k (x_t - (1-α_k)/√(1-α̅_k) ε_θ(z_t^new, x_t, k)) + σ_k w
8:     更新 z_t ← z_t^new
9:   end for
10:  x_{1:H} ← AddGuidance(x_{1:H}, ∇_x log c(x_{1:H}))
11: end for
12: 返回 x_{1:T}
模型实现
- 架构:卷积 RNN(实验中使用),理论上也可用 masked Transformer
- 隐状态: 通过循环层演化,捕获过去 token 的信息
- 输入:前一隐状态 + 当前噪声 token + 噪声级别
- 输出:预测噪声 ,通过仿射重参数化得到去噪结果
四、核心创新
创新 1:稳定自回归生成
传统自回归模型在连续数据(如视频)上生成超过训练长度时会发散。DF 通过以下方式稳定生成:
- 用略带噪声的 token()更新隐状态
- 避免了”完全确定的历史 + 完全未知的未来”的极端情况
- 实验表明可稳定生成超过训练长度 2-5 倍的序列
创新 2:因果不确定性建模
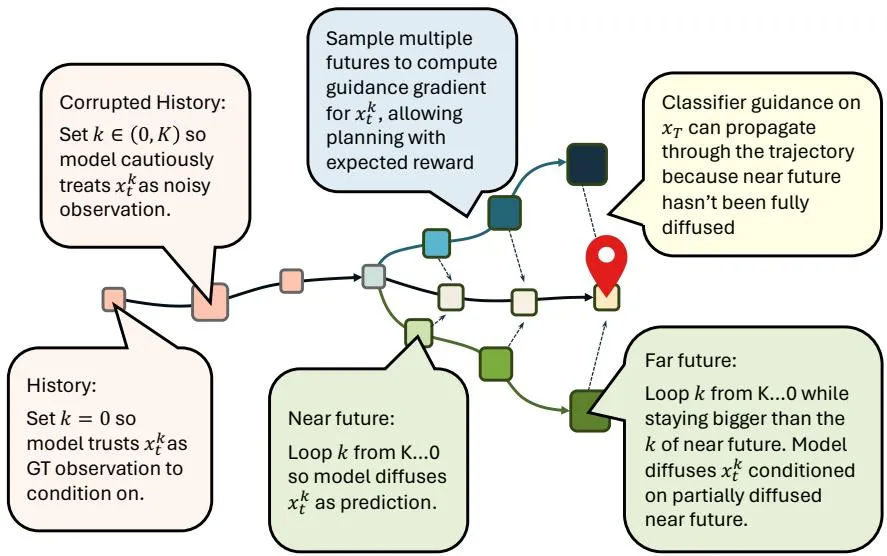
DF 通过噪声级别编码因果不确定性:
- 近未来:低噪声(更确定)
- 远未来:高噪声(更不确定)
“之字形”采样方案:
创新 3:蒙特卡洛引导 (MCG)
DF 允许通过多次采样未来轨迹并平均引导梯度来影响当前 token 的生成:
- 对同一未来进行多次采样
- 平均各次采样的引导梯度
- 效果类似于 MPPI(Model Predictive Path Integral)控制
- 结合因果不确定性建模效果更佳
创新 4:灵活序列决策框架
DF 同时作为策略(policy)和规划器(planner):
| 功能 | 实现方式 |
|---|---|
| 策略 | 短前瞻窗口 ,低延迟在线决策 |
| 规划器 | 长前瞻窗口 + 引导,离线长程规划 |
| 灵活切换 | 无需重训或修改架构 |
Token 定义:(动作 + 奖励 + 观测)
五、实验结果
视频生成
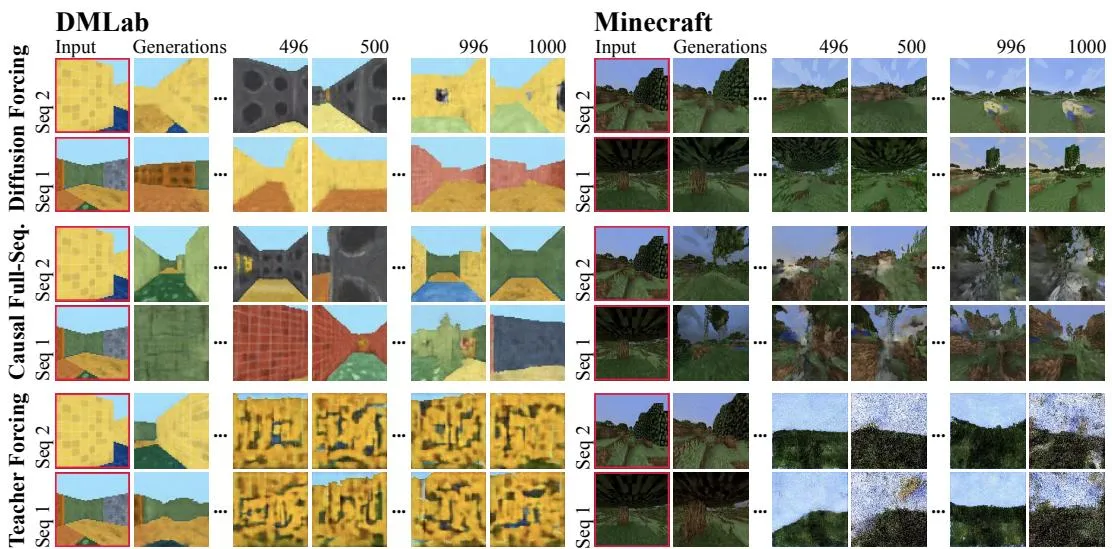
在 Minecraft 和 DMLab 数据集上:
- DF:稳定生成超过训练长度(1000+ 帧),时间一致性好
- Teacher Forcing:快速发散
- 因果全序列扩散:帧间不连续,视频跳跃
规划任务(D4RL Maze2D)
| 环境 | MPPI | CQL | IQL | Diffuser* | Diffuser (执行动作) | Ours w/o MCG | Ours |
|---|---|---|---|---|---|---|---|
| U-Maze | 33.2 | 5.7 | 47.4 | 113.9±3.1 | 6.3±2.1 | 110.1±3.9 | 116.7±2.0 |
| Medium | 10.2 | 5.0 | 34.9 | 121.5±2.7 | 13.5±2.3 | 136.1±10.2 | 149.4±7.5 |
| Large | 5.1 | 12.5 | 58.6 | 123.0±6.4 | 6.3±2.1 | 142.8±5.6 | 159.0±2.7 |
| 单任务平均 | 16.2 | 7.7 | 47.0 | 119.5 | 8.7 | 129.67 | 141.7 |
| Multi U-Maze | 41.2 | - | 24.8 | 128.9±1.8 | 32.8±1.7 | 107.7±4.9 | 119.1±4.0 |
| Multi Medium | 15.4 | - | 12.1 | 127.2±3.4 | 22.0±2.7 | 145.6±6.5 | 152.3±9.9 |
| Multi Large | 8.0 | - | 13.9 | 132.1±5.8 | 6.9±1.7 | 129.8±1.5 | 167.1±2.7 |
| 多任务平均 | 21.5 | - | 16.9 | 129.4 | 20.6 | 127.7 | 146.2 |
关键发现:
- Diffuser 直接执行生成的动作时性能急剧下降(需手写 PD 控制器)
- DF 的原始动作生成自洽,甚至优于 Diffuser 状态预测 + PD 控制器
- MCG 引导带来显著性能提升
机器人任务
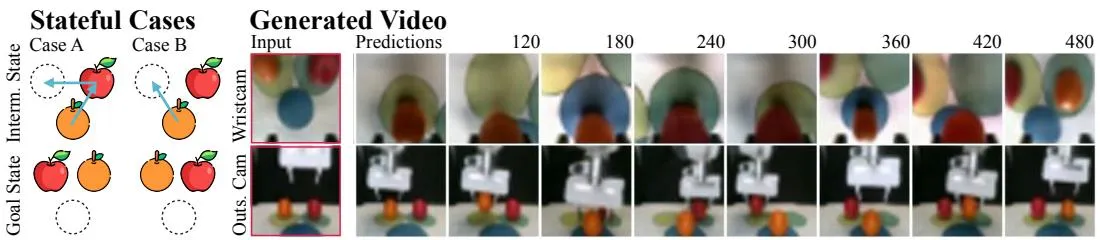
任务:机械臂交换两个水果的位置(需要记忆初始配置)
| 方法 | 成功率 |
|---|---|
| Diffusion Policy(无记忆) | 0%(失败) |
| DF(正常观测) | 80% |
| DF(视觉干扰/遮挡) | 76% |
| Next-frame diffusion(扰动观测) | 48% |
DF 通过隐状态自然融入记忆,且对噪声/缺失观测鲁棒。
时间序列预测
在 Electricity 数据集上的预测区间:
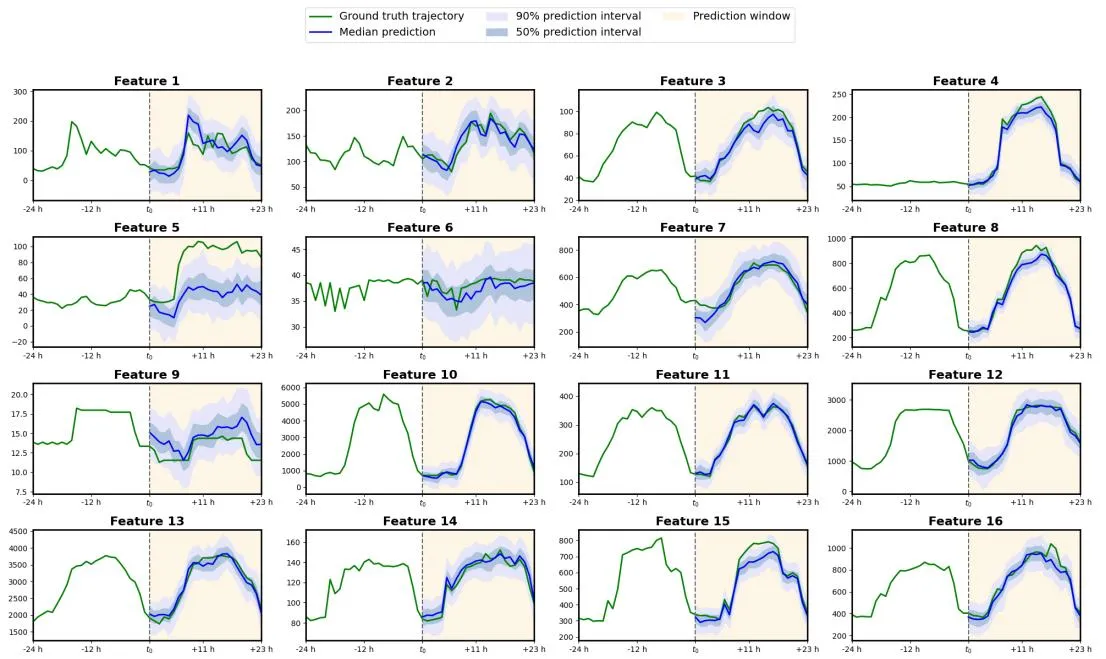
DF 在多变量时间序列预测上与 prior diffusion 和 transformer 方法具有竞争力。
六、核心创新总结
| 创新点 | 说明 | 关键优势 |
|---|---|---|
| 独立噪声级别 | 每个 token 独立噪声,统一自回归与扩散 | 结合两者优势 |
| 因果不确定性 | 近未来低噪声、远未来高噪声 | 有效长程引导 |
| 蒙特卡洛引导 | 多次采样未来平均引导梯度 | 显著提升规划性能 |
| 灵活决策框架 | 同时作为策略和规划器 | 无需重训切换 |
| 稳定长序列生成 | 超越训练长度 2-5 倍不发散 | 视频/连续信号生成 |
| 理论保证 | 优化所有子序列似然的 ELBO | 数学基础扎实 |
七、技术影响
对序列建模的指导
- 统一范式:DF 证明自回归和扩散可以统一,而非二选一
- 噪声即遮蔽:为理解扩散模型提供了新视角——加噪是部分遮蔽的一种形式
- 因果+扩散:因果架构与扩散的结合可产生新能力(如 MCG)
应用前景
- 视频生成:稳定长视频生成,避免滑动窗口
- 机器人控制:带记忆的模仿学习,对噪声鲁棒
- 决策规划:灵活的在线/离线规划切换
- 时间序列:通用序列建模
局限性
- 架构限制:当前基于 RNN,高分辨率视频需要更大的 Transformer
- 规模验证:未在互联网规模数据集上验证 scaling 行为
- 计算成本:多次采样未来用于 MCG 增加推理开销
- 训练复杂度:独立噪声级别采样增加了训练的随机性
八、参考资源
论文
相关工作
- Diffuser (Janner et al., ICML 2022): 全序列扩散规划
- Diffusion Policy (Chi et al., 2024): 扩散策略模仿学习
- AR-Diffusion (Wu et al., NeurIPS 2023): 自回归文本扩散
- DDPM (Ho et al., NeurIPS 2020): 去噪扩散概率模型
- MPPI (Williams et al., 2015): 模型预测路径积分控制