Latte: Latent Diffusion Transformer for Video Generation
首个系统性研究 Transformer 骨干用于潜空间视频扩散的工作。提出 4 种时空解耦的 Latte 变体,并通过大量消融确定视频生成的最佳实践(uniform patch embedding、S-AdaLN、绝对位置编码、图像-视频联合训练),在 4 个标准视频生成基准上达到 SOTA,并扩展到文生视频。
Latte:面向视频生成的潜空间扩散 Transformer
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Latte: Latent Diffusion Transformer for Video Generation |
| 作者 | Xin Ma, Yaohui Wang, Xinyuan Chen, Gengyu Jia, Ziwei Liu, Yuan-Fang Li, Cunjian Chen, Yu Qiao |
| 机构 | Monash University(莫纳什大学)、Shanghai AI Laboratory(上海人工智能实验室)、南京邮电大学、NTU S-Lab |
| 论文 | https://arxiv.org/abs/2401.03048 |
| 项目主页 | https://maxin-cn.github.io/latte_project/ |
| 代码 | https://github.com/Vchitect/Latte |
| 发布 | 2024-01(TMLR 收录) |
| 领域 | 视频生成、扩散模型、Diffusion Transformer |
一句话概括
Latte 是首个系统性研究「用 Transformer 作为骨干」的潜空间视频扩散模型。它先用预训练 VAE 把视频逐帧压到潜空间、抽取时空 token,再用一系列 Transformer block 建模视频分布。由于视频 token 数量巨大,作者从解耦时空维度的角度设计了 4 种高效变体;并通过严谨的消融确定了一套「最佳实践」(patch embedding 方式、变体选择、时间步/类别信息注入、时间位置编码、学习策略)。在 FaceForensics、SkyTimelapse、UCF101、Taichi-HD 四个标准视频生成基准上全面取得 SOTA,还成功扩展到文生视频(T2V)。Latte 是后来 Sora 类 DiT 视频模型的重要先驱工作之一。
二、核心思想
问题定义
扩散模型在图像生成上非常成功,但高质量视频生成仍极具挑战:视频具有复杂、高维的时空信息(高分辨率帧 + 时序)。此前视频扩散普遍以 U-Net(CNN) 为骨干,而 DiT / U-ViT 已证明在图像生成中 U-Net 的归纳偏置并非必需、Transformer 骨干反而性能更好。由此提出核心问题:
基于 Transformer 的潜空间扩散模型能否提升真实视频的生成质量?
关键难点在于:视频抽取的 token 数量 非常庞大,若直接用标准 Transformer 做全时空注意力,计算量无法承受,必须高效地解耦时空维度。
解决方案概述
- Latte 架构:VAE 逐帧编码 → 抽取时空 token → Transformer 骨干建模 → 线性解码器预测噪声与协方差。用 联合训练。
- 4 种时空解耦变体:从「Transformer block 分解」与「多头注意力分解」两个角度设计,探索时空模块解耦程度对视频生成的影响。
- 最佳实践:通过消融确定 5 个设计维度的最优选择,使 Latte 生成时序连贯的高保真视频。
三、技术架构
3.1 潜空间扩散模型基础(LDM)
LDM 在潜空间而非像素空间做扩散,用预训练 VAE 编码器 把样本 压成潜码 。
扩散过程(逐步加高斯噪声):
去噪过程(学习逆扩散预测 ):,其变分下界为:
简单训练目标(预测噪声):
为学习协方差 ,还需优化完整 项,即 ; 同样由 实现。
3.2 Latte 架构与四种模型变体
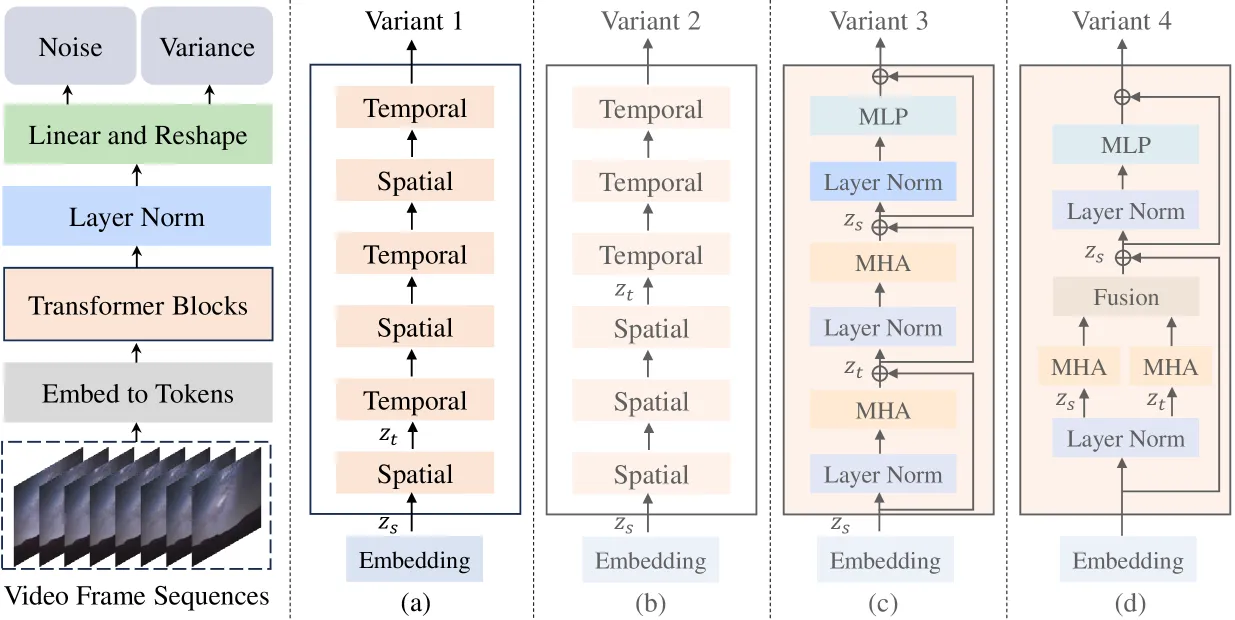
给定潜空间视频片段 ,先转成 token 序列 ,加时空位置编码 得 。核心是两种 reshape:
- 空间输入 (,每个时间索引的 token 数)
- 时间输入
| 变体 | 解耦方式 | 说明 | FLOPs(G) |
|---|---|---|---|
| Variant 1(最佳) | Block 级 · 交错融合 | 空间 Transformer block 与时间 Transformer block 交替堆叠,逐层交错捕获时空信息 | 5572.69 |
| Variant 2 | Block 级 · 后融合 | 前半段全部做空间 block、后半段全部做时间 block(late fusion) | 5572.69 |
| Variant 3 | 注意力级 · 串行 | 单个 block 内先做空间自注意力、再做时间自注意力(源自 TimeSformer) | 6153.15 |
| Variant 4 | 注意力级 · 并行 | 把多头注意力一半头做空间、一半头做时间,两路结果 reshape 后相加 | 1545.15 |
- 参数量:Variant 1/2 均为 673.68M,Variant 3 为 676.33M,Variant 4 为 676.44M(Variant 4 FLOPs 仅约其他的 1/4)。
- 骨干后接标准线性解码器 + reshape,输出预测噪声与协方差,形状与 相同。
3.3 架构设计的最佳实践
3.3.1 潜空间视频片段 Patch Embedding
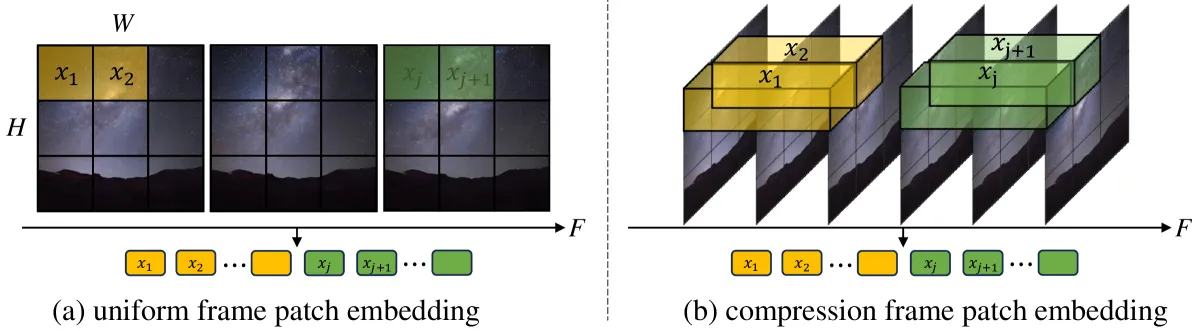
- Uniform frame patch embedding(均匀帧):对每帧独立套用 ViT 的 2D patch,。
- Compression frame patch embedding(压缩帧):把 ViT patch 扩到 3D,沿时间维以步长 抽 tube,,天然融入时空信息;解码时需额外接 3D 转置卷积做时间上采样。
消融结论:Uniform 显著优于 Compression(与视频理解模型 ViViT 结论相反)——推测压缩帧会丢失时空信号,使骨干难以学到视频分布。
3.3.2 时间步/类别信息注入
两种方式:
- All tokens:把时间步/类别 当作额外 token 拼到输入。
- S-AdaLN(可扩展自适应层归一化):由 线性回归出 ,;并回归 作用于残差连接前:。
消融结论:S-AdaLN 明显优于 all tokens 且收敛更快——all tokens 只在输入层引入 ,难以有效传播;S-AdaLN 在每个 block 自适应注入。
3.3.3 时间位置编码
- 绝对位置编码:正余弦函数(Transformer 原版)。
- 相对位置编码:RoPE(旋转位置编码)。
消融结论:绝对位置编码略优。由于 Latte 不需生成变时长/多分辨率视频(RoPE 的强项),最终选用绝对位置编码。
3.3.4 学习策略
(1) 用预训练模型初始化:从 ImageNet 上预训练的 DiT 初始化 Latte。处理参数不兼容:
- 位置编码:把 DiT 的 沿时间复制 份成 。
- 标签嵌入:视频数据集类别数与 ImageNet(1000) 不符,直接丢弃 DiT 的标签嵌入并零初始化。
消融结论(Fig.5d):ImageNet 预训练早期收敛快,但后期性能停滞、远差于随机初始化。原因:ImageNet 与 FaceForensics 数据分布差异大,小数据集上域差距超过迁移收益。但对大规模、通用任务(如 T2V),预训练收益更显著。
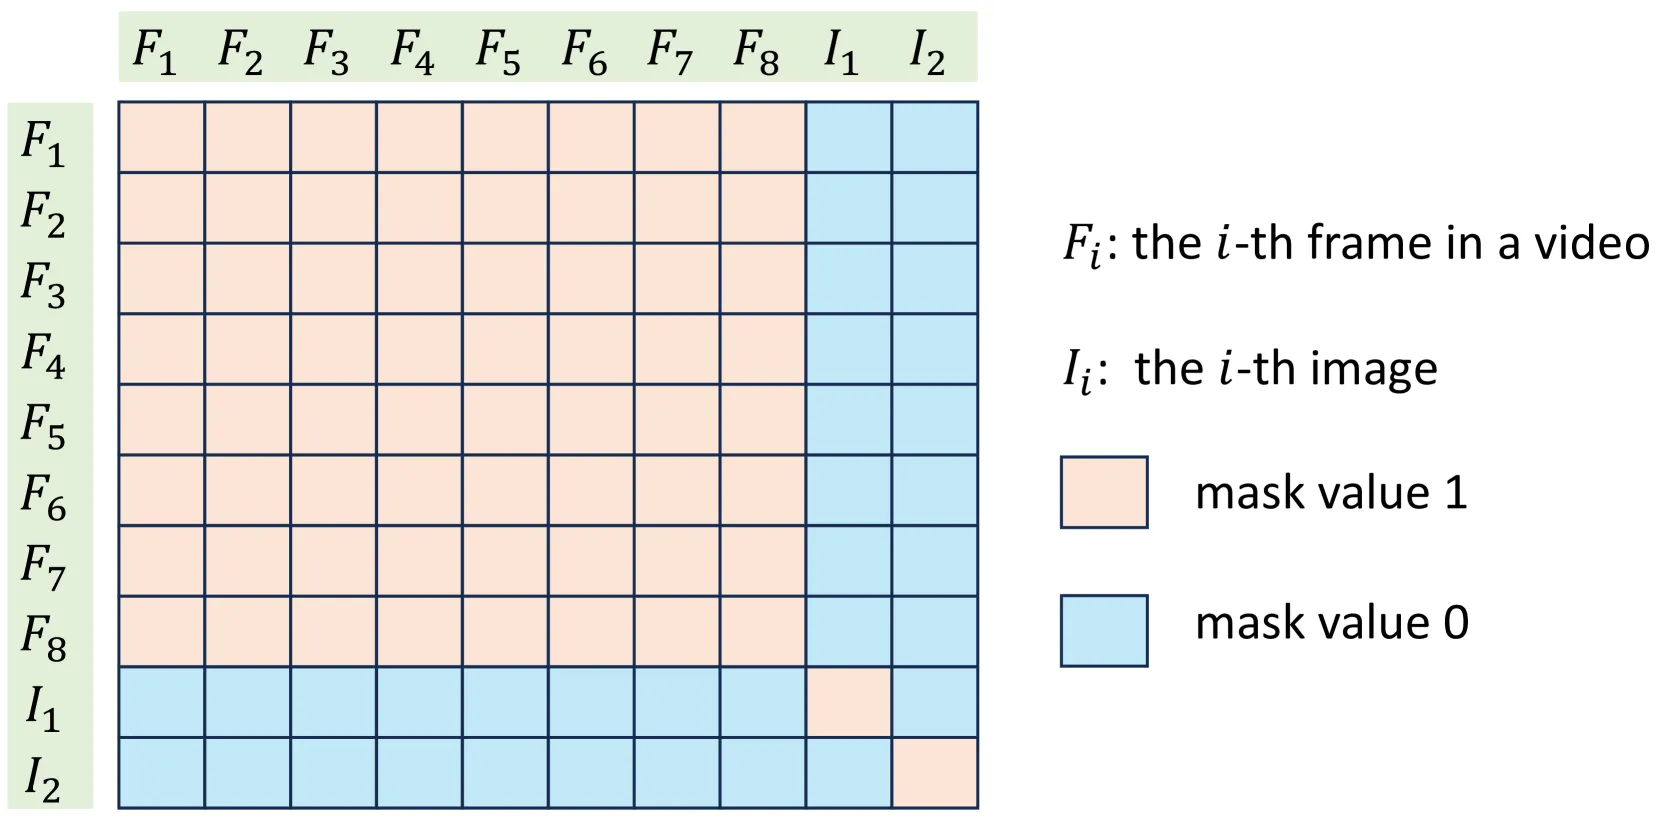
(2) 图像-视频联合训练:在视频片段末尾追加同数据集随机采样的独立帧。为保证生成连续视频,提出时间掩码矩阵 :
- Only Video:仅视频内容 token 参与时间模块建模(图像只优化空间模块)→ 效果次优。
- Temporal Mask(本文):让图像也优化时间模块,同时保持视频连续性。
UCF101 zero-shot:Only Video 的 FVD/FID 为 705.72 / 75.98;Temporal Mask 为 589.86 / 63.36,明显更优。
训练细节
| 项目 | 配置 |
|---|---|
| 优化器 | AdamW,恒定学习率 |
| 数据增强 | 仅水平翻转 |
| EMA | 衰减率 0.9999,结果取 EMA 模型 |
| VAE | 来自 Stable Diffusion 1.4 的预训练 VAE |
| 硬件 | 8× NVIDIA A100 (80G) |
| 训练片段 | 16 帧,分辨率 256×256,采样间隔 3 |
模型规模(follow ViT/DiT 配置):
| 模型 | 层数 N | 维度 D | 头数 H | 参数 |
|---|---|---|---|---|
| Latte-S | 12 | 384 | 6 | 32.48M |
| Latte-B | 12 | 768 | 12 | 129.54M |
| Latte-L | 24 | 1024 | 16 | 456.81M |
| Latte-XL | 28 | 1152 | 16 | 673.68M |
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 首个系统化的视频 DiT 研究 | 系统分析不同 Transformer 骨干与最佳实践对视频生成的影响,此前 VDT/GenTron/W.A.L.T 未做此分析 | §3.2/§3.3 全面消融 |
| 4 种时空解耦变体 + 深度分析 | 从 block 级与注意力级两个角度设计,并首次解释「解耦程度」如何影响视频生成、为何 Variant 1 最优 | Fig.6/8 帧间余弦相似度分析 |
| S-AdaLN | 在 AdaLN 基础上额外回归 作用于残差前,逐 block 自适应注入时间步/类别 | 优于 all tokens 且收敛更快 |
| Temporal Mask 联合训练 | 让追加图像帧也能优化时间模块,兼顾多样性与时序连贯 | FVD 705→589、FID 76→63 |
| T2V 扩展 | 用 PixArt-α 权重初始化空间 block,在 Vimeo25M 训练 | VBench 与 SOTA T2V 可比 |
为何 Variant 1 最佳(关键分析)
- 过多连续空间注意力会破坏时序连贯(Variant 2):Fig.6 显示随空间注意力堆叠,帧间余弦相似度均值持续下降、方差增大,出现「倒置关系」(第 1 帧与第 2 帧相似度反而低于第 1 帧与第 5 帧),说明时空信息未有效解耦。
- 并行结构直接融合会破坏时序(Variant 4):Fig.8 显示空间注意力与时间注意力输出的帧间相似度分布差异极大、互相似度极低,直接相加严重扰乱时序。
- Variant 3 耦合度过高:空间注意力特征只经 LayerNorm 就送入时间注意力,归一化不足以适配。
- Variant 1 交错融合恰到好处:完整 Transformer block(含 MHA+LN+MLP)比只用 MHA(Variant 3)更能建模时序 → 性能最佳。
五、实验结果
数据集:FaceForensics、SkyTimelapse、UCF101、Taichi-HD(16 帧、256×256)。 指标:FVD(主)、FID、IS(仅 UCF101)。
5.1 主结果:FVD(越低越好,Table 3)
| 方法 | FaceForensics | SkyTimelapse | UCF101 | Taichi-HD |
|---|---|---|---|---|
| StyleGAN-V | 47.41 | 79.52 | 1431.0 | - |
| PVDM | 355.92 | 55.41 | 343.6 | 540.2 |
| LVDM | - | 95.20 | 372.0 | 99.0 |
| VDT | - | - | 225.7 | - |
| W.A.L.T | - | - | 258.1 | - |
| Latte | 34.00 | 59.82 | 477.97 | 159.60 |
| Latte+IMG | 27.08 | 42.67 | 202.23 | 97.09 |
图像-视频联合训练(+IMG)带来大幅提升,全面刷新 SOTA。
5.2 帧质量:IS↑ / FID↓(Table 5)
| 方法 | IS (UCF101)↑ | FID (FaceForensics)↓ |
|---|---|---|
| PVDM | 60.55 | 29.76 |
| Latte | 68.53 | 5.02 |
| Latte+IMG | 73.31 | 3.87 |
5.3 消融实验(FaceForensics,FVD)
| 维度 | 对比 | 结论 |
|---|---|---|
| Patch embedding | Uniform vs Compression | Uniform 更优 |
| 信息注入 | S-AdaLN vs All tokens | S-AdaLN 显著更优、收敛更快 |
| 时间位置编码 | 绝对 vs RoPE | 绝对略优 |
| ImageNet 预训练 | 有 vs 随机 | 早期快、后期停滞(小数据集不划算) |
| 采样间隔 | 不同 rate | 长期趋同,选间隔 3 |
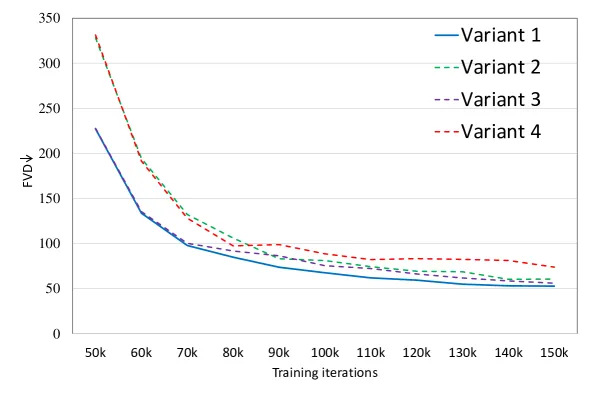
| 模型变体 | V1–V4 | Variant 1 最佳 |
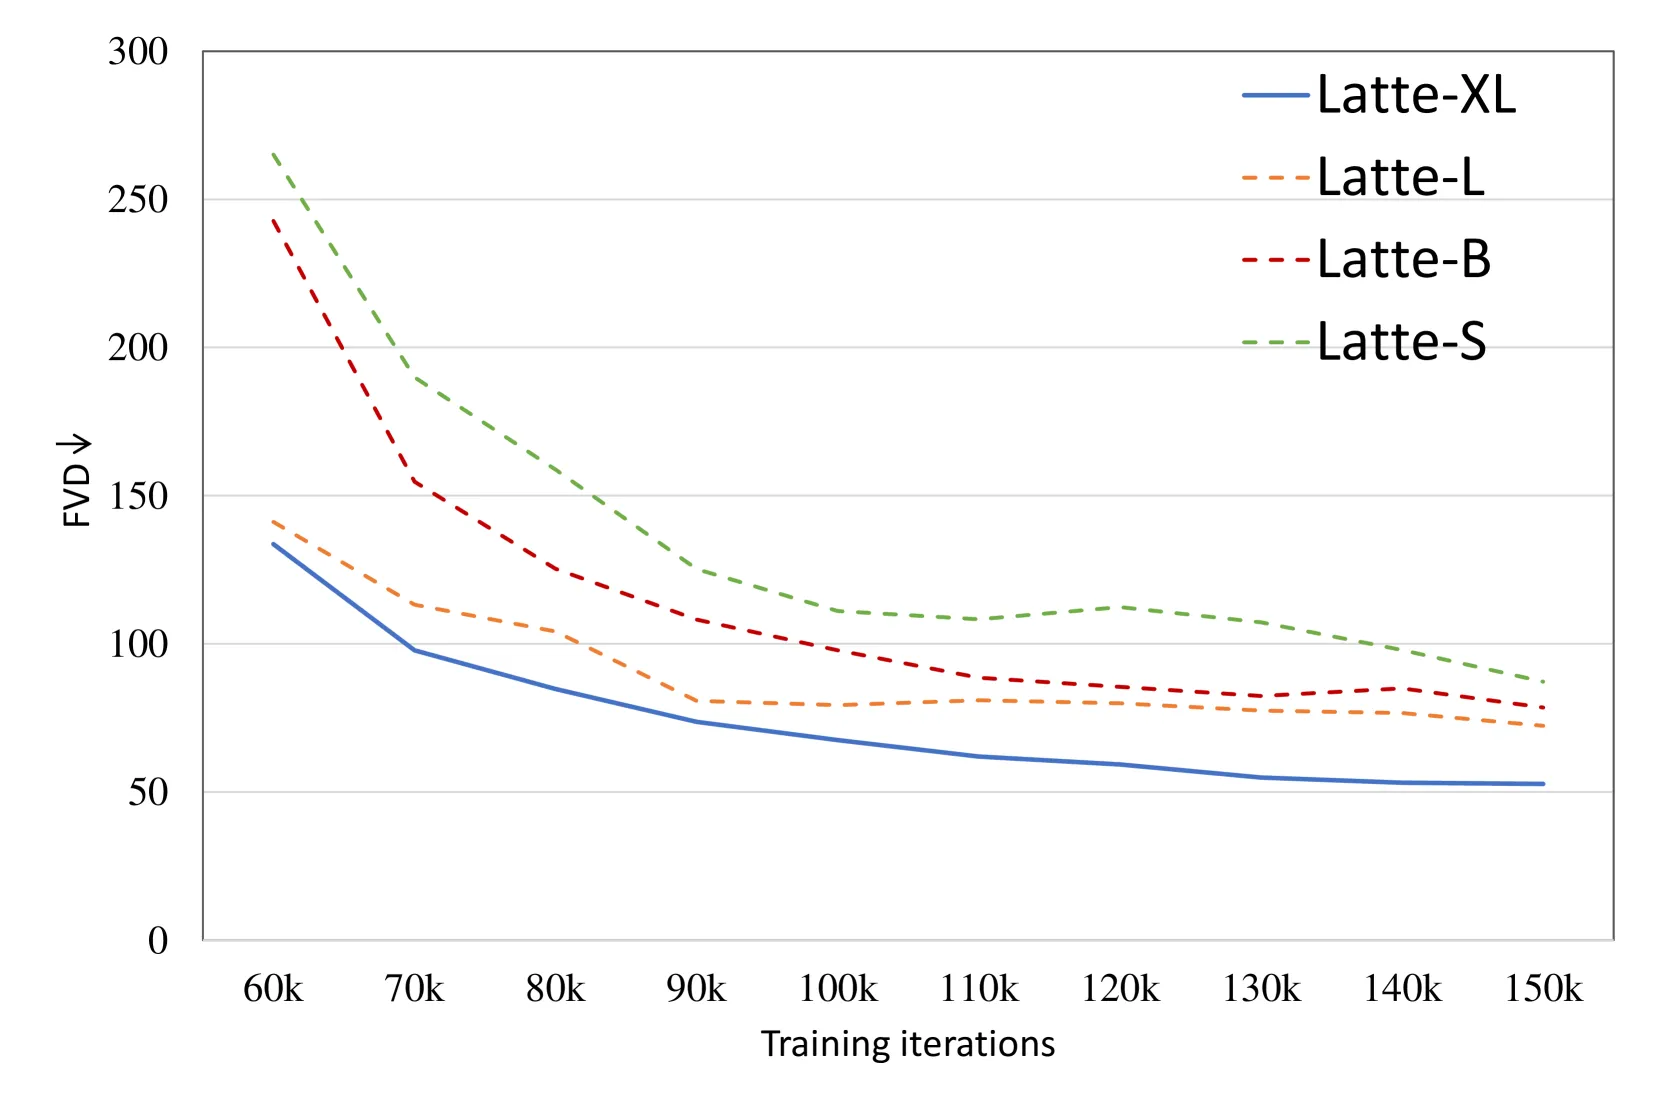
模型规模(Fig.7):XL > L > B > S,增大模型规模显著提升性能(与图像生成 DiT 结论一致)。
最佳实践总结:Variant 1 + Uniform patch embedding + S-AdaLN + 绝对位置编码 + 图像-视频联合训练。
5.4 文生视频扩展(VBench,Table 4)
用 PixArt-α(512×512)权重初始化空间 block,在 Vimeo25M 训练。与 ModelScope、VideoCrafter、CogVideo、HiGen、OpenSoraPlan 对比,Latte 在多个 VBench 维度(如 Human Action 85.31%、Multiple Object 34.53%、Overall Consistency 27.33%)取得可比甚至领先的成绩。
六、相关工作
- 视频生成三条路线:GAN 类(易 mode collapse)、自回归类(质量好但算力高)、扩散类(近年主流)。
- 并发/相关的 Transformer 视频扩散:VDT、GenTron、W.A.L.T(架构类似 Latte 的 Variant 3)、Open-Sora Plan、HunyuanVideo、Pyramidal Flow、Cosmos 等。Latte 的差异在于系统性分析不同 Transformer 骨干与最佳实践(详见附录 A.3)。
- DiT / U-ViT:证明 U-Net 归纳偏置对 LDM 非必需,是 Latte 采用纯 Transformer 骨干的直接动机。
七、总结
核心贡献
- Latte 架构:首个以视频 Transformer 为骨干的潜空间扩散模型,含 4 种高效时空解耦变体及其设计洞见。
- 最佳实践:系统消融确定 patch embedding、变体、信息注入、位置编码、学习策略五维度的最优选择。
- SOTA 性能:四个标准视频基准全面领先,T2V 扩展与当前 SOTA 可比。
技术影响
- 为「把 Transformer 骨干引入视频(及其他模态)扩散模型」提供了系统性参考,是 Sora 类 DiT 视频生成模型的重要先驱。
- Variant 1(交错时空注意力)成为后续众多视频 DiT 的常见范式。
局限性
- 训练片段固定 16 帧、256×256,未探索长视频/高分辨率/变时长生成(也是选绝对位置编码而非 RoPE 的原因)。
- ImageNet 预训练在专用小数据集上收益有限(域差距问题)。
- Variant 4 虽 FLOPs 最低(约 1/4)但性能最差,效率-质量权衡上尚无理想解。
八、参考资源
- 论文:https://arxiv.org/abs/2401.03048
- PDF:https://arxiv.org/pdf/2401.03048
- 项目主页:https://maxin-cn.github.io/latte_project/
- 代码:https://github.com/Vchitect/Latte
- 相关:DiT、U-ViT、PixArt-α、Stable Diffusion 1.4 VAE、VBench、TimeSformer
附录:论文图表索引
| 图 | 文件 | 说明 |
|---|---|---|
| Figure 2 | architecture-variants.png | Latte 架构与四种时空解耦变体 |
| Figure 3 | patch-embedding.png | Uniform vs Compression patch embedding |
| Figure 4 | temporal-mask.png | Temporal Mask 联合训练策略 |
| Figure 5a | ablation-patch-embedding.png | 消融:patch embedding |
| Figure 5b | ablation-timestep-injection.png | 消融:时间步/类别注入 |
| Figure 5c | ablation-temporal-pe.png | 消融:时间位置编码 |
| Figure 5d | ablation-imagenet-pretrain.png | 消融:ImageNet 预训练 |
| Figure 5e | ablation-sampling-interval.png | 消融:视频采样间隔 |
| Figure 5f | ablation-model-variants.png | 消融:四种模型变体 |
| Figure 7 | model-size-scaling.png | 不同规模 Latte 性能缩放 |


