Video LDM: 高分辨率视频合成的隐扩散模型
Video LDM (Align your Latents) 将 LDM 范式扩展到高分辨率视频生成——先在图像上预训练,再冻结空间层、插入并只训练时序对齐层(时序注意力 + 3D 卷积),把图像生成器转为视频生成器;同时时序微调解码器与超分模型,将 Stable Diffusion 变为最高 1280×2048 的文生视频模型,并首次实现个性化文生视频。
Align your Latents: High-Resolution Video Synthesis with Latent Diffusion Models (Video LDM)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Align your Latents: High-Resolution Video Synthesis with Latent Diffusion Models |
| 作者 | Andreas Blattmann, Robin Rombach, Huan Ling, Tim Dockhorn, Seung Wook Kim, Sanja Fidler, Karsten Kreis |
| 机构 | NVIDIA、LMU Munich、University of Toronto、Vector Institute |
| 论文 | https://arxiv.org/abs/2304.08818 (CVPR 2023) |
| 发布 | 2023-04-18 |
| 分类 | cs.CV |
| 项目页 | https://research.nvidia.com/labs/toronto-ai/VideoLDM/ |
摘要
隐扩散模型(LDM)通过在压缩的低维隐空间训练扩散模型,实现高质量图像合成同时避免过高算力需求。本文将 LDM 范式应用于高分辨率视频生成这一尤其耗资源的任务:先仅用图像预训练 LDM;然后通过向隐空间扩散模型引入时序维度并在编码后的图像序列(即视频)上微调,把图像生成器转为视频生成器。类似地时序对齐扩散上采样器,将其变为时序一致的视频超分模型。
聚焦两个实际应用:(i) 真实驾驶数据模拟;(ii) 文生视频创意内容生成。在 512×1024 真实驾驶视频上验证达 SOTA。方法可轻松利用现成预训练图像 LDM——此时只需训练时序对齐模型,从而将公开的 SOTA 文生图 LDM Stable Diffusion 转为高效的文生视频模型(分辨率高达 1280×2048)。所训练的时序层可泛化到不同微调的文生图 LDM,据此首次展示个性化文生视频。
历史意义:Video LDM 是视频扩散模型的奠基性工作之一,提出的”冻结空间层 + 训练时序层”范式被后续绝大多数视频生成模型(Stable Video Diffusion、AnimateDiff 等)继承。
二、核心思想
问题定义
视频建模远落后于图像——主因是视频数据训练的巨大算力开销与缺乏大规模公开视频数据集。此前视频扩散模型多只能生成低分辨率、短时视频。本文目标:生成高分辨率、长时视频。
解决方案概述
关键洞察:复用预训练、固定的图像生成模型,通过插入时序层将其转为视频生成器。
- 图像预训练:仅在图像上预训练 LDM(或直接用现成图像 LDM),利用大规模图像数据集
- 时序层对齐:向隐空间 DM 引入时序维度,冻结预训练空间层,只在编码后的视频上训练时序层
- 解码器时序微调:微调 LDM 解码器达到像素空间时序一致
- 超分时序对齐:时序对齐像素/隐空间上采样器,转为时序一致的视频超分
优势:可用海量图像数据预训练空间层,而稀缺的视频数据仅用于聚焦训练时序层;超分器只需局部操作,训练/算力开销低。
三、技术架构
3.1 背景:扩散模型与 LDM
去噪分数匹配目标(式1):给定 ,构造扩散输入 ,训练去噪器 :
目标 为随机噪声 或 v-prediction (后者收敛更快,本文两者都用)。采用 与方差保持 noise schedule。
LDM:先训练压缩自编码器 ,在压缩隐空间 上训练 DM,参数量与内存远低于像素空间 DM。
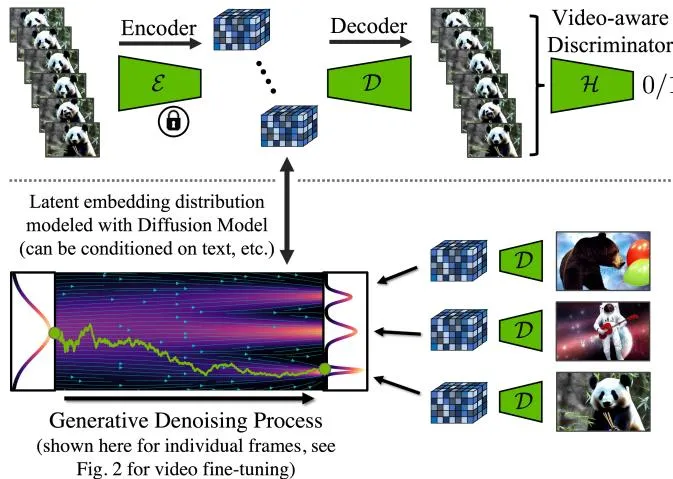
3.2 将图像 LDM 转为视频生成器(核心)
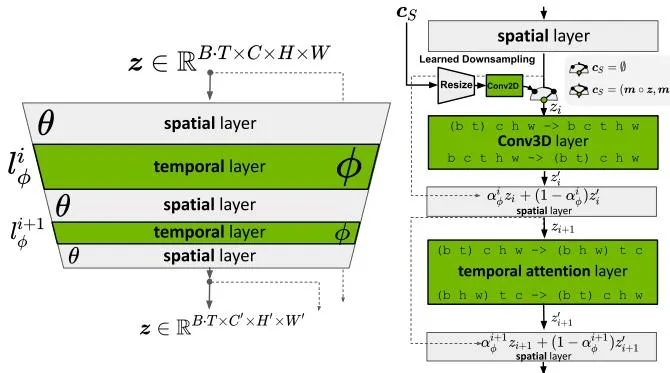
设图像 LDM 的空间层 (处理像素维度)。直接用它渲染 连续帧会失败(无时序感知)。因此引入时序层 与空间层交错,学习时序一致对齐。 个时序层 构成视频感知时序骨干,完整模型 为空间层 + 时序层的组合。
处理流程(einops 记法):从逐帧编码的输入视频 出发:
即:空间层将 帧作为独立批次处理;时序层在新时序维 上处理整段视频。
学习式融合:每个时序层后,输出 与 按 组合, 为可学习参数。推理时设 (跳过时序层)即恢复原始图像模型。
两类时序混合层:(i) 时序注意力;(ii) 基于 3D 卷积的残差块。用正弦嵌入提供时间位置编码。
训练目标(式2):固定空间层 ,只优化时序层 :
3.2.1 时序自编码器微调
图像 LDM 的自编码器仅在图像上训练,编解码时序一致图像序列会产生闪烁伪影。因此为解码器引入额外时序层,用基于 3D 卷积的(patch 级)时序判别器在视频上微调。编码器保持不变(使隐空间 DM 可复用)。重建 FVD 证明此步至关重要。
3.3 长视频预测模型
短序列生成会遇到瓶颈。引入预测模型:给定前 个上下文帧,用二值掩码 掩盖需预测的 帧。上下文条件 ,目标(式3):
学习条件于 0/1/2 个上下文帧的预测模型(支持 classifier-free guidance)。推理时迭代应用采样过程、复用最新预测作为新上下文,生成长视频。
Context guidance(式4):
3.4 高帧率时序插值
高分辨率视频需高帧率。分两部分:先生成低帧率关键帧(Sec 3.1/3.2),再用插值模型在关键帧间插值(复用掩码条件机制,但掩盖待插值帧)。在两关键帧间预测 3 帧(),并同时在 与 两种 regime 训练以达更高帧率。
3.5 超分(SR)模型时序微调
借鉴级联 DM,用 DM 将 Video LDM 输出 4× 放大(驾驶用像素空间 DM 到 512×1024;文生视频用 LDM 上采样器到 1280×2048)。用 noise augmentation + 噪声等级条件,目标(式5):
超分器同样视频感知化(空间层 + 时序层),但只在 patch 上高效训练、后续卷积式应用;因低分辨率条件已提供,无需长时相关,故不需预测/插值框架。
整体流程
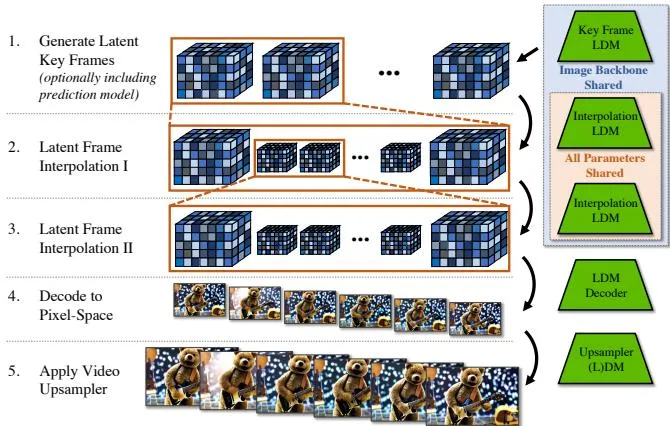
Video LDM Stack:先生成稀疏关键帧 → 用同一插值模型两步时序插值达高帧率 → 隐视频解码到像素空间 → 可选应用视频上采样 DM。所有操作共享同一图像骨干。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 冻结空间 + 训练时序层 | 复用预训练图像 LDM,只训时序对齐层 | 式2,可用海量图像数据 |
| 学习式时序融合 α | 无缝恢复图像模型 | 保留原生图像能力 |
| 时序解码器微调 | 3D 卷积时序判别器消除闪烁 | 重建 FVD 390.88→32.94 |
| 掩码预测 + 插值 | 迭代预测生成分钟级长视频 | 验证至 5 分钟 |
| 时序超分对齐 | patch 级高效训练的视频超分 | FVD 165.98→45.39 |
| 时序层可迁移 | 迁移到 DreamBooth 骨干 | 首次个性化文生视频 |
五、实验结果
5.1 实验设置
- 数据集:(i) 内部真实驾驶场景(RDS)——683,060 段 8 秒 512×1024 视频(≤30fps,含昼夜/车辆密度/边界框标注);(ii) WebVid-10M(10.7M 视频-字幕对,52K 小时,resize 到 320×512);(iii) Mountain Biking
- 评测:帧级 FID、FVD、人工评估;文生视频另用 CLIP-SIM 与 IS
- 架构:图像 LDM 基于 Rombach et al.,U-Net 基于 Dhariwal et al.;采样用 DDIM
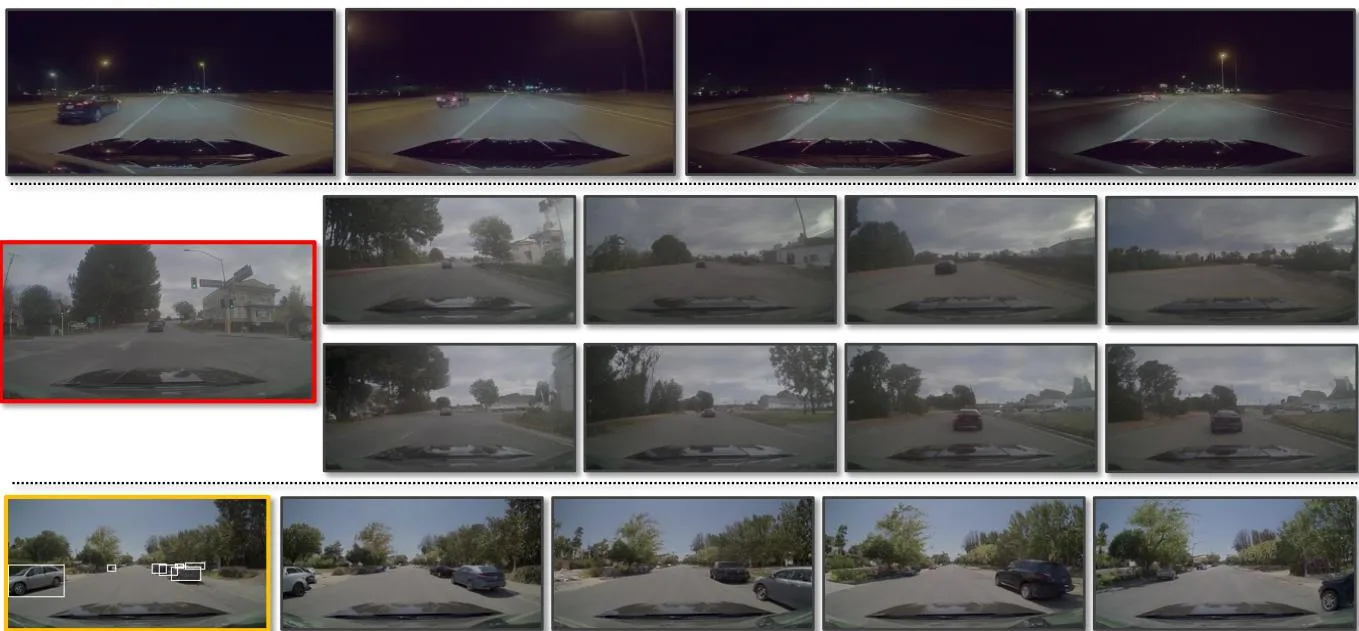
5.2 高分辨率驾驶视频合成
vs LVG(前 SOTA)(128×256,无上采样器):
| 方法 | FVD↓ | FID↓ |
|---|---|---|
| LVG | 478 | 53.5 |
| Ours | 389 | 31.6 |
| Ours (条件) | 356 | 51.9 |
消融(Table 1 右):
| 方法 | FVD↓ | FID↓ |
|---|---|---|
| Pixel-baseline | 639.56 | 59.70 |
| End-to-end LDM(无图像预训练) | 1155.10 | 71.26 |
| Attention-only(无 3D 卷积) | 704.41 | 50.01 |
| Ours | 534.17 | 48.26 |
| Ours (context-guided) | 508.82 | 54.16 |
- 图像预训练至关重要(End-to-end 严重退化)
- 3D 卷积时序层优于 attention-only
- context guidance 进一步降 FVD(略增 FID)
超分时序对齐(Table 3):视频上采样器 FVD 45.39 vs 图像上采样器 165.98——时序对齐对性能至关重要;FID 基本不变(独立帧仍高质量)。
解码器视频微调(Table 3):FVD 从 390.88(image-only)降至 32.94(finetuned),提升数量级。
长视频:用预测方法生成多分钟连贯高分辨率驾驶视频(验证至 5 分钟);可多模态模拟驾驶场景。
5.3 文生视频(基于 Stable Diffusion)
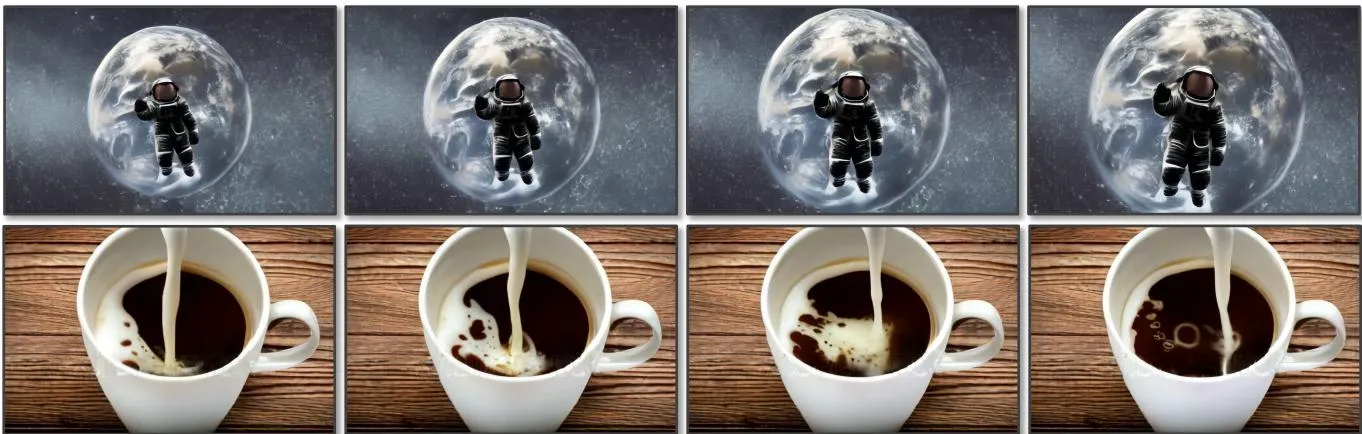
将公开 Stable Diffusion 转为文生视频:在 WebVid 帧上简短微调空间层 → 插入时序对齐层并训练(320×512,加文本条件)→ 视频微调 SD 上采样器实现 4× 放大到 1280×2048。生成 113 帧(可渲染为 24fps 的 4.7 秒 / 30fps 的 3.8 秒)。
虽然 WebVid 是写实视频,模型能生成高度表现力的艺术化视频——图像骨干的生成能力顺利迁移到视频。
UCF-101 零样本文生视频(Table 4):
| 方法 | Zero-Shot | IS↑ | FVD↓ |
|---|---|---|---|
| CogVideo (英) | Yes | 25.27 | 701.59 |
| Make-A-Video | Yes | 33.00 | 367.23 |
| Video LDM | Yes | 33.45 | 550.61 |
MSR-VTT(Table 5):Video LDM CLIP-SIM 0.2929(超越除 Make-A-Video 外所有基线)。Make-A-Video 为并发工作且用更多视频数据(额外 HD-VILA-100M),本文仅用 WebVid-10M,IS 仍超越它。
5.4 个性化文生视频(DreamBooth)
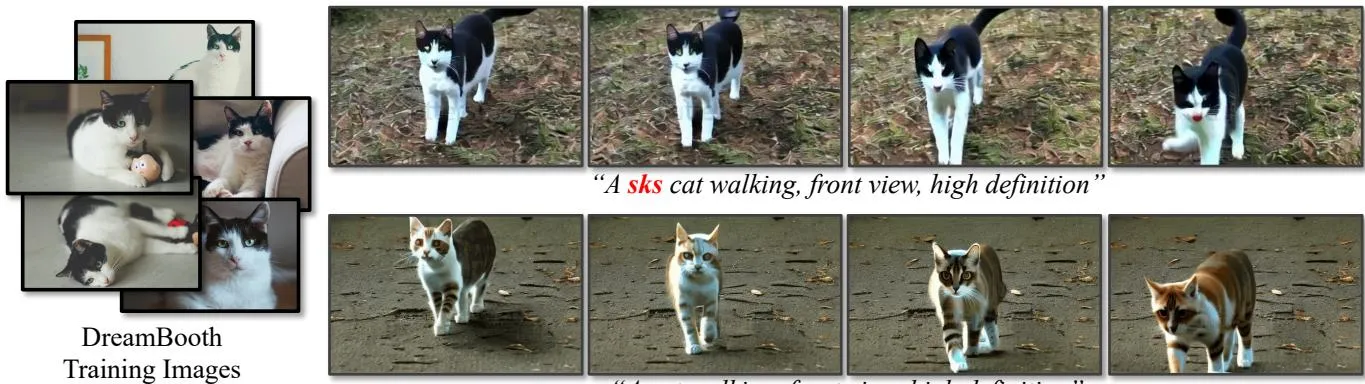
由于空间层与时序层分离——检验时序层能否迁移到其他 checkpoint。用 DreamBooth 微调 SD 空间骨干(将身份绑定到罕见 token “sks”),再插入此前视频微调 SD 的时序层,即可生成正确保持身份的个性化连贯视频。首次展示个性化文生视频,验证时序层泛化性。
六、总结
核心贡献
- 高效高分辨率长视频生成框架:基于 LDM,复用预训练图像 DM,插入时序层学习时序一致对齐
- 时序微调超分 DM:将普遍的超分模型时序对齐
- SOTA 驾驶视频合成:真实驾驶场景达 SOTA,生成多分钟长视频
- Stable Diffusion → 文生视频:转为最高 1280×2048 的强表现力文生视频 LDM
- 时序层可组合:与不同图像 checkpoint(如 DreamBooth)结合,首次个性化文生视频
技术影响
- 奠定视频扩散范式:“冻结空间层 + 训练时序层”被 Stable Video Diffusion、AnimateDiff、ModelScope 等广泛继承
- 时序层可插拔迁移的特性催生了大量个性化/可控视频生成工作
- 与本系列前述图像 DiT(2212.09748)互补——展示扩散范式从图像到视频的扩展路径
局限性与未来方向
- 依赖图像骨干质量与视频数据的运动多样性
- 时序建模仍受限于关键帧 + 插值的分层设计
- 广义影响与限制见附录 B
七、参考资源
- arXiv: https://arxiv.org/abs/2304.08818
- 项目页: https://research.nvidia.com/labs/toronto-ai/VideoLDM/
- 相关工作: LDM/Stable Diffusion、DreamBooth、Make-A-Video、CogVideo、级联 DM、Long Video GAN
- 数据集: RDS(内部)、WebVid-10M、Mountain Biking、UCF-101、MSR-VTT
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 3 | LDM 框架与时序解码器微调 | figure-3-temporal-decoder.jpg |
| Figure 4 | 时序层对齐帧序列(核心方法) | figure-4-temporal-layers.jpg |
| Figure 5 | Video LDM 完整堆栈 | figure-5-video-ldm-stack.jpg |
| Figure 6 | 1280×2048 文生视频样本 | figure-6-text2video.jpg |
| Figure 7 | 驾驶场景视频建模 | figure-7-driving.jpg |
| Figure 8 | DreamBooth 个性化视频 | figure-8-dreambooth.jpg |
分析日期: 2026-07-07 分析师: AI Paper Analyzer