MagicVideo: Efficient Video Generation With Latent Diffusion Models
字节跳动提出的首个基于潜空间扩散模型(LDM)的高效文生视频框架。通过在低维潜空间建模视频分布、复用文生图模型的 2D 卷积权重、引入帧级轻量 adaptor 与有向时序注意力,MagicVideo 在单卡上生成 256×256 视频,FLOPs 较 VDM 减少约 64×。
MagicVideo:基于潜空间扩散模型的高效视频生成
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MagicVideo: Efficient Video Generation With Latent Diffusion Models |
| 作者 | Daquan Zhou*, Weimin Wang*, Hanshu Yan*, Weiwei Lv, Yizhe Zhu, Jiashi Feng |
| 机构 | ByteDance Inc.(字节跳动) |
| 论文 | arXiv:2211.11018 |
| 发布 | 2022-11-20 |
| 领域 | 计算机视觉(cs.CV)、文生视频、扩散模型 |
| 项目主页 | MagicVideo Demo |
一句话概括
MagicVideo 是首个基于潜空间扩散模型(Latent Diffusion Model, LDM)的文生视频框架。它不在 RGB 像素空间训练视频模型,而是先用 VAE 把视频压缩到低维潜空间再做扩散,从而把单帧生成计算量降低约 64×;同时提出帧级轻量 adaptor(复用文生图模型的 2D 卷积权重)与有向时序注意力(directed temporal attention)来适配图像 U-Net 到视频,并用 VideoVAE 解码器消除逐帧解码带来的像素抖动(dithering)。最终可在单卡 GPU 上生成 256×256 视频,并超分至 1024×1024。
历史地位:这是 2022 年末视频扩散浪潮中与 Imagen Video、Make-A-Video 同期的工作,但率先将 LDM 思想引入视频生成,为后续 latent video diffusion(如 Video LDM、AnimateDiff、SVD 等)奠定了「潜空间 + 复用图像先验」的范式基础。
二、核心思想
问题定义
用扩散模型做视频生成面临三大难题:
- 数据稀缺(Data scarcity):带精确文本描述的视频远少于图文对;且视频含大量与文本无关的冗余片段。
- 复杂时序动态(Complex temporal dynamics):视频跨帧内容多样、动态复杂,比静态图像分布建模难得多。
- 高计算成本(High computation cost):一段流畅视频可能上百帧,直接生成整段视频消耗巨大。现有级联式(cascaded)像素空间视频扩散模型(如 VDM)生成 16 帧 64×64 视频需 6–10 秒、75GB 显存/迭代。
核心问题:如何在数据、计算双重受限下,高效训练出高质量、时序一致的文生视频模型?
解决方案概述
MagicVideo 的思路可概括为「潜空间建模 + 复用图像先验 + 轻量时序适配」:
- 潜空间建模:用预训练 VAE 把视频帧映射到 8× 下采样的低维潜空间,扩散在潜空间进行,单帧计算量约降 64×。
- 复用文生图先验:用「2D 卷积 + adaptor」替代 3D/(2+1)D 卷积,使 2D 卷积可直接用预训练 LDM(Stable Diffusion)权重初始化,即使少量视频数据也能学会生成。
- 有向时序注意力:用因果掩码(下三角)的自注意力建模视频运动的方向性,优于双向注意力。
- VideoVAE 解码器:在解码器加时序注意力层,消除逐帧解码的像素抖动。
- 两阶段生成流水线:关键帧生成 → 帧插值 → VideoVAE 解码回 RGB → 超分至 1024×1024。
三、技术架构
整体框架图
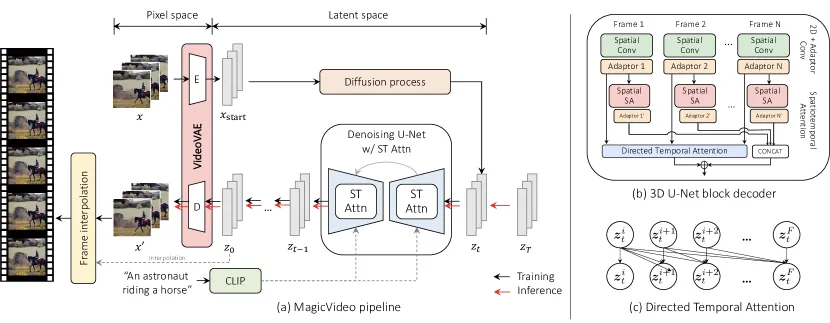
Figure 2:MagicVideo 整体框架。(a) 训练/推理数据流:训练时从 随机采样时间步 ,对输入视频帧做扩散加噪,U-Net decoder 学习重建;推理时随机采样高斯噪声,重复去噪 次,去噪后的潜向量 送入 VAE decoder 转回 RGB。(b) 时空注意力(ST-Attn)模块结构。(c) ST-Attn 中使用的有向注意力(directed attention)。
推理流程:
文本 prompt ──CLIP──> 文本嵌入 τ(y)
                            │ (cross-attn 条件)
随机噪声 ──> [3D U-Net 去噪 ×T] ──> 关键帧潜向量 (16 帧)
                            │
                     [帧插值网络] ──> 加密帧序列 (每对相邻帧插 3 帧)
                            │
                   [VideoVAE decoder] ──> 256×256 RGB 视频
                            │
                  [扩散超分 SR 模型] ──> 1024×1024 高清视频
符号约定(Notation)
- :时间步 加噪的视频帧序列, 为第 帧。
- :VideoVAE 编码器/解码器;逐帧映射 。
- :CLIP 编码的文本 prompt 嵌入。
- :潜空间扩散模型的去噪器。
核心公式
1. 视频分布 Adaptor(Video Distribution Adaptor)
将 “2D+1D” 卷积进一步简化为 “2D + adaptor”。对 帧共享同一 2D 卷积提取空间特征后,逐帧调整均值与方差:
\bm{z}^i_t = S^i \cdot \text{Conv2d}(\bm{z}^i_t) + B^i \tag{1}
其中 是两组可学习参数(仅少量标量)。灵感来自「同一视频片段内各帧语义相似」——帧间微小差异不必用专门的 1D 卷积建模,用一小组参数即可捕捉。这既省算力,又让模型能复用图像 2D 卷积权重。
2. 空间 + 时序双注意力(并行)
在 U-Net 下采样块(空间分辨率降 4×/8×/16×)后,并行做空间与时序注意力,输出相加:
\bm{z}_t = \text{S-Attn}(\bm{z}_{t-1}) + \text{T-Attn}(\bm{z}_{t-1}) \tag{2}
空间注意力(含文本 cross-attention):
\text{S-Attn} = \text{Cross-Attn}(\text{LN}(\text{MHSA}(\text{LN}(\bm{z}_{t-1}))), \tau(\bm{y})) \tag{3}
3. 有向时序注意力(Directed Temporal Attention)★核心创新
将 reshape 为 ,把每帧每像素当作 token,对相同空间位置跨帧做注意力:
A_t = \text{Softmax}(Q_t K_t^\top / \sqrt{d}) \odot M \tag{4}
其中 是下三角掩码: if else 。即当前帧 token 只受之前帧影响、不受未来帧影响,符合视频运动的方向性。这优于现有工作(VDM、Make-A-Video)普遍使用的双向时序注意力。
4. 训练目标与 FPS 嵌入
训练时先从每段视频随机采长度 的连续片段并读取 FPS,再从中均匀采 16 帧。用 表征运动速度( 越长场景变化越快),并编码为嵌入:
\text{emb}_\nu = \text{Linear}(\text{SiLU}(\text{Linear}(\text{Sin}(\nu)))) \tag{5}
加到视频帧特征上。
逐帧重建损失:
\mathcal{L}(\bm{z}_0) = \mathbb{E}_t \sum_{i=0}^{F} \|\bm{z}_0^i - \epsilon_\theta(\bm{z}_t^i, t, \bm{y})\|_2^2 \tag{6}
模型组件
| 组件 | 说明 | 关键设计 |
|---|---|---|
| 3D U-Net 去噪器 | 关键帧生成核心;用预训练 LDM 权重初始化 2D 卷积 | 2D Conv + adaptor 替代 3D/(2+1)D |
| Video Distribution Adaptor | 逐帧调整特征均值/方差,捕捉帧间微差 | 仅 少量参数 |
| ST-Attn(空间+有向时序注意力) | 空间注意力保内容多样性,时序注意力保跨帧一致性 | 并行相加;时序含因果掩码 |
| 帧插值网络 | 相邻关键帧间插 3 帧提升时间分辨率 | 潜空间训练,条件为相邻两帧 CLIP 嵌入+潜码拼接;用关键帧模型初始化 |
| VideoVAE decoder | 消除逐帧解码的像素抖动 | 解码器加 2 层有向时序注意力 |
| 超分 SR 模型 | 256×256 → 1024×1024 | RGB 空间扩散 SR,仅用图像数据训练 + 噪声条件增强 |
训练流程(两阶段)
- 无监督预训练:文本-视频对稀缺,故用 CLIP 视觉编码器提取的视频帧嵌入作为文本条件的代理(proxy)进行预训练(借鉴 Make-A-Video)。数据:HD-VILA-100M 与 Webvid-10M 的 10M 子集。
- 有监督微调:在自采 7M 视频-文本对上微调。两阶段用相同目标(Eqn.6)。
- 初始化:用 Laion-5B 预训练的 LDM 权重初始化 3D U-Net。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个 LDM 文生视频框架 | 在低维潜空间做视频扩散,单帧计算量降约 64× | FLOPs 较 VDM 减少 ~64× |
| 2D+adaptor 替代 3D 卷积 | 复用文生图 2D 卷积权重,少量视频数据即可训练 | 消融显示 adaptor 既省算力又提升质量 |
| 有向时序注意力 | 因果下三角掩码建模运动方向性 | 消融显示可大幅降低 FVD |
| VideoVAE 解码器 | 解码器加时序注意力消除像素抖动 | Fig.3 定性对比 vs 传统 VAE |
| 无监督预训练策略 | CLIP 视觉嵌入代理文本条件 | FVD 进一步降低约 60 |
| FPS 运动速度嵌入 | 显式编码运动快慢作为条件 | Eqn.5 |
五、实验结果
数据集与设置
- 初始化:Laion-5B 预训练 LDM 权重。
- 无监督预训练:HD-VILA-100M + Webvid-10M 的 10M 子集。
- 有监督微调:自采 7M 视频-文本对。
- 评估:在 UCF-101、MSR-VTT 测试集上**零样本(zero-shot)**评估 FID/FVD。
基准测试
Table 1 — MSR-VTT 视频生成评估:
| 方法 | Zero-Shot | FID ↓ | FVD ↓ |
|---|---|---|---|
| NÜWA | No | 47.7 | - |
| CogVideo | Yes | 49.0 | 1294 |
| MagicVideo (ours) | Yes | 36.5 | 998 |
Table 2 — UCF-101 视频生成评估:
| 方法 | Zero-Shot | FID ↓ | FVD ↓ |
|---|---|---|---|
| MoCoGAN-HD | No | - | 700 |
| CogVideo (Chinese) | Yes | 185 | 751 |
| CogVideo (English) | Yes | 179 | 702 |
| MagicVideo (ours) | Yes | 145 | 655 |
MagicVideo 在两个基准上 FID/FVD 均优于 CogVideo。
Table 3 — 人工评估(DrawBench,200 prompts,vs CogVideo):
数值为 MagicVideo 结果优于或等于 CogVideo 的样本百分比。
| Realism | Faithfulness | Smoothness | Time cost (mins/16帧) |
|---|---|---|---|
| 68% | 86% | 96% | 0.3 vs 21 |
MagicVideo 各维度显著优于 CogVideo,且生成 16 帧仅需 0.3 分钟 vs CogVideo 21 分钟(约 70× 加速)。
定性对比
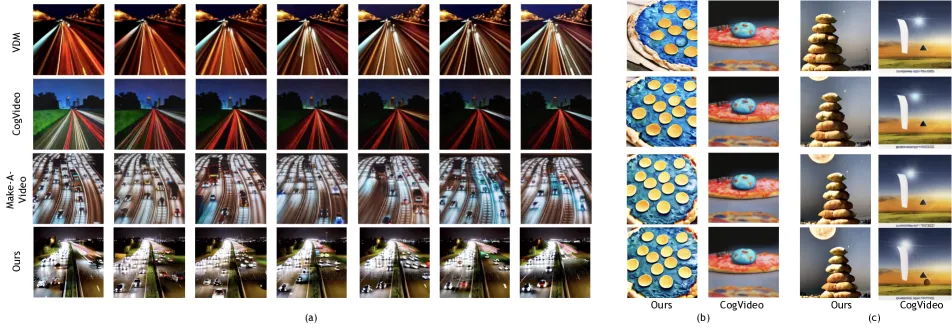
Figure 5:与 VDM、CogVideo、Make-A-Video 对比。输入 “Busy freeway at night” 时,CogVideo/VDM 只生成模糊的运动流抽象场景,而 MagicVideo 能生成带车灯的清晰高速公路车辆,甚至呈现近大远小的透视关系。
消融实验
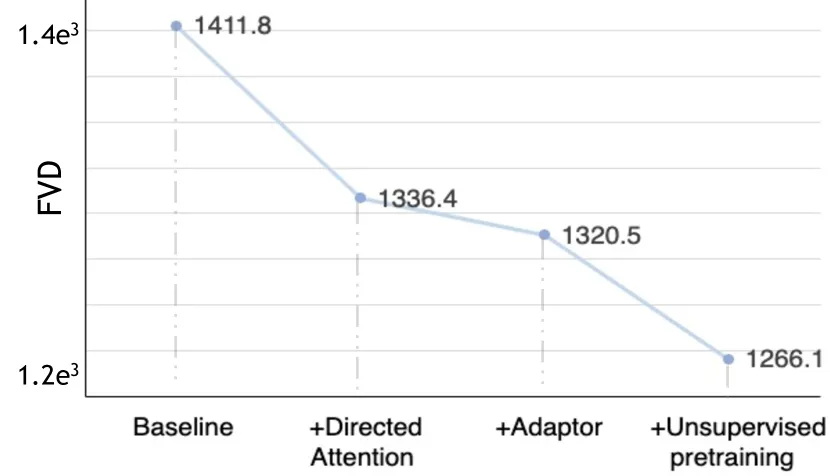
Figure 7:各组件对性能(FVD)的影响。在 Webvid-10M 测试集 1000 段视频(每段 16 帧)上评估:
- 有向注意力(directed attention):大幅降低 FVD。
- Adaptor:既省计算又提升生成质量。
- 无监督预训练:FVD 进一步降低约 60。
空间 vs 时序注意力可视化
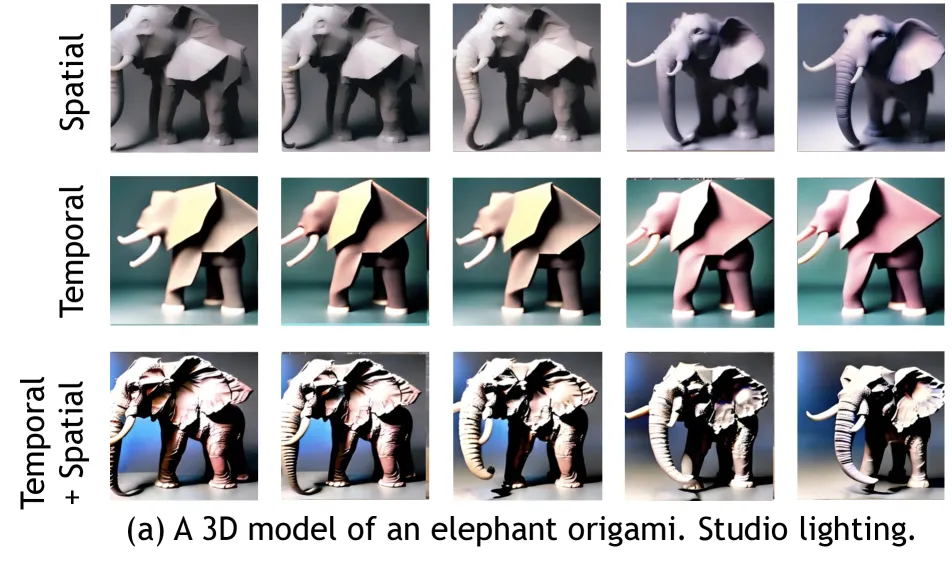
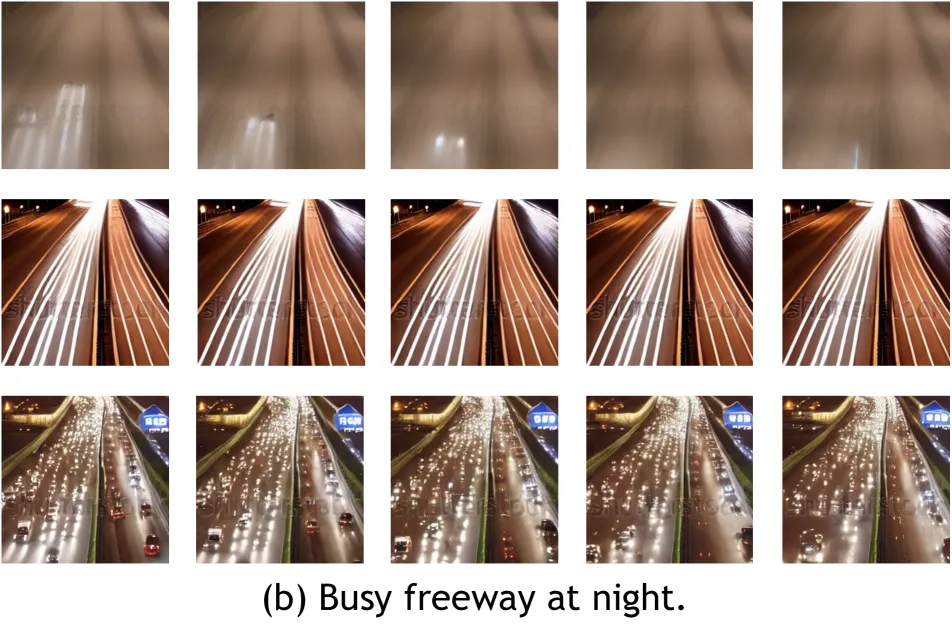
Figure 4:分别可视化两个分支特征。空间注意力帮助生成多样化的帧内容;时序注意力保证跨帧一致性。两者结合兼顾内容多样性与一致性。
VideoVAE 消除抖动
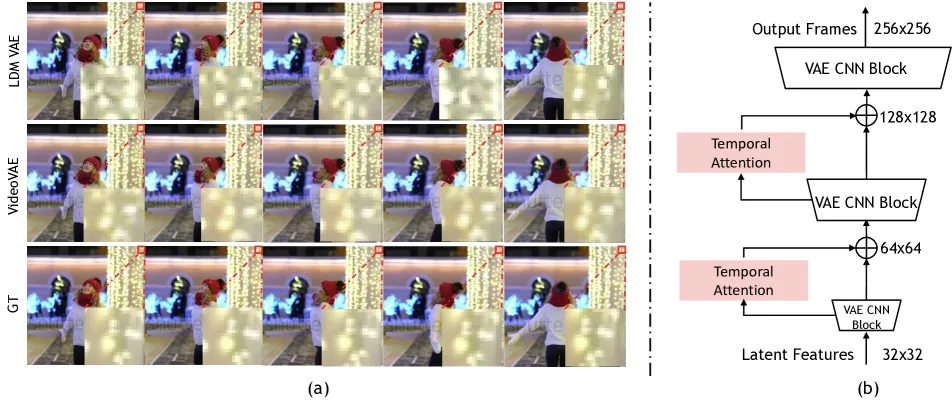
Figure 3:(a) VideoVAE 解码相比传统逐帧 VAE 能有效减少像素抖动伪影;(b) VideoVAE 解码器架构(低维潜特征 + 2 层有向时序注意力)。作者发现抖动与潜特征空间维度相关:维度越高抖动越少,但计算成本升高——VideoVAE 用时序注意力在保持低维的同时消除抖动。
应用扩展
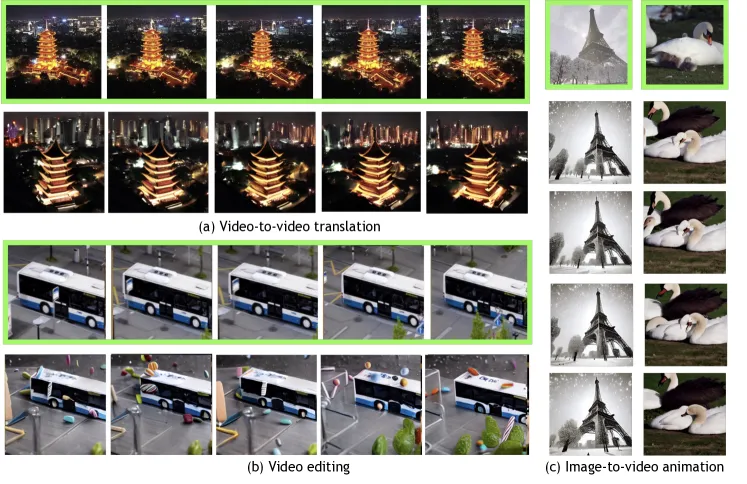
Figure 6:基于 MagicVideo 的三类应用(绿框为源图/视频帧):(a) 视频变体(video variation);(b) 视频编辑——给定行驶巴士视频,用 “candies falling onto the ground” 文本编辑;(c) 图生视频——给定单张图像生成相关短视频。
六、相关工作
| 方法 | 空间 | 关键差异 |
|---|---|---|
| VDM [Ho et al.] | RGB 像素 | 3D U-Net,级联超分;计算成本极高(75GB/迭代) |
| Imagen Video | RGB 像素 | 基础文生视频 + 3 个时空超分模块 |
| Make-A-Video(并发工作) | RGB 像素 | 先文生图嵌入 → 低分辨率视频 → 超分;双向时序注意力 |
| CogVideo | 自回归 Transformer | 大规模预训练,条件于文本+前帧;速度慢 |
| LDM (Stable Diffusion) | 潜空间(图像) | MagicVideo 的基础,扩展到视频 |
| MagicVideo(本文) | 潜空间(视频) | 首个 LDM 视频框架;2D+adaptor 复用图像先验;有向时序注意力 |
关键区别:Imagen Video 与 Make-A-Video 都在 RGB 空间建模视频分布;MagicVideo 在低维潜空间建模,效率显著更高。
七、总结
核心贡献
- 提出首个基于潜空间扩散模型的文生视频框架 MagicVideo,单帧计算量较像素空间 VDM 降约 64×,可在单卡生成 256×256 视频。
- 提出 2D 卷积 + 轻量 adaptor 设计,复用预训练文生图模型权重,缓解视频数据稀缺问题。
- 提出有向时序注意力(因果掩码),更好建模视频运动方向性。
- 提出 VideoVAE 解码器,消除逐帧解码的像素抖动伪影。
- 在 MSR-VTT/UCF-101 零样本 FID/FVD 及人工评估上均超越 CogVideo,且速度快约 70×。
技术影响
- 奠定 latent video diffusion 范式:证明「潜空间扩散 + 复用图像先验」在视频生成上高效可行,直接启发后续 Video LDM、AnimateDiff、Stable Video Diffusion 等一系列 latent video diffusion 工作。
- 参数高效适配:adaptor + 2D 卷积复用的思路对「图像模型→视频模型」的低成本迁移具有普适价值。
- 有向注意力:为视频时序建模引入方向性归纳偏置。
局限性
- 关键帧仅 16 帧,需插值 + 超分级联,长视频生成仍受限。
- 超分 SR 仅用图像数据训练(缺高分辨率视频数据),时序一致性依赖前级。
- 依赖 Stable Diffusion 预训练权重,可能继承 LAION 数据集的伦理问题。
- 生成视频可能被用于恶意编辑(deepfake),需配合检测技术。
八、参考资源
- 论文:arXiv:2211.11018
- PDF:arXiv PDF
- HTML(ar5iv):ar5iv 渲染版
- 项目主页:https://magicvideo.github.io/
- 基础工作:LDM/Stable Diffusion (2112.10752)、VDM (2204.03458)、Make-A-Video (2209.14792)、Imagen Video (2210.02303)
- 引用:Zhou, D., Wang, W., Yan, H., Lv, W., Zhu, Y., & Feng, J. (2022). MagicVideo: Efficient Video Generation With Latent Diffusion Models. arXiv:2211.11018.
附录:论文图表索引
| 图 | 文件 | 说明 |
|---|---|---|
| Figure 2 | architecture-overview.png | MagicVideo 整体框架(数据流 + ST-Attn + 有向注意力) |
| Figure 3 | videovae.png | VideoVAE 消除像素抖动 + 解码器架构 |
| Figure 4 (a) | attention-effects-spatial.png | 空间注意力效果(内容多样性) |
| Figure 4 (b) | attention-effects-temporal.png | 时序注意力效果(跨帧一致性) |
| Figure 5 | qualitative-comparison.png | 与 VDM/CogVideo/Make-A-Video 定性对比 |
| Figure 6 | applications.png | 三类应用(视频变体/编辑/图生视频) |
| Figure 7 | ablation-fvd.png | 各组件对 FVD 的消融影响 |


