Training with Confidence: Catching Silent Errors in Deep Learning Training with Automated Proactive Checks
TRAINCHECK — 通过自动推断训练不变量并主动检查,在训练过程中提前发现静默错误(OSDI 2025, University of Michigan)
Training with Confidence: Catching Silent Errors in DL Training with Automated Proactive Checks
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Training with Confidence: Catching Silent Errors in Deep Learning Training with Automated Proactive Checks |
| 作者 | Yuxuan Jiang, Ziming Zhou, Boyu Xu, Beijie Liu, Runhui Xu, Peng Huang |
| 机构 | University of Michigan |
| 会议 | 19th USENIX Symposium on Operating Systems Design and Implementation (OSDI 2025), July 7–9, 2025, Boston, MA, USA(ISBN 978-1-939133-47-2) |
| 论文 | https://www.usenix.org/conference/osdi25/presentation/jiang(PDF: osdi25-jiang.pdf) |
| 代码 | https://github.com/OrderLab/TrainCheck |
| 技术报告 | University of Michigan, 2025(含 20 个被复现静默错误的完整描述) |
二、核心思想
深度学习模型训练是一个横跨用户代码、编译器、训练框架、优化库、驱动与分布式系统的复杂过程。与会显式抛异常、直接终止任务的错误不同,静默错误(silent errors) 不会引起明显的训练中断,却会最终产生次优甚至错误的模型,或在很晚之后才造成严重故障。例如 HuggingFace 训练 BLOOM-176B 时,DeepSpeed 的 BF16Optimizer 在梯度裁剪逻辑上存在 bug,导致部分模型在 GPU 之间静默发散——该问题既不触发异常,也不立即影响 loss/accuracy,直到 10 天后合并 checkpoint 时才发现,随后又花了 9 天合并权重。
论文的核心洞见是:训练正确性的根因往往在早期就触发,且可以通过特定、低层级的检查来捕获;而当前依赖 loss/accuracy 等高层信号的做法在错误检测上天然不足——这些信号有噪声、周期性评估、且无法提供诊断线索。作者由此提出 训练不变量(training invariants):在整个训练过程中应当始终成立、能够精确捕获 DL 训练高层语义的规则(例如”分布式 worker 间模型权重应保持一致”)。但手工编写不变量不可行(框架与训练实践快速演进),因此需要自动推断不变量及其前置条件(preconditions)。
一个关键观察是:训练不变量往往只在特定条件下成立(例如只对张量并行中复制的 LayerNorm 权重、只在特定的并行设置下)。TRAINCHECK 自动从高质量训练 pipeline(如 PyTorch 官方示例)中推断出带前置条件、可跨 pipeline 迁移的训练不变量,并在目标训练任务的在线阶段持续验证,一旦违反即告警并提供诊断线索。
问题定义
静默错误(silent/latent training errors)——不触发明显训练中断、但最终导致模型次优或错误、且难以检测和诊断的错误。论文聚焦其中的正确性违背(correctness violations):直接破坏训练结果的完整性与正确性、通常影响大且可行动、但被现有工具忽视的错误。
解决方案概述
TRAINCHECK 是一个端到端框架,包含三个组件:
- Instrumentor(插桩器):通过 monkey-patching + Proxy 模式动态插桩训练程序,以低开销采集运行时 trace(API 调用、变量状态、meta 变量);
- Infer Engine(推断引擎):基于假设(hypothesis)的迭代式推断,从 trace 中自动推导训练不变量及其前置条件;
- Verifier(验证器):在线阶段对训练任务进行选择性插桩,以流式方式实时检查不变量,违反即报告。
TRAINCHECK 采用两阶段运行:离线阶段从高质量训练 pipeline 推断不变量;在线阶段将这些不变量部署到目标训练任务,持续验证。
三、技术架构
整体框架图
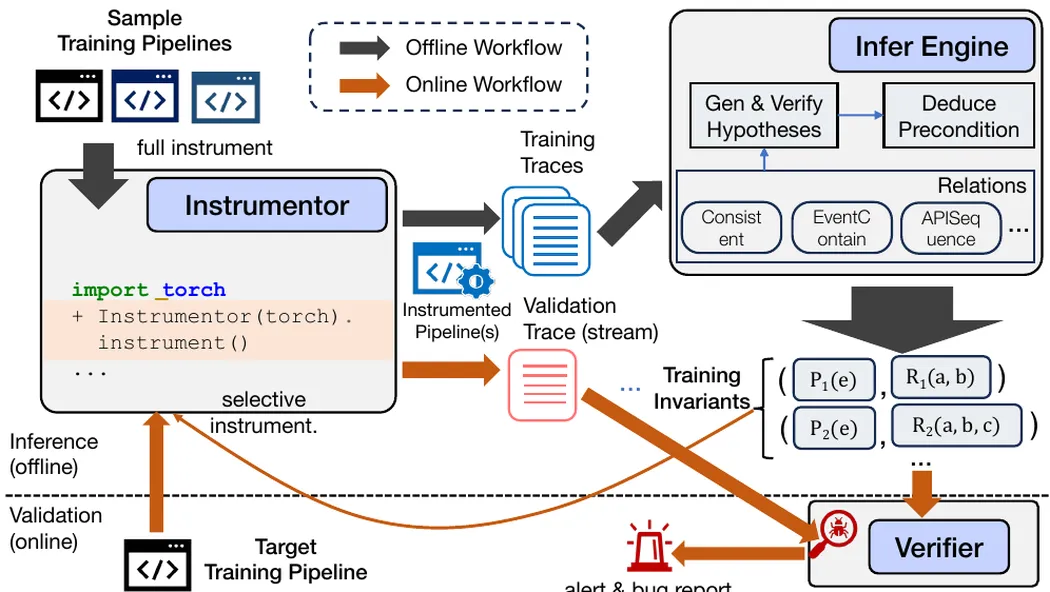
TRAINCHECK 的工作流如上图:离线阶段用完整插桩(full instrumentation)采集”样本训练 pipeline”的 trace,交给 Infer Engine(生成/验证假设 + 推导前置条件,依据五类关系模板);在线阶段对”目标训练 pipeline”做选择性插桩,Verifier 基于推断出的不变量 (P(e), R(a,b)) 流式检查,违反即产生告警与 bug 报告。
不变量表示(Invariant Representation)
TRAINCHECK 定义了通用关系接口(relation interface),不变量就是”用具体变量与 API 实例化、且必须满足指定关系”的规则。论文通过分析实际静默错误,归纳了五种代表性关系(Table 2):
| 关系 | 描述 |
|---|---|
| Consistent(Va, Vb) | Va 与 Vb 应具有相同的值,但值可以随时间变化(如分布式训练中跨 worker 复制/共享的参数一致性) |
| EventContain(Ea, Eb) | 当调用 Ea 时,指定的子事件 Eb(如另一个 API 调用或变量状态变化)必须发生在 Ea 的持续时间内(如 Optimizer.step 应包含对模型参数及其更新操作的调用) |
| APISequence(Ia, Ib, …) | Ia, Ib, … 必须都出现,且按指定顺序出现(如用户忘记调用 Optimizer.zero_grad 就执行 loss.backward) |
| APIArg(Ia, is_distinct) | 对 Ia 的所有调用中,参数必须保持一致或保持相异 |
| APIOutput(Ia, bound_type) | Ia 的输出必须满足某些属性约束(如 dtype 约束) |
这些关系是确定性的,编码了严格的语义,因此能够精确、及时地检测静默错误。除内置关系外,框架可扩展,开发者可方便地添加新关系。推断从”用描述符实例化关系”开始:API 描述符指定 API 名称及可选参数/返回值;变量描述符指定变量类型、属性名及可选期望值/值变化。
Trace 表示
原始 trace 由一系列记录组成,每条记录标注时间戳与线程 ID,包含:
- API 调用 trace:函数入口、出口、参数与返回值;
- 变量状态 trace:变量赋值、删除与修改;
- meta 变量:训练迭代号、分布式训练 rank、活跃的上下文管理器(context manager)等;用户可通过
set_meta自定义(如 pipeline 阶段)。
TRAINCHECK 进一步从原始记录中抽取高层事件(如 APICallEvent 聚合入口/出口记录及派生属性,如执行时长、嵌套事件),形成不变量推断的结构基础。
不变量推断(Invariant Inference)
TRAINCHECK 采用基于假设的方法。Algorithm 1 给出推断主流程:
Algorithm 1: Invariant Inference
Input: traces, relation_pool
Output: all_invariants

all_invariants ← [];
foreach relation ∈ relation_pool do
    hypotheses ← [];
    foreach trace ∈ traces do
        hypotheses.extend(relation.GEN_HYPOS(trace));
    foreach hypo ∈ hypotheses do
        foreach trace ∈ traces do
            relation.COLLECT_EXAMPLES(trace, hypo);
    foreach hypo ∈ hypotheses do
        preconditions ← INFER_PRECONDITION(hypo);
        if preconditions ≠ null then
            hypo.invariant.preconditions ← preconditions;
            all_invariants.append(hypo.invariant);
return all_invariants;
三个核心步骤:
- 假设生成(Hypothesis generation):扫描所有 trace,用潜在的具体描述符实例化关系;
- 假设验证(Hypothesis validation):对每个假设不变量,在 trace 上验证,并根据关系是否成立将匹配实体记录为通过/失败样本(passing/failing examples);
- 前置条件推导(Precondition deduction):推导通过/失败样本之间的区分条件。若找到,作为该属性的前置条件;若找不到,则假设失效并被丢弃。
以 Consistent 关系为例,Algorithm 2 展示假设生成:
Algorithm 2: Hypothesis Generation for Consistent
Input: trace
Output: Generated hypotheses

variables ← trace.get_all_variables();
foreach (var1, var2) ∈ Combinations(variables, 2) do
    foreach (attr1, attr2) ∈ CartesianProduct(var1.attrs, var2.attrs) do
        if exists_value_match(attr1.states, attr2.states) then
            hypo ← NEW_HYPO(relation ← ConsistentRelation,
                            entities ← [VarDesc(var1.type, attr1.name),
                                        VarDesc(var2.type, attr2.name)]);
            yield hypo;
其他关系以类似方式定义各自的假设生成与验证方法。
前置条件(Preconditions)
DL 语义是上下文敏感的。例如:分布式训练中的参数一致性不变量,只在同一模型层跨 worker、同一训练迭代内、且只对复制而非切分的参数成立;输出张量 dtype 通常依赖输入 dtype,但在 autocast 上下文管理器激活时应为 autocast dtype。
前置条件带来四方面收益:(1) 增强不变量准确性信心;(2) 减少误报;(3) 便于调试——违反时解释是 pipeline 哪部分出错;(4) 降低开销——只执行适用的检查。此外,前置条件使不变量可迁移:它给出了清晰的适用上下文,因此可应用到共享该上下文的其他 pipeline。
TRAINCHECK 支持四种条件类型:
| 类型 | 含义 |
|---|---|
| CONSTANT | 字段值在每条记录中相同,且必须匹配特定要求值 |
| CONSISTENT | 字段值在每条记录中相同,但不要求特定值 |
| UNEQUAL | 字段在不同记录间取值不同 |
| EXIST | 字段在每条记录中都出现 |
前置条件推导(Deducing Preconditions)
算法目标是推导出**最弱但安全(weakest yet safe)**的前置条件:对所有通过样本求值为 true、对所有失败样本求值为 false。
推导流程:
- 扫描通过样本,为每个样本找出其所有 trace 记录中均满足的条件;
- 取所有通过样本均满足条件的合取作为候选前置条件;
- 用失败样本验证该合取是否安全:安全则返回;否则进入”欠约束(under-constrained)“处理。
欠约束(under-constrained)有三种成因:(1) 前置条件无法用支持的条件类型表达;(2) trace 信息不足;(3) 不变量在多个前置条件下成立(作者经验中最高频)。此时算法将通过样本按剩余非重叠条件拆分为子组,对每个子组分别推断;若子组推导出的前置条件都安全且联合覆盖所有通过样本,则用析取组合成最终前置条件。若无法再拆分,则报告推断失败。
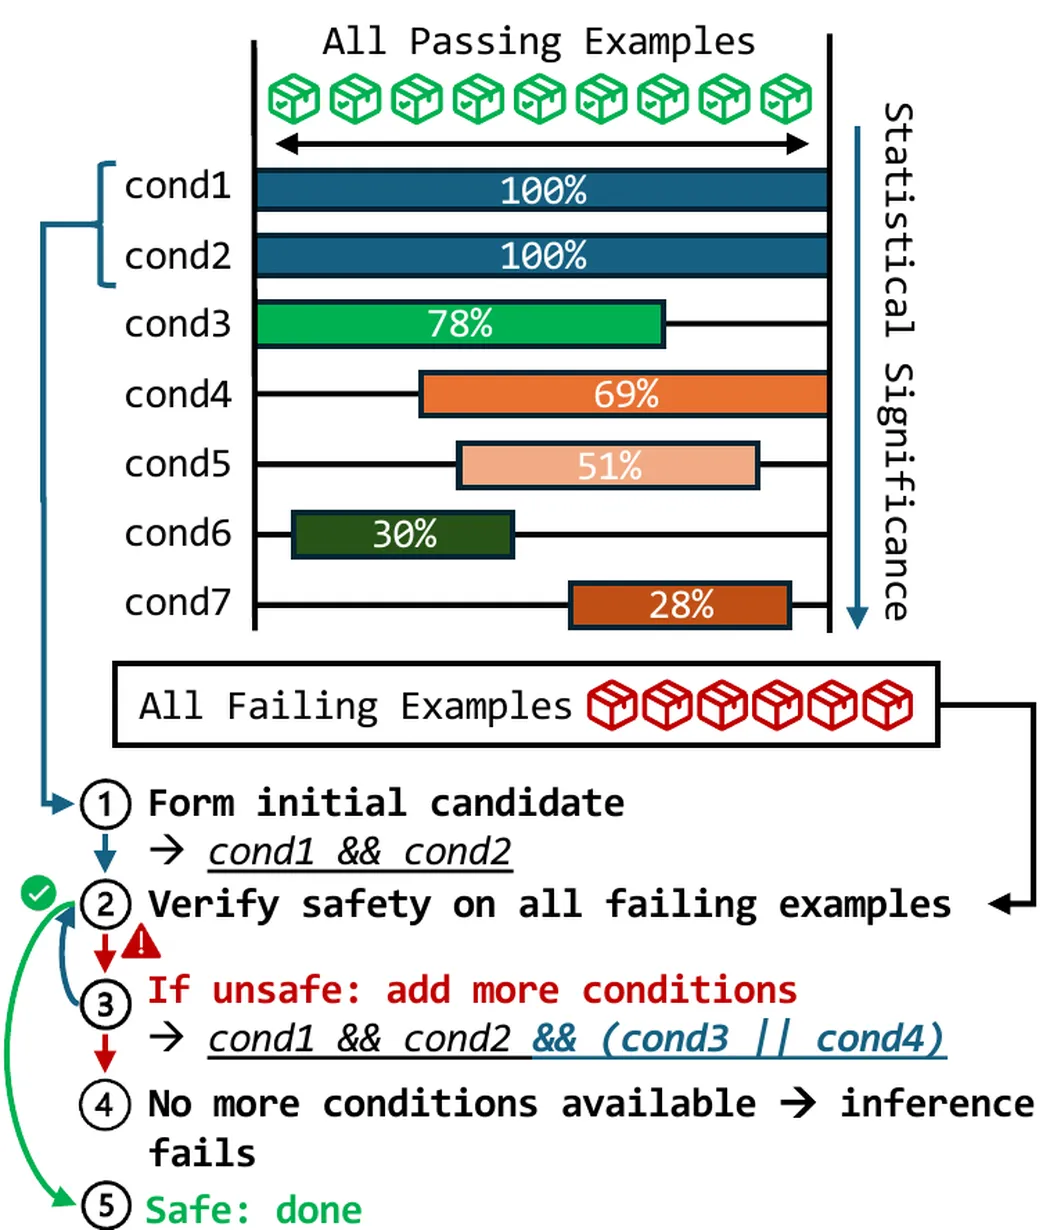
剪枝无关条件(Prune Irrelevant Conditions):trace 中可推断出大量条件,但并非都与不变量相关。例如参数一致性不变量中,所有参数可能都有相同的 is_cuda 属性——用它作条件虽然安全但太浅。TRAINCHECK 在安全验证过程中移除未被任何失败样本违反的条件(如图 4 示例中的 is_cuda 恒为 True 被剪枝)。此外,每个关系可编码”应避免用作条件的属性”规则(如 Consistent 不变量若涉及 torch.Tensor 类型属性,就不能用其他 torch.Tensor 类型属性作条件)。
统计显著性搜索(Statistical significance-based search):当候选前置条件不安全时,按统计显著性降序(即覆盖最多通过样本的条件)逐步添加之前未考虑的条件来进一步约束。如图 5:候选为 cond1 && cond2,不安全;添加 cond3 与 cond4 得到安全的 cond1 && cond2 && (cond3 || cond4);若仍不安全则重复,直到找到安全前置条件或耗尽计算预算。
示例(Figure 4):对 BLOOM-176B 错误推断出的带前置条件不变量(简化):
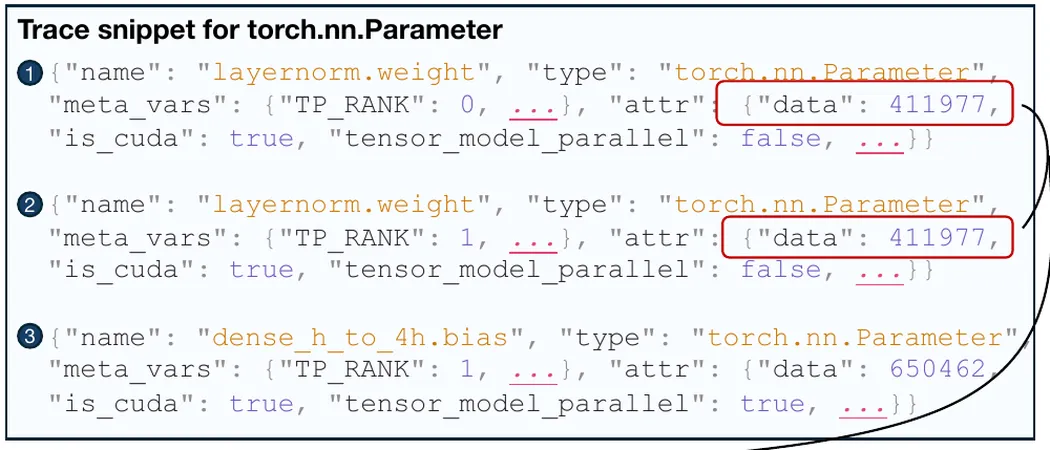
推导过程:初始候选为 CONSTANT(tensor_model_parallel, False) && CONSTANT(is_cuda, True) && UNEQUAL(meta_vars.TP_RANK);is_cuda 恒为 True、未被任何失败样本违反,被剪枝;最终前置条件为:
CONSTANT(\text{tensor\_model\_parallel}, \text{False}) \wedge UNEQUAL(\text{meta\_vars.TP\_RANK}) \tag{1}
过滤表面性不变量(Filtering Out Superficial Invariants)
TRAINCHECK 将无法推导出前置条件的不变量视为表面性(superficial)——它们可能因 trace 信息有限而看似成立(如两个无关 API 的返回值恰好一致),但因不知道何时应用而不能部署。这是降低误报、增强可解释性的关键设计。
与传统不变量挖掘(如 Daikon)不同,TRAINCHECK 不使用通过/失败样本的数量来估计统计显著性。因为在 DL 训练中,大量失败样本并不意味着不变量是表面性的:训练过程多样且复杂,局部语义在全局上下文可能不具统计代表性。例如张量并行中,注意力层的主要参数被切分,只有 LayerNorm 参数被复制,占比不足总参数的 0.1%。在推断中,“torch.nn.Parameter 对象应保持一致”这一不变量在通过/失败样本上的比值为 1:38——按统计显著性方法会被当作表面性而剪枝,但它恰恰是捕获 BLOOM-176B 错误的关键。
可扩展性(Scalability)
DL 训练产生海量 trace。例如对 BLOOM-176B 的 2-GPU、70M 参数预训练运行插桩,每训练迭代产生约 92,000 条 trace 记录(50 MB)。TRAINCHECK 采用两个设计决策应对:(1) 将分析限制在预定义的高层语义关系集合上,大幅缩减搜索空间;(2) 将 API 与变量抽象为描述符——变量按 type(obj) + 属性名(如 data、grad)+ 可选值约束来归纳推理。例如枚举 104 个变量实例会得到 5,356 对组合,而按类型分组后只需考虑 PyTorch 训练相关的类型(主要是 torch.nn.Parameter),大大减少候选不变量数量。
输入要求
生成有效不变量不需要大规模环境:论文中所有被评估的不变量均由至多 4 GPU、至多 100 迭代的训练作业推断。BLOOM 原始训练跨越数百 GPU,TRAINCHECK 用 2-GPU 运行即可推断出相关不变量。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个面向 DL 训练的不变量主动检查框架 | 自动推断并检查针对训练任务定制的不变量,而非泛化高层的 loss/accuracy 信号 | 20 个真实静默错误中检测出 18 个(单迭代内);6 个新 bug |
| 带前置条件的不变量表示 | 不变量只在特定上下文成立;前置条件提供准确性、低误报、可调试、低开销、可迁移 | 4 种条件类型 + 最弱安全前置条件推导算法;跨类 FP 率 <2% |
| 欠约束下的前置条件推导 | 合取候选不安全时,按统计显著性逐步添加条件、拆分通过样本后析取组合 | cond1 && cond2 && (cond3 |
| 表面性不变量过滤 | 无法推导前置条件的不变量不被部署,降低误报、增强可解释性 | 与 Daikon 统计显著性方法的关键差异(<0.1% LayerNorm 例子) |
| 跨 pipeline 迁移性 | 不变量从少量示例 pipeline 推断后可迁移到不同 pipeline 甚至不同库 | >8% 不变量适用于 >16 个 pipeline;PyTorch 专属不变量 23% 适用于 >16 个 |
| 低开销插桩 | monkey-patching(API)+ Proxy(变量)组合,只记录张量哈希;选择性插桩 | 典型开销 <2%,最坏 1.6×;sys.settrace 为 200×–550× 慢 |
| 隐藏变量状态变化的捕获 | 记录训练中影响模型质量的模型/优化器状态(Proxy 拦截 __setattr__),而非任意局部变量 | 88 个静默错误经验:多数非平凡错误影响少量关键对象 |
五、代码实现分析
TRAINCHECK 用 Python 实现,约 22.7K 行代码,由三个组件构成。核心挑战是在”采集细粒度 trace 以推断有效不变量”与”最小化运行时开销”之间取得平衡。
Instrumentor(插桩器)
以命令行工具形式运行,接受入口 Python 程序路径与感兴趣的库列表(如 torch、deepspeed)。自动扫描 import 语句与模型定义,插桩必要函数与变量;也支持 shell 脚本设置环境与参数。Trace 以 JSON 格式写入指定目录。三个设计目标:非侵入性、低开销、高覆盖,且插桩粒度灵活(不同关系需要不同细节:Consistent 仅需周期性采样模型状态,EventContain 需要变量修改时即时报状态)。
- sys.settrace 方案不可行:观测到 200×–550× 减速,且会干扰 pdb、cProfile 等工具。
- 动态 monkey-patching:运行时注入 hooks;支持选择性插桩(只 patch 指定模块);跳过调用频繁但很少为不变量推断提供有意义信息的内部函数(如
torch.jit、torch._C)。 - 变量追踪:CPython 中赋值发生在 C 层,无法高效追踪任意变量。经验表明多数非平凡静默错误影响少量关键对象(模型与优化器);若静默错误不影响模型质量则通常无关紧要。因此用 Proxy 包装模型与优化器,重写
__setattr__等魔术方法拦截状态变化并即时记入 trace。另支持低开销的基于采样的方案:在Optimizer.step注册状态转储回调。 - 记录张量哈希而非值:序列化真实值开销不可承受。观察表明 shape、dtype 与张量间相等关系才是推断不变量所需的。
- meta 变量采集:从调用栈中找到循环索引局部变量(最外层循环中每次迭代递增),或用
set_meta指定;也支持将程序标注为训练/验证/测试等阶段。
Infer Engine(推断引擎)
处理 Instrumentor 生成的 trace,推断不变量与前置条件。面临大数据量挑战(典型 pipeline 每 epoch 数百 MB trace)。实现于 Python,利用数据处理/深度学习生态;由于 trace 无法用固定 schema 表示,实现了多种 trace 后端(Pandas、Polars、内置 dict),默认 Pandas DataFrame + Python 动态类型。引入自定义分析函数的优化:查询缓存、采样、剪枝(如剪掉 torch.cuda.is_available 相关候选)。
Verifier(验证器)
在线阶段,插桩被限制为只与已部署不变量相关的 API 与变量,因此很轻量。Verifier 实时监控 trace 流,当相关 trace 到达时触发检查:先评估不变量前置条件是否满足,满足则检查不变量是否成立。检测到违反时,报告不变量及对应 trace,为开发者提供调试帮助。
六、实验结果
实验环境
- Ubuntu 22.04,Intel Xeon Silver 4310 CPU,252 GB RAM,1× NVIDIA A40 GPU;
- 分布式训练相关 trace 采集:相同规格服务器但配 8× NVIDIA A2 GPU;
- Python 3.10,PyTorch 2.2.2,CUDA 12.1。
静默错误实证研究
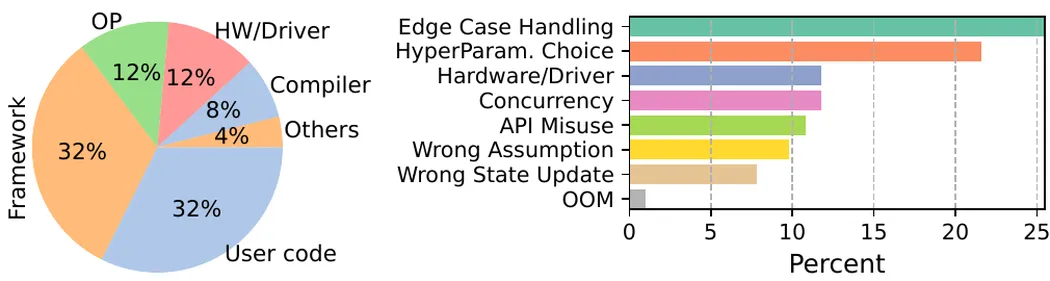
共收集 88 个已知根因的静默错误:70 个 GitHub issue、16 个讨论论坛(StackOverflow、PyTorch Forums)、2 个工业报告。根因位置分布(Fig. 2a):用户代码 32%、框架 32%、数学运算 12%、硬件 12%、编译器 8%、其他 4%。用户代码引发的错误分两类:①错误实现(缺失/错误/不一致的 API 调用或参数更新,如漏掉 zero_grad()、在模型变换前初始化优化器);②不当设计选择(不合适的 loss、过激的 dropout、有问题的数据管线)。根因类型(Fig. 2b)包括 API 误用、错误状态更新、错误假设、并发、超参选择、边界情况处理、OOM 等。
后果严重:BLOOM-176B 涉及 384 张 A100 GPU、3.5 个月训练;PyTorch-Forum-84911 中数据预处理误将图片 resize 为 1024×1024(期望 224×224),显著拉长每迭代时间。检测与诊断困难:根因早早触发却长时间不被发现;开发者依赖 loss/accuracy 等信号,但静默错误往往不引起即时异常,且这些信号噪声大。
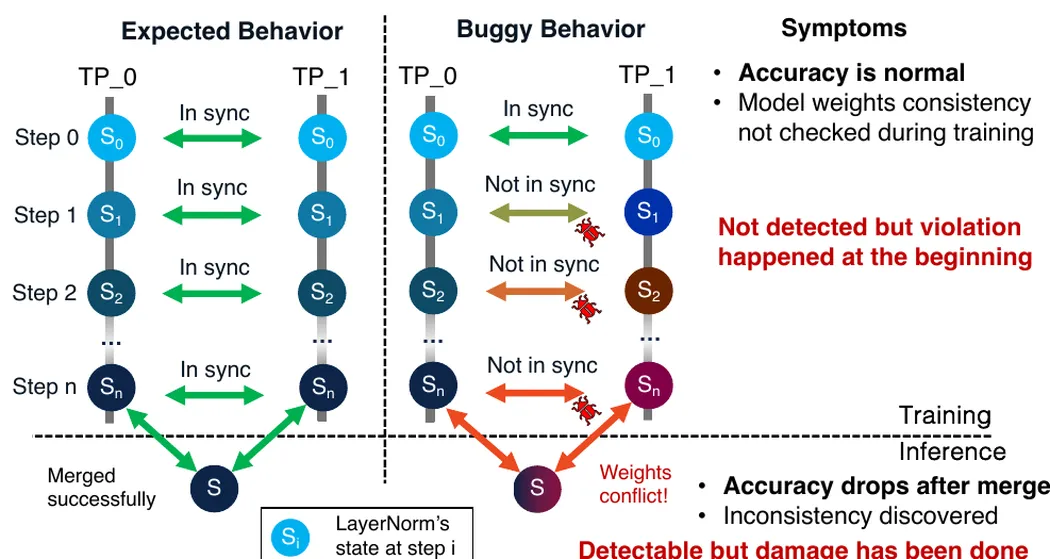
BLOOM-176B 案例(DeepSpeed-1801):DeepSpeed BF16Optimizer 的梯度裁剪 bug 只在前几个 GPU 上对未切分层启用,导致 LayerNorm 权重用不同梯度更新、跨 TP rank 静默发散。不触发异常、不立即影响 loss/accuracy;只有当跨 GPU 的模型需要合并为单个 checkpoint(训练完成要部署/微调,或中途改并行配置)时才暴露。10 天检测 + 9 天合并权重。
小规模复现(Table 1):用 CodeParrot clean 数据集训练小型 transformer 语言模型,4 TP rank + 2 DP rank:
| 迭代 | 数据集 | Loss Diff | PPL Diff | Diff (Loss/PPL) |
|---|---|---|---|---|
| 2000 | Valid | +1.14% | +1.43% | +0.014 / +0.050 |
| 2000 | Test | +2.74% | +3.30% | +0.032 / +0.107 |
| 4000 | Valid | +3.05% | +3.36% | +0.033 / +0.099 |
| 4000 | Test | +4.67% | +4.79% | +0.047 / +0.131 |
权重合并导致 loss/perplexity 差异随迭代数增加而增大。
PyTorch-115607 案例:torch.dynamo(JIT 编译器)缺少 guard,导致只做 forward 不做 backward 的迭代中模型不更新。可检测(整个模型不更新)但难诊断——若不转储每迭代 loss/accuracy,开发者无从得知模型何时停止更新。
检测效果(Detection)
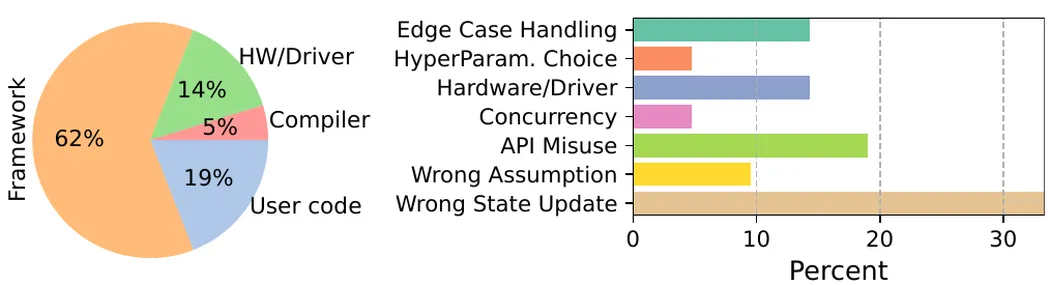
从研究样本中选 6 个 + 新收集 14 个,共复现 20 个真实静默错误,覆盖多样根因位置与类型(上图为复现错误的根因分布)。TRAINCHECK 检测出 18 个,全部在根因触发后不晚于一个训练迭代内发现。以 BLOOM 为例,错误的梯度裁剪逻辑在第 2 个迭代触发,TRAINCHECK 在第 3 个迭代即检测到。使用的不变量覆盖 Table 2 全部五类关系。
对比基线:
- Spike 检测器(监控 loss/accuracy 数值尖峰,阈值 75):信号类检测器合计只检出 2 个(均为模型完全停止学习、loss 恒定跨 epoch 的极端情况);
- Trend 检测器(监控 loss/accuracy 未按预期下降/上升,容忍度 3):同上;
- 异常检测器(LOF k=2、Isolation Forest contamination=0.1、Z Score):无论怎么调参都会在整个训练过程中大量告警;
- PyTea / NeuRI(张量 shape 约束,先验静态):只检出 1 个(transformers 库中处理数据 batch size 与参数不符的错误)。
检测失败的两例:
- TF-33455:trainer 因错误计算总训练步数而提前停止,训练过程本身正确。需监控计算出的步数与预期参数对比——TRAINCHECK 当前不支持追踪 Python 基本类型变量(代价过高且需改 Python 运行时)。
- TF-29903:
safe_checkpoint函数内构造了损坏的 state dict。错误局限于 checkpoint 函数、不影响主训练逻辑,且 TRAINCHECK 不分析局部变量。
诊断:18 个检出错误中,违规报告精确定位根因 10 个、接近根因 8 个。虽然诊断不是 TRAINCHECK 的首要目标,但不变量违规信息显著辅助了根因分析。
新发现的静默错误(Table 3)
监控 DeepSpeed 与 Transformers 近期未解决的 GitHub issue,TRAINCHECK 检出 6 个此前未知的静默错误,全部获确认,其中 3 个已被修复:
| Bug ID | 摘要 |
|---|---|
| AC-2665 | 在将模型包装为 DDP 之前初始化优化器,导致训练不前进 |
| DS-6770 | 模型与优化器持有的参数不匹配,初始化时触发 KeyError |
| DS-5489 | 在初始化 DeepSpeed 前冻结参数,导致模型 checkpoint 不完整 |
| DS-6714 | 异构 MoE 架构与 pipeline 并行结合时通信原语使用不一致,导致训练卡住 |
| DS-6772 | DeepSpeed 初始化静默覆盖模型的 “id” 属性,导致错误的模型-GPU 放置 |
| DS-6089 | 各 worker 上 “capacity” 值一致导致通信卡死 |
AC-2665 案例分析:用户将 pipeline 适配为 DDP 后模型完全停止学习,且不知道根因——只发现一个能规避错误的设置 use_orig_param true。将 GCN 示例推断的不变量应用到其 pipeline 后,发现三个真阳性:
- Inv1:
zero_grad应包含 grad 属性从非零张量变为零张量或 None 的变化; - Inv2:
step应包含模型参数data属性的变化; - Inv3:
step应包含对模型参数进行的数学运算(如_foreach_add)调用。
Inv2/Inv3 表明优化器未执行模型更新,Inv1 表明没有计算梯度。三者结合指出:优化器很可能没有用实际前向/后向所用参数初始化。检查后确认:DDP 自动展平原始模型参数并创建新模型,但用户用原始模型参数初始化优化器,导致优化器没有正确的参数可更新。该问题已上报用户与 transformers 团队并获确认,修复 PR 在审核中。
误报率(False Positive)
收集 63 个无已知 bug 的多样训练程序(覆盖不同规模、框架 PyTorch/Transformers/Diffusers、任务图像分类/语言建模/视觉 Transformer 预训练、配置精度/batch size/数据集/模型架构),按任务类型分为四类:CNN 图像分类、语言建模、扩散模型、视觉 Transformer。每类划分为训练集(推断不变量)与验证集(评估误报);验证集进一步分为跨配置(cross-configuration)(与训练集仅配置参数不同)与跨 pipeline(cross-pipeline)(不同代码、语义相似)。
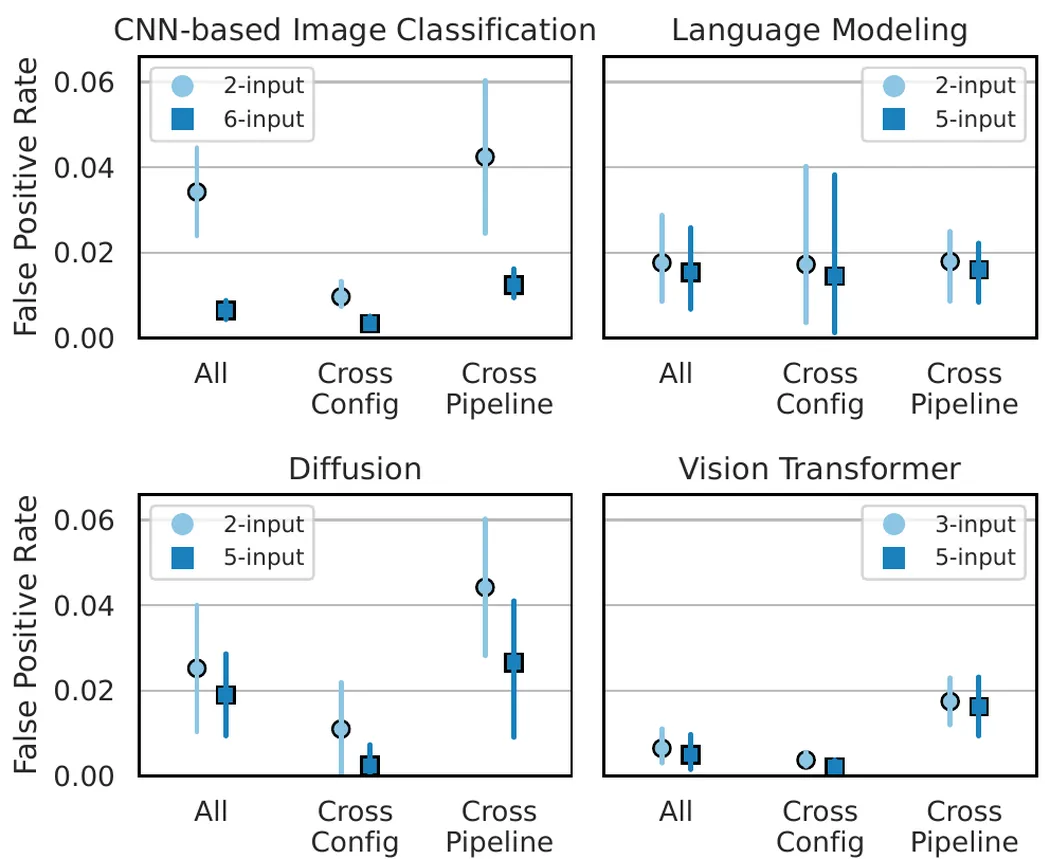
主要评估设置(5/6 个输入程序推断不变量)下,四类程序的误报率均低于 2%;即使仅用 2–3 个输入程序,误报率仍低于 5%。跨类极端迁移(用一类推断、应用到其他类)的评估中,仅最小的 CNN 类误报率偏高(2.62% vs 类内 0.65%),其余类相当或更低(如语言建模 0.93% vs 1.54%)——因为许多不变量因 API 用法与训练上下文不同而不适用。
不变量迁移性(Transferability)
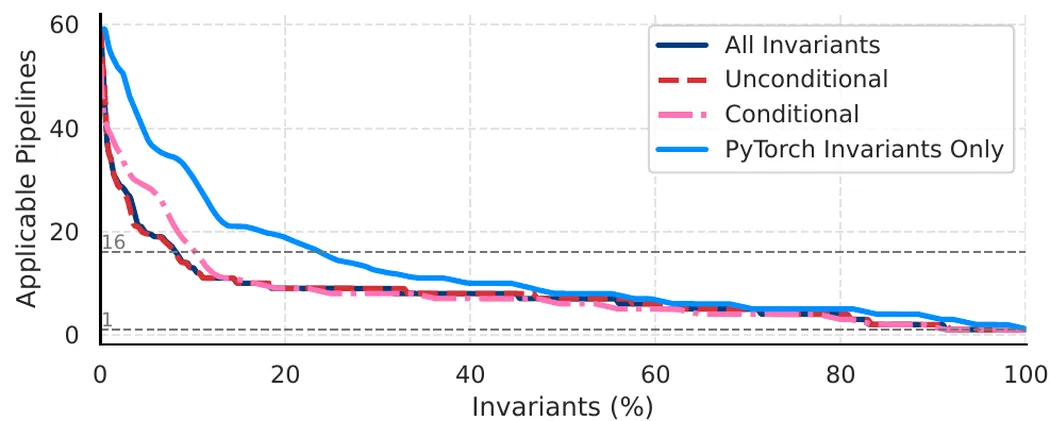
将有效的(在 §5.3 中无误报的)不变量应用到全部 63 个 pipeline,统计每个不变量可应用(不产生误报)的 pipeline 数:
- 所有不变量都至少可应用到 1 个推断之外的 pipeline;
- 超过 8% 的不变量适用于超过 16 个 pipeline(每类 pipeline 的平均数),展现强跨类泛化;
- 带前置条件(Conditional)的不变量普遍比无条件(Unconditional)的更可迁移,凸显精确前置条件推断的重要性;
- 由于全部 pipeline 均用 PyTorch,隔离出 8,172 个仅捕获 PyTorch 专属语义的不变量:其中 23% 适用于超过 16 个 pipeline,表明框架级行为是可复用不变量的强来源。
漏报 / 检测率随输入程序数(False Negative)
评估三种设置:跨配置(从同一 pipeline 未观察到静默错误的历史配置推断)、跨 pipeline(从语义相似、无错误的 pipeline 推断)、随机(从通用教程 pipeline 推断)。对每个检出的静默错误,随机采样 k 个输入 pipeline,重复 100 次求平均检测率。
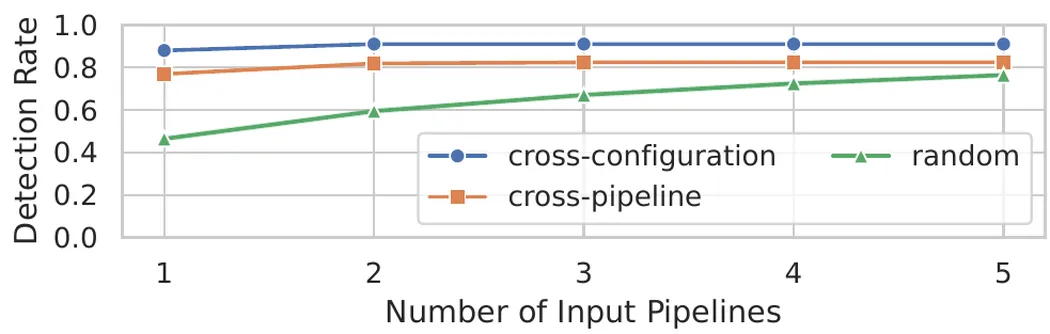
- 跨配置与跨 pipeline 设置下,仅 2 个输入程序即达到高检测覆盖(91% 与 82%);
- 随机设置起点较低,但随着输入增加稳步提升(5 个输入时 76%);
- 未检出的静默错误涉及示例 pipeline 中代表性不足或未触发的专门特性,如 DeepSpeed-5794 需要 DeepSpeed MoE 特性,但 15 个 DeepSpeed 教程 pipeline 中只有 1 个做 MoE 训练。
运行时开销(Overhead)
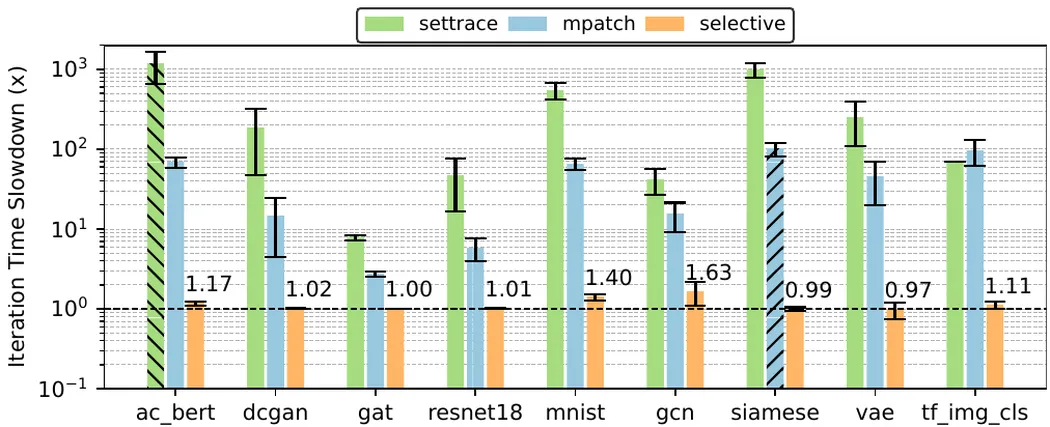
对多样训练程序各部署 100 个随机采样的不变量,对比选择性插桩与两个基线(sys.settrace;TRAINCHECK 全量插桩模式)。选择性模式下 TRAINCHECK 开销典型低于 2%,全部负载最坏 1.6×。GCN(1.6×)与 MNIST(1.4×)等玩具负载相对开销较高(每迭代执行时间极短,插桩占比大);更真实的工作负载开销显著更低(更大比例时间花在 GPU 计算上)。主要开销来源:trace 序列化为 JSON、对象转 dict、追踪对象的处理——均在 Python 层,且当前实现为同步、优先正确性与模块化。
推断效率(Inference Efficiency)
以 ResNet-18 预训练 trace(20 训练迭代 + 10 测试迭代,66.2 MB / 93,686 条记录)为标准程序规模:
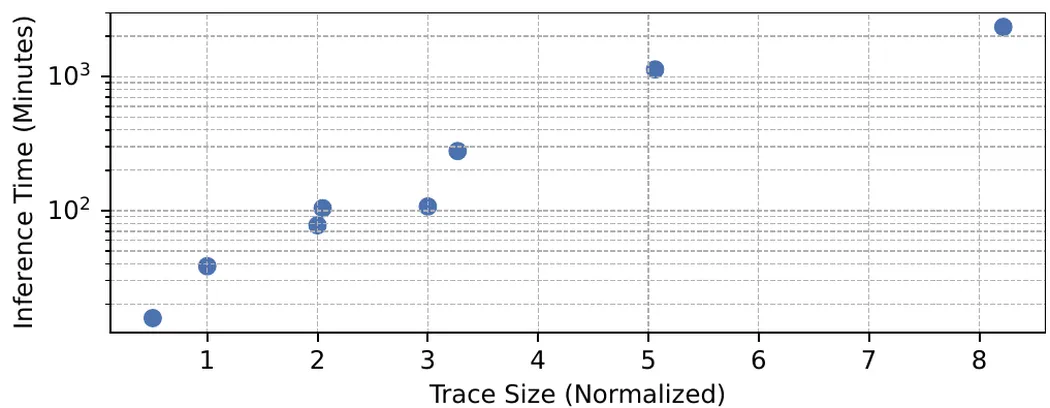
推断时间随 trace 规模近似二次增长。算法本身对 trace 规模与假设数都是线性的,但更大 trace 暴露更多语义行为,导致更大假设集。最坏情况 38 小时(处理 8.2 个标准程序的 trace)。由于推断离线运行且当前实现单线程,该性能对实际使用可接受。
检查违规报告(Examining Invariant Violations)
检查违规报告(Examining Invariant Violations):即使误报率低,误报仍会发生,开发者需从中提取可行动的诊断信息。作者发现违规通常可按结构检查而非孤立看待:违规往往聚集在特定 API 或组件周围,使审查更可控;真阳性常被多个相互印证的违规支撑,而误报遵循可辨识的模式、容易排除。以 AC-2665 为例(§5.2 案例),仅用 PyTorch GCN pipeline 推断的不变量报告了 100 个违规:52 个真阳性(33 个指示 torch.optim.adamw.adamw 从未被调用——缺失优化器初始化;18 个显示 optimizer.step 未做数学运算——未关联模型参数);48 个被快速排除(7 个 GCN 专属常量如 dropout_rate == 0.5,26 个缺失 ReLU 调用——不适用于 AC-2665 的 T5 模型)。
七、相关工作
| 方向 | 代表性工作 | 与 TRAINCHECK 的关系 |
|---|---|---|
| 传统不变量挖掘 | Daikon [16], DIDUCE [19] | 关注低层变量关系(如 var1 > var2),无法捕获 DL 训练高层语义 |
| 归纳不变量(分布式协议验证) | I4 [30], DistAI [49], DuoAI [48] | 面向分布式协议的形式化验证,非训练正确性 |
| 分布式系统静默失败规则 | Oathkeeper [29] | 推断事件规则检测分布式系统静默失败;TRAINCHECK 面向 DL 训练这一新领域 |
| 通用规则推断(bug 检测) | Engler et al. [15] | 从程序员信念推断规则;TRAINCHECK 面向 DL 训练系统独特挑战 |
| 框架/编译器差异测试 | CRADLE [33], AUDEE [18], LEMON [44], NNSmith [27] | 跨后端/编译器的差分测试;TRAINCHECK 推断与训练过程适配的运行时不变量,覆盖更广静默失败 |
| API shape 约束 | PyTea [22], NeuRI [28] | 先验约束张量 shape;TRAINCHECK 自动推断针对训练定制的高层语义不变量并推导前置条件 |
| 数值缺陷检测 | RANUM [25] | 面向数值缺陷;TRAINCHECK 记录张量哈希,无法做细粒度数值分析(可与 RANUM 互补) |
| 训练动态监控 | TensorBoard [1], Weights & Biases [5] | 记录高层指标但需人工主动监控(如 BloombergGPT 训练中 loss 平台期持续 7 天开发者才注意到),噪声大、易误报、无诊断价值 |
| DL 模型测试 | DeepXplore [32], DeepTest [43] | 测试最终模型权重而非验证训练过程,与 TRAINCHECK 正交 |
| 容错机制 | Varuna [3], Oobleck [21], Bamboo [42], Universal Checkpointing [26] | 提升容错能力,但不解决配置/代码/正确性违背引起的静默错误 |
八、总结
核心贡献
- 对 DL 训练中鲜为人知但影响巨大的静默错误问题进行实证研究(88 个真实错误),揭示其根因位置/类型、严重后果与检测诊断困难;
- 提出用训练不变量主动验证 DL 训练、捕获静默错误的方法,并设计带前置条件的不变量表示;
- 设计并实现 TRAINCHECK——据作者所知,首个自动推断并检查面向 DL 训练任务定制不变量的框架(Instrumentor + Infer Engine + Verifier,22.7K 行 Python);
- 在 20 个真实静默错误上评估:18 个单迭代内检出、6 个此前未知 bug(3 个已修复)、误报率 <2%、典型开销 <2%、不变量可跨 pipeline/框架迁移。
技术影响
- 证明”选择正确的观察层级”可以让训练不变量变得简单而精确——低于模型评估信号、又高于传统软件不变量;非确定性是检查层级过高的产物。
- 前置条件机制使不变量可迁移:从少量教程/示例 pipeline(≤4 GPU、≤100 迭代)推断,即可部署到大规模真实训练。
- 提供诊断线索:违规报告在 18 例中 10 例精确定位根因、8 例接近根因,显著降低人工排查成本。
- 为 DL 训练可靠性提供了一个主动、连续、自动化的安全网,与事后指标监控、静态 shape 检查形成互补。
局限性
- 与 JIT 编译冲突:插桩会干扰 torch.compile 等 JIT 工具,无法分析优化后的代码路径;
- 仅限 Python 代码:无法分析 FlashAttention 等底层语言实现的重要逻辑组件;
- 张量哈希化:丢失细粒度数值信息,无法检测由不当超参导致的数值不稳定(可与超参调优 [50]、数值缺陷检测 [25] 互补);
- 不追踪 Python 基本类型变量:导致 TF-33455 这类错误无法检测(代价过高且需改 Python 运行时);
- 不分析局部变量:导致 TF-29903(confined 到 checkpoint 函数的错误)漏检。
九、参考资源
- 论文主页: https://www.usenix.org/conference/osdi25/presentation/jiang
- PDF: https://www.usenix.org/system/files/osdi25-jiang.pdf
- 代码仓库: https://github.com/OrderLab/TrainCheck
- 技术报告: “Training with Confidence: Catching Silent Errors in Deep Learning Training with Automated Proactive Checks (Technical Report)”, University of Michigan, 2025
- 图片来源: 11 张图片由 MinerU API(vlm 模型)从 USENIX 官方 PDF 提取的图图像缩放生成(Fig.2/6 为左右子图合成),等比缩放至宽度 1050px,索引见
figures/traincheck/README.md,映射关系由content_list.json的图注字段确定 - MinerU 全文提取: 通过 MinerU API(vlm 模型)提取的全文 Markdown 与结构化元数据存档于
mineru_output/traincheck/(full.md584 行 / 93,366 字节,16 张干净裁剪图,content_list.json332 条目:206 文本 + 9 图表 + 3 表格 + 3 代码块 + 54 引用文本),本分析文档已与之一致性核对