Tawa: Automatic Warp Specialization for Modern GPUs with Asynchronous References(Tawa:面向现代 GPU 的异步引用自动 Warp 特化编译器)
CGO 2026 论文,Cornell + NVIDIA 合作。提出 Tawa——首个面向现代 NVIDIA GPU(Hopper+)的**全自动 warp 特化编译流程**,从未经修改、无标注的 Triton 程序出发,自动分区为 producer/consumer warp group,自动管理软件流水线。核心创新是**异步引用(asynchronous reference, aref)**——一种形式化语义保证的 IR 抽象,将 warp 间通信建模为带硬件 mbarrier 的单槽信道(put/get/consumed),封装 TMA 描述符配置、mbarrier 初始化/相位管理等底层细节。编译器三步变换:① 基于语义标记的任务感知分区(iteration stmt → producer, tile stmt → consumer,依赖闭包 + 计算复制);② 基于 aref 的多槽环形缓冲自动构建跨 warp 数据流;③ 多级软件流水线(细粒度:CUDA 地址计算与 MMA 重叠;粗粒度:CUDA Core 变换与 TC 流水线装配线)。额外优化:协作计算 warp group(多 WG 共享 tile 寄存器预算)、持久化 kernel。在 H100 上:GEMM 达 cuBLAS 水平(FP16 +1.01×,FP8 +1.06×);Attention 达 FA3 手工优化内核的 96%,超 Triton 1.21×。ablation 显示 +Auto WS 提升 3.78×,最终 GEMM 达 718 TFLOPs/s(baseline 的 ~7×)。
Tawa: Automatic Warp Specialization for Modern GPUs with Asynchronous References(Tawa:面向现代 GPU 的异步引用自动 Warp 特化编译器)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Tawa: Automatic Warp Specialization for Modern GPUs with Asynchronous References |
| 作者 | Hongzheng Chen, Evghenii Gaburov, Jason Knight, Bin Fan, Masahiro Masuda, Zhiru Zhang, Alexander Collins, Matthew Brookhart, Vinod Grover, Bastian Hagedorn, Chris Sullivan |
| 机构 | Cornell University / NVIDIA |
| 会议 | CGO 2026(ACM/IEEE International Symposium on Code Generation and Optimization) |
| csl.cornell.edu/~zhiruz/pdfs/tawa-cgo2026.pdf | |
| 硬件 | NVIDIA H100 SXM5 80GB, CUDA 12.7 |
| 基准 | GEMM(FP16/FP8)、Batched/Grouped GEMM、Multi-Head Attention(FP16/FP8) |
一句话总结:Tawa 是 CudaDMA → Singe → Twill 这条 warp 特化研究血脉的又一延伸,但路线不同——Twill 用 SMT 求解器自动发现最优调度;Tawa 则面向实际工程,目标是让程序员写普通的 Triton 代码(enable_warp_specialization=True 一键开启),编译器自动完成分区、数据流管理和多级流水线,达到甚至超越手写 CUTLASS C++ FlashAttention-3 的性能。
二、核心问题:SIMT 编程模型与现代 GPU 架构的根本错位
现代 GPU(Hopper/Blackwell)已从同质处理器演变为异构系统:除 CUDA 核心外,集成了 Tensor Core(密集矩阵计算)和 TMA(异步数据搬运)。这启发了异步数据流执行模型——数据搬运可与计算显式重叠。然而,SIMT 编程模型(CUDA/Triton 的基础)假设 warp 内所有线程执行相同指令,无法表达不同 warp 承担不同角色的需求。
这造成三大编程挑战:
| 挑战 | 说明 |
|---|---|
| ① 协调并发 warp 角色 | SIMT 缺乏 warp 角色分配的一等抽象,开发者须手动用复杂条件分支封装异构角色;Triton 等高级 DSL 仍保留 SIMT 中心抽象,无法自然表达 warp 特化 |
| ② 底层通信管理 | CUDA 无 C++ 级 TMA/mbarrier 接口,须用内联 PTX 配置 TMA 描述符、初始化 mbarrier、编排同步——涉及 arrival count、barrier phase、shared memory aliasing,微妙错误导致死锁 |
| ③ 资源分配与流水线编排 | 有效重叠 producer/consumer 须手动实现深层软件流水线:管理 shared memory 多缓冲、划分 prologue/main/epilogue、平衡寄存器/shared memory 占用率——设计决策紧密耦合,优化空间巨大且繁琐 |
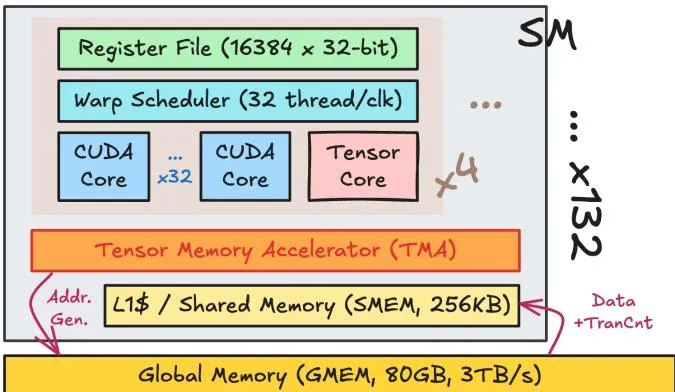
三、Tawa 编译器架构(Section III)
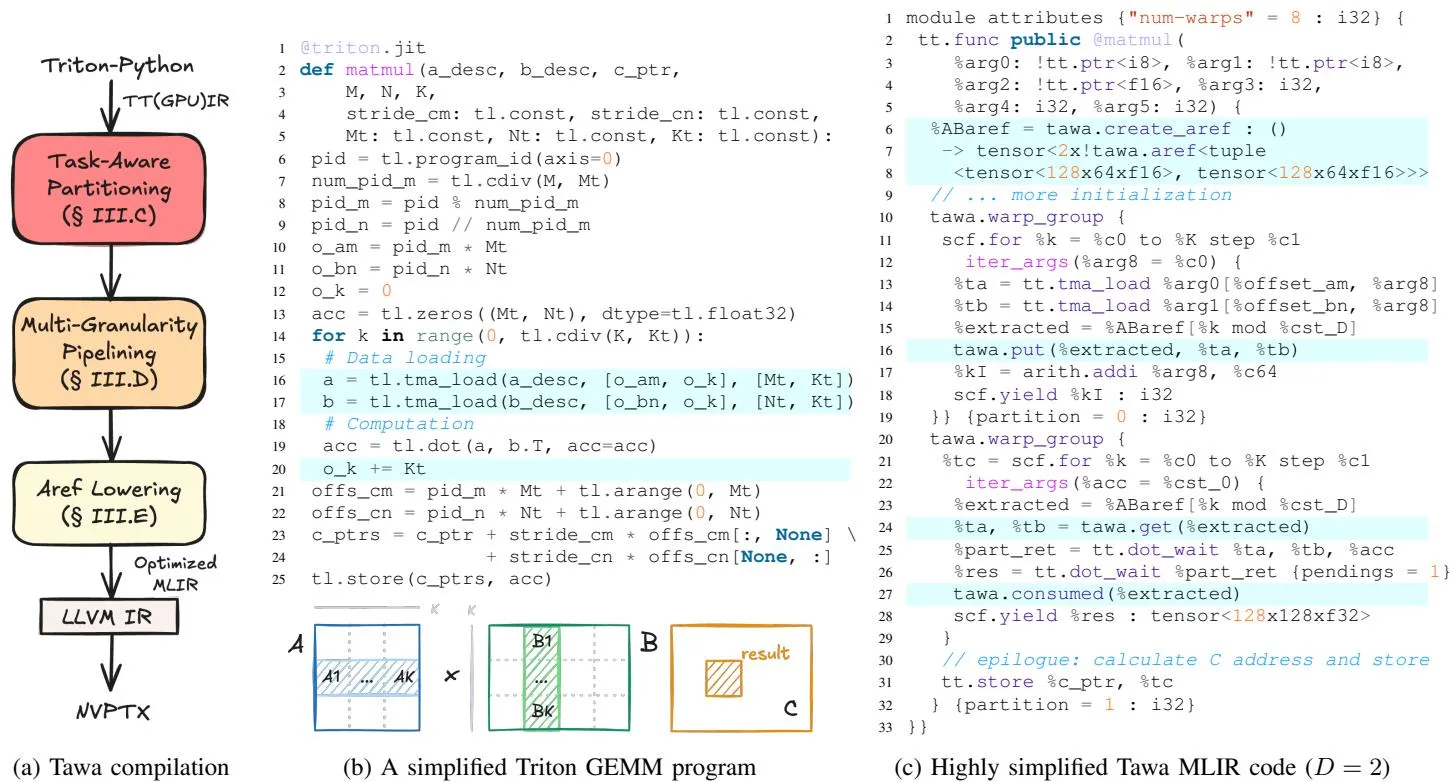
Tawa 对未经修改、无标注的 Triton 程序执行三步变换:
- 任务感知分区(Task-aware partitioning):将程序分为 producer/consumer warp group(解决挑战 ①)
- 异步引用抽象(asynchronous reference, aref):以一等 IR 值表达 warp 间通信,自动插入同步和数据搬运(解决挑战 ②)
- 多级软件流水线(Multi-granularity pipelining):在 aref 程序上编排通信与计算的重叠(解决挑战 ③)
产出 IR 经标准 Triton 编译管线降至 LLVM IR → PTX。
3.1 异步引用 aref(§III-B)
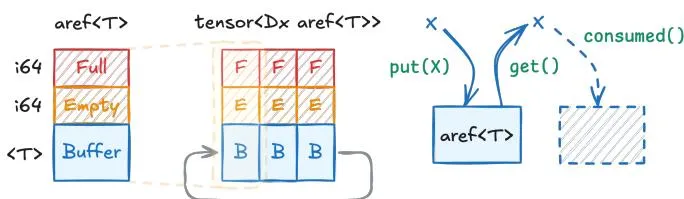
aref 是 Tawa 的核心创新——一个 IR 抽象,建模 GPU 上 producer 与 consumer 之间的单槽信道,由硬件 mbarrier 实现两个同步原语:empty 和 full。任一时刻恰好一个 barrier 编码槽状态:
E=1, F=0(初始):槽空,producer 可写E=0, F=1:槽满,consumer 可读
aref 暴露三个操作,其形式化运算语义如下:
PUT:   σ(a).E = 1  ⇒  ⟨σ, put(a,v)⟩ → ⟨σ[a↦⟨buf=v, F=1, E=0⟩], ε⟩
GET:   σ(a).F = 1  ⇒  ⟨σ, get(a)⟩ → ⟨σ[a↦⟨buf=σ(a).buf, F=0, E=0⟩], σ(a).buf⟩
CONSUMED: ⟨σ, consumed(a)⟩ → ⟨σ[a↦⟨buf=σ(a).buf, F=0, E=1⟩], ε⟩时序链:
put(a,v):要求槽空 → 写 payload → flip 到 full(在 full mbarrier 上 arrive)→ 数据对 consumer 可见get(a):要求槽满 → 读 buffer → 进入 borrowed 状态(F=E=0,值在使用中但槽不可重用)consumed(a):consumer 不再需要值 → 在 empty mbarrier 上 arrive → 恢复 empty credit → 启用下一次 put
aref 是类型泛型的
<T>,支持 tensor/tuple 等结构化 payload;多个 aref 可分组为深度 D 的环形缓冲区,支持深层流水线。
与 OpenCL pipe 等构造不同,aref 专为 GPU warp 间通信设计,语义根植于硬件 mbarrier 同步,提供清晰的排序模型。
3.2 任务感知分区(§III-C)
从 MLIR 计算图出发,两步完成分区:
Step 1:语义标记(Partition Annotation)
反向遍历 use-def 链(从 Store 等 side-effecting sink 出发),按效果标记节点:
- Iteration statements(橙色):贡献地址计算(如 TMA 的指针算术)
- Tile statements(蓝色):转换/消费 tile 进行实际计算(如 WGMMA)
据此做图割:iteration statements + 其支配的 TMALoad → producer partition;tile statements + 其依赖 → consumer partition。跨 partition 共享节点(如地址计算被两者共用)→ 复制计算,确保每个 partition 自包含。
Hopper 上典型配置:Producer = WG0(load warp group),Consumer = WG1(compute warp group),epilogue 附属于 WG1。
Step 2:循环分发(Loop Distribution)
对每个跨 partition 边,创建大小为 D 的 aref 环形缓冲(D 选择以最大化 TMA 传输与 TC 计算的重叠)。在 producer 侧插入 put(slot index = k mod D),consumer 侧插入 get,计算完成后插入 consumed。
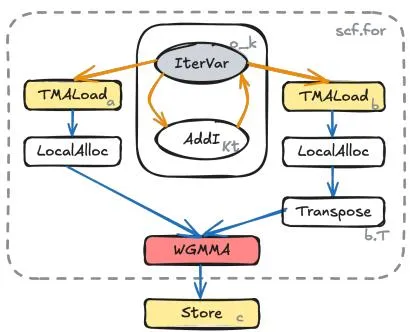
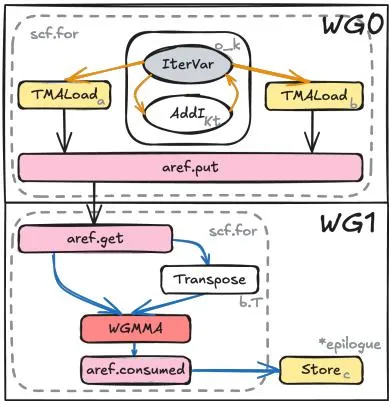
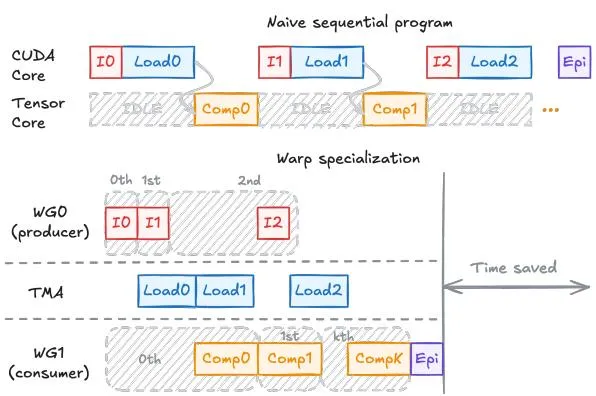
分发后产生两个 WG 区域,各自携带等距 scf.for 循环。跨 warp 通信由 aref 完成。
3.3 多级软件流水线(§III-D)
细粒度流水线(Fine-Grained Pipeline)
重叠 CUDA 核心上的地址计算与 Tensor Core 上的 MMA 执行,深度为 P:
- 每迭代异步发射下一个 MMA(
WGMMA.issue(k)) - 当挂起操作达最大深度 P 时阻塞(
WGMMA.wait(pendings=P)) - 一旦填充,释放迭代 k-P 的结果引用(
aref.consumed(k-P)) - 末迭代后 epilogue 排空流水线
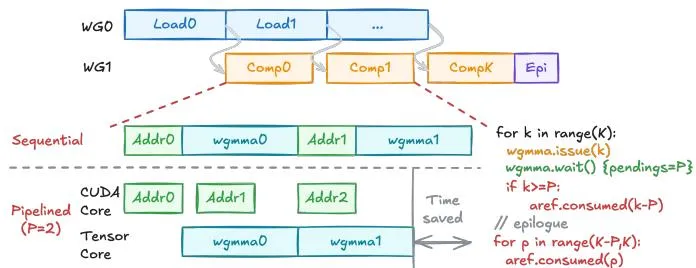
粗粒度流水线(Coarse-Grained Pipeline)
当循环含 CUDA Core 计算时,形成三阶段 producer-transform-(optional)consumer 装配线:
Algorithm 1: 粗粒度 CUDA 与 Tensor Core 流水线
输入: Tile 数 N; 布尔 USE_U
Prologue;
MAYBEAREFGET(T₀); ISSUEANDCOMMIT(T₀); DOTWAIT(T₀); // 物化 T₀ 输出
MAYBEAREFCONSUMED(T₀); COMPUTE(C₀);
Steady state;
for j ← 1 to N - 1 do
   MAYBEAREFGET(Tⱼ); ISSUEANDCOMMIT(Tⱼ);
   if USE_U then MAYBEAREFGET(Uⱼ₋₁); ISSUEANDCOMMIT(Uⱼ₋₁);
   DOTWAIT(Tⱼ₋₁); // 确保 Tⱼ₋₁ 结果可见
   MAYBEAREFCONSUMED(Tⱼ₋₁); COMPUTE(Cⱼ₋₁);
   if USE_U then DOTWAIT(Uⱼ₋₁); MAYBEAREFCONSUMED(Uⱼ₋₁)
Epilogue; DOTWAIT(Tₙ₋₁); MAYBEAREFCONSUMED(Tₙ₋₁); COMPUTE(Cₙ₋₁); ...
每迭代 j 有:TC 阶段 (产中间 tile)、CUDA Core 阶段 (变换中间 tile,如 softmax/activation)、可选下游 TC 阶段 (消费变换结果)。
- Stage 识别:从 MLIR 图中按 dialect/type 线索切分——TC micro-tiles 及其胶水 → T(可能有 U 如果第二 TC 阶段),算术/归一化/激活/规约/布局变换 → C。
- 例如 Attention: → T,softmax → C,第二 GEMM → U。
3.4 aref 降级(§III-E)
将高层 aref 变换为 GPU 上直接执行的显式同步和内存搬运指令:
create_aref:声明 buffer + 分配 mbarriersput→ 异步 TMA load + empty/full barrier 保护get→ 阻塞等待对应 full barrierconsumed→ 在 empty barrier 上 arrive
**关键:奇偶校验机制(parity mechanism)**避免死锁——每次操作交替使用两套 barrier(由迭代奇偶索引)。奇偶切换时,若数据已生产,consumer 可跳过等待;producer 可安全重用 buffer slot。
3.5 额外优化(Section IV)
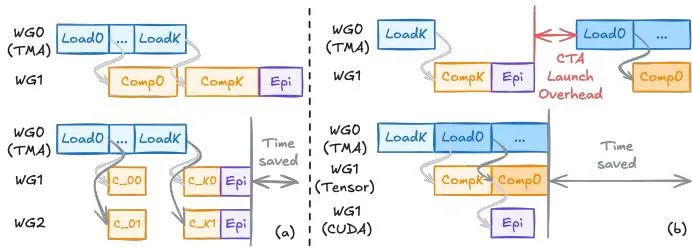
协作计算 warp group(§IV-A):WS 执行的限制是每个 warp group 寄存器预算有限,限制最大 tile 大小和计算强度。优化:多个 consumer warp group 协作计算同一 tile(如图 7a,WG1+WG2 共同消费 WG0 产生的数据)。通过池化寄存器形成更大 tile → 提高算术强度、改善数据复用、减少访存。无需修改 aref 抽象。
持久化 kernel(§IV-B):重复 kernel 发射引入显著 CTA launch 开销。优化:仅发射等于 SM 数的 CTAs 并保持驻留,由驻留 CTA 负责迭代处理多个 tile(如图 7b)。消除重发射延迟,重叠 TMA 加载、TC 计算、CUDA Core epilogue。
四、实验结果(Section V)
对比基线:cuBLAS (v12.7)、CUTLASS (v4.0.0)、Triton(同 commit)、ThunderKittens、TileLang。所有基线用固定 tile size 组合 {64, 128, 256} 手工调优。Tawa 的 aref 大小和 MMA 深度手动选择以最大化性能。
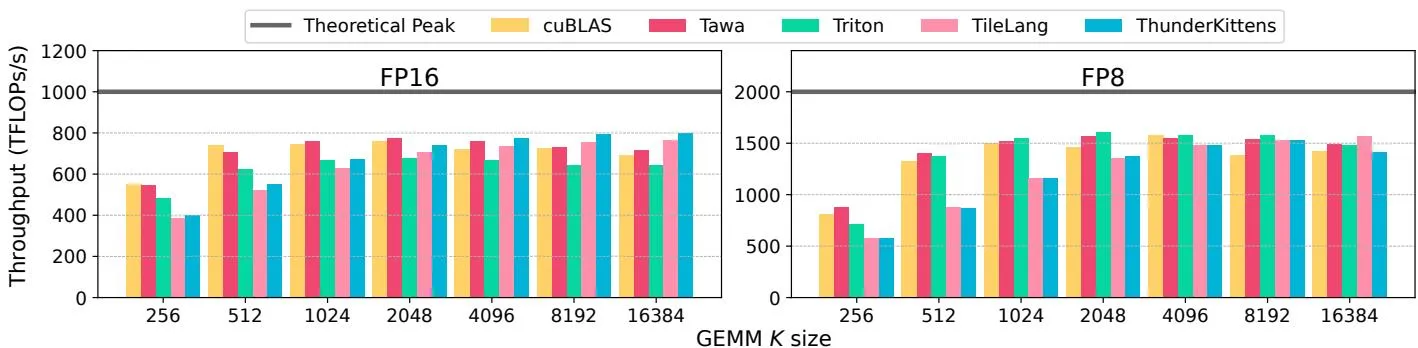
4.1 GEMM(§V-B)
M=N=8192,K 从 256 扫到 16384。
| 精度 | vs cuBLAS | vs Triton | vs TileLang | vs ThunderKittens |
|---|---|---|---|---|
| FP16 | +1.01× | +1.13× | +1.15× | +1.09× |
| FP8 | +1.06× | +1.02× | +1.22× | +1.24× |
- 最高达 79% 硬件利用率(FP16/FP8 均如此)。
- FP8 收益更大:小 tile 使 TC 计算极快,访存和同步成为瓶颈;aref 自动平衡 producer/consumer 并加深预取。
- 小 K 时落后 cuBLAS:Triton 开销占比相对显著。
4.2 GEMM 变体(§V-C)
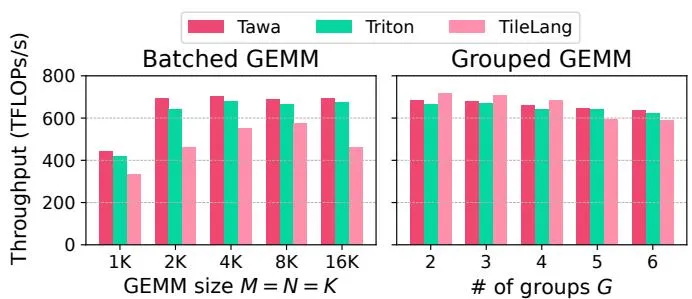
Batched GEMM(batch=8,M/N/K 1K~16K)和 Grouped GEMM(可变形状)——MoE 模型中常见。
- Batched GEMM:Tawa 持续优于 Triton(最高 +7%),比 TileLang 快高达 50%。
- Grouped GEMM:TileLang 在小 group 表现好但随 group 增大退化。
Tawa 的 aref 分区和自动 WS 允许一个 GEMM 的数据搬运与另一个 GEMM 的计算重叠。
4.3 多头注意力(§V-D)
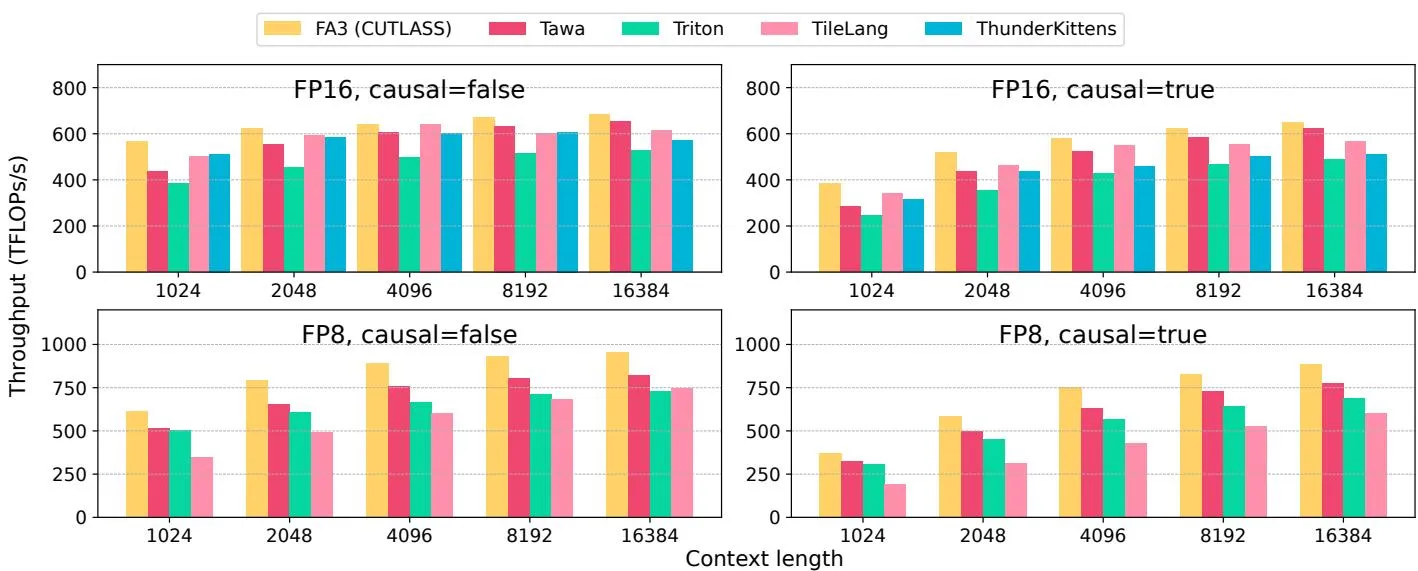
L ∈ [1024, 16384],batch=4,head_dim=128。
| 精度 | vs FA3 (CUTLASS C++) | vs Triton | vs TileLang | vs ThunderKittens |
|---|---|---|---|---|
| FP16 | 96% | +1.21× | — | — |
| FP8 | 89% | +1.11× | +1.48× | 无法运行 |
- FP16 优势在 L≥4K 后明显(内存流量和同步占主导);短序列时 prologue/epilogue/barrier 成本未摊销,WS 优势不明显。
- ThunderKittens 无法运行 FP8 attention 配置——表明其内核主要调优于 FP16。
4.4 超参数分析(§V-E)
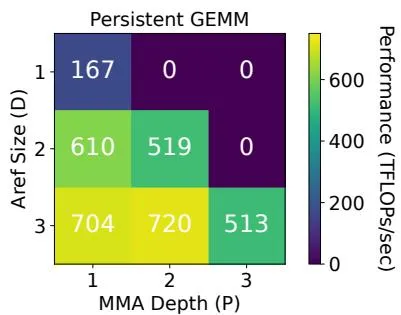
- aref 大小 D:性能随 D 增大而提升(更多预取、平滑延迟变化、更好隐藏 global→shared 传输)。但 D 过大需更多 shared memory,与大型 tile 不可兼得。
- MMA 深度 P:经典过流水线权衡。P=1→2 通常有益(减少 accumulator 可用性等待);P=3 降低吞吐(更深计算流水线增加 live fragment 和 accumulator 寄存器,压低 WG 占用率)。
- 持久化 kernel:始终更快(+5~10%),消除 grid 调度和尾部效应,改善缓存局部性。
4.5 消融实验(§V-F)
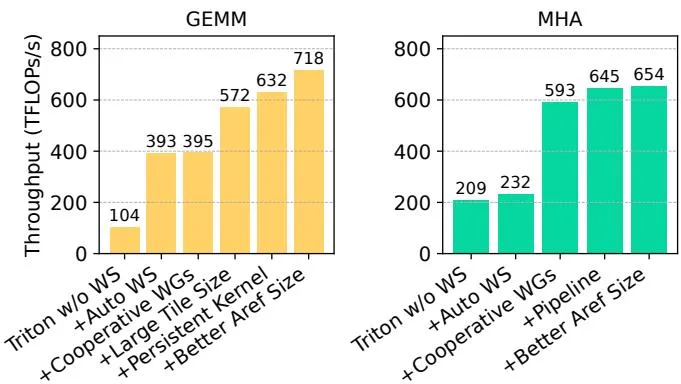
以 baseline Triton(无 WS)= 104 TFLOPs/s 为起点:
| 优化 | GEMM 提升 | MHA 提升 |
|---|---|---|
| +Auto WS(单 warp group) | 3.78× → 393 TFLOPs/s | 2.84× |
| +Cooperative WGs(两 compute WG) | 同 tile 不变;但可增大 tile | — |
| +Large Tile Size(128×256×64) | 1.46× | — |
| +Persistent Kernel | 10% | — |
| +Better Aref Size(调优 D) | 718 TFLOPs/s(~7× baseline) | 654 TFLOPs/s |
渐进改进凸显了 Tawa 精心整合 warp 特化、协作 warp group 和流水线的威力。
五、与相关系统的比较
| 系统 | 分区方式 | 通信抽象 | 流水线 | 形式化保证 | 用户标注 |
|---|---|---|---|---|---|
| Triton | 无 WS | 无 | Ampere cp.async | 无 | 无 |
| TileLang | 隐式 | 无 | 有限 MMA 流水线 | 无 | 需 T.pipelined / T.copy |
| Cypress | 手动管理层级 | 逻辑计算描述 | 有 | 无 | 需手动映射 |
| Gluon | 无 | 显式通信操作 | 有 | 无 | 需显式插入 |
| Twill | SMT 求解 | 无(直接 PTX) | 模调度 | 最优性保证 | 无 |
| Tawa | 语义标记自动分区 | aref(形式化语义) | 多级自动流水线 | aref 语义保证 | 无标注 |
Tawa 的独特定位:全自动、无需标注、有形式化 aref 语义保证,直接面向实际 GPU 编程模型(Triton 前端)。
六、总结
核心贡献
- 提出 aref——具有形式化语义保证的 warp 级通信抽象,封装 TMA/mbarrier 底层细节。
- 开发 Tawa——首个面向现代 NVIDIA GPU 的全自动 warp 特化编译流程:从无标注 Triton 程序 → 任务感知分区 → aref 数据流 → 多级流水线 → PTX。
- 实证:H100 上 GEMM 达 cuBLAS 水平(FP16/FP8 最高 79% 硬件利用率),Attention 达 FA3 手工内核的 96%,超 Triton 1.21×。
技术影响
- 将 warp 特化从专家手工编排(FA3 的 CUTLASS C++、ThunderKittens 的 16×16 tile 抽象)降维到一键开启(
enable_warp_specialization=True)。 - aref 抽象为 warp 间通信提供了类型安全的、有形式化语义保证的一等 IR 值,避免了手动 PTX 的错误风险。
- 与 Twill 形成互补:Twill 用 SMT 求解器自动发现最优调度(理论最优),Tawa 用 aref + 自动分区/流水线自动编排实际代码(工程可用)。
局限性
- aref 大小 D 和 MMA 深度 P 需手动调优(虽比手工调 kernel 简单得多)。
- 目前主要面向 producer-consumer 双缓冲模式;ping-pong 和 multicast 等高级模式留作未来工作。
- 对 Blackwell 的 Tensor Memory(tmem)支持尚需扩展。
七、参考资源
- 论文:Tawa: Automatic Warp Specialization for Modern GPUs with Asynchronous References (CGO 2026)
- 相关文档(同一 warp 特化研究血脉):
- Twill: 最优软件流水线与 Warp 特化 (arXiv 2512.18134)(SMT 求解器自动发现最优 SWP+WS 调度)
- Singe: 用 Warp 特化实现 GPU 高性能的 DSL 编译器 (PPoPP’14)(多路 WS 编译器,同作者 Bauer/Aiken)
- CudaDMA: 通过 Warp 特化优化 GPU 内存带宽 (SC’11)(warp 特化起源)
- Veda: 蒸馏式稀疏注意力(现代 Hopper kernel 的 warp specialization 实践)