Towards Efficient Large Language Model Serving: A Survey on System-Aware KV
系统感知的KV缓存优化综述,从时间、空间、结构三个维度系统梳理LLM推理中的KV缓存管理技术
Towards Efficient Large Language Model Serving: A Survey on System-Aware KV Cache Optimization
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Towards Efficient Large Language Model Serving: A Survey on System-Aware KV Cache Optimization |
| 作者 | Jiantong Jiang, Peiyu Yang, Rui Zhang, Feng Liu |
| 机构 | The University of Melbourne, Huazhong University of Science and Technology |
| 论文 | PDF (非arXiv) |
| 代码 | GitHub: Awesome-KV-Cache-Optimization |
| 发布 | 2026-01-05 |
二、核心思想
综述范围
本综述聚焦于系统感知的KV基础设施用于LLM推理(sKis),从系统行为视角重新审视现有工作,组织为三个维度:
- 执行与调度(时间维度):KV数据何时被访问、计算或调度
- 放置与迁移(空间维度):KV数据在内存层次或设备间放置或移动的位置决策
- 表示与保留(结构维度):KV数据如何被压缩或管理的结构处理
与其他综述的区别
| 综述 | KV中心 | 仅推理 | 免训练 | 组织原则 |
|---|---|---|---|---|
| Miao et al. (2023) | ✓ | 算法-系统 | ||
| Yuan et al. (2024) | ✓ | 优化层 | ||
| Li et al. (2024a) | ✓ | ✓ | 系统组件 | |
| Shi et al. (2024) | ✓ | 生命周期阶段 | ||
| Li et al. (2024b) | ✓ | ✓ | 优化层 | |
| 本综述 (sKis) | ✓ | ✓ | 系统行为 |
核心贡献
- 首个将KV缓存优化框架化为时间-空间-结构行为空间的工作
- 从系统行为视角提供全面理解
- 分析跨行为协同设计模式和行为-目标关系
三、技术架构
综述范围定位
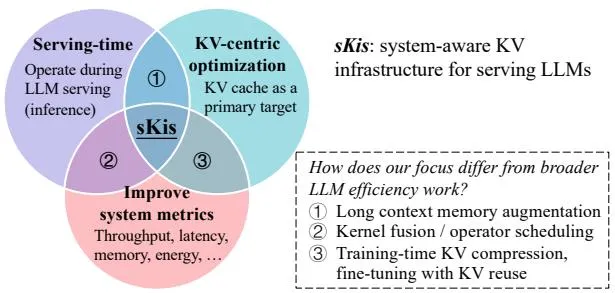
Figure 1: 综述范围定位(“sKis”)。
分类体系
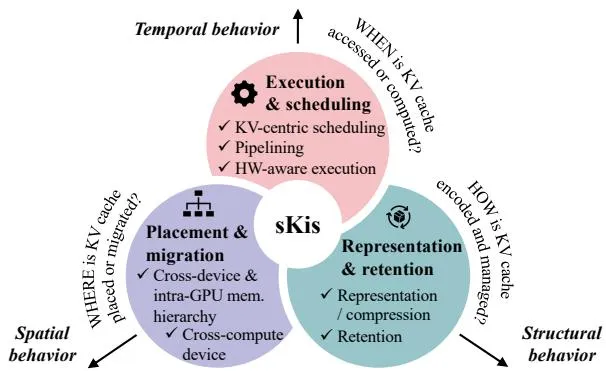
Figure 2: 综述分类体系,涵盖时间、空间和结构三个维度。
LLM推理基础
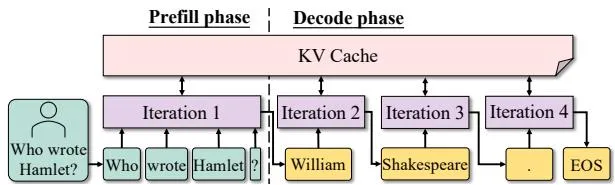
Figure 3: LLM推理的Prefill和Decode阶段。
详细分类
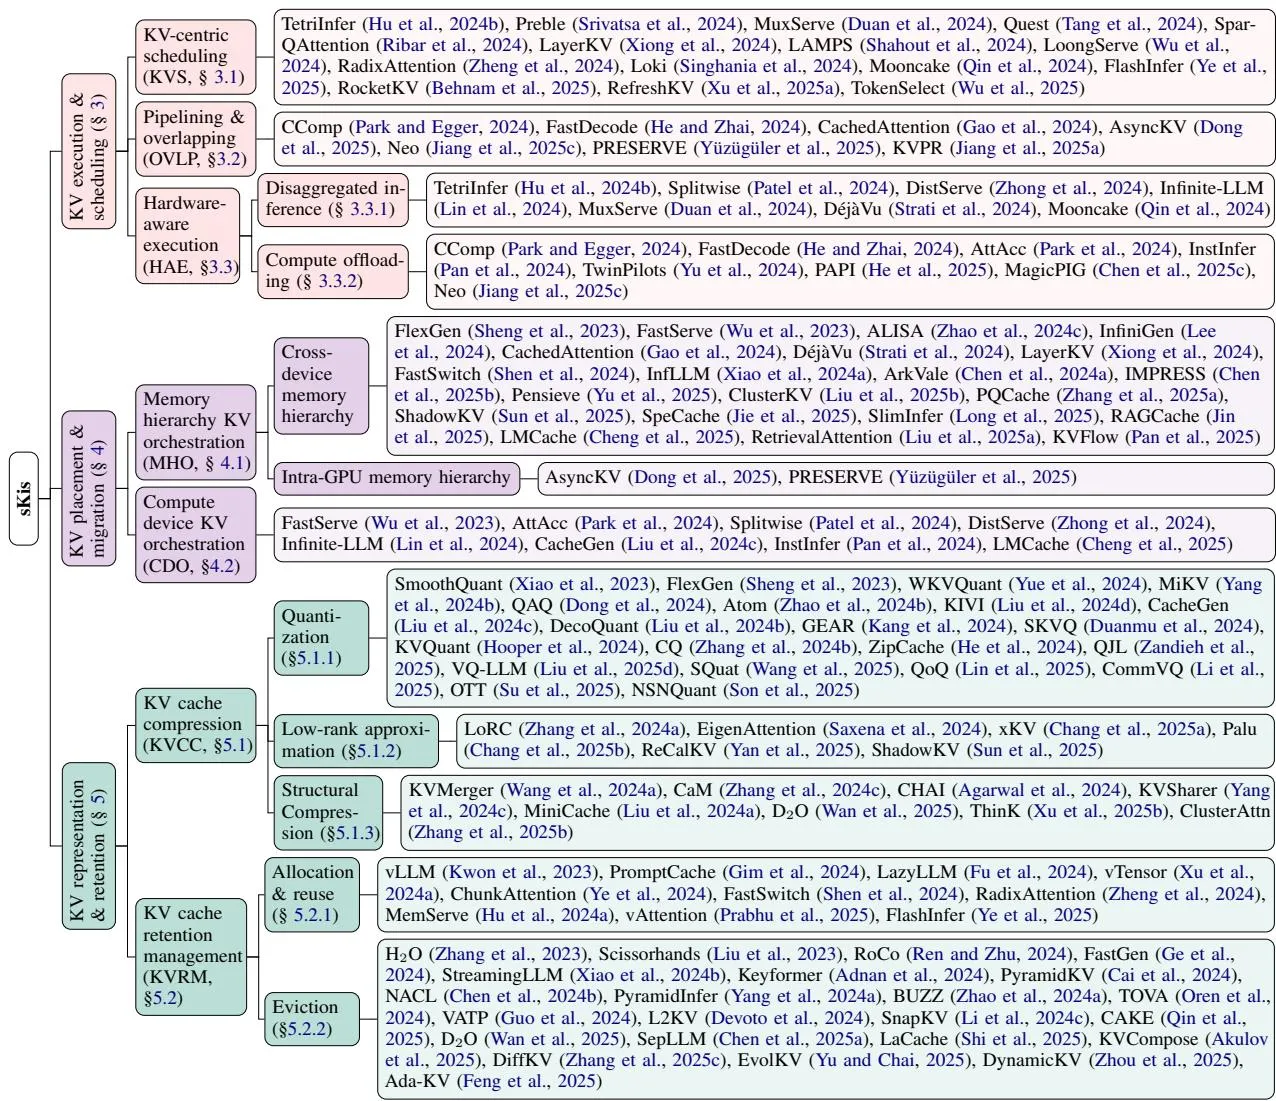
Figure 4: sKis详细分类及关联方法。
四、KV执行与调度(时间维度)
4.1 KV中心调度(KVS)
请求级调度:
- TetriInfer:基于预测KV使用量优先调度,缓解Prefill-Decode干扰
- MuxServe:KV使用感知调度,平衡资源负载
复用感知调度:
- RadixAttention:优先高复用请求,最大化KV缓存命中率
- Mooncake:KV复用潜力作为关键调度信号
Token级调度:
- Quest:基于估计贡献决定哪些KV条目参与注意力
- Spar-QAttention:细粒度token选择
- FlashInfer:基于查询和KV长度调度CUDA线程块
4.2 流水线与重叠(OVLP)
隐藏KV相关延迟,重叠计算、I/O和通信:
| 方法 | 重叠模式 | 重叠操作 |
|---|---|---|
| CComp | 计算-通信 | Prefill与KV传输 |
| FastDecode | 计算-卸载 | 注意力与CPU卸载 |
| CachedAttention | 计算-加载 | 层级化KV加载 |
| AsyncKV | 异步传输 | KV预取与计算 |
| PRESERVE | 流水线 | 多级缓存访问 |
4.3 硬件感知执行(HAE)
3.3.1 分离推理(Disaggregated Inference):
- Splitwise/DistServe:Prefill和Decode分离到不同设备
- Infinite-LLM:分布式KV缓存管理
- DéjàVu:跨设备KV复用
3.3.2 计算卸载(Compute Offloading):
- AttAcc:GPU-CPU-Disk分层卸载
- InstInfer:SSD辅助推理
- Neo:异构计算优化
五、KV放置与迁移(空间维度)
5.1 内存层次KV编排(MHO)
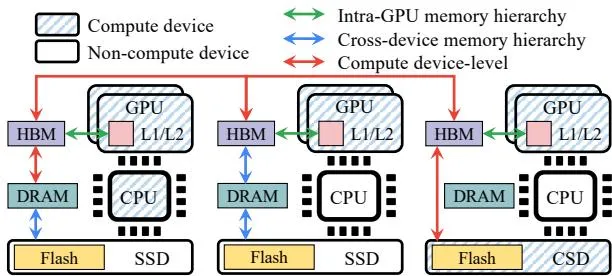
Figure 5: KV缓存放置和迁移跨内存层次和计算设备示意图。
跨设备内存层次:
- FlexGen:GPU-CPU-Disk三级存储
- FastServe:虚拟内存管理
- ALISA:分层缓存调度
- InfiniGen:异步预取
- InfLLM:块级KV管理
- LMCache:分布式KV缓存层
GPU内内存层次:
- vLLM(PagedAttention):OS启发的分页KV缓存
- vTensor:虚拟内存抽象
- vAttention:注意力感知内存管理
5.2 计算设备KV编排(CDO)
- FastServe/AttAcc:跨GPU-CPU-Disk分层
- Splitwise/DistServe:跨计算节点
- CacheGen:KV缓存压缩传输
- LMCache:分布式KV缓存共享
六、KV表示与保留(结构维度)
6.1 KV缓存压缩(KVCC)
量化(Quantization):
- KIVI:Key和Value不同精度
- KVQuant/SKVQ:混合精度量化
- SmoothQuant/Atom:激活感知量化
- ZipCache:动态精度选择
- CommVQ:通信高效量化
低秩近似(Low-rank Approximation):
- DecoQuant:张量分解量化
- ShadowKV/Palu:低秩KV缓存
结构压缩(Structural Compression):
- KVMerger/CaM:基于相似度合并
- CHAI/MiniCache:跨层KV共享
- ThinK:通道级剪枝
- ClusterAttn:聚类注意力
6.2 KV缓存保留管理(KVRM)
分配与复用(Allocation & Reuse):
- vLLM:块级分配
- PromptCache:前缀复用
- LazyLLM:延迟加载
- ChunkAttention:块级前缀共享
- RadixAttention/MemServe:分布式KV管理
驱逐(Eviction):
- H₂O:基于累积注意力分数驱逐
- StreamingLLM:保留Initial+Recent tokens
- Scissorhands:基于重要性持久性
- SnapKV/PyramidKV:观察窗口选择
- PyramidInfer:层级分配
- BUZZ/TOVA/NACL:多样化驱逐策略
- LaCache:梯形KV缓存模式
七、跨行为协同设计
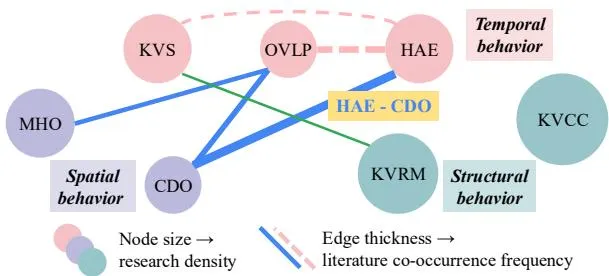
Figure 6: 行为-行为协同设计亲和网络。
关键发现:
- 调度与放置协同:KV感知调度需要了解内存层次
- 压缩与放置协同:压缩影响传输和存储决策
- 调度与压缩协同:动态压缩需要调度支持
八、未来研究方向
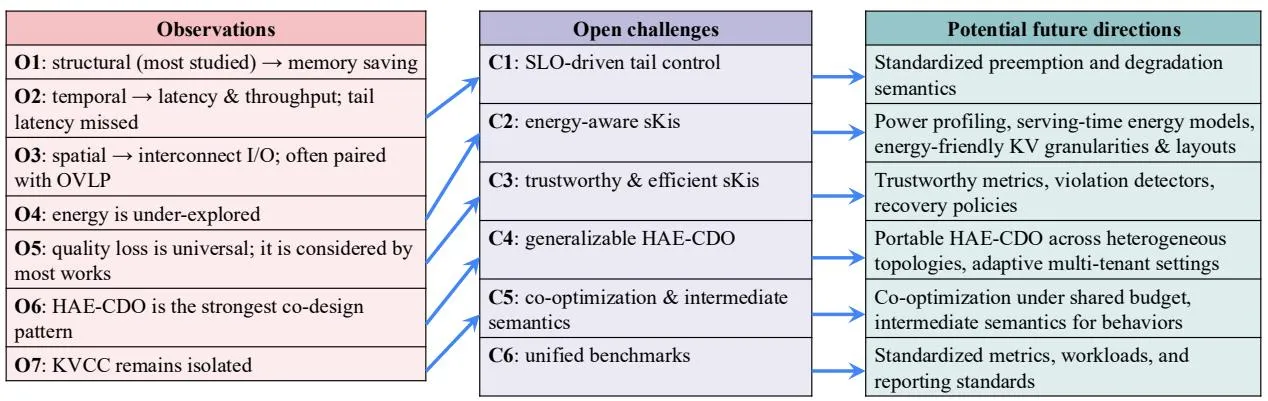
Figure 7: 连接开放挑战与潜在研究方向的路线图。
开放挑战
- 跨行为协同设计不足:现有方法通常独立优化单一维度
- 行为-目标关系不清晰:不同优化目标(延迟、吞吐、内存)之间的权衡
- 动态适应性差:难以适应不同工作负载和硬件配置
- 可扩展性限制:长上下文和大batch场景下的挑战
潜在研究方向
- 统一优化框架:整合时间、空间、结构三个维度
- 自适应策略:根据工作负载动态调整优化策略
- 硬件协同设计:算法与硬件的联合优化
- 跨模态扩展:支持多模态模型的KV缓存管理
九、核心创新总结
| 维度 | 代表方法 | 核心思想 | 主要优势 |
|---|---|---|---|
| 时间(调度) | TetriInfer, RadixAttention | KV感知调度 | 最大化复用,减少干扰 |
| 时间(流水线) | AsyncKV, PRESERVE | 计算-I/O重叠 | 隐藏延迟 |
| 时间(硬件) | Splitwise, AttAcc | 分离推理/卸载 | 异构资源利用 |
| 空间(内存层次) | vLLM, LMCache | 分页/分布式管理 | 灵活内存分配 |
| 结构(压缩) | KIVI, KVMerger | 量化/合并 | 内存节省 |
| 结构(保留) | H₂O, StreamingLLM | 驱逐策略 | 固定缓存大小 |
十、总结
核心贡献
- 首个系统行为视角的KV缓存综述:从时间-空间-结构三维框架组织现有工作
- 全面覆盖:涵盖200+篇相关论文
- 跨行为协同分析:揭示不同优化维度之间的协同模式
- 未来方向指引:提供清晰的研究路线图
技术影响
本综述展示了系统感知设计对KV缓存优化的重要性:
- 时间维度:调度和流水线是减少延迟的关键
- 空间维度:内存层次管理是扩展性的基础
- 结构维度:压缩和驱逐是内存效率的核心
- 跨维度协同:统一框架是未来方向
实际部署建议
| 场景 | 推荐方法组合 |
|---|---|
| 低延迟服务 | KV感知调度 + 流水线重叠 + FlashAttention |
| 高吞吐服务 | 分离推理 + 批量调度 + 前缀复用 |
| 内存受限 | 量化 + 驱逐 + 分页管理 |
| 长上下文 | 分层卸载 + 压缩传输 + 聚类注意力 |
十一、参考资源
- 论文: PDF(非arXiv)
- 代码: GitHub: Awesome-KV-Cache-Optimization
- 相关综述:
- 代表性方法: