SpecLA: Efficient Speculative Decoding for Linear-Attention Models
A speculative decoding runtime for stateful linear-attention models that verifies chains and trees with topology-aware kernels, stores compact factors to recover accepted states, and uses confidence pruning plus a target-aligned EAGLE-style drafter.
SpecLA: Efficient Speculative Decoding for Linear-Attention Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SpecLA: Efficient Speculative Decoding for Linear-Attention Models |
| 作者 | Zhibin Wang, Xuying Han (南京大学 软件新技术与产业化工程研究中心) |
| 机构 | State Key Laboratory of Novel Software Technology, Nanjing University |
| 论文 | https://arxiv.org/abs/2607.16673 |
| 代码 | 未提供 |
| 发布 | 24 Jun 2026 |
| 许可 | 未明确 |
二、核心思想
问题定义
线性注意力模型(如 GDN)用循环状态替代了增长型 KV 缓存,但自回归解码仍然每次读取、更新和写入这些状态——一次一个 token。投机解码(Speculative Decoding, SD)可以通过一次性验证多个草稿 token 来降低此成本,但现有投机系统是为 Transformer KV 缓存设计的:
- 验证依赖链式关系:树状候选必须遵循祖先依赖,不能像 Transformer 那样简单拼接 KV 后缀
- 接受后状态恢复:拒绝的候选不能通过截断 KV 缓存后缀来移除,因为循环状态是稠密对象
- Draft 对齐:纯线性注意力目标缺乏预训练的同族 drafters,通用 Transformer drafter 的分数不匹配循环执行路径
解决方案概述
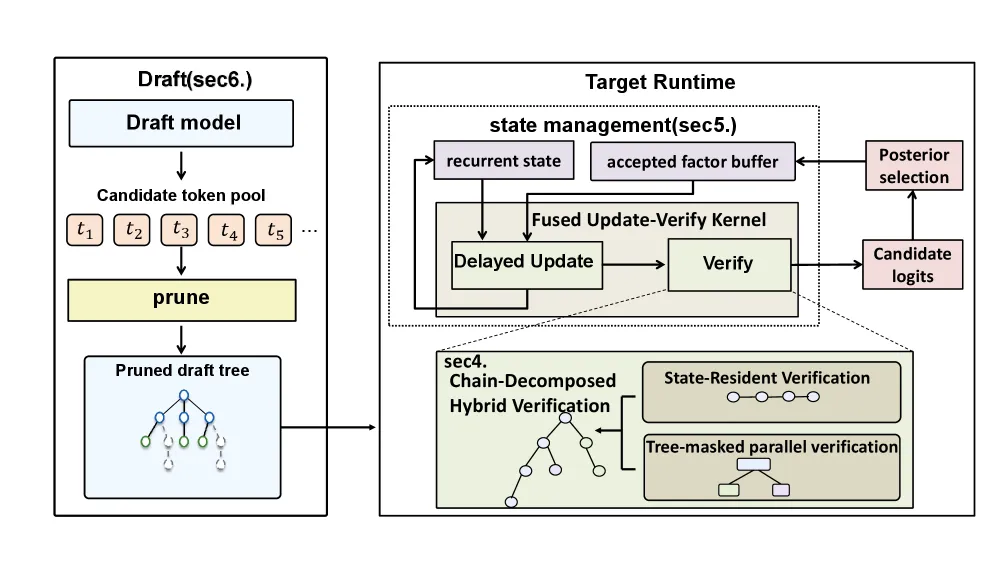
SpecLA 是一个面向状态化线性注意力模型的投机解码运行时系统,从下到上优化三个层级:
- Level 1 — 拓扑感知验证:将提交拓扑作为目标内核调度信号,而非强制所有候选通过 decode replay 或 prefill reuse
- Level 2 — 接受因子状态管理:记录紧凑的验证因子(而非完整状态端点),延迟状态更新以融合到下一个验证 kernel
- Level 3 — Draft 集成:置信度引导剪枝 + 目标对齐的 EAGLE-style drafter
在 NVIDIA H100 上,使用 GDN-1.3B 目标模型,SpecLA 实现了最高 1.70× 端到端加速。
三、技术架构
整体框架
SpecLA 保留了外部 draft–verify–accept 循环,但用三个目标感知机制替换了 KV 缓存后缀操作:
┌─────────────────────────────────────────────────────┐
│                  SpecLA Runtime                      │
│                                                      │
│  Level 3: Draft Integration                          │
│  ┌──────────────┐    ┌───────────────┐              │
│  │ Confidence   │    │ Target-Aligned│              │
│  │ Pruning      │───▶│ EAGLE Drafter │              │
│  └──────────────┘    └───────────────┘              │
│         │                      │                     │
│         ▼                      ▼                     │
│  ┌──────────────────────────────────────┐           │
│  │  Parent-pointer Topology → Chains/Trees│          │
│  └──────────────────────────────────────┘           │
│                      │                               │
├──────────────────────┼───────────────────────────────┤
│                      ▼                               │
│  Level 1: Topology-Aware Verification                │
│  ┌──────────┐ ┌──────────┐ ┌──────────────────────┐  │
│  │ Serial   │ │ Parallel │ │ Hybrid (Chain-Decomp)│  │
│  │ Kernel   │ │ Kernel   │ │                      │  │
│  └──────────┘ └──────────┘ └──────────────────────┘  │
│                      │                               │
├──────────────────────┼───────────────────────────────┤
│                      ▼                               │
│  Level 2: State Management                           │
│  ┌──────────────────┐ ┌──────────────────────────┐  │
│  │ Factor Buffering │ │ Delayed State Update     │  │
│  │ (not full snap)  │ │ (fused with next verify) │  │
│  └──────────────────┘ └──────────────────────────┘  │
└─────────────────────────────────────────────────────┘
核心公式
线性注意力递归更新(公式 1):
其中 通过投影因子 和 总结前缀。添加 token 时突变状态而非追加独立缓存槽。
Token Replay 状态恢复(公式 2):
因子缓冲状态恢复(公式 3):
其中 是验证期间产生的紧凑层特定因子(key/value 向量、衰减因子、Delta-rule 系数),每层仅约 128.5 KiB(L=8 时),比完整状态小约 128×。
Tree-Masked 并行验证:
置信度剪枝(公式 7):
保留满足 的节点。
三种验证 Kernel
| Kernel | 适用场景 | 优势 | 劣势 |
|---|---|---|---|
| State-Resident Serial (§4.1) | 短链候选 | 低开销,状态驻留 SRAM | 无 token 级并行 |
| Tree-Masked Parallel (§4.2) | 树状候选 | 完全并行 | 高 setup 开销 |
| Chain-Decomposed Hybrid (§4.3) | 混合拓扑 | 兼顾两者 | 需重轻分解策略 |
Serial Kernel 关键优化:从 token-major 改为 layer-major 执行顺序,相邻 token 同层连续执行,V-dimension tiling 避免跨块归约。
Hybrid Kernel 调度:将提交拓扑分解为依赖尊重链,每条链用 serial kernel 验证,边界状态就绪的链并行执行。
状态管理三种方案对比
| 方案 | 内存 | 计算 | 适用性 |
|---|---|---|---|
| Full-State Snapshotting | 2 MiB/层 × L | 低(直接拷贝) | 不实用(溢出 SRAM) |
| Token Replay | 最小 | 高(重复前向) | 抵消投机收益 |
| Factor Buffering (本文) | ~128 KiB/层 × L | 低(轻量 delta 构造) | 推荐 |
延迟状态更新
立即更新产生额外的状态访问 pass(读→写→再读)。延迟更新将接受因子缓冲区融合到下一次验证 kernel 中,消除冗余 HBM 往返。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 拓扑感知验证 | 将提交拓扑作为目标内核调度信号,提供 serial/parallel/hybrid 三种路径 | §4, Fig. 3-6 |
| 因子缓冲状态管理 | 记录紧凑验证因子而非完整状态端点,比 token replay 快 2.74-4.28× | §5, Fig. 7, 11(a) |
| 延迟状态更新 | 将接受因子融合到下次验证 kernel,减少 1.15-1.44× 延迟 | §5.2, Fig. 11(b) |
| 置信度剪枝 | 基于累积对数概率的树剪枝,ancestor-closed 窗口保证正确性 | §6.1, Fig. 8 |
| 目标对齐 Draft | 在循环特征上训练的 EAGLE-style drafter,比 Transformer drafter 更匹配 | §6.2 |
五、代码实现分析
实现栈:PyTorch + Triton,集成到 EAGLE-style 生成运行时。
四个自定义 Triton Kernel:
- Serial tree-state verifier
- Parallel factorized tree-state verifier
- Parallel chain verifier (specialized to )
- Fused commit-and-verify kernel
配置:GDN-1.3B 单层模拟:, ,因果深度卷积(kernel size 4),SiLU gating。循环状态 FP32 存储(2 MiB/层),投影激活 BF16。
Runtime 修改四点:
- Cache holder 存储每层固定大小 FP32 循环状态
- Target layer wrapper 暴露双输出 forward(候选 logits + 因子记录)
- Proposal converter 将 drafter 的 tree mask 转为 parent array
- Generation loop 调用 GatherAcceptedBuffer 提取接受因子而非截断 KV cache
六、实验结果
基准测试
硬件:NVIDIA H100 GPU
数据集:
- EAGLE-style mixed suite:480 prompts(对话、指令跟随、数学推理、代码生成、QA、摘要)
- GSM8K:1,319 prompts
- HumanEval:164 prompts
端到端性能(Figure 9):
| 方法 | Mixed Suite | GSM8K | HumanEval |
|---|---|---|---|
| Autoregressive | 1.00× | 1.00× | 1.00× |
| FLA-SD | 1.28× | 1.51× | 0.91× |
| Chain | 1.26× | 1.54× | 1.03× |
| SpecLA | 1.42× | 1.70× | 1.06× |
Tree vs Chain 对比(GSM8K):
- Accepted length: 3.47 → 5.00 tokens (+44%)
- First-token match: 0.68 → 0.81 (+19%)
Tree 验证效率(Table 1)
| Top-k | Depth | Nodes | R2L(ms) | Serial | Parallel | Hybrid |
|---|---|---|---|---|---|---|
| 2 | 12 | 16 | 22.5 | 1.31× | 0.58× | 2.20× |
| 2 | 24 | 32 | 55.0 | 1.36× | 1.02× | 2.55× |
| 4 | 4 | 16 | 37.8 | 3.73× | 1.70× | 5.14× |
| 4 | 4 | 32 | 91.2 | 4.74× | 3.47× | 7.11× |
| 4 | 12 | 16 | 19.0 | 1.19× | 0.52× | 1.80× |
| 4 | 24 | 32 | 41.0 | 1.30× | 0.95× | 2.19× |
Hybrid 在所有配置下均优于 Serial 和 Parallel,在 top-k=4, depth=4, 32-node 时达到 7.11× 加速。
状态管理开销(Figure 11)
| 方案 | Commit Length=1 | Commit Length=8 | 加速 |
|---|---|---|---|
| Token Replay | 19.70 ms | 35.96 ms | — |
| Factor Buffer | 5.15 ms | 13.10 ms | 2.74-4.28× |
| 方案 | 最短延迟 | 最长延迟 | 加速 |
|---|---|---|---|
| Separate Verify+Commit | 0.102 ms | 0.153 ms | — |
| Fused Commit+Verify | 0.071 ms | 0.133 ms | 1.15-1.44× |
FP32 精度检查:循环状态最大差异 ≤ ,卷积状态差异为零。
受控接受研究(Figure 12)
- :所有 draft length 低于 1×(亏损)
- :短 draft 略超 1×,长 draft 仍亏损
- :所有 draft length 有益
- Oracle 接受: 时达 3.71×(1.3B),4.61×(9B 投影)
关键洞察:Proposal 质量决定有效 draft 预算。大 draft 预算提高上限,但需要足够准确的 drafter 才能回报。
七、相关工作
| 工作 | 方法 | 局限 |
|---|---|---|
| EAGLE | Feature-level drafting | 针对 Transformer KV cache |
| Medusa | Auxiliary draft heads | 针对 Transformer KV cache |
| SpecInfer | Tree-based SD | 针对 Transformer KV cache |
| Snakes & Ladders | SSM speculative decoding | 未解决因子缓冲和延迟更新 |
| STree | Hybrid SSM tree decoding | 未解决拓扑感知 kernel |
| SpecLA (本文) | Topology-aware + Factor buffer + Delayed update | 专为线性注意力设计 |
八、总结
核心贡献
- 拓扑感知验证:三种 kernel(serial/parallel/hybrid)根据提交拓扑自适应选择,消除 decode replay 和 prefill reuse 的抽象不匹配
- 因子缓冲状态管理:记录紧凑验证因子替代完整状态快照,恢复延迟降低 2.74-4.28×
- 延迟状态更新:将接受因子融合到下次验证 kernel,消除额外 HBM 往返
- 目标对齐 Draft:在循环特征上训练的 EAGLE-style drafter + 置信度剪枝
- 端到端 1.70× 加速:在 H100/GDN-1.3B 上超越所有基线
技术影响
首次将投机解码有效应用于状态化线性注意力模型,建立了从 Transformer KV-cache 范式到循环状态范式的运行时抽象转换。
局限性
- 当前仅评估了 GDN 单层(非完整 24-layer GDN-1.3B)
- Drafter 仍使用 Transformer-style(二次复杂度),在更长 draft 时可能成为瓶颈
- 未评估多 batch 场景下的扩展性
九、参考资源
- arXiv: https://arxiv.org/abs/2607.16673
- HTML: https://arxiv.org/html/2607.16673v1
- GDN-1.3B Model: https://huggingface.co/m-a-p/1.3B-100B-GatedDeltaNet-pure