Singe: Leveraging Warp Specialization for High Performance on GPUs(用 Warp 特化实现 GPU 高性能的 DSL 编译器)
PPoPP'14 论文,来自 CudaDMA 同一作者团队(Bauer/Treichler/Aiken, Stanford)。提出 Singe——一个面向燃烧化学(combustion chemistry)的 DSL 编译器,用 warp 特化(warp specialization)作为替代数据并行的编程模型,把一个 CTA 内的 warp 划分为不同子计算,通过硬件生产者-消费者命名屏障(named barriers, PTX bar.arrive/bar.sync)细粒度同步。核心解决燃烧 kernel 的三大难题:超大工作集(每点数百个双精度变量)、不规则计算(多阶段、部分可并行)、不规则访存。Singe 用 warp 特化把大工作集拆分到不同 warp 的片上寄存器/shared memory,避免寄存器溢出。三类 kernel 案例:Viscosity(按物种求和分块,Store 模式)、Diffusion(对 dij 矩阵按列分块,Mixed 模式)、Chemistry(反应速率存寄存器经 shared 交换,Buffer 模式 + QSSA DAG 分块 overlap)。编译器四阶段:分块→映射(FLOPS/寄存器/局部性三指标)→命名屏障放置调度(无死锁定理,16 个命名屏障=SSA 寄存器分配)→代码生成。代码生成三关键技术避免指令 cache 抖动:代码 overlay(同时遍历 AST 森林 + 位掩码/间接分支)、常量去重(Fermi shared 广播 / Kepler shuffle)、warp 索引(不规则访存)。在 Fermi C2070 与 Kepler K20c 上对 DME/Heptane 机制,相比已高度优化的数据并行 baseline 最高加速 3.75×。
Singe: Leveraging Warp Specialization for High Performance on GPUs(用 Warp 特化实现 GPU 高性能的 DSL 编译器)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Singe: Leveraging Warp Specialization for High Performance on GPUs |
| 作者 | Michael Bauer、Sean Treichler、Alex Aiken(Stanford University) |
| 会议 | PPoPP’14(Principles and Practice of Parallel Programming, 2014) |
| cs.stanford.edu/~sjt/pubs/ppopp14.pdf | |
| 硬件 | NVIDIA Tesla C2070(Fermi,14 SM)、Tesla K20c(Kepler,13 SM),CUDA 5.0 |
| 应用背景 | 燃烧科学 S3D(DME / n-Heptane 化学机制) |
一句话总结:Singe 是 CudaDMA 的直接续作(同一作者 Bauer)。CudaDMA 只用两条 warp 代码路径(compute/DMA);Singe 则把 warp 特化推向任意多路划分,并首次给出构造一个 warp 特化 DSL 编译器所需的全套算法(分块、映射、命名屏障放置调度、抗指令 cache 抖动的代码生成)。在燃烧化学 kernel 上相比已高度优化的数据并行 baseline 最高加速 3.75×。
二、核心问题:数据并行模型不适合燃烧 kernel
燃烧应用(如 S3D)的物理/化学 kernel 有三个特征,使其难以映射到传统数据并行 GPU 模型:
- 超大工作集(Large working sets):每个离散空间点常需数百个 live 双精度变量。数据并行模型下这远超单线程片上内存容量 → 寄存器溢出、低占用率、算力单元利用不足。
- 例:Heptane 52 物种,仅存 molar fractions + per-species viscosities 就需 104 个双精度值 = 208 个寄存器;Fermi 每线程仅 64 寄存器,Kepler 256 但占用率极低。
- 不规则计算(Irregular computations):kernel 含多个计算特征各异的阶段,阶段间大量临时变量迫使融合成单 kernel;部分阶段本可并行,但数据并行模型强制串行化。
- 不规则访存(Irregular data accesses):访存依赖化学机制性质与运行期值,数据并行模型难以避免访存分歧与 shared memory bank 冲突。
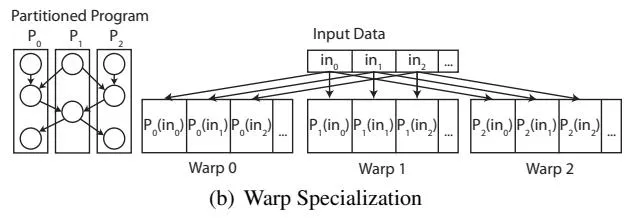
三、Warp 特化机制(Section 2)
关键洞见
warp 内控制分歧(intra-warp divergence)损害性能,但 warp 间分歧(inter-warp divergence)无害。 warp 特化 kernel 通过依赖 warp ID 的动态分支,制造显式的 warp 间控制分歧,让每个 warp 执行不同代码——只要 warp 内所有线程执行同一指令流,唯一开销就是 warp-specific 分支指令本身。
命名屏障(Named Barriers)
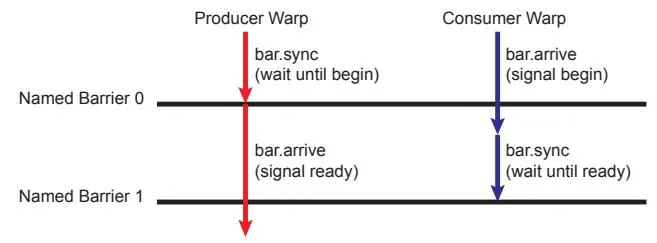
传统 CUDA 只有 CTA 全宽 __syncthreads()。通过内联 PTX,可用更具表达力的命名屏障,提供两个操作:
- arrive:非阻塞,登记某 warp 已到达屏障后继续执行。
- sync:阻塞,等待所有必要 warp 到达/同步。
命名屏障支持 CTA 内任意 warp 子集(包括单对 warp)同步,可编码生产者-消费者关系。
四、Warp 特化分块案例研究(Section 3)
分块策略依赖领域知识 + 目标架构,无通用算法;本文给出燃烧域的案例。
4.0 燃烧化学背景
化学机制由反应集合与物种构成。本文两个机制:
| 机制 | 反应数 | 物种数 | QSSA | Stiff |
|---|---|---|---|---|
| DME(二甲醚) | 175 | 39 | 9 | 22 |
| Heptane(正庚烷) | 283 | 68 | 16 | 27 |
用基于 CHEMKIN 标准的声明式数据 DSL 描述(CHEMKIN / TRANSPORT / THERMO 三个输入文件),Singe 解析后为每个 kernel 生成 CUDA 代码。QSSA(准稳态近似)以额外计算换取物种数减少;Stiffness(刚性)允许更大时间步长但需额外计算。
4.1 Viscosity(粘度)—— Store 模式
per-species 粘度(温度三次多项式的指数):
最终粘度 ν 是所有物种两两交互:
其中 为物种数,、 为物种 的摩尔分数与分子质量。两大瓶颈:大工作集寄存器放不下 + 常量太多(DME/Heptane 需 13.9/42.4 KB 常量,而片上常量 cache 仅 8 KB)。
Singe 方案:把对物种的外层求和拆分成子计算映射到不同 warp;一个 CTA 的所有 warp 协作处理 32 个点(warp 的 lane 处理第 个点分配给 的 per-species 计算)。molar fractions / per-species viscosities 移入 shared memory(32 点很小,轻松装下);每个 warp 只需常量子集,配合常量去重(§6.2)把全部常量放入片上寄存器。
4.2 Diffusion(扩散)—— Mixed 模式
每对物种 的扩散常量(δ 为 N×N×4 系数矩阵):
per-species 扩散输出 :
与粘度不同,扩散每点每物种一个输出; 矩阵对称、对角为零 → 只需算不到一半,但每个 要同时贡献给 和 。
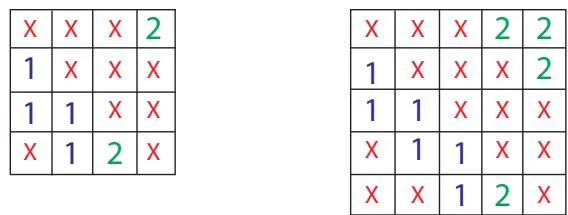
Singe 方案: 矩阵按列分块,相邻列分给相邻 warp 以最大化局部性。每个 warp 遍历其列,寄存器中维护每列 partial sum,shared memory 中维护每物种 partial sum;用命名屏障同步不同 shared 区域避免数据竞争。这形成 shared memory + 寄存器的混合存储。
4.3 Chemistry(化学)—— Buffer 模式 + QSSA DAG 分块
最复杂的 kernel,多阶段(部分可并行):① 正/反反应速率(Arrhenius / Lindermann / Landau-Teller 模型,每反应 6~15 个常量)② QSSA 缩放因子 ③ Stiff 物种 ④ 输出阶段按化学计量系数求和。
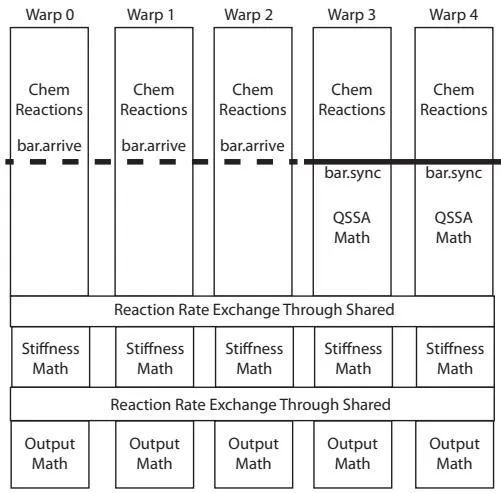
若拆成独立 kernel,Heptane 每点需读写 566 个双精度反应速率 → 访存受限、慢。故融合为单 kernel。反应速率太多无法放 shared memory,改为分块存各 warp 寄存器,需要时分批经 shared memory 交换(远快于 off-chip global)。
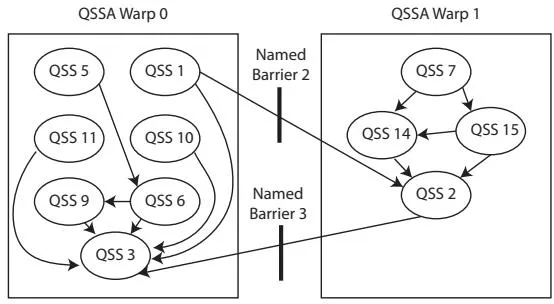
QSSA 双粒度 warp 特化:QSSA 阶段计算昂贵且难并行(每 QSSA 物种需 20~60 DFMA,物种间有数据依赖)。
- 粗粒度:QSSA 所需反应先分配给 warp,然后分流一部分 warp 做 QSSA、其余继续算反应速率;非阻塞命名屏障让 QSSA 与剩余反应速率计算重叠(数据并行版做不到)。
- 细粒度:用启发式把 QSSA 计算的 DAG 分块到多个 QSSA warp;每条跨 warp 边分配一个生产者-消费者命名屏障。
五、Warp 特化编译器架构(Section 4)
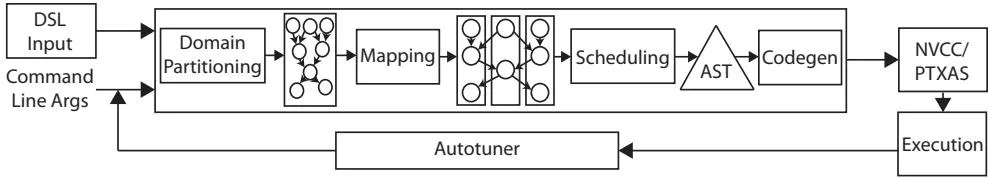
源到源编译器,四个阶段:
| 阶段 | 输入 → 输出 | 说明 |
|---|---|---|
| ① 分块 Partition | DSL → 数据流图(operation 节点 + 依赖边) | 领域特定,粒度由各 DSL 决定 |
| ② 映射 Mapping | 数据流图 → operation 分配到 warp + 数据分配到寄存器/shared | §4.1 |
| ③ 屏障放置调度 | → 每 warp 一棵 AST(含调度与同步) | §4.2,无死锁 |
| ④ 代码生成 | AST 森林 → CUDA 代码 | §5,非标准遍历 |
关键设计:Singe 对任意 warp 数与映射决策都能生成正确代码 → 支持 autotuning,且大幅简化编译器(无需算最优映射)。搜索空间从不超过几百个点,用暴力穷举 autotuner 驱动。
5.1 计算与数据映射(§4.1)
Step 1:operation → warp,三个(常冲突的)指标:
- FLOPS 平衡:均衡各 warp 计算负载(用 FLOP 数作代理),避免算力单元闲置。
- 寄存器平衡:因 GPU 不支持 per-warp 寄存器分配,寄存器需求最大的 warp 决定所有 warp 的寄存器数;不均衡会浪费大片寄存器文件、限制工作集、降低占用率。
- 局部性:最小化跨 warp 数据流边 → 减少 shared memory 通信与屏障同步。
Singe 用贪心算法:按 cost(FLOP/寄存器/局部性加权)从高到低映射 operation,局部最小化总 cost;三指标权重通过命令行 flag 暴露给 autotuner。
Step 2:变量 → 寄存器 / shared memory,三种 shared memory 使用模式:
| 模式 | 机制 | 代表 kernel |
|---|---|---|
| Store | 共享值少,全放 shared memory | Viscosity |
| Buffer | 工作集极大,值留寄存器,shared 仅作 warp 间通信缓冲 | Chemistry |
| Mixed | 部分值存 shared,其余作通信缓冲 | Diffusion |
5.2 命名屏障放置与调度(§4.2)—— 无死锁保证
放置算法:
- 给每条跨 warp 数据依赖标记同步点(producer 做 arrive,consumer 做 wait)。
- 基于传递数据依赖构造同步点的偏序。
- 线性化偏序并编号,定义同步点全序。
- 为每 warp 生成静态调度,遵守数据依赖 + 同步点全序(低编号先于高编号)。
定理 1:遵守初始数据依赖 + 同步点全序的每-warp 调度存在且无死锁。 证明要点:初始 operation 图是 DAG。为每个需同步点的 operation 向所有更高编号的同步点 operation 加边——这些边仍遵守原 DAG 偏序(全序由原依赖约束)。故图仍是 DAG,无环 → 无控制资源循环依赖 → 无死锁。∎
允许的重排变换(不破坏定理 1):arrive/wait operation 可在不越过相应编号同步点的前提下上/下移。用途:① 把关键路径 operation 提前;② 合并同组 warp 间多个同步点 → 批量通信、减少命名屏障数。
屏障分配:把同步点映射到 Fermi/Kepler 每 SM 16 个命名屏障,此问题与 SSA 寄存器分配同构,可多项式时间求解。实践中仅 Heptane chemistry kernel 用满 16 个。
六、Warp 特化代码生成(Section 5)—— 抗指令 cache 抖动
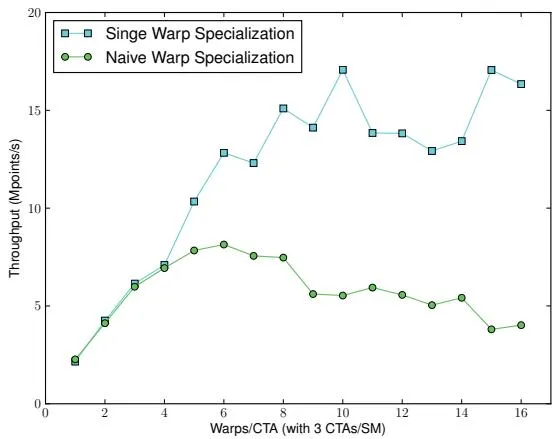
核心障碍:GPU 指令 cache 假设所有线程跑同一代码。naive 做法(顶层 switch(warpID))在**≥6 条 warp 代码路径**时开始抖动指令 cache,性能可退化一个数量级。
6.1 代码 Overlay(§5.1)
同时遍历 AST 森林:只要各 warp 的 AST 节点相同(仅常量值/索引偏移不同),就为所有 warp 发射单份代码;结构不同处才用 warp ID 分支。两种分支方式:
- 间接分支(indirect branch):warp 间代码毫无相似时,按 warp ID 跳转;长序列可分裂成多个间接分支(每段 < 几百指令时,指令 cache 预取可处理分歧)。
- 位掩码(bit-mask):warp 子集仍有共同结构时,用 one-hot 编码位掩码指示哪些 warp 进入代码块(见 Listing 1,同时算 Landau-Teller/Lindermann 反应速率)。
经验法则:多路分支但每段几百指令内,或长代码但只分少数路,可避免抖动。
6.2 常量数组与常量去重(§5.2)
- 常量数组:每 warp 只需常量子集,分配一个大小=最大 warp 常量数的数组,所有 warp 始终访问相同下标位置(分歧代码用 padding 填充)——避免按常量值分支。
- 常量去重:常量数组可能超过一个线程的寄存器容量。由于 warp 内所有线程需要同一组常量,把常量跨 warp 内线程条带化存储,每线程只存 1/32,用时从属主线程广播:
- Fermi:经 shared memory 广播(一线程写、其余读,warp 锁步无需显式同步)。
- Kepler:用 shuffle 指令(把双精度拆成高/低 32 位交换再重组),比 Fermi 更快(不阻塞 shared memory 流水)。
![Figure 10 数据] Kepler 上每线程常量寄存器数:
| 机制 | Viscosity | Diffusion | Chemistry |
|---|---|---|---|
| DME | 8 | 18 | 6 |
| Heptane | 28 | 28 | 8 |
数量足够小,大部分寄存器留给通用计算,却比常量 cache 能寻址的还多。配合 streaming 执行(多组点映射到一个 CTA、常量 load 提到循环外)可进一步摊销开销。
6.3 Warp 索引(§5.3)
不规则访存时不同 warp 需访问不同内存位置(如 chemistry 的 stiffness 计算),与代码 overlay 目标冲突。解法:每个 warp 存储各自的整数偏移常量(warp indexing constants),所有 warp 用同一索引变量做地址计算(但变量对不同 warp 存不同值)——这层间接使 overlay 无需动态分支。若索引常量多也可跨 warp 内线程去重条带化。限制:仅适用于可动态索引的内存(global/shared/constant);寄存器数组不可动态索引,否则被溢出到慢速 local memory。
七、实验结果(Section 6)
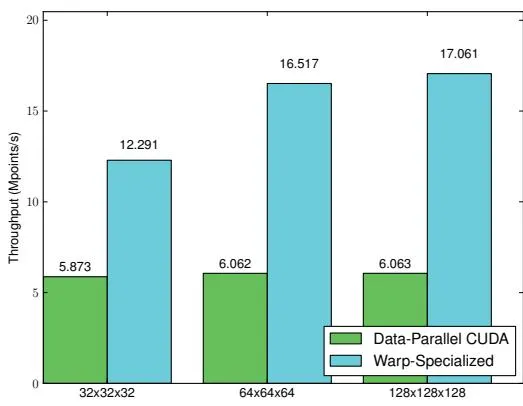
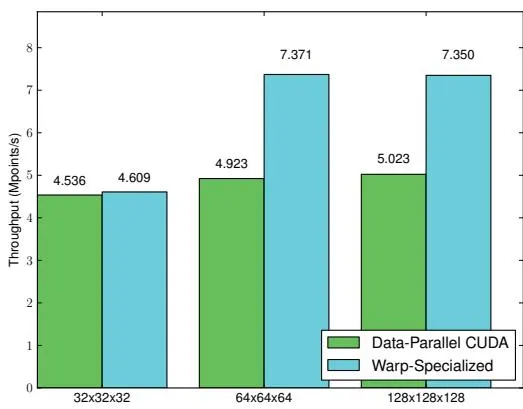
平台:Tesla C2070(Fermi,14 SM)、Tesla K20c(Kepler,13 SM),ECC 关闭(让 baseline 尽量快)。Baseline 是 Singe 早期版本发射的数据并行 CUDA kernel,已用对数空间计算、ILP 暴露、Kepler LDG 纹理 load、暴力 autotuner 穷举占用率-寄存器权衡等充分优化(已比 S3D 生产版 OpenACC 快约 2×)。三种网格规模 32³/64³/128³。
| Kernel | 加速范围(vs 数据并行 baseline) | 限制因素分析 |
|---|---|---|
| Viscosity | 1.2× ~ 3.75× | warp 特化版接近数学吞吐峰值;baseline 受寄存器溢出到 local + 常量 cache miss 拖累 |
| Diffusion | 1.33× ~ 2.58× | warp 特化版受 partial sum 同步的命名屏障拖累(straggler warp 等待);需 ≥64³ 摊销常量 load |
| Chemistry | 1.01× ~ 1.50× | baseline 全局带宽受限(Heptane 每线程溢出 8736B/Fermi);warp 特化版几乎全留寄存器(仅溢出 276B/Fermi、44B/Kepler),转为 shared memory 延迟受限——仍远优于全局带宽受限 |
关键数字(DME viscosity):
- Fermi:baseline 197.9 GFLOPS → warp 特化 257.3 GFLOPS(接近 Fermi 实用峰值 ~300,理论 513)。
- Kepler:baseline 220.6 GFLOPS → warp 特化 617.7 GFLOPS(理论峰值 1173 的一半以上,受常量 cache 第三操作数 DFMA 吞吐限制;改用寄存器常量可达 ~750 GFLOPS 验证其 compute-bound)。
Kepler 加速普遍大于 Fermi:因 Kepler 数学吞吐天花板更高,warp 特化版更充分逼近之。
八、讨论(Section 7)
- 可推广到其他宽向量 SIMD 架构(如 Intel Xeon Phi):一个 warp 类似发射 32 宽向量指令的指令流。但 Xeon Phi 缺两项硬件:① 快速硬件同步原语(等价命名屏障,当前需重量级软件 mutex)② 片上软件管理内存(当前只能用受干扰/驱逐的硬件管理 L1)。
- 硬件管理 cache 反而有害:占用晶体管、难被编译器推理(早期 Singe 试图把常量存 L2 但被其他线程写驱逐)、增加 tag 查找开销与功耗。理想未来 GPU 应以软件管理 cache 为主。
- 指令 cache 是主要制约:当前 GPU 指令 cache 差,使得 warp 特化必须 overlay 代码;未来若指令 cache 能处理多分歧 warp,可去掉 overlay,大幅简化编译器并让人工写 warp 特化代码变得可行。
- 驳”摩尔定律会淘汰 warp 特化”:计算科学家总会用更多硬件跑更高保真度的仿真(本文机制已是”简化机制”,真实机制有成百上千物种),而非让现有仿真更快。故 warp 特化对未来管理大工作集、处理不规则性、开发任务级并行仍是必需。
九、相关工作与定位
| 工作 | 关系 |
|---|---|
| CudaDMA(SC’11,同作者) | 最相关。仅 2 条 warp 路径(compute/DMA),无需 overlay 抗抖动;固定分块方案(应用码跑 compute warp、DMA 码跑 DMA warp),避开 Singe 的分块难题;是通用库而非编译器 |
| Green-Marl | 图分析 DSL,用虚拟化 warp 处理不规则性,但映射回数据并行模型 |
| G-Streamline | 运行时动态检测/重写不规则 kernel;Singe 则无任何动态开销 |
| Halide | 图像流水线 DSL/autotuning,未考虑 warp 特化 |
定位:作者称是首个展示构造 warp 特化 DSL 编译器所需完整技术的工作。
十、总结
核心贡献
- 提出 warp 特化作为数据并行之外的 GPU 编程模型,专治不规则计算/访存 + 超大工作集。
- 给出 warp 特化 DSL 编译器的完整架构与算法:分块、三指标映射、无死锁命名屏障调度(与 SSA 寄存器分配同构)、抗指令 cache 抖动代码生成。
- 三大代码生成技术:代码 overlay(AST 森林同时遍历 + 位掩码/间接分支)、常量去重(Fermi shared / Kepler shuffle)、warp 索引(不规则访存)。
- 实证:Fermi/Kepler 上燃烧 kernel 相比高度优化数据并行 baseline 最高 3.75×。
技术影响
Singe 与 CudaDMA 共同奠定 “warp 特化 + 生产者-消费者命名屏障” 这一 GPU 编程范式。这一思想在现代 Hopper 高性能 kernel(FlashAttention-3、ThunderKittens、TileLang)中以 producer-consumer warp specialization + 异步 TMA 搬运 的形式延续。Singe 的独特之处在于把它编译器化、多路化,展示了 DSL 编译器如何自动化这类专家级优化。
局限性
- 分块策略依赖领域知识,无通用算法。
- 强依赖当前无硬件对 warp 特化的一等支持(16 命名屏障、需手工 overlay 抗指令 cache 抖动)。
- 寄存器不可动态索引限制了 warp 索引的适用范围。
十一、参考资源
- 论文 PDF:Singe: Leveraging Warp Specialization for High Performance on GPUs (PPoPP’14)
- 相关文档:
- CudaDMA: 通过 Warp 特化优化 GPU 内存带宽(同作者直接前作,warp 特化的 2 路库版本)
- Can Tensor Cores Benefit Memory-Bound Kernels? (No!)(GPU 访存受限 kernel 优化的理论边界)
- Veda: 蒸馏式稀疏注意力(现代 Hopper kernel 的 producer-consumer warp specialization 延续)