SALT: Salience-Aware Lexical Trie for Long-Context Compression
Model-agnostic extractive prompt compression framework using sentence-frequency-ordered lexical trie to prevent theme collapse under tight budgets
SALT: Salience-Aware Lexical Trie for Long-Context Compression
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SALT: Salience-Aware Lexical Trie for Long-Context Compression |
| 作者 | Oteo Mamo, Hyunjin Yi, Joydhriti Choudhury, Shangqian Gao, Weikuan Yu |
| 机构 | Florida State University |
| 论文 | arXiv:2607.17486 |
| 代码 | GitHub (paper 提到提供代码,具体仓库待确认) |
| 发布 | 20 Jul 2026 (v1), 3,473 KB |
| 许可 | CC BY 4.0 |
| Subjects | Performance (cs.PF); Artificial Intelligence (cs.AI); Machine Learning (cs.LG) |
二、核心思想
问题定义:主题坍塌 (Theme Collapse)
大语言模型处理越来越长的 prompt 时,计算和 KV cache 内存成本成为推理系统的重大瓶颈。现有的输入级 prompt 压缩方法(如 RECOMP、EXIT、CPC、Sentinel、LLMLingua 等)通过标量相关性分数对每个句子排名,将文档视为无结构的词/句子池。在严格预算下,这会导致主题坍塌——文档的主导主题消耗了大部分预算,丢弃了低频但任务相关的主题。例如在多跳 QA 中,可能保留多个关于主实体的段落,而丢弃连接第二实体的桥接句子。
解决方案概述
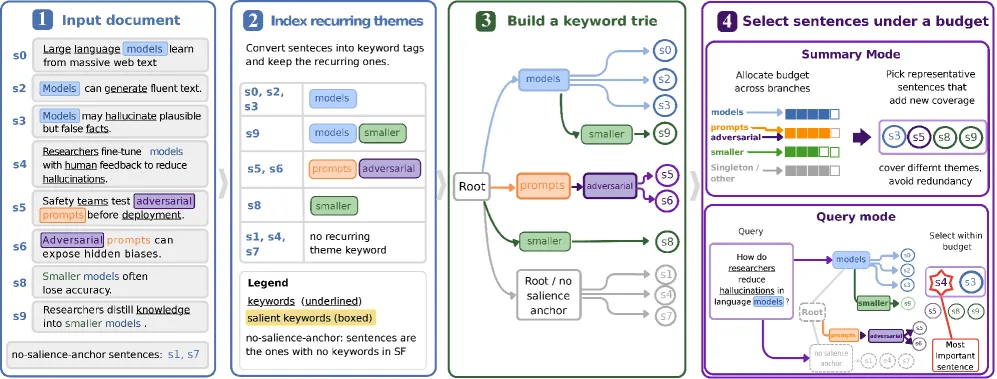
SALT 是一个模型无关的提取式压缩框架,核心理念是:压缩预算应在文档衍生的词汇主题间分配,而非孤立地对句子打分。
SALT 将每句关键词组织到一个按句子频率 (Sentence Frequency, SF) 排序的词缀树 (lexical trie) 中。SF 是文档主题结构的轻量级、可复用代理。这种基于 trie 的组织方式平滑了内存分配,防止主导主题垄断预算。
SALT 包含两个阶段:
- 索引阶段 (Indexing):使用 BGE-small-en-v1.5 从每个句子中提取关键词,构建 SF 有序的词缀树
- 选择阶段 (Selection):在目标词预算下遍历 trie 选择句子子集,支持摘要模式 (summary mode) 和查询模式 (query mode)
Trie 跨对话轮次持久化,支持多轮使用而无需重新编码文档。SALT 输出纯文本 prompt,与任何下游 LLM 兼容,且可与针对解码延迟和内存的 KV cache 方法组合使用。
三、技术架构
整体框架图
┌─────────────────────────────────────────────────────────────┐
│                     SALT Pipeline Overview                   │
│                                                              │
│  Phase 1: Indexing (once per document)                      │
│  ┌──────────┐    ┌──────────────┐    ┌──────────────────┐   │
│  │ Document  │ →  │ BGE Encoder  │ →  │ Per-Sentence     │   │
│  │ D = {s_i} │    │ (512-token   │    │ Keyword Extraction│   │
│  │          │    │  dense pack)  │    │ via [CLS] attn   │   │
│  └──────────┘    └──────────────┘    └──────────────────┘   │
│                                                    │         │
│                                                    ▼         │
│  ┌──────────────────────────────────────────────────────┐   │
│  │ Compute Sentence Frequency (SF) for each keyword      │   │
│  │ Filter salience set S (top 10% quantile, p=0.9)      │   │
│  └──────────────────────────────────────────────────────┘   │
│                                                    │         │
│  ┌──────────────────────────────────────────────────────┐   │
│  │ Build Keyword Trie T:                                │   │
│  │ - Each sentence s_i → sorted path by decreasing SF   │   │
│  │ - Shared prefixes for sentences with common anchors  │   │
│  └──────────────────────────────────────────────────────┘   │
│                                                              │
│  Phase 2: Selection (per query / per budget)                │
│  ┌──────────────────────────────────────────────────────┐   │
│  │ Summary Mode:                                         │   │
│  │   BranchAllocate → select within branches by Eq.(5)   │   │
│  │   GlobalFill → assign unused budget                    │   │
│  │                                                       │   │
│  │ Query Mode:                                           │   │
│  │   QueryKeywords → activate trie nodes at any depth    │   │
│  │   AnchorPhase → admit top candidates + neighbors      │   │
│  │   BranchAllocate + GlobalFill → as summary mode       │   │
│  └──────────────────────────────────────────────────────┘   │
│                                                              │
│  Output: Sentence subset R in original document order        │
│  → Plain-text prompt → Any downstream LLM                    │
└─────────────────────────────────────────────────────────────┘
核心公式
关键词提取与句子频率
[CLS] Attention 关键词排序: 对每个句子 ,使用 BGE encoder 的 [CLS] token attention 对内容词降序排列。
Knee Detection 关键词数量确定:
余弦相似度累积曲线 (Eq. 1):
其中 是前 个词的均值嵌入与完整句子均值嵌入的余弦相似度。 是单调包络线。Kneedle 算法找到 knee 点 ,限制最多选择 的内容词。
句子频率 (Sentence Frequency) (Eq. 2):
其中 是句子 的关键词集合。SF 衡量一个关键词作为选中锚点出现在多少个句子中。
Salience Set 过滤: 保留 高于 -th 分位数(默认 )的关键词。
归一化显著性权重:
词缀树结构
子树关键词签名: 对于 trie 节点 ,令 为其后代句子, 为其关键词签名。
已覆盖关键词:
未覆盖质量 (Uncovered Mass) (Eq. 3):
预算约束选择
边际增益 (Eq. 4):
句子评分 (Eq. 5):
其中 偏好中等长度句子, 编码句子级先验(位置和查询模式下的词匹配)。
Branch Allocate 策略
分支配额 = 固定下限 + 剩余份额 ,其中 。 是分支的剩余未覆盖质量。次线性指数压缩高质量分支,下限为低质量分支保留容量。
查询模式
有效显著性集合:
其中 是查询关键词。查询关键词在计算 时被赋予更大质量。
注意力源重归一化 (Appendix B.2)
Span-local Renormalization (Eq. 6):
其中 是句子在 chunk 中的 token 跨度。
Kneedle 截止 (Appendix B.3) (Eq. 7):
其中 。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| BGE Encoder | BAAI/bge-small-en-v1.5, 6层 BERT, , 33M 参数 | 512-token dense packing, 2-sentence overlap |
| [CLS] Attention | 最终层 [CLS] token 的 attention row 用于关键词排序 | Span-local renormalization (Eq. 9) |
| Kneedle Cutoff | 基于余弦累积曲线的 knee 检测确定关键词数量 | , 即最多选 40% 词 |
| Sentence Frequency | 关键词在句子关键词集中出现的次数 | SF 分布的 分位数阈值 |
| Keyword Trie | 内部节点由 salience set 关键词标记,叶子存储句子 ID | 根到叶路径按 SF 降序排列 |
| Branch Allocate | 按未覆盖质量 分配预算给分支 | (次线性) |
| Anchor Phase | 查询模式下,激活匹配查询关键词的 trie 节点 | 控制相关性-覆盖率权衡 |
训练流程
SALT 不需要训练。它是一个免训练的提取式框架:
- 一次性索引:对文档运行 BGE-small-en-v1.5 (33M 参数) 进行关键词提取和 trie 构建
- 可复用:trie 对压缩预算和查询模式不变,可跨多轮对话重复使用
- 两种模式:
- 摘要模式: 无条件从根遍历,按分支未覆盖质量分配预算
- 查询模式: 提取查询关键词,激活匹配的 trie 节点, 控制相关性-覆盖率权衡
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 发现主题坍塌问题 | 首次明确指出标量排名压缩方法在严格预算下导致主导主题垄断预算、丢弃低频主题的问题 | Appendix A: 诊断性 ROUGE-L 实验证明仅选 top-ranked centroid candidates 并非始终最优 |
| SF 有序的关键词 Trie | 用句子频率 (SF) 作为文档衍生的主题结构代理,将关键词组织到可复用的 trie 中,预算先在主题分支间分配再选择句子 | Section 3.2: 子树未覆盖质量 度量分支代表性,branch allocate 防止主导主题垄断 |
| 多锚点检索 (Multi-anchor Retrieval) | 查询关键词可在 trie 中任意深度激活节点,不仅限于前缀下降,支持查询相关关键词作为主锚点或次共现 | Section 3.2: 扩展显著性集,恢复被剪枝但在某些句子中存在的查询关键词 |
| 跨轮次可复用索引 | 索引独立于查询,多轮对话中只需遍历 trie,摊销编码成本 | Section 4.4: QuALITY 19 轮对话中,SALT 总成本 0.91s vs RECOMP 1.88s vs 基线 3.71s |
五、代码实现分析
实现细节
- 框架: PyTorch 2.6.0 / 2.7.1
- Encoder: BAAI/bge-small-en-v1.5 (33M 参数, 6 layers, )
- 密集打包: 连续句子贪婪拼接至 512-token chunk,相邻 chunk 重叠 2 句
- Span-local Renormalization: 对每个句子 token 跨度内的 [CLS] attention 做局部归一化 (Eq. 9)
- 输出格式: 每个句子产生 5-7 个内容词(中位数 6 个,平均句长 28 词),附带 attention 权重和 final layer hidden-state embeddings
与其他方法的对比配置
| 方法 | 配置 |
|---|---|
| SnapKV | 默认 20% 预算 |
| FastKV | 60% prefill + 20% decode 预算 |
| DuoAttention | 20% (论文最佳为 50%,此处调低以对齐预算) |
| SentenceKV | 原始实现不变 |
| H2O | Chunked prefill at 8k |
| EXIT | spaCy 分句 + LoRA-tuned Gemma-2B classifier, threshold 0.5 |
| RECOMP | 原始实现不变 |
| CPC | 预训练 LoRA + local Llama-3.1-8B-Instruct answer generator |
| Sentinel | Qwen-2.5-0.5B proxy + trained detector |
六、实验结果
实验设置
- 模型: LLaMA-3.1-8B-Instruct (主), Ministral-8B-Instruct-2410 (附录)
- 硬件: NVIDIA H100 (主), 跨代验证: V100, A100, B200
- 数据集: PG19 (latency/memory profiling), LongBench (accuracy), QuALITY (multi-turn), RULER/NIAH (retrieval)
- 上下文长度: 16k – 256k tokens
- KV Cache 保留率: 20%
基准测试: LongBench 准确率 (Table 1)
LLaMA-3.1-8B-Instruct, 20% KV cache retention:
| Method | Single-Doc QA | Multi-Doc QA | Summarization | Few-Shot | Synthetic | Code | Avg. |
|---|---|---|---|---|---|---|---|
| Full-context | 43.58 | 44.65 | 29.22 | 69.48 | 54.21 | 60.01 | 50.19 |
| KV Cache Methods (20%) | |||||||
| SnapKV | 43.29 | 43.92 | 26.59 | 67.95 | 53.75 | 58.74 | 49.04 |
| FastKV | 43.31 | 44.10 | 26.61 | 68.36 | 53.72 | 59.26 | 49.23 |
| SentenceKV | 39.25 | 43.82 | 28.18 | 69.26 | 53.24 | 47.33 | 46.85 |
| DuoAttention | 34.71 | 36.67 | 24.30 | 58.02 | 50.81 | 54.33 | 43.14 |
| Preprocessing Methods (20%) | |||||||
| EXIT | 31.50 | 23.77 | 24.94 | 58.89 | 13.50 | 37.45 | 31.68 |
| RECOMP | 35.88 | 41.09 | 24.16 | 52.06 | 50.77 | 37.37 | 40.22 |
| CPC | 38.91 | 39.42 | 24.97 | 51.67 | 51.50 | 21.84 | 38.05 |
| Sentinel | 39.85 | 41.66 | 26.15 | 38.78 | 51.55 | 38.83 | 39.47 |
| SALT | 40.05 | 41.42 | 26.95 | 62.21 | 53.37 | 37.06 | 43.51 |
关键观察:
- SALT 在预处理方法中平均准确率最高 (43.51),仅次于全上下文 (50.19) 和 SnapKV/FastKV (~49)
- SALT 在 Few-Shot (62.21) 上显著领先所有压缩方法
- Code 是所有预处理方法的共同弱点(句子级粒度无法区分代码行边界)
- KV cache 方法 (SnapKV/FastKV) 最接近全上下文基线,但 SALT 在多数类别上表现更好
Ministral-8B 结果 (Appendix D, Table 5): SALT 平均 45.42,同样在预处理方法中领先。
端到端效率 (Section 4.2, Figure 3)
在 16k–256k 上下文长度上的 walltime 和峰值 GPU 内存:
Walltime (s) at 20% budget (Table 7):
| Method | 16k | 32k | 64k | 128k | 256k |
|---|---|---|---|---|---|
| SALT | 1.92 | 2.61 | 4.01 | 5.99 | 11.51 |
| EXIT | 5.83 | 16.30 | 60.60 | OOM | OOM |
| RECOMP | 2.00 | 2.29 | 3.34 | 6.27 | 11.95 |
| FastKV | 1.73 | 2.35 | 4.22 | 10.77 | 34.29 |
| SnapKV | 2.00 | 3.08 | 6.43 | 18.13 | 61.75 |
SALT 在预处理方法中 latency 最低(与 RECOMP 相当),且远低于 EXIT/CPC。在 KV cache 方法中,SALT 与 FastKV 相当,远低于 SnapKV/SentenceKV。
Peak GPU Memory (GB) at 20% budget (Table 8):
| Method | 16k | 32k | 64k | 128k | 256k |
|---|---|---|---|---|---|
| SALT | 16.70 | 17.90 | 20.20 | 23.30 | 32.80 |
| DuoAttention | 16.80 | 17.85 | 19.85 | 23.85 | 31.86 |
| FastKV | 17.37 | 19.39 | 23.43 | 31.52 | 47.67 |
| EXIT | 23.70 | 45.40 | 73.20 | OOM | OOM |
SALT 的峰值内存与 DuoAttention 相当(~31.86–32.80 GB),远低于需要完整 prefill 的方法(EXIT 在 64k 就 OOM)。
跨硬件平台可移植性 (Section 4.3, Table 2)
Peak GPU Memory (GB) of SALT across NVIDIA generations at 20% retention:
| GPU | 32k | 64k | 128k | 256k | Scaling (256k/32k) |
|---|---|---|---|---|---|
| V100 (Volta, 2017) | 20.10 | 22.50 | 27.87 | 40.22 | 2.00× |
| A100 (Ampere) | 18.30 | 20.65 | 24.14 | 33.29 | 1.81× |
| H100 (Hopper) | 17.90 | 20.20 | 23.30 | 32.80 | 1.83× |
| B200 (Blackwell) | 16.41 | 17.86 | 20.67 | 25.72 | 1.57× |
关键发现:V100(2017 年 Volta)成功处理 256k 上下文,证明 SALT 不依赖特定加速器库(如 FlashAttention),可在旧 GPU 上运行。
多轮交互成本 (Section 4.4, Table 6)
QuALITY @ 20% budget, 50 articles, 972 turns:
| Method | TTFT (ms) | Comp. (ms/turn) | Acc. | HARD (s) |
|---|---|---|---|---|
| No compression | 195 | — | 0.741 | 3.71 |
| FastKV | 138 | — | 0.739 | 2.62 |
| RECOMP | 53 | 46 | 0.615 | 1.88 |
| SALT | 38 | 11 | 0.726 | 0.91 |
SALT 在 19 轮对话中总成本仅 0.91s,比基线快 4×,比 RECOMP 快 2×,且准确率 (72.6%) 远高于 RECOMP (61.5%),接近无压缩基线 (74.1%)。
Needle-in-a-Haystack (NIAH, Section 4.5, Figure 6)
SALT 在所有上下文长度上保持 NIAH 准确率,与无压缩基线匹配。在最长的设置下,基线因 tokenized prompt 超出模型窗口而无法运行,但 SALT 的压缩 prompt 仍可容纳。
诊断性 ROUGE-L 实验 (Appendix A, Table 3)
在 20% token budget 下的诊断性摘要实验:
| Method | Gov. | QMS. | MNews | Avg. |
|---|---|---|---|---|
| Full context | 35.14 | 25.78 | 26.73 | 29.22 |
| Random | 29.63 | 21.73 | 22.02 | 24.46 |
| kNN | 30.23 | 20.95 | 22.50 | 24.56 |
| Centroid | 29.64 | 20.45 | 21.62 | 23.90 |
| SALT (Trie) | 32.77 | 23.99 | 24.08 | 26.95 |
SALT 在所有数据集上均优于其他选择策略,证明 trie-based 主题分配优于标量排名。
Trie 规模与可扩展性 (Appendix C, Table 4)
| Metric | 32k | 64k | 128k | 256k |
|---|---|---|---|---|
| Sentences | 1,783 | 3,365 | 7,738 | 15,411 |
| 176 | 388 | 770 | 1,164 | |
| Trie nodes | 2,163 | 3,546 | 9,679 | 20,582 |
| Nodes/sentence | 1.21 | 1.05 | 1.25 | 1.34 |
| Depth-1 branches | 149 | 327 | 637 | 1,007 |
| Median path depth | 2.2 | 2.1 | 2.1 | 2.4 |
| Max path depth | 7.4 | 6.7 | 8.1 | 8.3 |
Trie 规模随上下文长度近线性增长,但路径深度与长度无关(中位数 2.1–2.4,最大 < 8.5)。256k 文档仅 ~20.6k 节点。
七、相关工作
Input-level Prompt Compression
- 句子级: RECOMP (Xu et al. 2024), EXIT (Hwang et al. 2025), CPC (Liskavets et al. 2025), Sentinel (Zhang et al. 2025)
- Token 级: LLMLingua (Jiang et al. 2023), LLMLingua-2 (Pan et al. 2024)
- SALT 的区别:不在标量排名后添加多样性修正,而是在句子选择之前先在主题分支间分配预算
KV Cache / Attention-side Methods
- SnapKV (Li et al. 2024), FastKV (Jo et al. 2025), DuoAttention (Xu et al. 2025), SentenceKV (Zhu et al. 2025), H2O (Zhang et al. 2023)
- SALT 的区别:在 prefill 之前压缩输入,降低 prefill 计算和 KV cache 大小,与这些方法互补
Diversity-aware Retrieval & Summarization
- MMR (Carbonell & Goldstein 1998), Submodular summarization (Lin & Bilmes 2011)
- SALT 的区别:多样性不是候选选择后的后处理修正,而是首要的分配目标
八、总结
核心贡献
- 识别主题坍塌问题: 揭示标量排名压缩方法在严格预算下导致主导主题垄断预算的结构缺陷,将提取式压缩重构为先在文档衍生的词汇主题间分配预算、再进行句子选择
- 提出 SALT 框架: 模型无关的提取式压缩方法,使用 BGE encoder 提取关键词,构建 SF 有序的词缀树,在分支间分配预算后再选择句子
- 多模式支持: 摘要模式无条件遍历 trie,查询模式通过多锚点激活支持跨轮次对话,trie 可复用无需重新编码
- 精度-效率综合最优: 在 LongBench 上匹配 SOTA KV cache 技术的延迟和内存表现,同时在多轮对话中实现 4× 端到端加速
技术影响
SALT 将 prompt 压缩从”标量排名 + 后处理多样性”范式转向”主题结构感知 + 预算预分配”范式。其 trie 索引的跨轮次可复用特性使其特别适合 RAG 和多轮对话场景,其中同一文档会被反复查询。
局限性
- 代码任务表现弱: 句子级粒度无法可靠地区分代码单元边界,关键词提取对源代码中的标识符/运算符/结构 token 无效。这是所有预处理方法的共同弱点
- 20% 预算下限: 任务相关片段通常占输入的 5–20%,因此设 20% 为保守下限。Token 级 KV cache 方法可以压缩得更激进
- 英文专注: 当前仅评估英文数据集(LongBench English subset, QuALITY, PG19)
- BGE 依赖: 虽然仅需一次编码,但 BGE encoder 仍是额外模型依赖
九、参考资源
- 论文: https://arxiv.org/abs/2607.17486
- DOI: https://doi.org/10.48550/arXiv.2607.17486
- License: CC BY 4.0
- Authors: Florida State University
- 相关数据集:
- LongBench: https://arxiv.org/abs/2308.14508
- QuALITY: https://aclanthology.org/2022.naacl-main.394/
- RULER: https://arxiv.org/abs/2404.06654
- PG19: https://arxiv.org/abs/1911.05507
- 相关基线:
- SnapKV: https://proceedings.neurips.cc/paper_files/paper/2024/hash/28ab418242603e0f7323e54185d19bde-Abstract-Conference.html
- FastKV: https://arxiv.org/abs/2502.01068
- DuoAttention: https://openreview.net/forum?id=cFu7ze7xUm
- RECOMP: https://openreview.net/forum?id=mlJLVigNHp
- EXIT: https://aclanthology.org/2025.findings-acl.253/
- LLMLingua: https://aclanthology.org/2023.emnlp-main.825/