Reflex: Real-Time VLA Control through Streaming Inference
A streaming inference framework enabling real-time 50Hz control for Flow Matching Vision-Language-Action models via partitioned attention, AdaRMSNorm, and async pipeline
Reflex: Real-Time VLA Control through Streaming Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Reflex: Real-Time Vision-Language-Action Control through Streaming Inference |
| 作者 | Yuanchun Guo, Bingyan Liu |
| 机构 | 未明确标注(代码仓库: github.com/9yc/Reflex) |
| 论文 | arXiv:2607.14695 |
| 代码 | https://github.com/9yc/Reflex |
| 发布 | 2026-07-16 (v1, 6,286 KB) |
| 许可 | CC BY-NC-SA 4.0 |
| 备注 | ICML 2026 Accepted |
| 领域 | Robotics (cs.RO), Machine Learning |
二、核心思想
Flow Matching Vision-Language-Action (VLA) 模型能够实现精确的连续控制,但其迭代去噪特性与实时机器人控制存在根本性冲突:全局时间步注入使 KV 缓存失效,被迫在缓慢的 O(N²) 重新计算和数学上不正确的缓存复用之间做出选择。
Reflex 是一个流式推理框架,通过利用**时间步不变性(Timestep-Invariance Property)**实现实时流式推理——感知编码器在功能上独立于去噪循环。Reflex 将注意力上下文划分为静态(pinned)、滑动(sliding)和动态(dynamic)三个区域,实现 O(1) 增量缓存更新,同时为固定输入保留与全批次等价的注意力输出。
问题定义
VLA 模型需要 50–100 Hz 的控制频率以实现平滑轨迹,但最先进的 VLA 模型每次推理需要 100–200 ms——存在一个数量级的频率差距。标准方法假设加速单个推理步骤即可得到更快的机器人,但忽略了关键系统级洞察:主要瓶颈不是计算的持续时间,而是同步等待导致执行冻结。
Flow Matching 模型中,时间步嵌入 条件化整个网络,当 在不同去噪步骤间变化时,缓存的 key-value 表示失效。此外,持续 50 Hz 运行暴露于高方差流初始化( at )的频率是离线训练的 50 倍,触发 BFloat16 下溢。
解决方案概述
Reflex 的核心创新包括:
- 分区注意力(Partitioned Attention):将 VLA 上下文分为静态前缀、滑动历史和动态后缀,利用时间步不变性实现 O(1) 缓存更新
- AdaRMSNorm:精度感知的自适应归一化层,防止 BFloat16 在无限视界流式推理中的数值崩溃
- 异步流水线:解耦视觉编码和动作生成到独立线程,结合未来状态预测补偿执行延迟
- 系统优化:操作融合(QKV 打包核、SwiGLU 融合、FlashNorm、FusedAdaLN)和静态环形缓冲区架构
三、技术架构
整体框架
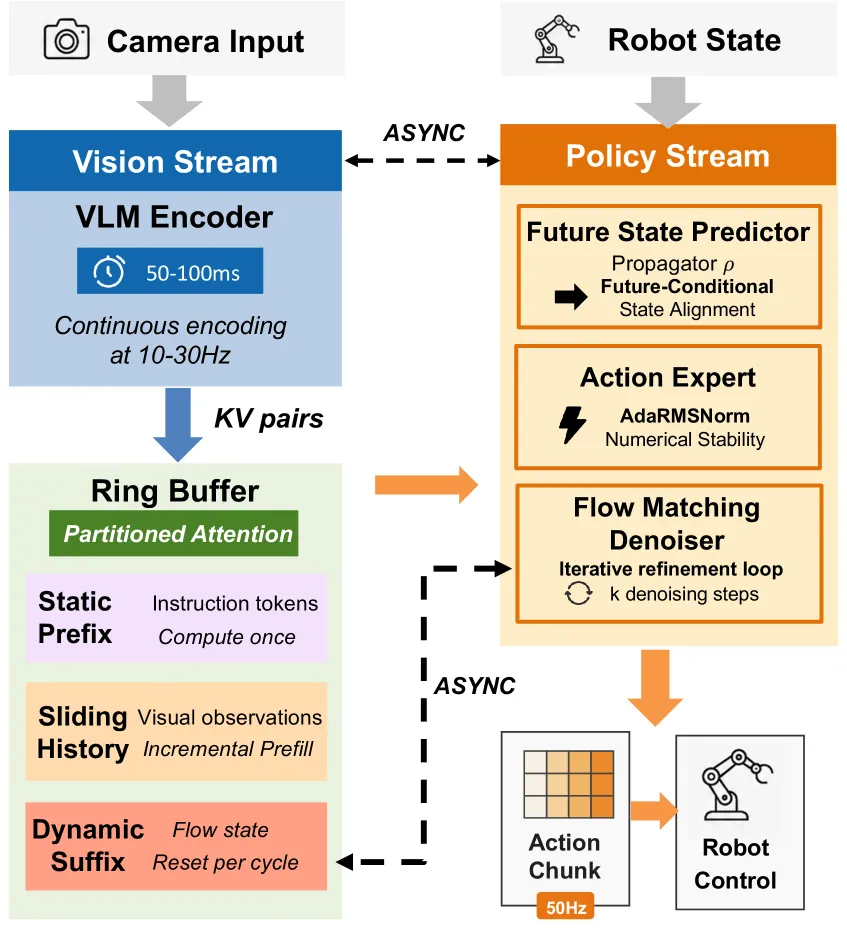
Reflex 系统由两个并行流组成(见 Figure 3):
┌─────────────────────────────────────────────────────────────┐
│                      Reflex System                          │
├───────────────────────┬─────────────────────────────────────┤
│   Thread A (Vision)   │       Thread B (Policy)             │
│   "Producer"          │       "Consumer"                     │
│                       │                                     │
│  Camera Frame → VLM   │                                       │
│  Encoder → Ring Buffer│                                       │
│         ↓             │  Ring Buffer ← KV pairs              │
│  Future State         │  Action Expert                       │
│  Predictor            │  Flow Matching Denoiser              │
│         ↓             │         ↓                            │
│  (predict s_{t+Δ})    │   action_{t+Δ} → Robot               │
└───────────────────────┴─────────────────────────────────────┘

Ring Buffer 分区:
┌────────────┬──────────────────────┬─────────────────┐
│ Static     │ Sliding History      │ Dynamic Suffix   │
│ Prefix     │ (FIFO queue of N     │ (Flow state x   │
│ (instructions) observations)      │  recomputed each)│
│ Permanently│ Each step: enqueue    │ Each denoising   │
│ pinned     │ newest frame, evict   │ step: recompute  │
│            │ oldest frame          │ only this part   │
└────────────┴──────────────────────┴─────────────────┘
核心公式
分区注意力(Partitioned Attention)—— 核心机制:
其中 为永久固定的指令前缀(在 计算一次), 为滑动观察窗口(FIFO 队列,每步入队新帧、出队最老帧), 为动态流状态后缀(每个去噪步骤 重新计算)。
AdaRMSNorm —— 数值稳定性保障:
其中 拼接正弦时间步嵌入和本体感受机器人状态。RMS 计算强制 FP32 执行以防止下溢,门控 MLP 以 BFloat16 运行以最小化内存带宽。
未来状态预测:
用最后的目标动作命令 替换过时的传感器读数 ,预测 时刻的状态。
命题 A.1(分区注意力等价性证明): 对于时间步不变编码器()且采用 FIFO 驱逐策略,分区注意力输出 与全批次注意力输出 在所有动态后缀 token 上严格相等。
证明核心:由于 softmax 操作对输入向量的分区排列不变,只要完整集合的 logits 都存在,注意力权重 与拼接后的分区计算结果一致,因此加权值求和等价于标准注意力计算。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| StreamingInputManager | 缓存驱逐和位置 ID 管理 | add_new_prefix(), merge_caches(), split_caches(), evict_source_prefix() |
| Ring Buffer | 静态环形缓冲区,消除动态内存分配 | buffer_k: num_layers × max_seq_len × num_heads × head_dim (BF16) |
| AdaRMSNorm | 自适应归一化层 | MLP: Linear(cond_dim→hidden_dim) → SiLU → Linear(hidden_dim→model_dim) |
| Future State Predictor | 轻量级未来状态预测模块 | 用最后动作命令 近似 |
| Incremental Prefill | 仅编码最新观察帧 | 检测并编码每步的新帧,避免全量重编码 |
训练流程
Reflex 是一个推理框架,不修改模型训练过程。其部署流程如下:
- 模型加载:预训练 Pi0/Pi0.5 模型(PaliGemma 视觉 backbone + 动作专家解码器)
- Ring Buffer 初始化:在模型加载时分配静态缓冲区
torch.zeros(..., dtype=torch.bfloat16, device='cuda') - 流式推理启动:
- Thread A 持续编码视觉观测并推送到共享缓存
- Thread B 从缓存查询最新可用 token 序列进行流式动作生成
- Adaptive Overlap Scheduling 实现推理与执行的完全重叠
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 分区注意力(Partitioned Attention) | 将 VLA 上下文分为静态前缀、滑动历史、动态后缀三区,利用时间步不变性实现 O(1) 缓存更新 | 命题 A.1 证明与全批次注意力等价(MSE = 0.00);Table 4 消融验证 |
| AdaRMSNorm | 精度感知自适应归一化,基于流相位动态调节激活分布 | Table 5 应力测试:BF16 + AdaRMSNorm 稳定 >2000 步,零 NaN/Inf 事件 |
| 异步流水线 + 未来状态预测 | 解耦视觉编码和动作生成为独立线程,用未来状态预测补偿执行延迟 | Figure 5 调度图;Table 1 显示停滞率从 100% 降至 0% |
| 操作融合 | QKV 打包核、SwiGLU 融合、FlashNorm、FusedAdaLN | Figure 11 操作融合消融 |
| 静态环形缓冲区 | 消除动态内存分配开销 | Appendix B.2 实现细节 |
五、代码实现分析
项目结构
Reflex/
├── streaming_manager.py    # StreamingInputManager: 缓存驱逐和位置ID管理
├── ring_buffer.py          # 静态环形缓冲区实现
├── ada_rmsnorm.py          # AdaRMSNorm: 自适应归一化层
├── future_predictor.py     # 未来状态预测模块
├── pipeline.py             # 异步流水线调度 (Adaptive Overlap Scheduling)
└── ...
关键实现
StreamingInputManager 核心方法:
add_new_prefix():添加新观测 token,返回驱逐计数merge_caches():将前缀和历史合并为连续缓冲区split_caches():去噪循环后恢复结构evict_source_prefix():从所有层移除最老帧 token
Ring Buffer 初始化:
buffer_k = torch.zeros(num_layers, max_seq_len, num_heads, head_dim,
                       dtype=torch.bfloat16, device='cuda')
buffer_v = torch.zeros_like(buffer_k)
ptr = 0  # 当前写入位置
AdaRMSNorm 实现:
self.dense = nn.Sequential(
    nn.Linear(cond_dim, hidden_dim),
    nn.SiLU(),
    nn.Linear(hidden_dim, model_dim),
)
def forward(self, x, cond):
    rms = x.float().pow(2).mean(-1, keepdim=True)  # FP32
    x_norm = x * torch.rsqrt(rms + self.eps)
    gate = 1 + self.dense(cond)
    return x_norm * gate
六、实验结果
基准测试
Table 1: 控制响应性(反应延迟 / 停滞率)
| 模型 | 任务 | 同步延迟 | 同步停滞 | Async-Naive | Async-Naive 停滞 | Reflex | Reflex 停滞 |
|---|---|---|---|---|---|---|---|
| Pi0.5 (2.3B) | LIBERO-Spatial | 148.2ms | 100% | 112.4ms (-24%) | 38% | 78.5ms (-47%) | 0% |
| Pi0.5 | LIBERO-Object | 152.6ms | 100% | 118.6ms (-22%) | 42% | 82.3ms (-46%) | 0% |
| Pi0.5 | LIBERO-Goal | 156.4ms | 100% | 122.8ms (-21%) | 45% | 85.1ms (-46%) | 0% |
| Pi0.5 | LIBERO-Long | 168.8ms | 100% | 134.2ms (-20%) | 52% | 84.2ms (-50%) | 0% |
| Pi0.5 | LIBERO Avg. | 156.5ms | 100% | 122.0ms (-22%) | 44% | 82.5ms (-47%) | 0% |
| Pi0.5 | Kinetix | 172.4ms | 100% | 138.6ms (-20%) | 48% | 86.8ms (-50%) | 0% |
| Pi0 (3.1B) | LIBERO-Long | 226.8ms | 100% | 182.6ms (-19%) | 54% | 105.2ms (-54%) | 0% |
| Pi0 | Kinetix | 224.8ms | 100% | 184.2ms (-18%) | 52% | 112.6ms (-50%) | 0% |
Table 7: 组件延迟分解(Pi0.5, RTX 4090, LIBERO)
| 组件 | 标准延迟 (ms) | Reflex 延迟 (ms) | 减少 |
|---|---|---|---|
| 图像预处理 | 4.2 | 4.2 | 0% |
| 视觉编码器 (Prefill) | 42.1 | 8.2 | 81% |
| 观测融合 | 12.4 | 3.6 | 71% |
| 去噪循环 (×10) | 68.4 | 32.8 | 52% |
| 动作解码 | 8.1 | 3.6 | 56% |
| 总计 | 135.2 | 52.4 | 61% |
Table 8: GPU 可扩展性(RTX 4090 vs RTX 3090)
| GPU | 方法 | 延迟 (ms) | 加速比 | 显存 (GB) | 成功率 (%) |
|---|---|---|---|---|---|
| RTX 4090 | Standard | 135.2 | — | 8.42 | 78.0 |
| RTX 4090 | Reflex | 52.4 | 2.58× | 6.15 | 79.5 |
| RTX 3090 | Standard | 168.4 | — | 8.56 | 78.0 |
| RTX 3090 | Reflex | 68.2 | 2.47× | 6.32 | 79.2 |
任务性能
Table 3: LIBERO 子任务详细成功率(%)
| 模型 | 任务 | Standard | Naive† | Async | Reflex | Δ |
|---|---|---|---|---|---|---|
| Pi0.5 | Spatial | 82.4 | 14.2 | 82.8 | 83.2 | +0.8 |
| Pi0.5 | Object | 79.6 | 12.8 | 80.0 | 80.4 | +0.8 |
| Pi0.5 | Goal | 81.2 | 11.6 | 81.4 | 82.0 | +0.8 |
| Pi0.5 | Long | 68.8 | 8.4 | 69.6 | 72.4 | +3.6 |
| Pi0 | Spatial | 84.6 | 15.4 | 85.0 | 85.4 | +0.8 |
| Pi0 | Object | 81.8 | 13.2 | 82.2 | 82.6 | +0.8 |
| Pi0 | Goal | 83.4 | 12.4 | 83.6 | 84.2 | +0.8 |
| Pi0 | Long | 71.0 | 9.2 | 72.2 | 75.0 | +4.0 |
Naive Cache 产生不正确输出(标记 †),因为忽略了 Flow Matching 的时间步条件。
Kinetix 基准(Figure 7):Reflex 在动态物理基准上提升更显著:Pi0.5 +7.4%,Pi0 +6.7%。
消融实验
Table 4: 分区注意力消融
| 策略 | 预测 MSE (↓) | 成功率 (%) |
|---|---|---|
| 全量重新计算 (Oracle) | 0.00 | 85.2 |
| 朴素缓存 | 1.42 | 12.5 |
| 分区注意力 (Ours) | 0.00 | 85.4 |
分区注意力实现了与全量重新计算相同的正确性(MSE = 0.00),同时保持与 Oracle 相当的成功率。
Table 5: BF16 稳定性压力测试
| 变体 | 最大稳定步数 | NaN/Inf 事件 | 额外延迟 (ms) |
|---|---|---|---|
| BF16 基线 | 120–220 | frequent | 0.0 |
| BF16 + FP32 norm-only | 700–1200 | rare | +0.8 |
| BF16 + AdaRMSNorm | >2000 | none | +0.4 |
Table 9: 动作块大小消融(Pi0.5, LIBERO)
| 块大小 | 标准延迟 (ms) | Hz | Reflex 延迟 (ms) | Hz | 加速比 | 成功率 (%) |
|---|---|---|---|---|---|---|
| 25 | 98.4 | 10.2 | 42.6 | 23.5 | 2.31× | 78.8 |
| 50 (默认) | 135.2 | 7.4 | 52.4 | 19.1 | 2.58× | 79.5 |
| 75 | 168.6 | 5.9 | 64.2 | 15.6 | 2.63× | 79.2 |
| 100 | 202.4 | 4.9 | 76.8 | 13.0 | 2.64× | 78.6 |
SmolVLA (500M) 结果(Table 10):
| 任务套件 | 标准延迟 (ms) | Reflex 延迟 (ms) | 标准成功率 (%) | Reflex 成功率 (%) |
|---|---|---|---|---|
| LIBERO-Spatial | 46.2 | 20.1 (-56%) | 74.8 | 75.6 (+0.8) |
| LIBERO-Object | 47.8 | 20.8 (-56%) | 71.2 | 72.4 (+1.2) |
| LIBERO-Goal | 49.4 | 21.5 (-56%) | 73.6 | 74.8 (+1.2) |
| LIBERO-Long | 50.8 | 22.2 (-56%) | 70.0 | 72.4 (+2.4) |
| LIBERO Avg. | 48.6 | 21.2 (2.29×) | 72.4 | 73.8 (+1.4) |
证明 Reflex 的加速效果在小模型上同样有效。
真实机器人部署
Table 2: AgileX PiPer 真实机器人部署(每任务 20 次实验)
| 任务 | 同步成功率 | Async-Naive 成功率 | Reflex 成功率 | Reflex 延迟 | Reflex 停滞率 |
|---|---|---|---|---|---|
| Pick-Place | 65±8 | 62±8 | 76±7 | 101ms | 0% |
| Articulated | 52±9 | 48±11 | 66±9 | 104ms | 0% |
| Dynamic Recovery | 38±8 | 32±8 | 55±9 | 110ms | 0% |
Reflex 在真实机器人上相比同步基线分别提升 +11pp、+14pp、+17pp。
内存效率
Reflex 通过增量缓存更新保持平坦的内存占用:LIBERO 上节省 27% 峰值 VRAM,Kinetix 上节省 24%。标准推理随上下文长度线性增长,而 Reflex 维持固定大小的滑动窗口。
七、相关工作
| 方法 | 核心思路 | 与 Reflex 的区别 |
|---|---|---|
| VLA-Cache (Xu et al., 2025) | 按帧差异分区视觉 token | 面向静态场景,不适用于 Flow Matching 的时间步条件 |
| VL-Cache (Tu et al., 2024) | 模态感知压缩 | 压缩策略,不解决时间步不变性问题 |
| ActionFlow (Dai et al.) | 动作空间缓存 | 同样受限于 Flow Matching 的时间步依赖 |
| Standard KV-caching | 全局缓存复用 | Flow Matching 中时间步变化使缓存失效 |
| Naive Cache | 无分区直接复用 | 产生不正确输出(MSE >> 1.0) |
Reflex 的独特之处在于首次针对 Flow Matching VLA 模型提出了数学正确的流式推理方案,而非简单地加速单个推理步骤。
八、总结
核心贡献
- 范式转变:从加速单个推理步骤转向基于流式的异步执行,实现实时 VLA 控制
- 分区注意力:将 VLA 上下文分为三个区域(静态前缀/滑动历史/动态后缀),实现 O(1) 缓存更新同时保持与全批次注意力严格等价(MSE = 0.00)
- AdaRMSNorm:精度感知的自适应归一化层,通过基于流相位的门控机制,确保 BFloat16 下无限视界 50Hz 流式推理的数值稳定性(>2000 步零 NaN/Inf)
- 异步流水线:解耦视觉感知和动作生成到独立线程,结合未来状态预测补偿执行延迟,消除 100% 停滞率
- 系统优化:操作融合(QKV 打包核、SwiGLU 融合、FlashNorm、FusedAdaLN)和静态环形缓冲区架构
技术影响
- Reflex 实现了 2.58× 推理加速,将 Pi0.5 的推理延迟从 135.2ms 降至 52.4ms
- 实现稳定的 50Hz 流式控制,反应延迟降低高达 54%
- 停滞率从 100% 降至 0%,消除运动过程中的卡顿
- 显存占用降低 24–27%,适合边缘设备部署
- 跨模型尺度(500M–3.1B)验证了方法的普适性
局限性
- 适用范围:仅适用于感知编码器时间步不变的 VLA 架构;Unified DiT 风格架构(时间步条件进入视觉编码器)不在当前范围内
- LIBERO 提升有限:在准静态操作中任务成功率提升较小(+0.8%),主要在动态场景(Kinetix +7.4%)中优势明显
- 依赖硬件:实验主要在 RTX 4090/3090 上进行,边缘设备的实际性能需进一步验证
- 异步调度的复杂性:双线程架构增加了系统实现的复杂度
九、参考资源
- arXiv: https://arxiv.org/abs/2607.14695
- 代码: https://github.com/9yc/Reflex
- ICML 2026: Accepted
- 许可: CC BY-NC-SA 4.0
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 标准阻塞推理 vs Reflex 流式推理对比 | figure-1.png |
| Figure 2 | Flow Matching VLA 架构 | figure-2.png |
| Figure 3 | Reflex 系统架构(Vision Stream + Policy Stream + Ring Buffer) | figure-3.png |
| Figure 4 | 分区注意力掩码(静态前缀/滑动历史/动态后缀) | figure-4.png |
| Figure 5 | 异步流水线调度(Thread A 编码 + Thread B 生成) | figure-5.png |
| Figure 6 | 系统效率对比(Pi0/Pi0.5 跨尺度验证) | figure-6.png |
| Figure 7 | LIBERO 平均 + Kinetix 任务成功率汇总 | figure-7.png |
| Figure 8 | 增量组件消融(Pi0.5 LIBERO Avg) | figure-8.png |
| Figure 9 | Kinetix 可控延迟消融 | figure-9.png |
| Figure 10 | 上下文窗口大小消融 | figure-10.png |
| Figure 11 | 操作融合消融(动作专家延迟) | figure-11.png |
| Figure 12 | Kinetix 基准效率对比 | figure-12.png |