RaBitQCache: Rotated Binary Quantization for KVCache in Long Context LLM Inference
基于 Johnson-Lindenstrauss 引理的旋转二进制量化 KV Cache 框架,通过高吞吐 binary-INT4 算术实现无偏代理分数估计,支持自适应 Top-p 检索,在长上下文推理中实现 2.16× 端到端加速且精度几乎无损
RaBitQCache: Rotated Binary Quantization for KVCache in Long Context LLM Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | RaBitQCache: Rotated Binary Quantization for KVCache in Long Context LLM Inference |
| 作者 | Wenhao Li, Jinhao Dong, Hailin Zhang, Wenhang Shi, Wei Lu, Xiaoyong Du |
| 机构 | 复旦大学(主要),其他合作机构未列出 |
| 论文 | arXiv:2606.31519 |
| 代码 | 无公开仓库(GitHub 搜索未找到) |
| 发布 | 2026-06-30 (v1) |
| 许可 | arXiv.org perpetual non-exclusive license |
核心贡献:
- 提出 RaBitQCache——一种基于 Johnson-Lindenstrauss (JL) 引理的稀疏注意力框架,通过随机旋转将高维 Key 向量映射到单位超立方体顶点并进行二进制量化,构建轻量级代理分数
- 设计无偏代理分数估计器:将昂贵的浮点向量内积转化为二进制码本与 INT4 量化 Query 的高吞吐算术运算,具有严格 误差界
- 实现自适应 Top-p 检索:基于无偏估计支持动态 token 预算调整,相比固定 Top-k 更好地适应不同任务的注意力模式变化
- 设计高性能 GPU kernel 算子 Int4DotBinary:通过打包二进制表示、共享内存 tiling 和向量化位提取,实现 2.84×–3.43× 加速
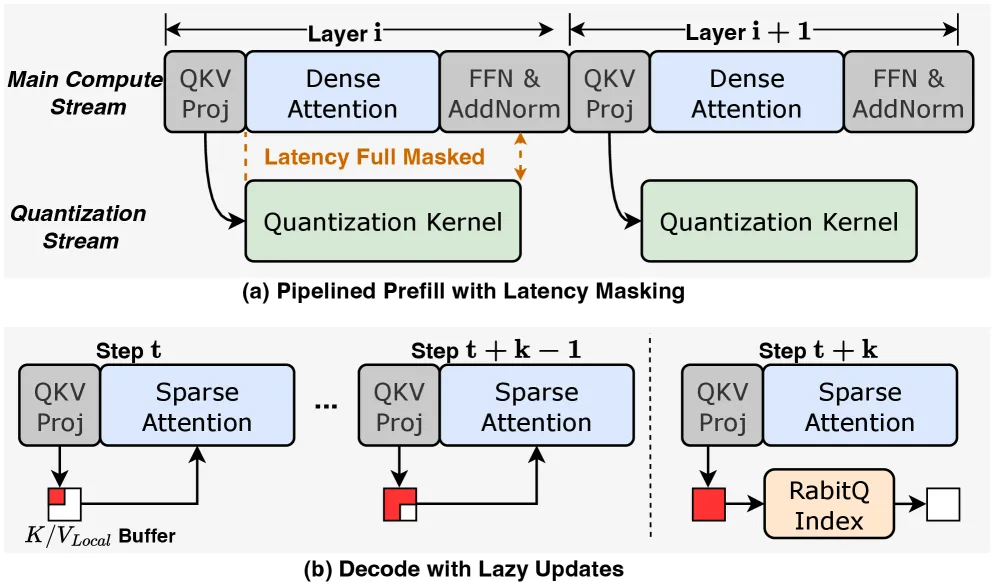
- 提出系统级调度优化:异步预填充隐藏索引构建开销(<10%),惰性解码更新减少 kernel 启动开销
- 在 LongBench、RULER、GSM8K 等基准上验证:RaBitQCache 以不到 20% 的 KV cache 访问率实现与全注意力相当的性能,端到端加速达 2.16×
二、核心思想
问题定义
LLM 正从短对话转向长上下文场景,最大上下文长度已从最初的 2K-4K 增长到 128K 甚至更多。自注意力机制的计算复杂度与输入序列长度呈二次关系,而海量 KV cache 显著增加了 GPU 显存消耗。
现有两条技术路线:
- KV Cache Eviction:丢弃不重要的 KV 对以节省存储,但”一旦不重要就一直不重要”的假设往往不成立
- KV Cache Offloading:保留完整数据,每次计算只加载部分 KV cache。随着存储成本下降,offloading 成为主流
在 offloading 策略下,现有动态选择方法存在两大局限:
- (1) 代理分数不准确:Quest 一次性选择整个 page,由于 token 重要性的离散分布导致检索大量无关 token;DS 仅选择部分维度进行估计,容易偏离真实分布
- (2) 缺乏理论误差界:现有方法无法提供代理分数估计的理论保证,只能近似相对顺序而无法精确估计注意力权重的大小,因此局限于固定 Top-k 方法,不支持自适应 Top-p 检索
解决方案概述
RaBitQCache 的核心洞察是:KV cache 中的 token 本质上是高维向量,评估其重要性的代理分数实际上是一个降维操作。这一视角自然引出经典的 Johnson-Lindenstrauss (JL) 引理——在高维空间中,随机线性投影可以在低维空间中近似保持成对距离。
RaBitQCache 采用两阶段稀疏注意力架构:
Prefill Phase:
Input X → Centroid Calculation → Random Rotation → Binary Quantization → Binary Index + Correction Factors

Decode Phase:
Query q_t → Centering & Normalization → Random Rotation → INT4 Quantization
          → Int4_Dot_Binary (Binary Index × INT4 Query) → Unbiased Proxy Score
          → Adaptive Top-p Selection → Fetch Selected KV pairs + Local Window
          → Hybrid Attention (Sparse + Local)
Index Branch(预填充阶段):对 Key 向量进行中心化和归一化后,通过随机正交矩阵旋转并映射到单位超立方体顶点,生成 1-bit 二进制索引和标量校正因子。
Main Branch(解码阶段):对每个新 Query 进行相同的旋转和 INT4 量化,通过自定义 CUDA kernel 计算二进制索引与 INT4 Query 的点积,得到无偏代理分数估计,用于自适应 Top-p 检索。
三、技术架构
整体框架
RaBitQCache 建立在 KV cache offloading 范式之上,核心创新在于代理分数的构造方式:
| 组件 | 参数量 | 功能 |
|---|---|---|
| Prefill 中心化与归一化 | 零额外参数 | 计算 prefill 阶段的 query/key 质心 ,对向量进行中心化和归一化 |
| 随机旋转矩阵 P | 正交矩阵(初始化时生成一次) | 将归一化向量旋转到随机正交基 |
| 二进制索引 | 1-bit per dimension | 预填充阶段生成的二进制码本,存储于 GPU 显存 |
| 校正因子 | 标量 per token | 每个 key token 对应的无偏估计校正标量 |
| INT4 Query 量化 | 零额外参数 | 解码阶段对旋转后的 query 进行均匀标量量化为 INT4 |
核心公式
Attention Error Bound(Eq. 1)
稀疏注意力的目标是在最小化选择 token 数量的同时保持误差界尽可能低。
Inner Product Decomposition(Eq. 2)
原始内积分解为:
其中中心化归一化向量为 ,。等式右侧除 外的项均为常量或可预计算。
Binary Codebook Construction(Eq. 3)
通过随机正交旋转矩阵 将归一化 key 映射到二进制码本:
query 旋转后为 。
Unbiased Proxy Score Estimator(Eq. 4)
其中 是标量校正因子。Theorem A.1 证明该估计器是真实余弦相似度的无偏估计,具有严格的 误差界。
INT4 Query Quantization(Eq. 5)
其中 是 的动态范围。根据 Theorem A.2,此量化引入的误差在 量级内。
Algorithm 1: Prefill Index Construction
Algorithm 1: RaBitQCache Index Construction (Prefill)
Input: Key tensors K, Rotation Matrix P
Output: Binary Index C_bar_b, Correction Factors alpha

Step 1: Centering and Normalization
  Calculate centroid c_k from K
  for each token i in 1...L do
    k^(i) ← K[i] - c_k
    k_c^(i) ← k^(i) / ||k^(i)||_2
  end for

Step 2: Randomized Rotation
  K' ← (K - c_k) P^T

Step 3: Binary Quantization & Correction
  for each token i in 1...L do
    C_bar_b[i] ← sign((K'[i])^T)        // 1-bit representation
    c_bar ← (2 · C_bar_b[i] - 1_D) / sqrt(D)
    alpha[i] ← <c_bar, P^T k_c^(i)>     // scalar correction factor
  end for

Store C_bar_b and alpha
Algorithm 2: Decode with Adaptive Retrieval
Algorithm 2: RaBitQCache Decoding with Adaptive Retrieval
Input: Current Query q_t, Index C_bar_b, alpha, Centroids, Matrix P
Output: Attention Output o_t

Step 1: Query Pre-processing & INT4 Quantize
  q_c ← (q_t - c_q) / ||q_t - c_q||_2
  q' ← P^T q_c
  q_bar_u ← UniformQuantize(q')           // INT4 quantization

Step 2: Score Estimation
  S_binary ← Int4_Dot_Binary(C_bar_b, q_bar_u)
  S_norm ← Reconstruct(S_binary) / alpha   // unbiased estimate
  S_orig ← Eq.(2)(S_norm)                  // reconstruct original scores

Step 3: Adaptive Selection
  I_select ← TopP(softmax(S_orig / sqrt(D)), p)  // adaptive token budget

Step 4: Hybrid Attention
  Fetch K[I_select], V[I_select]
  o_t ← Attn(q_t, K_select ∪ K_local, V_select ∪ V_local)
Algorithm 3: Top-p Mask Generation (FlashInfer adapted)
采用三元搜索在 时间内找到阈值,而非排序的 :
Algorithm 3: Top-p Mask Generation (Adapted from FlashInfer)
Input: Scores S, Target mass p
Output: Boolean Mask M

low ← 0, high ← max(S)
repeat
  π₀ ← (high + 2·low) / 3
  π₁ ← (2·high + low) / 3
  G₀ ← Σ_{s∈S} s · I(s > π₀)    // accumulated mass above π₀
  G₁ ← Σ_{s∈S} s · I(s > π₁)    // accumulated mass above π₁
  v_min ← min{s ∈ S | s > low}
  v_max ← max{s ∈ S | s ≤ high}
  if G₁ ≥ p then low ← π₁
  else if G₀ ≥ p then low ← π₀, high ← min(π₁, v_max)
  else high ← min(π₀, v_max)
until v_min = v_max
θ ← low
M ← (S > θ)
系统级调度优化
Asynchronous Prefill
预填充阶段构建的索引仅在当层首次解码时需要。利用这一点,将索引构建与主注意力计算解耦:主 CUDA stream 执行计算密集的 稠密注意力时,辅助低优先级 stream 并行执行 的 key 向量量化。这使得索引构建延迟被二次复杂度的预填充注意力计算完全隐藏。
Lazy Decode Updates
解码阶段逐 token 更新索引会引入显著的 kernel 启动开销。采用惰性更新策略:局部窗口 作为全精度回写缓冲区,新 token 暂时累积在该缓冲区中参与混合注意力计算 ,无需立即量化。当 达到预设批量容量时才批量量化。这既利用了数据并行性饱和 GPU 资源,又隐含地保证了近期上下文的高精度访问。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| JL 引理驱动的无偏估计器 | 将代理分数构造问题重新表述为 JL 引理下的降维估计,获得严格误差界 | Theorem A.1: 无偏估计; Eq. (4) |
| 旋转二进制量化 | 随机正交旋转 + sign 操作将高维 Key 压缩为 1-bit 二进制码本 | Eq. (3): |
| INT4 Query 量化 | 对旋转后的 Query 进行均匀标量量化为 INT4,与二进制码本匹配 | Eq. (5): 量化误差在 量级内 |
| Int4DotBinary GEMV Kernel | 自定义 CUDA kernel 实现二进制-INT4 高吞吐算术运算 | Table 5: 2.84×–3.43× 加速 |
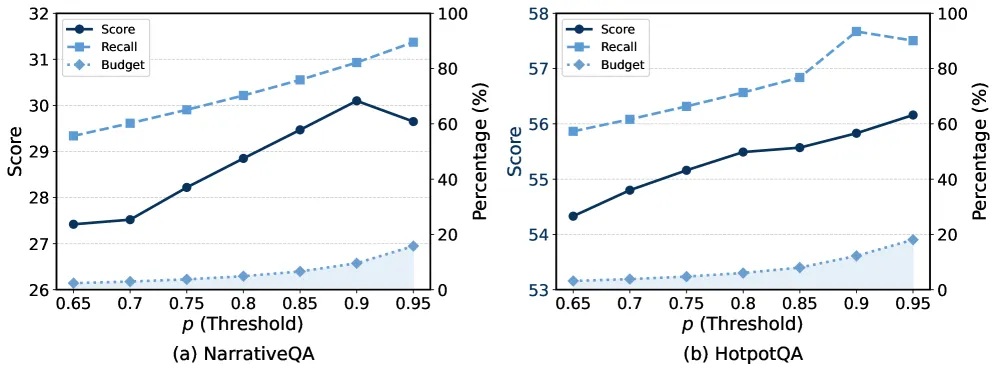
| 自适应 Top-p 检索 | 基于无偏估计支持动态 token 预算调整,适应不同任务的注意力模式 | Figure 4: p 在不同任务上表现稳定; Table 7: 固定 k 跨任务差异大 |
| 三元搜索 Top-p 掩码算子 | 适配 FlashInfer 的线性时间阈值搜索,避免排序的 开销 | Algorithm 3: ternary search partitioning |
| 异步预填充流水线 | 隐藏索引构建开销于稠密注意力计算之后 | Section 3.4: prefill overhead < 10% |
| 惰性解码更新 | 局部窗口作为全精度缓冲,批量量化减少 kernel 启动开销 | Section 3.4: 隐含 sliding window 保证近期上下文精度 |
五、GPU Kernel 设计
Int4DotBinary GEMV 算子
RaBitQCache 的核心计算瓶颈在于量化 INT4 query 向量 与大规模二进制 key cache 之间的相似度估计。为实现高吞吐近似分数估计,设计了自定义 CUDA kernel,通过三项关键技术优化 INT4 × Binary GEMV 操作:
打包二进制表示:通过将沿 head 维度的 32 个连续二进制元素打包为单个 32 位整数,解决将二进制 key 存储为 8 位整数(uint8)带来的显著内存带宽浪费,实现 8× 内存带宽降低。数据打包在量化阶段提前完成,避免运行时开销。
共享内存 Tiling:由于同一 INT4 量化 query 向量 需对所有 key 的内积计算中使用,实施缓存策略消除冗余全局内存访问。每个 thread block 首先协作加载当前 token 的 到片上共享内存;随后 block 内所有线程从低延迟缓存读取,处理不同的 key-value 对。有效将 query 向量的全局内存流量降低相当于 block size 倍的因子。
向量化位提取:利用向量化指令和位运算优化点积计算的 inner loop。使用 128 位向量化加载高效获取数据,并通过快速位运算从打包二进制格式中提取单独位。结合循环展开,使编译器生成高度高效的指令流水线,最大化指令级并行性。
Benchmark(Table 5):
| Config (batch×tokens×heads×dim) | Original (ms) | Warp (ms) | Speedup |
|---|---|---|---|
| 1×1024×8×128 | 0.0382 | 0.0127 | 3.01× |
| 1×4096×8×128 | 0.0386 | 0.0130 | 2.96× |
| 1×8192×8×128 | 0.0385 | 0.0129 | 2.98× |
| 1×16384×8×128 | 0.0388 | 0.0136 | 2.84× |
| 4×4096×8×128 | 0.0387 | 0.0130 | 2.97× |
| 8×4096×8×128 | 0.0741 | 0.0216 | 3.43× |
| 1×4096×32×128 | 0.1585 | 0.0501 | 3.16× |
| 1×8192×8×64 | 0.0212 | 0.0093 | 2.27× |
高效 Top-p 算子
为在自适应检索阶段确保高吞吐,实现了定制的融合 CUDA kernel。借鉴 LLM 生成中常用的 Nucleus (Top-p) Sampling 策略,适配 FlashInfer 的高性能采样 kernel 作为大规模并行 KV cache 检索掩码算子。标准 Top-p 实现通常依赖排序,带来 开销,而 RaBitQCache 采用基于值划分的线性时间三元搜索方法(Algorithm 3),将阈值搜索复杂度降至 。
六、实验结果
实验设置
| 配置项 | 值 |
|---|---|
| GPU | NVIDIA Hopper 架构 GPU |
| 基线系统 | vLLM v0.10.2 + FlashInfer v0.5.3 + LMCache |
| 代码规模 | 5000+ 行(Python 编排 + OpenAI Triton + 自定义 CUDA kernel) |
| 模型 | Longchat-7B-v1.5-32k, LLaMA-3.1-8B-Instruct, LLaMA-3.1-70B-Instruct |
| 基准 | LongBench (13 tasks), RULER (8K–64K), GSM8K |
| Baselines | Quest, Double Sparse (DS), SparQ, MagicPIG, PyramidKV, SnapKV, PQCache, KIVI, Oracle |
| RaBitQCache 超参数 | LongBench: p=0.95; RULER/GSM8K: p=0.9 |
| Baseline 配置 | Quest (chunk_size=16), SparQ (r=16), DS (r=32, quant_bit=2), MagicPIG (K=10, L=150, W=64), PyramidKV (capacity=512, window=64), SnapKV (capacity=1024, window=64), PQCache (compress=0.1, subvec=2, bits=6), KIVI (k/v_bits=2, group=32, residual=128) |
精度结果(LongBench)
Table 2: LongBench 主要结果(Generation Score / Attention Recall)
| 方法 | 预算 | LongChat-7B Score (Recall) | LLaMA-3.1-8B Score (Recall) |
|---|---|---|---|
| Full Attention | 100% | 35.78 (100%) | 50.58 (100%) |
| Oracle | 1024 (11.4%) | 35.84 (89.3%) | 50.31 (86.9%) |
| RaBitQCache | p=0.95 (17.33%) | 36.21 (89.8%) | 50.60 (90.7%) |
| Quest | 4096 (40.29%) | 36.28 (86.1%) | 49.24 (92.9%) |
| Quest | 8192 (64.57%) | 36.11 (94.7%) | 50.43 (97.0%) |
| DS | 8192 (64.60%) | 32.58 (67.4%) | 50.47 (96.9%) |
| SparQ | Ratio=0.25 (25%) | 35.91 (93.1%) | 50.15 (89.8%) |
关键发现:
- RaBitQCache 在 LongChat 上仅用 17.33% 预算即达到 89.85% 注意力召回,性能几乎与 Full Attention 持平,甚至略超(36.21 vs 35.78)
- 在 LLaMA-3.1-8B 上达到 50.60 分(90.7% recall),优于 Full Attention(50.58)
- 相比之下 Quest-4096 虽在 LongChat 上略优,但代价是 40.29% 的预算和更低的召回率(86.05%)
- RaBitQ 平均得分 50.63,高于所有 baselines:MagicPIG (49.95), PQCache (50.34), KIVI (50.13), PyramidKV (45.09), SnapKV (44.91)
Table 3: LLaMA-3.1-8B-Instruct 上与其他稀疏注意力方法的对比
| 方法 | RaBitQ | MagicPIG | PyramidKV | SnapKV | PQCache | KIVI |
|---|---|---|---|---|---|---|
| Avg. Score | 50.63 | 49.95 | 45.09 | 44.91 | 50.34 | 50.13 |
Table 4: 跨模型规模和基准的泛化能力
| Benchmark | Full | RaBitQ | Quest | SparQ |
|---|---|---|---|---|
| LongBench Avg. (LLaMA-3.1-70B) | 54.62 | 54.58 | 50.69 | 53.76 |
| RULER Avg. (LLaMA-3.1-8B, 8K–64K) | 79.65 | 79.55 | 78.20 | 79.08 |
| GSM8K Acc. (LLaMA-3.1-8B) | 0.81 | 0.77 | 0.70 | 0.77 |
| GSM8K Recall | 1.00 | 0.888 | 0.813 | 0.605 |
- 在 LLaMA-3.1-70B 的 LongBench 上,RaBitQCache 达到 54.58,几乎追平 Full Attention(54.62)
- 在 RULER 上,RaBitQCache 在 8K–32K 匹配或超越 Full Attention,64K 仍具竞争力
- 在 GSM8K 上,RaBitQCache 以 0.77 的准确率匹配 DS 和 SparQ,同时达到所有稀疏 baseline 中最高的注意力召回(0.888)
效率结果
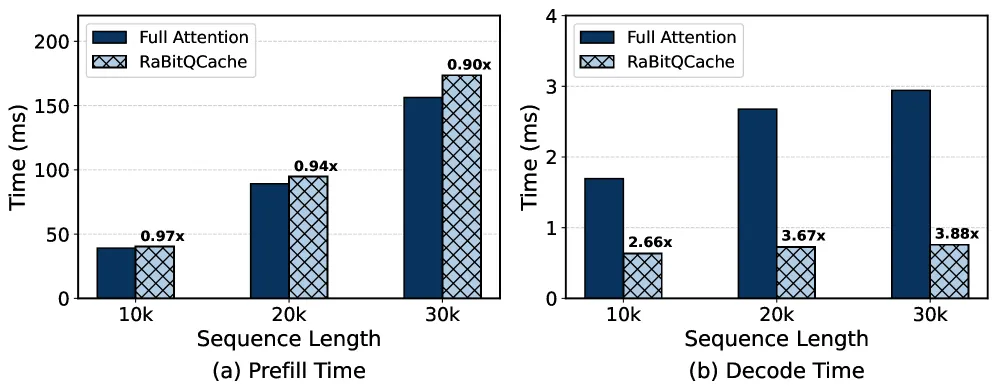
Prefill 延迟(TTFT):RaBitQCache 相比标准 FlashAttention 基线表现出可忽略的开销(小于 10%)。主要性能降级源于预填充是计算密集型任务,异步计算不可避免地影响主 CUDA stream 效率。这实证验证了异步流水线策略的有效性。
Decoding 延迟(TBT):在 10K–32K 变化的上下文长度上,RaBitQCache 相比 Full Attention 实现高达 3.88× 的加速。轻量级二进制索引扫描有效缓解了加载大规模 KV cache inherent 的内存 I/O 瓶颈,将推理延迟与上下文增长解耦。
端到端加速:RaBitQCache 相比全精度基线实现整体 2.16× 加速,证明将理论计算减少转化为实质性的 wall-clock 加速。
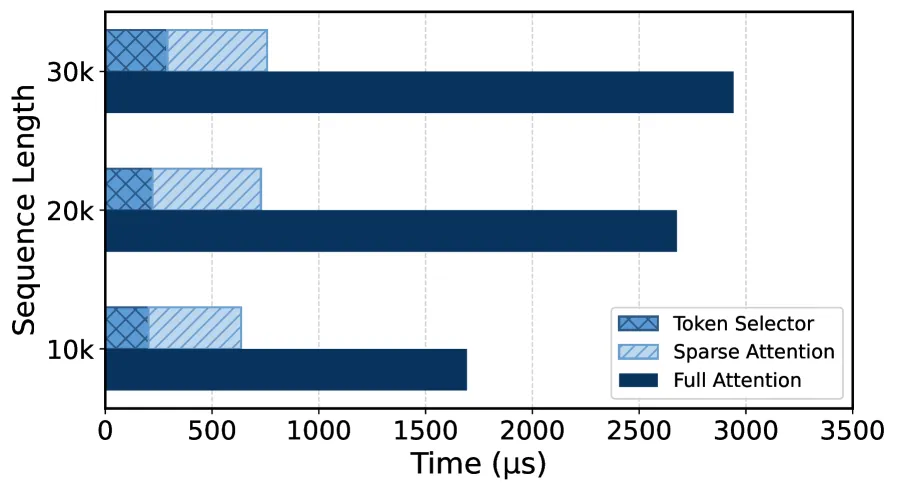
时间分解(Figure 5):Token Selector 的计算开销相对于 Full Attention 基线仅相当于约 10%。通过过滤无关 token,RaBitQCache 大幅减少了重型全精度注意力计算。
Top-p 阈值敏感性分析
Figure 4: 在 NarrativeQA 和 HotpotQA 上追踪 Generation Score、Retrieval Recall 和 Token Budget 随 p 从 0.65 到 0.95 的变化。观察到不同任务对 p 变化的响应趋势高度一致——这源于 p 代表累积概率质量,对任务特定变化不敏感。相比之下,静态预算 k 在不同任务间表现出显著分化。RaBitQCache 在访问不到 20% KV cache 的情况下实现与全注意力相当的性能。
质心重居中消融
RaBitQCache 使用 prefill 阶段质心 在量化前重新居中 query 和 key 向量,这是理论推导中假设单位超球面上近均匀分布所必需的。在 LLaMA-3.1-8B-Instruct 的 13 个 LongBench 任务上,移除重居中使平均分从 50.63 降至 50.25。虽然经验退化在测试 workload 上较温和,但重居中在理论上对于满足 误差界所需的单位超球面均匀性假设是必需的。
七、消融实验与可视化分析
无偏估计器有效性
RaBitQCache 的独特优势在于它是唯一支持自适应 Top-p 检索的方法,因为其他方法(MagicPIG, PyramidKV, SnapKV, PQCache)仅提供相对排名信息,仅能支持固定预算 Top-k 选择;KIVI 正交于检索——它直接压缩 KV cache。RaBitQCache 提供带有可证明误差界的注意力分数无偏估计。
自适应 vs 固定预算
固定 token 预算缺乏适应不同任务注意力模式的灵活性。RaBitQCache 的自适应检索自动调整预算而无需参数调优。在 RULER 基准上,RaBitQCache 在 8K 仅花费 1076 个 token,在 64K 自然扩展到 3581 个 token,直接展示了 Top-p 检索的任务自适应特性。
质心重居中必要性
移除质心重居中步骤导致性能轻微退化(50.63 → 50.25),验证了理论推导中对近均匀分布假设的依赖。尽管实际退化温和,但在存在显著 decode 阶段分布漂移的场景下,重居中对于维持误差界仍是必要的。
稀疏 attention baselines 局限性
| Baseline | 策略 | 局限性 |
|---|---|---|
| Quest | Page-level 重要性 | 一次性选择整个 page,token 重要性离散分布导致无关 token 过多 |
| DS | 部分维度估计 | 仅选择部分维度,易偏离真实分布 |
| SparQ | 固定比率 | 静态预算缺乏任务适应性 |
| MagicPIG | 相对排名 | 仅支持固定 Top-k |
| PyramidKV | 分层 eviction | 固定 capacity,无法自适应 |
| SnapKV | 注意力统计 | 仅支持固定 Top-k |
| PQCache | 量化压缩 | 正交于检索方法 |
| KIVI | KV 量化 | 直接压缩 KV cache,非检索方法 |
八、与相关工作对比
| 方法 | 稀疏时机 | 理论误差界 | 代理分数 | 检索策略 | 粒度 |
|---|---|---|---|---|---|
| RaBitQCache (Ours) | Native | 是 () | 无偏估计 | 自适应 Top-p | Token |
| Quest | Inference | 否 | Page-level 重要性 | 固定 Top-k (page) | Page |
| DS | Inference | 否 | 部分维度估计 | 固定 Top-k | Token (partial dim) |
| SparQ | Inference | 否 | 固定比率 | 固定 Ratio | Token |
| MagicPIG | Inference | 否 | 相对排名 | 固定 Top-k | Token |
| PyramidKV | Inference | 否 | 分层统计 | 固定 capacity | Token |
| SnapKV | Inference | 否 | 注意力统计 | 固定 Top-k | Token |
| PQCache | Inference | 否 | 量化压缩 | N/A | — |
| KIVI | Inference | 否 | KV 量化压缩 | N/A | — |
| Oracle | Inference | N/A | 真实注意力 | 最优 Top-k | Token |
RaBitQCache 与相近工作的两个区别轴:
- 基于 JL 引理的严格理论保证:唯一提供无偏估计器和可证明误差界的代理分数方法
- 自适应 Top-p 检索:唯一支持动态 token 预算调整的方法,无需针对不同任务手动调参
九、总结
核心贡献
- RaBitQCache 框架:minimal、theoretically-grounded 的稀疏注意力框架,基于 JL 引理构建无偏代理分数估计器,支持自适应 Top-p 检索
- 旋转二进制量化:通过随机正交旋转将高维 Key 向量压缩为 1-bit 二进制码本,配合 INT4 Query 量化实现高吞吐 binary-INT4 算术
- Kernel co-design:Int4DotBinary GEMV kernel(打包二进制 + 共享内存 tiling + 向量化位提取)+ 线性时间 Top-p 掩码算子,将理论计算减少转化为实际加速
- 系统级调度:异步预填充隐藏索引构建开销(<10%),惰性解码更新减少 kernel 启动开销
- 大规模验证:在 7B–70B 多模型尺度、LongBench/RULER/GSM8K 多基准上验证:RaBitQCache 以不到 20% KV cache 访问率实现与全注意力相当的性能,端到端加速 2.16×,解码加速最高 3.88×
局限性
- 质心漂移问题:使用 prefill 阶段质心假设 decode 阶段分布偏移可忽略,但在长序列或分布漂移显著的场景下可能失效。recent work 观察到 key/query 向量倾向于紧密聚类而非在单位超球面上均匀分布,可能在实际部署中 invalidate 均匀性假设
- INT4 量化精度权衡:虽然量化误差在 量级内,但对于超高维场景或极端精度要求的应用,INT4 可能不足以保留足够的信息
- 随机旋转矩阵存储: 正交矩阵需要存储在 GPU 显存中,在模型尺度极大时占用一定显存
- 仅验证 serving 场景:主要在 vLLM serving 系统上验证,training-time sparse attention 的适用性尚待探索
- 与 KIVI 等量化方法正交:RaBitQCache 专注于检索,未涉及对选中 token 的进一步压缩,与 KIVI 风格压缩的结合留作未来工作
未来方向
- 探索更严格的理论处理以应对实际部署中聚类分布和显著 decode 阶段分布漂移
- 将自适应 Top-p 检索与 KIVI 等 KV 压缩方法结合(先检索再压缩)
- 探索不同 INT4 量化位数(如 INT3/INT5)对误差界和精度的影响
- 扩展到更多样化的硬件拓扑和更长上下文场景
十、参考资源
- 论文: arXiv:2606.31519
- vLLM: Kwon et al., 2023
- FlashInfer: Ye et al., 2025
- FlashAttention-2: Dao, 2023
- Quest: Tang et al., 2024
- Double Sparse: Yang et al., 2024b
- SparQ: Ribar et al., 2024
- MagicPIG: Chen et al., 2025
- PyramidKV: Cai et al., 2024
- SnapKV: Li et al., 2024
- PQCache: Zhang et al., 2025
- KIVI: Liu et al., 2024
- LongBench: Bai et al., 2024
- RULER: Hsieh et al., 2024
- GSM8K: Cobbe et al., 2021
- Johnson-Lindenstrauss Lemma: Johnson & Lindenstrauss, 1984
- RaBitQ: Gao & Long, 2024
- LMCache: Liu et al., 2025b
附图索引
| 编号 | 文件名 | 说明 |
|---|---|---|
| Figure 1 | figure-7.png | RaBitQCache 系统级调度优化总览:异步预填充 + 惰性解码更新 |
| Figure 2 | figure-8.png | 推理延迟分析:prefill overhead < 10%,decoding 最高 3.88× 加速 |
| Figure 3 | figure-9.png | 端到端延迟对比:最大 2.16× 系统级加速 |
| Figure 4 | figure-4.png | Top-p 阈值敏感性分析:p 在不同任务上表现稳定 |
| Figure 5 | figure-5.png | RaBitQCache 时间分解:Token Selector 开销 negligible |
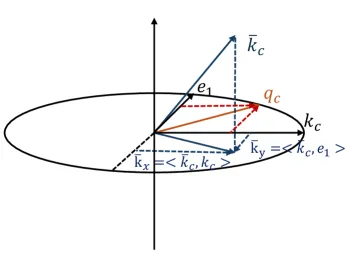
| Figure 6 | figure-6.png | qc, kc, e1 的几何关系示意图 |
附表格索引
| 编号 | 说明 |
|---|---|
| Table 1 | RaBitQCache 符号汇总表(20 个符号定义) |
| Table 2 | LongBench 主要结果:Full vs Oracle vs RaBitQ vs Quest vs DS vs SparQ |
| Table 3 | LLaMA-3.1-8B 上与其他稀疏注意力 baselines 的平均 LongBench 得分对比 |
| Table 4 | 跨模型规模(LLaMA-3.1-70B/8B)和基准(LongBench/RULER/GSM8K)的泛化能力 |
| Table 5 | Int4DotBinary 算子延迟 benchmark(不同 batch/tokens/heads/dim 配置) |
| Table 6–12 | Appendix 表格:完整 Longbench 结果、token 预算统计、per-task 结果、质心重居中消融等 |