PyTorch 2: Faster Machine Learning Through Dynamic Python Bytecode Transformation and Graph Compilation
PyTorch 2 introduces TorchDynamo and TorchInductor for JIT graph compilation in PyTorch while retaining eager mode flexibility
PyTorch 2: 通过动态Python字节码变换和图编译实现更快的机器学习
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | PyTorch 2: Faster Machine Learning Through Dynamic Python Bytecode Transformation and Graph Compilation |
| 作者 | Jason Ansel, Edward Yang, Horace He, Natalia Gimelshein, Animesh Jain, Michael Voznesensky, Bin Bao, Peter Bell, David Berard, Evgeni Burovski, Geeta Chauhan, Anjali Chourdia, Will Constable, Alban Desmaison, Zachary DeVito, Elias Ellison, Will Feng, Jiong Gong, Michael Gschwind, Brian Hirsh, Sherlock Huang, Kshiteej Kalambarkar, Laurent Kirsch, Michael Lazos, Mario Lezcano, Yanbo Liang, Jason Liang, Yinghai Lu, CK Luk, Bert Maher, Yunjie Pan, Christian Puhrsch, Matthias Reso, Mark Saroufim, Marcos Yukio Siraichi, Helen Suk, Michael Suo, Phil Tillet, Eikan Wang, Xiaodong Wang, William Wen, Shunting Zhang, Xu Zhao, Keren Zhou, Richard Zou, Ajit Mathews, Gregory Chanan, Peng Wu, Soumith Chintala |
| 机构 | Meta (多数), OpenAI, Intel, Quansight, 密歇根大学, 乔治梅森大学 |
| 论文 | https://docs.pytorch.org/assets/pytorch2-2.pdf |
| 发表 | ASPLOS ‘24, La Jolla, CA, April 27-May 1, 2024 |
| DOI | 10.1145/3620665.3640366 |
| 代码 | 已合入 PyTorch 主仓库 (torch/_dynamo, torch/_inductor) |
二、核心思想
本文介绍了 PyTorch 的两个重要扩展:TorchDynamo 和 TorchInductor,它们实现了在 PyTorch 2 中发布的 torch.compile 功能。这两个组件共同解决了 PyTorch 急切模式(eager mode)与编译器优化之间的根本矛盾。
问题定义
PyTorch 作为急切模式框架,其核心优势是灵活性和易用性——用户可以用纯 Python 编写模型并使用 print/pdb 等标准工具调试。但这也意味着框架每次只能看到一个算子的执行,无法跨算子边界应用图级优化(如算子融合、调度优化)。相比之下,图模式框架(TensorFlow、Theano)虽然能更好地优化,但牺牲了编程灵活性。
Prior 尝试(torch.jit.trace、torch.jit.script、torch.fx.symbolic_trace、Lazy Tensors)都存在不同程度的局限:要么是不完备的(unsound),要么要求用户重写代码,要么引入运行时开销。
解决方案概述
TorchDynamo 通过在 CPython 解释器层面动态修改 Python 字节码,在字节码执行前提取 PyTorch 操作序列到 FX 图中,实现了灵活的图捕获。TorchInductor 作为默认后端编译器,将 FX 图转换为 OpenAI Triton(GPU)或 C++/OpenMP(CPU)代码进行 JIT 编译。
三、技术架构
TorchDynamo 整体框架
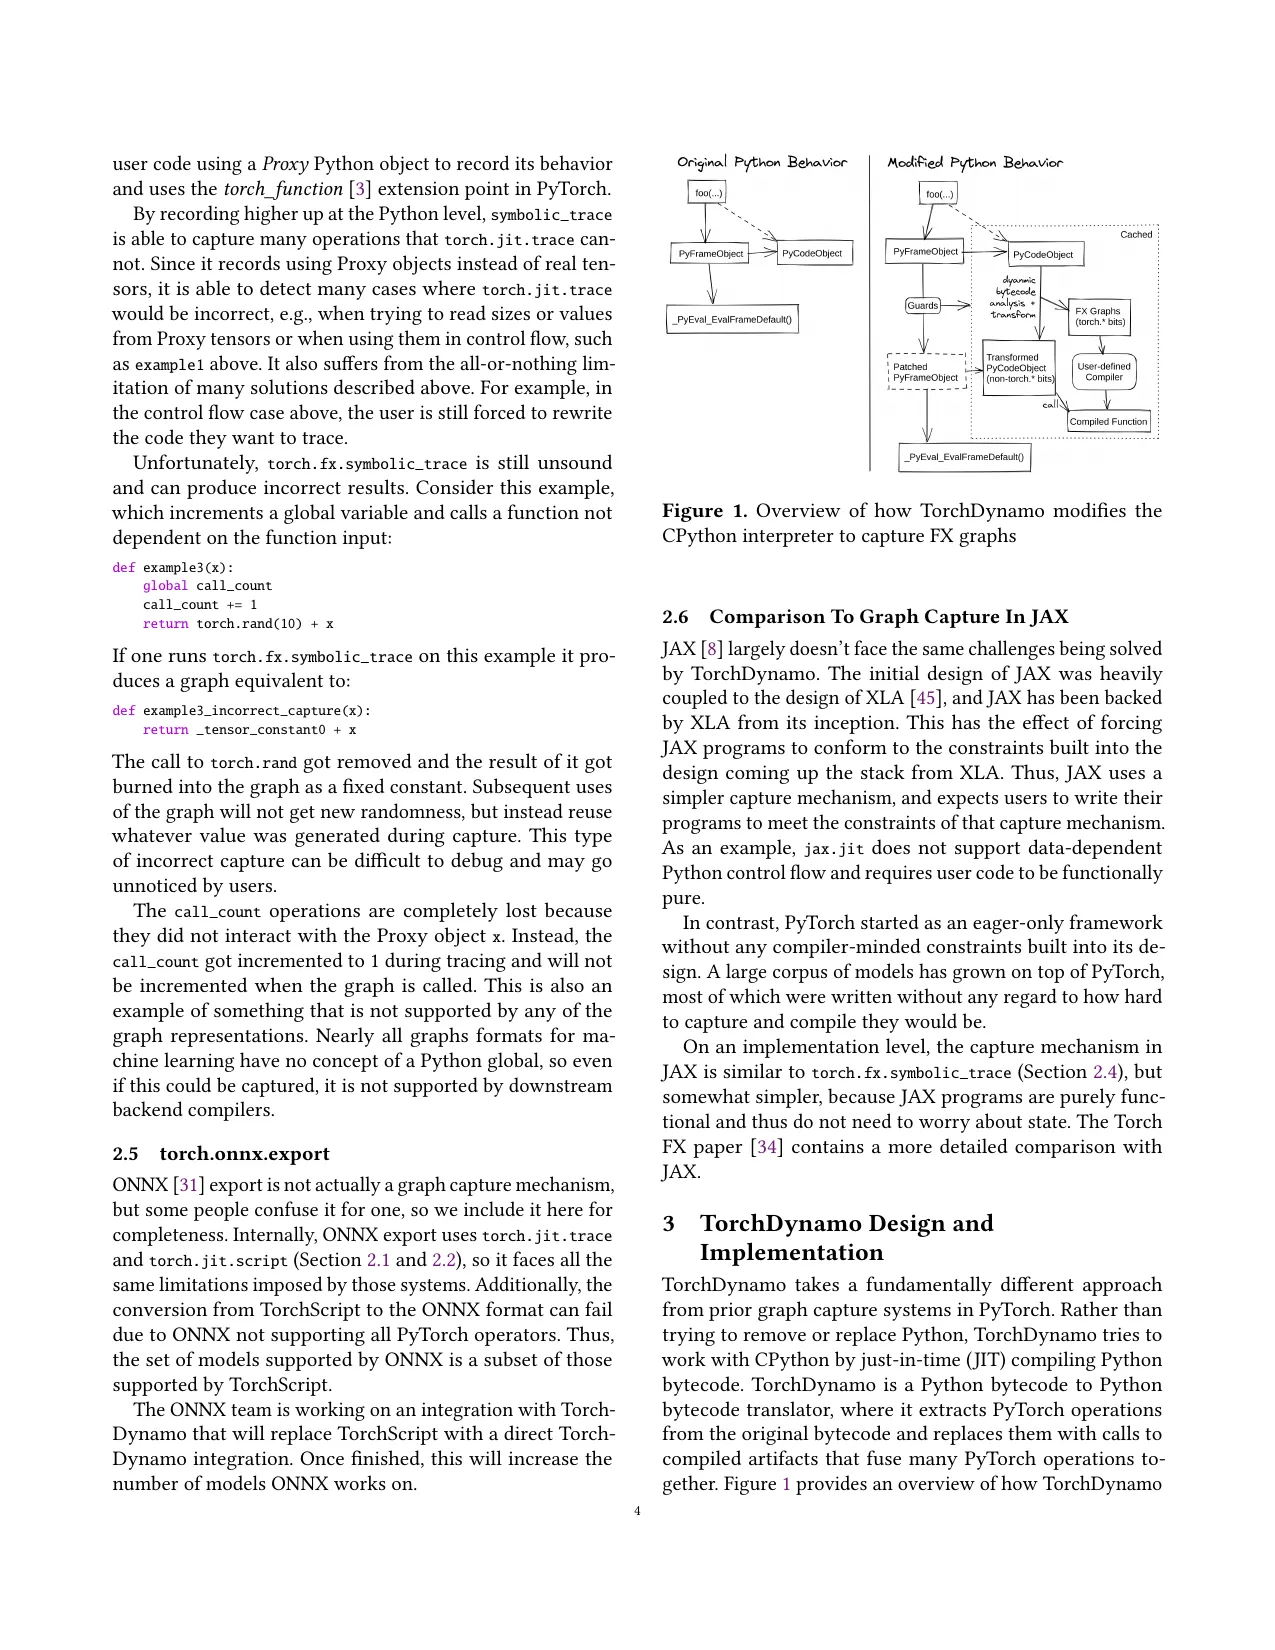
TorchDynamo 的核心机制是利用 PEP 523 引入的 frame evaluation API。它通过覆盖 CPython 的 eval_frame 函数指针,安装自定义的 frame evaluation hook,从而在字节码执行前对其进行即时编译。
工作流程:
- 检查跳过条件:根据文件名排除标准库、numpy 等不含 PyTorch 操作的模块
- 缓存查询:检查是否已有编译过的字节码缓存,如有则执行守卫函数(guard function)判断是否可复用
- 符号分析:逐指令分析函数字节码,提取 FX 图、生成守卫函数、追踪副作用
- 编译 FX 图:使用用户定义的编译器(默认为 TorchInductor)编译提取的 FX 图
- 生成守卫函数:编译检查所有守卫条件的 Python 函数
- 生成续体函数:如果分析未到达函数末尾,生成
resume_at_XX续体函数处理剩余字节码 - 生成新字节码:输出新字节码调用编译后的 FX 图、恢复局部变量/栈状态、执行副作用、返回或产生图断裂(graph break)
核心公式与技术细节
符号求值中的变量追踪(VariableTracker)
TorchDynamo 为每种 Python 数据类型定义了 VariableTracker 子类层次结构:
VariableTracker (基类)
├── TensorVariable          # torch.Tensor,存储 fx.Proxy 和 fake tensor
├── ListVariable            # list 类型
├── TupleVariable           # tuple 类型
├── ConstDictVariable       # 常量键值的字典
├── DataClassVariable       # 数据类
├── UserFunctionVariable    # 用户定义函数(支持内联)
├── UserMethodVariable      # 用户定义方法
├── UserDefinedClassVariable # 用户定义类
├── UserDefinedObjectVariable # 用户定义对象实例
└── ... (30+ 种守卫类型)
每个 VariableTracker 包含:
- guards 集合:初始化时创建,通过操作传播(union)
- 来源追踪:记录变量来源以便在输出字节码中加载或修改
守卫函数系统(Guards)
Guard 用于重新检查 JIT 编译中使用的动态属性,以确定是否可以复用已编译的代码。TorchDynamo 生成了 30 种不同类型的守卫:
# Guard 类型包括:
- torch.Tensor 属性 (dtype, device, size, stride, requires_grad, etc.)
- Python 类型检查
- 常量特化 (constant specialization)
- 属性访问
- dict/list/tuple 内容
- nn.Module 实例
- 全局 PyTorch 状态
守卫全部独立检查,除去重外互不交互。守卫系统和转换后的代码通过 _PyCode_SetExtra(PEP 523 引入的扩展点)存储。
图断裂与续体函数(Graph Breaks & Continuations)
当 TorchDynamo 遇到无法处理的字节码时,会产生图断裂:
def resume_at_X(...live_vars...):
    ... 恢复 try/except/栈状态 ...
    JUMP_ABSOLUTE X
    ... 原始函数字节码 ...
续体函数接收断裂处的活跃变量作为参数,恢复栈/异常状态后跳转回原函数中间位置继续执行。TorchDynamo 会递归地通过 frame evaluation API 分析续体函数。
突变与副作用处理
原始代码:  x = x + 1; some_dict['key'] = x; print(x)
           │              │              │
           ▼              ▼              ▼
延迟执行:  [FX graph 执行] → 批量应用副作用
           │
           ├─ STORE_GLOBAL: 生成 STORE_GLOBAL 字节码
           ├─ STORE_ATTR:   生成 STORE_ATTR 字节码
           ├─ 闭包突变:     特殊处理 cell 变量
           └─ dict/list 突变: 创建新对象匹配最终状态
TorchDynamo 将所有写操作推迟到 FX 图调用之后,然后生成输出字节码一次性应用所有副作用。这种方式将多次写入合并为单次写入。
AOTAutograd 前向/反向图分割
# AOTAutograd 工作流程:
1. 在 fake tensor 输入上运行 PyTorch eager mode autograd engine
2. 记录联合的前向+反向图
3. 使用最小割算法(min-cut)将联合图分离为独立的前向和反向图
4. 在最小割过程中应用后端特定的优化来重计算可低成本重计算的激活值
TorchInductor 编译器后端
TorchInductor 的设计原则:
- PyTorch Native:共享与 PyTorch eager mode 类似的抽象,通过薄翻译层支持所有 PyTorch 特性(exposed strides、aliasing views、in-place mutation)
- Python First:用 Python 实现,便于 PyTorch 用户理解和扩展
- Breadth First:专注于广泛算子支持而非特定模型优化
分解(Decompositions)
# log2 的分解示例:
log2_scale = 1 / math.log(2)

@register_decomposition(torch.ops.aten.log2)
def log2(x):
    return torch.log(x) * log2_scale
在写作时,TorchInductor 使用了 191 个分解(含重载共 387 个)。大多数分解不特定于 TorchInductor,可通过 torch._decomp 模块供其他后端使用。
定义-运行循环级 IR(Define-By-Run Loop-Level IR)
# TorchInductor IR 示例(对 2D tensor 的 log2):
def inner_fn_buf0(index):
    i0, i1 = index
    tmp0 = ops.load("arg0_1", i0 * s1 + i1)
    tmp1 = ops.log(tmp0)
    tmp2 = ops.constant(1.4426950408889634, torch.float32)
    tmp3 = ops.mul(tmp1, tmp2)
    return tmp3

buf0_ir = TensorBox(StorageBox(ComputedBuffer(
    name='buf0',
    layout=FixedLayout('cuda', torch.float32,
                       size=[s0, s1], stride=[s1, 1]),
    data=Pointwise(inner_fn=inner_fn_buf0,
                   ranges=[s0, s1], ...))))
IR 包含 54 个原始操作符:
ops.load/ops.store:从命名缓冲区读写,使用 SymPy 索引ops.reduction:隐式归约(argmin, argmax, any, max, min, prod, sum, xor_sum, welford_combine)ops.index_expr:SymPy 索引转计算值ops.indirect_indexing:动态索引ops.masked:条件执行ops.load_seed/ops.rand/ops.randn/ops.randint64:随机数- 其余为逐元素数学运算
调度与融合(Scheduling & Fusion)
# 融合控制的两项关键函数:
Scheduler.can_fuse(node1, node2)   # 检查两个节点能否融合
Scheduler.score_fusion(node1, node2) # 排序不同融合可能性

# 融合评分标准:
# 1) 融合类别(pointwise/reduction/template)
# 2) 融合节省的内存流量字节数
# 3) 原始图中节点间的距离
Triton 代码生成
# 生成的 Triton 代码(对应上图 log2 示例):
@pointwise(...)
@triton.jit
def kernel(in_ptr0, out_ptr0, xnumel, XBLOCK: tl.constexpr):
    xoffset = tl.program_id(0) * XBLOCK
    xindex = xoffset + tl.arange(0, XBLOCK)[:]
    xmask = xindex < xnumel
    x0 = xindex
    tmp0 = tl.load(in_ptr0 + x0, xmask)
    tmp1 = tl.log(tmp0)
    tmp2 = 1.4426950408889634
    tmp3 = tmp1 * tmp2
    tl.store(out_ptr0 + x0, tmp3, xmask)
归约内核有两种代码生成模式:
- 小型归约:持久归约,整个归约加载到单个 block,保留在寄存器/共享内存中
- 大型归约:生成循环,使用整个 block 作为累加器 + Triton 归约调用
矩阵乘和卷积使用 Jinja 模板系统,混合手写 Triton 和生成 Triton。
CPU 后端:C++/OpenMP
- 向量化变体:使用
at::vec::Vectorized类,每次处理 16 个元素,支持多种 SIMD 指令集 - 非向量化变体:使用标准 C++ STL 函数,通过
#pragma omp for并行化 - 归约映射到 OpenMP reduction 注解或 C++ 累加器循环
动态形状支持(Dynamic Shapes)
# 动态形状示例程序:
def f(x, y):
    z = torch.cat([x, y])
    if z.size(0) > 2:
        return z.mul(2)
    return z.add(2)
关键技术:
- 元函数(Meta Functions):在不实际执行节点的情况下传播张量的大小信息。写作时覆盖了 2657/3028 个 PyTorch ops
- 0/1 特化:如果输入大小为 0 或 1,不分配符号变量而是视为常量
- 无提示(Unbacked)符号整数:从
.nonzero()或.item()等数据依赖操作中产生的大小变量 - 增量简化:随着从守卫中学习更多事实,增量简化符号表达式
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Python 字节码级 JIT 编译 | 通过 PEP 523 frame evaluation API 动态修改字节码,而非替换 Python | 比 TorchScript 在 TorchBench 上覆盖多 2 倍以上的模型 |
| 部分图捕获(Partial Graph Capture) | 允许混合编译片段与 Python 执行,优雅处理图断裂 | TorchBench 70% 模型 0 次断裂,89% HF 模型 0 次断裂 |
| 符号求值与变量追踪 | 逐指令分析字节码,维护完整的符号状态(栈、局部变量、副作用) | 支持闭包、突变、控制流展开等复杂 Python 语义 |
| 定义-运行循环级 IR | 用可执行的 Python 代码定义循环体,保留 Python 的全部表达能力 | 降低新算子 lower 的样板代码量 |
| 动态形状零注解支持 | 默认假设所有输入可能动态变化,权重静态,通过分析推断真实动态性 | 减少编译时间,避免为每个形状组合重新编译 |
| 统一 GPU/CPU 后端 | 同一前端同时支持 Triton(GPU)和 C++/OpenMP(CPU) | 覆盖两种硬件平台,无需额外配置 |
五、实验结果
TorchDynamo 图捕获能力
| 指标 | TorchBench | HuggingFace | TIMM |
|---|---|---|---|
| 模型总数 | 80 | 46 | 62 |
| TorchDynamo 兼容 | 74 (93%) | 46 (100%) | 62 (100%) |
| TorchScript 兼容 | 36 (45%) | 0 (0%) | 61 (98%) |
| 平均算子数/图 | 252.8 | 612.6 | 450.7 |
| 平均图数/模型 | 21.1 | 7.7 | 1 |
| 0 次断裂的模型 | 52 (70%) | 41 (89%) | 62 (100%) |
| 1-9 次断裂 | 6 (8%) | 1 (2%) | 0 (0%) |
| 10+ 次断裂 | 16 (22%) | 4 (9%) | 0 (0%) |
关键发现:TorchScript 在 HuggingFace 上完全失败(0%),因为 HF 模型返回 ModelOutput 容器类,TorchScript 不支持。而 TorchDynamo 支持 100% 的 HF 模型。
图捕获开销
| 系统 | TorchBench 开销 |
|---|---|
| TorchDynamo | 5% |
| Lazy Tensors | 38% |
| Lazy Tensors + 跨迭代流水线 | 31% |
TorchDynamo 的捕获开销显著低于 Lazy Tensors(5% vs 38%)。
TorchInductor 加速效果
GPU A100 Inference (float32) - 几何平均加速比:
| 后端 | TorchBench | HuggingFace | TIMM |
|---|---|---|---|
| TorchInductor | 2.73× | 1.47× | 2.48× |
| nvFuser | 1.23× | 1.09× | 1.16× |
| NNC | 1.12× | 0.98× | 1.02× |
| PyTorch/XLA | 0.80× | 1.03× | 1.24× |
| ONNXRT | 0.86× | 0.84× | 0.92× |
| TVM | 0.16× | 0.09× | 0.13× |
| Hidet | 0.54× | N/A | 0.30× |
GPU A100 Inference (float16):
- TorchInductor: TorchBench 2.59×, HuggingFace 1.91×, TIMM 2.77×
GPU A100 Training (float32):
- TorchInductor: TorchBench 1.38×, HuggingFace 1.24×
CPU Inference (float32):
- TorchInductor: TorchBench 1.39×, HuggingFace 2.54×, TIMM 2.55×
总体几何平均:TorchInductor 在 A100 GPU 上提供 2.27× 推理 和 1.41× 训练 加速,超越六种其他编译器。
消融实验(Ablation Study)
移除各优化对 HuggingFace float16 推理的影响:
| 移除的优化 | 推理加速 | 训练加速 |
|---|---|---|
| 全部优化 | 1.91× | 1.45× |
| 无循环/布局重排 | 1.91× (-0.00) | 1.28× (-0.17) |
| 无 matmul 模板 | 1.85× (-0.06) | 1.41× (-0.04) |
| 无参数冻结 | 1.85× (-0.06) | 1.45× (-0.00) |
| 无模式匹配 | 1.83× (-0.08) | 1.45× (-0.00) |
| 无 CUDA Graph | 1.81× (-0.10) | 1.37× (-0.08) |
| 无融合 | 1.68× (-0.23) | 1.27× (-0.18) |
| 无内联 | 1.58× (-0.33) | 1.31× (-0.14) |
| 无融合+无内联 | 0.80× (-1.11) | 0.59× (-0.86) |
关键发现:融合和内联是最主要的加速来源。两者同时移除后,TorchInductor 反而产生 0.80× 减速(即变慢),因为分解增加了算子数量但没有融合来抵消内存带宽瓶颈。
五、相关工作对比
| 系统 | 图捕获方式 | 是否 sound | 运行时开销 | 训练支持 |
|---|---|---|---|---|
| torch.jit.trace | 记录/回放(dispatcher 级) | 否 | 低 | 是 |
| torch.jit.script | AST 解析 + 静态分析 | 是 | 低 | 是 |
| torch.fx.symbolic_trace | Python 级 Proxy 记录 | 否 | 低 | 是 |
| Lazy Tensors (PyTorch/XLA) | C++ 级图累积 | 是 | 高 (38%) | 是 |
| TorchDynamo | 字节码动态变换 | 是 | 低 (5%) | 是 |
| JAX jax.jit | 函数式纯代码 | 是 | 低 | 是 |
七、总结
核心贡献
- TorchDynamo:首个在 PyTorch 中实现 sound、低开销(5%)、部分图捕获的 Python 级 JIT 编译器,通过 PEP 523 frame evaluation API 动态修改字节码
- TorchInductor:通用编译器后端,支持 GPU(Triton)和 CPU(C++/OpenMP),提供 2.27× 推理和 1.41× 训练的几何平均加速
- 动态形状零注解支持:无需用户标注即可支持动态输入尺寸,通过元函数和 0/1 特化等策略高效管理符号形状推理
- 完整的副作用和突变处理:支持闭包、全局变量、dict/list 突变、类构造等复杂 Python 语义
- 大规模实验验证:在 180+ 真实世界模型上验证,覆盖 TorchBench、HuggingFace、TIMM 三大基准套件
局限性
- 图断裂仍是性能瓶颈,特别是对于包含 numpy 调用、Python 类型转换和数据依赖控制流的模型
- TVM、Hidet 等推理专用编译器在部分模型上支持率较低(缺失算子实现)
- 某些 PyTorch 模式(如
torch.any(torch.isnan(x))或loss.item())会迫使 Lazy Tensors 刷新流水线,但对 TorchDynamo 影响较小
技术影响
TorchDynamo 和 TorchInductor 为急切模式框架引入了实用的编译器优化通道,使 PyTorch 用户无需修改代码即可获得显著的性能提升。这一设计为后续各种后端(nvFuser、XLA、ONNX Runtime 等)提供了统一的图捕获前端。
八、参考资源
- PyTorch 源码: https://github.com/pytorch/pytorch/
- TorchDynamo 代码:
torch/_dynamo目录 - TorchInductor 代码:
torch/_inductor目录 - Benchmark 代码: https://github.com/pytorch/pytorch/tree/main/benchmarks/dynamo
- TorchInductor 性能仪表盘: https://hud.pytorch.org/benchmark/compilers
- Triton: https://github.com/openai/triton
- PEP 523 (Frame Evaluation API): https://peps.python.org/pep-0523/