PagedWeight: Efficient MoE LLM Serving with Dynamic Quality-Aware Weight Quantization
A runtime memory-management system for MoE LLM serving that dynamically quantizes expert weights at runtime to balance GPU memory between model weights and KV cache, using a quality-aware planner with offline sensitivity, online routing statistics, and prompt residuals.
PagedWeight: Efficient MoE LLM Serving with Dynamic Quality-Aware Weight Quantization
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | PagedWeight: Efficient MoE LLM Serving with Dynamic Quality-Aware Weight Quantization |
| 作者 | Yuchen Yang, Xuying Han, Anisha Dasgupta, Sasa Misailovic |
| 机构 | University of Illinois Urbana-Champaign |
| 论文 | https://arxiv.org/abs/2607.16184 |
| 代码 | 未提供 |
| 发布 | 23 Jul 2026 |
| 许可 | 未明确 |
二、核心思想
问题定义
MoE(混合专家)模型通过只激活部分专家来降低计算量,但总参数量巨大——MoE 权重可占 GPU 内存的 60% 以上。在 LLM 推理服务中,GPU 内存需要同时存储模型权重和 KV 缓存。KV 缓存随上下文长度增长,而静态量化无法动态平衡权重与 KV 缓存之间的内存分配。
现有方法局限:
- 静态量化:部署前固定精度,无法适应推理时的 KV 缓存压力变化
- 运行时精度自适应:已有方法(如 APL、DP-LLM)允许推理时改变精度,但不用于重新分配 GPU 内存
- MxMoE:使用”fake”量化模拟低精度,实际仍存储高精度张量,内存开销大
解决方案概述
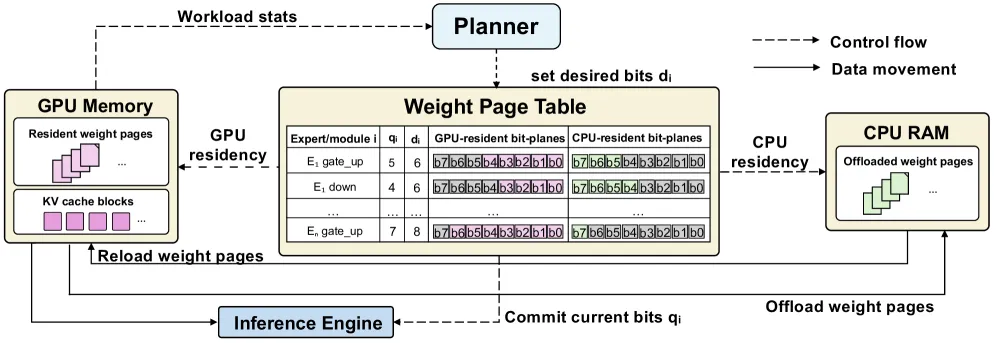
PagedWeight 提出将 MoE 权重视为可分页对象,类似于 PagedAttention 对 KV 缓存的分页管理:
- 将 Any-Precision (AP) bit-plane 和 LUT buffer 作为 GPU resident pages
- 根据当前 KV 缓存压力,动态调整专家权重的 committed bitwidth
- 使用质量感知规划器选择损伤最小的量化动作
- 异步页面移动隐藏 offload/reload 延迟
在三个 MoE 模型(Qwen1.5-MoE-A2.7B、Mixtral-8×7B、Gemma-4-26B-A4B)上,PagedWeight 实现了 FP16 等效精度 + 72% GPU 内存节省 + 1.94× 吞吐提升。
三、技术架构
整体框架
┌─────────────────────────────────────────────────────┐
│                  PagedWeight Runtime                 │
│                                                      │
│  ┌──────────────────┐    ┌──────────────────────┐   │
│  │ Quality-Aware    │    │ Asynchronous Page    │   │
│  │ Runtime Planner  │───▶│ Movement Pipeline    │   │
│  │                  │    │                      │   │
│  │ • Offline Sens.  │    │ Offload: lower q_i   │   │
│  │ • Routing Stats  │    │   → copy to CPU      │   │
│  │ • Prompt Resid.  │    │ Reload: copy to GPU  │   │
│  └──────────────────┘    │   → commit higher q_i│   │
│         │                └──────────────────────┘   │
│         ▼                              ▼            │
│  ┌──────────────────────────────────────────────┐   │
│  │  Fused Mixed-Precision MoE Kernel            │   │
│  │  (reads AP bit-planes + LUTs directly)       │   │
│  └──────────────────────────────────────────────┘   │
└─────────────────────────────────────────────────────┘
核心公式
专家路由质量(公式 1):
其中 是路由权重, 是选中的专家。如图 2 所示,不同专家的路由质量差异显著。
Hessian 敏感度(公式 2):
其中 是 Hessian 导出的重要性分数, 是 -bit 量化版本。
释放内存(公式 3):
其中 包含 AP bit-plane 和 LUT 的总内存。
全局损伤(公式 4):
Prompt 残差预测(公式 5):
其中 是三维路由输入特征向量:路由加权均值输入范数、路由加权 RMS 输入范数、最大输入范数。
Prompt 调整因子(公式 6):
KV 缓存压力(公式 7):
其中 是空闲 block 阈值, 是当前空闲 block 数, 是每个 KV block 的字节数。
预测损伤(公式 8):
其中 是路由桶的损伤乘数。
权重页面表
每个 linear-block 在页面表中占一行:
| 字段 | 说明 |
|---|---|
| 支持的 bitwidth 集合 | |
| 当前 committed bitwidth(推理中使用) | |
| 期望 bitwidth(规划器选择) | |
| LUT state | 每个 bit-plane 的状态(GPU/CPU/transferring) |
| 每精度的 GPU 内存大小表 |
质量感知规划器(Algorithm 1)
PlanStep(𝒯_t, 𝒪_t, Ω_off, Q_t):
  D_t ← TargetBytesFromKVPressure(𝒪_t)     // 计算目标释放字节
  for each s ∈ BitwidthFloorStages(Ω_off) do
    ℛ_s ← ScoreActions(𝒯_t, 𝒪_t, Ω_off, s) // 评分所有候选动作
    Π_s ← GreedySelect(ℛ_s, D_t)           // 贪心选择最低损伤动作
    Q_{t+1} ← RefreshPlanQueue(Q_{t+1}, Π_s) // 更新计划队列
  end for
  if PressureTriggered(𝒪_t) then
    Π_t ← SelectBestPlan(Q_{t+1}, D_t)     // 选择最佳计划执行
  end if
  return (Q_{t+1}, Π_t)
规划器按 (每释放字节的预测损伤)排序,贪心选择最便宜的步骤直到满足目标 。
异步页面移动
- Offload:先降低 committed bitwidth → 将不需要的 pages 从 GPU 移到 CPU → 释放 allocator headroom 供 KV blocks 使用
- Reload:先将 pages 从 CPU 移回 GPU → 确认 page state 为 GPU-resident → 再提高
融合 Mixed-Precision MoE Kernel
单一 fused CUDA kernel 完成 routing、expert activation、down projection 和 output accumulation,直接读取 AP bit-planes 和 LUTs,支持 per-linear-block 不同 bitwidth。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| Weight Page Table | 首次将 MoE 权重视为可分页对象,类比 PagedAttention | §3.1, Fig. 3 |
| 三元质量估计 | 离线敏感度 + 在线路由统计 + prompt 残差联合估计量化损伤 | §3.2, Eq. 4-8 |
| Routing-aware 保护 | 按路由质量将专家分桶,热专家获得更高 bitwidth floor 和损伤乘数 | §3.2, Fig. 2 |
| Prompt residual | 针对当前输入的线性回归校正,捕获同一量化对不同 prompt 的差异化影响 | Eq. 5-6 |
| 异步页面移动 | offload/reload 与服务重叠,commit 仅在安全边界进行 | §3.3, Fig. 4 |
| 融合 mixed-precision kernel | 单一 CUDA kernel 支持 per-block 不同精度 | §3.3 |
五、代码实现分析
实现栈:PyTorch + vLLM v0.20.1 + 自定义 fused CUDA kernel
关键实现组件:
- Any-Precision (AP) bit-plane 格式存储多精度权重
- 融合 mixed-precision MoE CUDA kernel:routing → expert activation → down projection → output accumulation 单 kernel
- 异步页面移动 pipeline:planner 持续准备计划,达到 threshold 后执行
- Weight page table:每 linear-block 一行,记录 , , page states,
校准流程:
- 在 C4 校准集上计算每 linear-block 的 Hessian 敏感度表
- 训练 prompt residual 线性回归 head(每个 bitwidth transition 一个 head)
- 搜索路由桶、桶乘数、depth caps 等超参数
六、实验结果
基准测试
评估模型:
| 模型 | 参数 | Experts | Top-K |
|---|---|---|---|
| Qwen1.5-MoE-A2.7B | 14.3B / 26.7GB | 60+4 shared | 4 |
| Mixtral-8×7B-v0.1 | 46.7B / 92.9GB | 8 | 2 |
| Gemma-4-26B-A4B | 25.2B / 53.1GB | 128+1 shared | 8 |
数据集:Wikitext2, C4(perplexity);GSM8K, MATH-500(reasoning);LongBench(Passage Retrieval, NarrativeQA, QMSum)
基线:FP16, APL(uniform quantization), MxMoE(static MPQ), DP-LLM(dynamic MPQ)
Figure 5 — 质量-内存权衡:
- PagedWeight 在所有三个模型和四个任务上始终优于所有基线
- 在 Wikitext2/C4 上,PagedWeight 以更低的内存消耗达到接近 FP16 的质量
- Qwen1.5-MoE-A2.7B 上:16 GB 达到 near-FP16 质量(APL 需要更多内存)
- Mixtral-8×7B 上:35 GB 达到 near-FP16 质量
- Gemma-4-26B 上:22 GB 达到 near-FP16 质量
Table 2 — 长上下文质量(LongBench):
| 方法 | 内存 (GB) | Passage Retrieval | NarrativeQA | QMSum | Average |
|---|---|---|---|---|---|
| FP16 | 35.25 | 15.5% | 11.9% | 23.5% | 17.0% |
| APL-6bit | 14.97 | 15.5% | 12.0% | 23.5% | 17.0% |
| APL-5bit | 12.92 | 13.0% | 9.7% | 23.4% | 15.4% |
| APL-3bit | 9.40 | 10.5% | 4.9% | 21.1% | 12.2% |
| PW-10GB | 9.86 | 17.5% | 10.0% | 23.6% | 17.0% |
| PW-13GB | 12.79 | 15.0% | 11.2% | 23.4% | 16.5% |
关键发现:10 GB 预算下 PagedWeight 达到与 FP16 (35.25 GB) 相同的 17.0% 平均分,而 APL 在 9.4 GB 仅达 12.2%。
吞吐量(Table 3,Qwen1.5-MoE-A2.7B,seq_len=2048)
| 方法 | B=1 Mem.(GB) | B=1 TPS | B=4 Mem.(GB) | B=4 TPS |
|---|---|---|---|---|
| FP16 | 27.04 | 67.1 | 28.17 | 258.0 |
| APL (3.25-bit) | 7.63 | 134.5 | 8.75 | 429.9 |
| APL (4.5-bit) | 9.29 | 123.5 | 10.41 | 413.8 |
| APL (6-bit) | 13.44 | 123.1 | 14.56 | 401.9 |
| PagedWeight | 7.63 | 130.1 | 8.73 | 419.4 |
| PagedWeight | 13.34 | 120.1 | 14.55 | 385.4 |
PagedWeight 以相似/更低内存匹配 uniform APL 的吞吐量,最大吞吐下降仅 3.3% (B=1) 和 4.1% (B=4)。
消融实验(Table 4)
| 配置 | Wikitext2 PPL | C4 PPL |
|---|---|---|
| PagedWeight (full) | 7.22 | 10.06 |
| w/o routing statistics | 7.26 | 10.13 |
| w/o prompt residual | 7.31 | 10.19 |
| w/o page movement | 7.43 | 10.33 |
| w/o global sensitivity | 7.46 | 10.40 |
各组件贡献:prompt residual 贡献最大(7.22→7.31),其次是 page movement(7.31→7.43)。
七、相关工作
| 工作 | 方法 | 局限 |
|---|---|---|
| PagedAttention (vLLM) | KV cache 分页管理 | 不管理权重内存 |
| APL | Any-Precision uniform quantization | 静态精度策略 |
| DP-LLM | Dynamic precision adaptation | 需保持高精度张量,实际内存大 |
| MxMoE | Static mixed-precision | fake quantization,实际内存远超理论 |
| DPQ (Chu et al.) | Dynamic expert quantization | 非 runtime 动态 |
| PagedWeight (本文) | Runtime weight paging + quality-aware planning | 动态平衡 weight/KV 内存 |
八、总结
核心贡献
- PagedWeight 系统:首次将 MoE 权重视为可分页对象,动态调整 committed bitwidth 平衡权重与 KV 缓存内存
- 质量感知运行时规划器:结合离线 Hessian 敏感度、在线路由统计和 prompt 残差的三元估计
- 异步页面移动:隐藏 offload/reload 延迟,commit 仅在安全边界进行
- 融合 mixed-precision MoE kernel:支持 per-block 不同精度的单一 CUDA kernel
- 全面实验验证:三个 MoE 模型上 consistently 优于 APL、DP-LLM、MxMoE,FP16 等效精度 + 72% 内存节省 + 1.94× 吞吐
技术影响
将 MoE 推理服务的内存管理从静态量化推向动态权衡,开辟了任务精度、计算时间和 GPU 内存分配之间新的优化空间。
局限性
- 当前仅评估了特定量化格式和敏感度指标
- 未评估极端长上下文(>32K)下的效果
- 未来需要扩展到更多量化格式和 prompt-wise 敏感性估计方法