Orchestrated Scheduling and Prefetching for GPGPUs
A prefetch-aware (PA) warp scheduling policy that coordinates thread scheduling and data prefetching in GPGPUs to better tolerate long memory latencies
Orchestrated Scheduling and Prefetching for GPGPUs
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Orchestrated Scheduling and Prefetching for GPGPUs |
| 作者 | Adwait Jog, Onur Kayiran, Asit K. Mishra, Mahmut T. Kandemir (Penn State), Onur Mutlu (CMU), Ravishankar Iyer (Intel Labs), Chita R. Das (Penn State) |
| 机构 | The Pennsylvania State University, Carnegie Mellon University, Intel Labs |
| 论文 | https://users.ece.cmu.edu/~omutlu/pub/orchestrated-gpgpu-scheduling-prefetching_isca13.pdf |
| 代码 | 未公开 |
| 发布 | ISCA 2013 |
| 许可 | - |
二、核心思想
问题定义
GPGPU 的内存子系统性能是决定整体性能的关键因素。随着 GPU 集成更多计算资源,内存带宽和延迟成为主要瓶颈。传统上,GPGPU 通过并发执行大量线程来容忍长内存延迟,但现有的 warp 调度策略无法有效利用数据预取(data prefetching)来进一步隐藏延迟。
核心问题:为什么在 GPGPU 中加入预取器并不能显著提升性能?
原因在于现有调度策略(Round-Robin 和 Two-Level)都将相邻 warp 安排在连续周期执行。相邻 warp 访问相近的缓存块,具有高度的空间局部性。当一个 warp 触发预取请求时,下一个 warp 几乎立即被调度并产生对该缓存块的需求请求——在预取数据到达之前。因此,预取虽然准确但为时已晚(too late to help)。
解决方案概述
提出 Prefetch-Aware (PA) Warp Scheduling 策略,核心思想是在时间上分离相邻 warp 的调度,使它们不连续执行。这样,当一个 warp 产生预取请求时,相邻 warp 不会被立即调度,而是先执行其他不相关 warp,给预取器足够时间完成数据传输。
PA 调度器基于 Two-Level 调度器改进,关键区别在于 fetch group 的分组方式:不是将相邻 warp 放在同一组,而是将不相邻 warp 放在同一组。
三、技术架构
GPGPU 基线架构
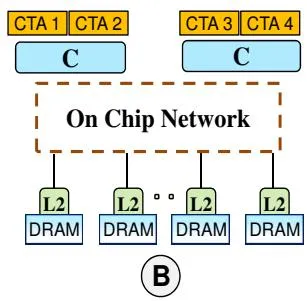
基线架构包含多个 SM 核心,每个核心具有 SIMT 宽度 8,私有 L1 数据/纹理/常量缓存,共享内存,通过交叉连接网络连接到 8 个内存通道(MC)。每个 MC 关联共享 L2 缓存。
PA 调度器 vs 现有调度器对比
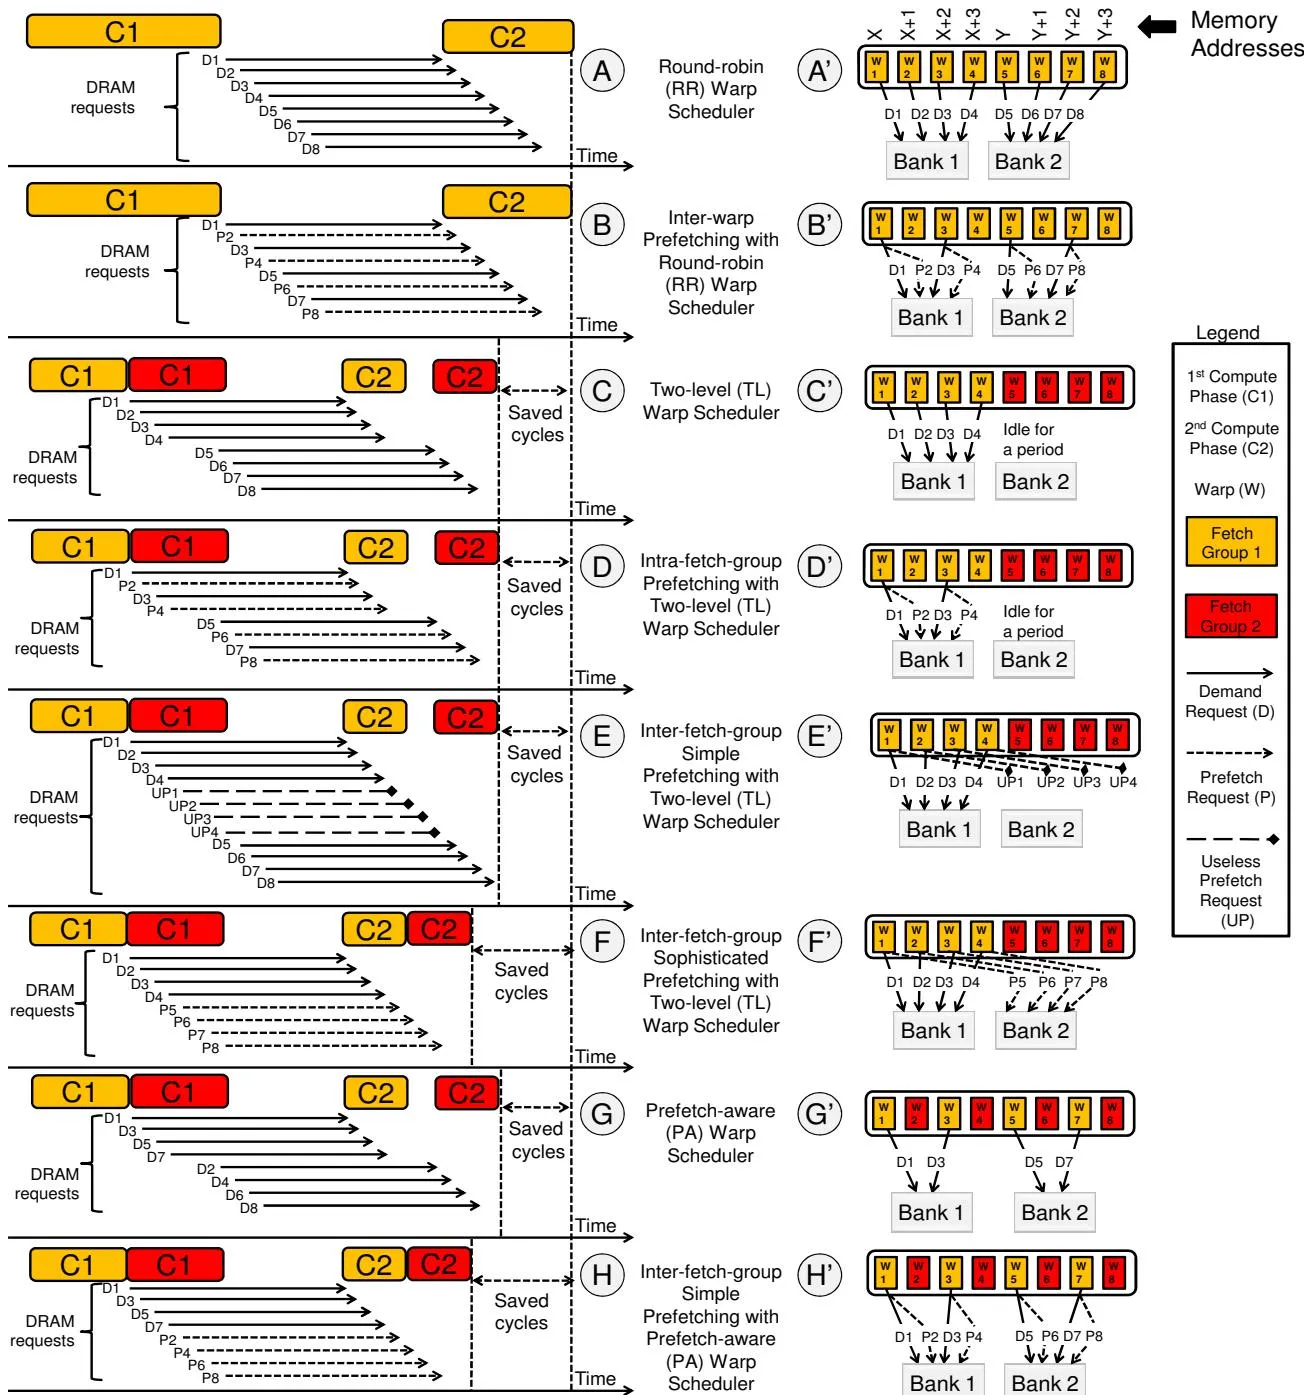
图中展示了 8 种调度+预取组合的执行时间线和 DRAM 行为:
- (A/A’) RR 调度 + 无预取:所有 warp 同时产生内存请求,同时 stall
- (B/B’) RR 调度 + 预取:预取太早,相邻 warp 立即需求数据,预取无效
- (C/C’) TL 调度 + 无预取:两个 fetch group 交替执行,部分重叠内存延迟与计算
- (D/D’) TL 调度 + 组内预取:同 (B),预取仍然太早
- (E/E’) TL 调度 + 简单组间预取:预取不准确,浪费带宽
- (F/F’) TL 调度 + 复杂组间预取:预取准确但难以设计
- (G/G’) PA 调度 + 无预取:非相邻 warp 同组,提高 BLP 但降低 RBL
- (H/H’) PA 调度 + 预取:相邻 warp 在不同组,预取及时且准确,同时利用 RBL 和 BLP
核心算法:Fetch Group 分组
Algorithm 1: Fetch group formation in the PA scheduler
输入: n_warp (核心上并发 warp 数量), g_size (每组 warp 数量)
输出: g_num[i] = warp i 所属的 fetch group 编号

n_grp = n_warp / g_size
n_cons_warps = floor(g_size / n_grp)

for i = 0 → n_warp - 1 do
    g_num[i] = floor((i mod g_size) / n_cons_warps)
end for分组示例(32 warps,group_size=8,n_grp=4):
- G0: W0, W8, W16, W24, W1, W9, W17, W25
- G1: W2, W10, W18, W26, W3, W11, W19, W27
- G2: W4, W12, W20, W28, W5, W13, W21, W29
- G3: W6, W14, W22, W30, W7, W15, W23, W31
关键性质:相邻 warp(如 W0 和 W1)最多只有 n_cons_warps = floor(8/4) = 2 个在同一组。大多数相邻 warp 被分配到不同组,确保它们在时间上被分隔。
空间局部性检测预取器(SLD-based Prefetcher)
宏块定义:512 字节 = 4 个连续缓存块为一组(macro-block)
SLD 表:每核 64 项全相联表,每项记录:
- 宏块地址
- 位向量(bit vector)标记哪些缓存块已被访问过
预取触发条件:当宏块中至少有 C=2 个缓存块被访问后,预取器为该宏块中剩余的未访问缓存块发出预取请求。
空间局部性分布分析(图4):
- TL 调度器:平均 36% 的内存请求访问宏块的所有缓存块(高空间局部性)
- PA 调度器:该比例降至 17%(因为非相邻 warp 同组,空间局部性降低)
- 但 PA + 预取可以恢复行缓冲区局部性
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首次协调调度与预取 | 证明 warp 调度策略与预取器的交互是 GPGPU 内存延迟隐藏的关键 | 图1-3 系统分析各种组合 |
| PA 调度分组算法 | 将不相邻 warp 分到同一 fetch group,分离相邻 warp 调度时间 | Algorithm 1,数学分组公式 |
| SLD 预取器 | 基于空间局部性检测的保守预取器,预取度=2,距离小 | 4.2 节详细分析 |
| BLP vs RBL 权衡分析 | 首次系统分析 GPGPU 中行缓冲区局部性与银行级并行性的权衡 | 图7-9 实验对比 |
五、实验结果
基准测试平台
模拟器:修改版 GPGPU-Sim 2.1.2b,30 核平台
硬件配置(表1):
- 1300MHz,SIMT 宽度=8,每核 32KB L1,128B 缓存行
- 8 个 GDDR3 MC,每 MC 8 DRAM bank,FR-FCFS 调度
- 时序:tCL=10, tRP=10, tRC=35, tRAS=25, tRCD=12, tRRD=8
评估应用(10 个 CUDA 应用,表2): MapReduce (SSC, PVC), Rodinia (KMN, BFSR), Parboil (SPMV, FFT), CUDA SDK (SCP, BLK, FWT), JPEG
五种调度+预取组合的 IPC 对比
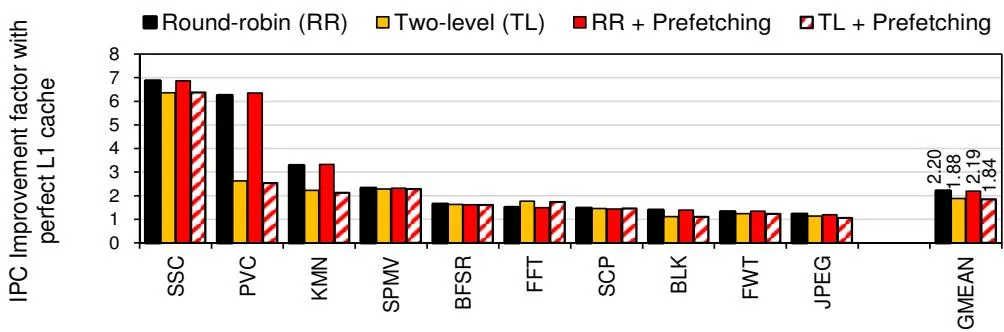
核心结果:
- PA + Prefetch 相比 RR+Prefetch 提升 25%(平均 IPC)
- PA + Prefetch 相比 TL+Prefetch 提升 7%
- PA(无预取) 相比 RR(无预取)提升 20%
- PA(无预取) 相比 TL(无预取)提升 4%
- PA+Prefetch 达到完美 L1 缓存性能的 ~57%(1/1.74)
预取准确性与时序分析
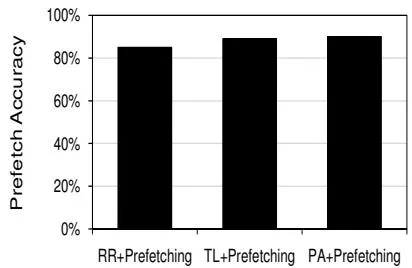
| 指标 | RR+Prefetch | TL+Prefetch | PA+Prefetch |
|---|---|---|---|
| 预取准确率 | 85% | 89% | 90% |
| 迟到预取比例 | 89% | 85% | 69% |
| L1 命中率提升 | 2% | 4% | 10% |
关键发现:PA 调度器显著改善了预取的及时性(timeliness)——即使准确率相似,PA 下只有 69% 的预取是迟到的(而 RR/TL 下为 85-89%)。
银行级并行性(BLP)与行缓冲区局部性(RBL)
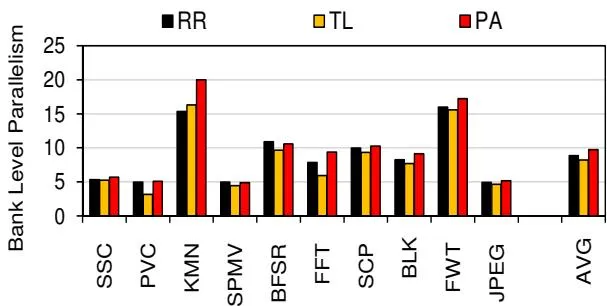
| 调度器 | BLP 变化 | RBL 变化 |
|---|---|---|
| PA vs TL | +18% | -24% |
| PA vs RR | 略降 | 略升 |
应用级差异:
- FFT:BLP 提升 57%,RBL 下降 44%,IPC 提升 31%(BLP 收益 > RBL 损失)
- PVC:BLP 提升 62%,RBL 下降 31%,IPC 反而下降 4%(RBL 损失 > BLP 收益)
L1 缺失率与缓存污染
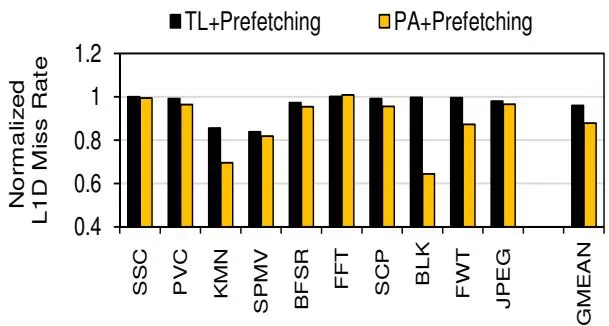
PA+Prefetch 相比 TL+Prefetch 将 L1 缺失率降低 10%。
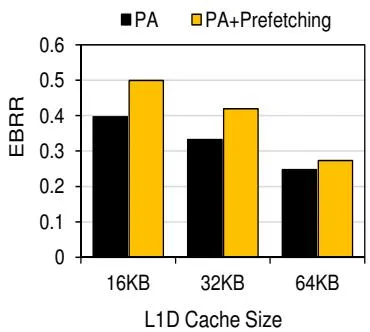
预取导致的缓存污染度量(Evicted Block Reference Rate):
- 32KB L1:预取导致 EBRR 增加 26%
- 64KB L1:EBRR 仅增加 10%
- 结论:更大的 L1 缓存或预取缓冲区可以减少污染,但会减少计算资源
六、相关工作
| 工作 | 关系 |
|---|---|
| Two-Level Warp Scheduler (MICRO’11) [34] | PA 的基础,TL 将相邻 warp 分同组,PA 改为不相邻 warp |
| OWL (ASPLOS’13) [17] | CTA-aware 调度减少缓存竞争,不考虑预取交互 |
| Cache-Conscious Wavefront Scheduling (MICRO’12) [40] | 缓存感知调度,不涉及预取 |
| Many-Thread Aware Prefetching (MICRO’10) [29] | 多线程感知的核外预取,可与 PA 正交组合 |
| Prefetch-Aware DRAM Controllers (MICRO’08) [26] | CPU 系统中调度感知预取,首次探索该方向 |
| Improving BLP with Prefetching (MICRO’09) [27] | CPU 中预取对 BLP 的影响,GPGPU 中未探索 |
| ATLAS (HPCA’10) [22] | DRAM 控制器级并行调度,与 warp 调度正交 |
七、总结
核心贡献
- 发现现有调度器的预取盲区:RR 和 TL 调度器将相邻 warp 连续调度,导致预取虽准确但太晚
- PA 调度器设计:基于不相邻 warp 分组的 fetch group 形成算法,分离相邻 warp 调度时间
- SLD 预取器:基于空间局部性检测的简单预取器,配合 PA 调度器发挥最大效能
- 25% IPC 提升:PA+Prefetch 较 RR+Prefetch 平均提升 25%,较 TL+Prefetch 提升 7%
- BLP vs RBL 权衡:系统分析 GPGPU 中行缓冲区局部性与银行级并行性的权衡,证明两者都重要
技术影响
- 调度与预取的协同设计是 GPGPU 内存延迟隐藏的未被充分探索的方向
- PA 调度器无需复杂预取器即可达到 sophisticated prefetcher + TL 的性能
- 硬件开销极小:30 核系统仅占用 1.25 mm²(65nm),占 GTX 285 面积的 0.27%
局限性
- 预取在 32KB L1 下导致 26% 的 EBRR 增加(缓存污染),64KB 时可降至 10%
- 某些应用(如 BFSR)因内存请求缺乏空间局部性,PA+Prefetch 无明显收益
- 仅评估了 10 个应用,覆盖 MapReduce/Rodinia/Parboil/CUDA SDK 四类套件
- 未考虑多 kernel 并发执行场景
八、参考资源
- 论文 PDF: https://users.ece.cmu.edu/~omutlu/pub/orchestrated-gpgpu-scheduling-prefetching_isca13.pdf
- GPGPU-Sim: http://gpgpusim.org (cycle-accurate GPGPU simulator)
- OWL 论文: Jog et al., ASPLOS 2013, “OWL: CTA-Aware Scheduling Techniques for Improving GPGPU Performance”
- Two-Level Scheduler: Narasiman et al., MICRO 2011, “Improving GPU Performance via Large Warps and Two-Level Warp Scheduling”
- Spatial Locality Detection: Johnson et al., MICRO 1997, “Run-Time Spatial Locality Detection and Optimization”