MAI-Thinking-1: Building a Hill-Climbing Machine
微软AI从零构建的35B/1T MoE推理模型,AIME 2025达97%,SWE-Bench Pro达52.8%
MAI-Thinking-1: Building a Hill-Climbing Machine
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MAI-Thinking-1: Building a Hill-Climbing Machine |
| 作者 | The Microsoft AI Team |
| 机构 | Microsoft AI (MAI) |
| 论文 | microsoft.ai/pdf/mai-thinking-1.pdf |
| 发布 | 2026年 |
| 页数 | 108页 |
| 联系 | mai-technical-report@microsoft.com |
二、核心思想
问题定义
如何从零构建一个强大的推理模型,使其在 STEM 推理和编程任务上达到前沿水平?关键不是单个模型的突破,而是建立一个能够持续改进的”爬山机器”(hill-climbing machine)——将模型开发视为系统级优化问题。
解决方案概述
MAI-Thinking-1 是微软 AI 从零开发的推理模型,具有以下核心特征:
- 架构: 35B 活跃参数 / 1T 总参数的稀疏 MoE 模型
- 预训练: 30T tokens,完全使用干净的企业级数据,无第三方模型蒸馏
- RL 训练: 从零开始的强化学习,持续数千步的对数线性性能提升
- 三大设计原则:
- 能力应通过学习获得,而非继承(无蒸馏)
- 简单性是可持续的
- 科学严谨性避免捷径
核心性能
| 基准 | 得分 |
|---|---|
| AIME 2025 | 97.0% |
| AIME 2026 | 94.5% |
| LiveCodeBench v6 | 87.7% |
| SWE-Bench Pro | 52.8% |
| SWE-Bench Verified | 73.5% |
| GPQA Diamond | 84.2% |
| HMMT Feb 2026 | 84.9% |
| Terminal-Bench 2.0 | 46.0% |
三、技术架构
模型架构
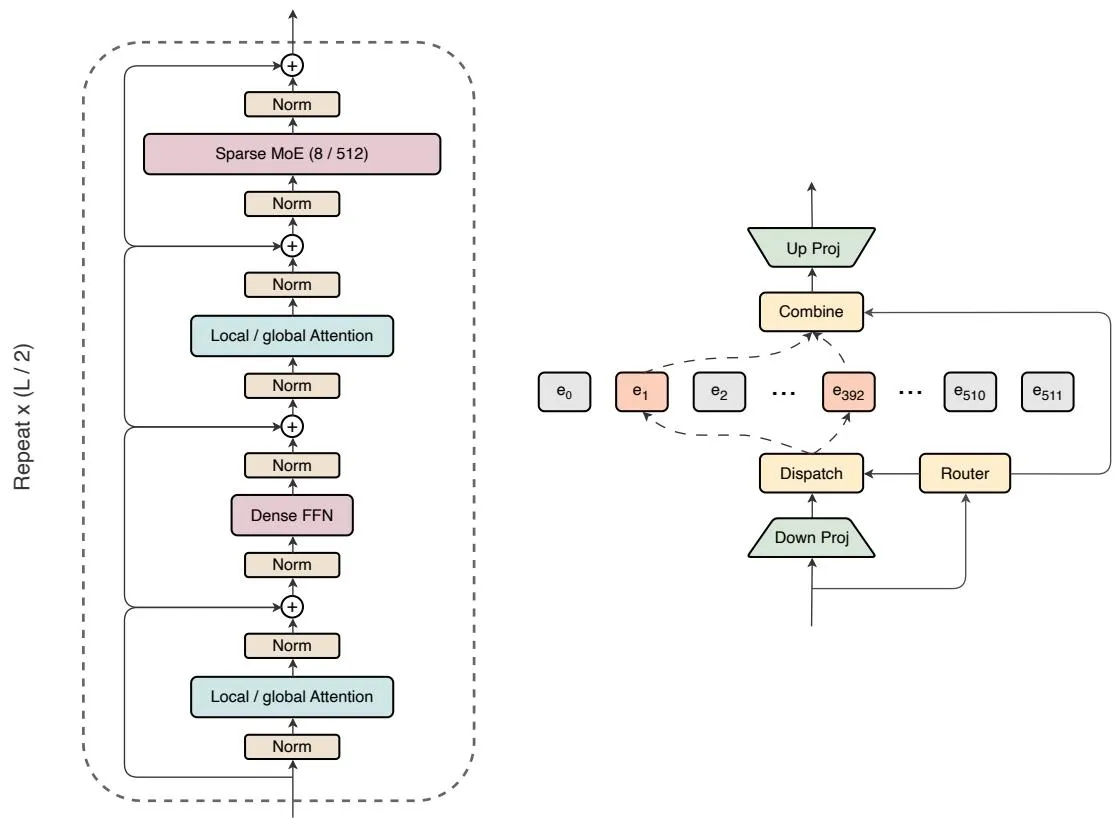
Figure 2: MAI-Base-1 架构总览
MAI-Base-1 是一个 decoder-only Transformer,具有以下关键设计:
| 参数 | 值 |
|---|---|
| 活跃参数 | 34.7B |
| 总参数 | 962B(~1T) |
| 层数 | 78 |
| 隐藏维度 | 6656 |
| FFN 维度 | 13312 |
| Expert FFN 维度 | 10240 |
| Top-k / 专家数 | 8 / 512 |
| KV/Q 头数 | 8/80 |
| 词表大小 | 200,019 (o200k_base) |
| 最大上下文 | 256K |
关键架构创新
1. 交替 MoE + Dense FFN
- 交替使用高稀疏度 MoE 层和小型 Dense FFN
- 比均衡稀疏度分配更高效(等活跃参数和等总参数设置下)
- 每层 MoE 依赖共享专家较少
2. 交替 Local/Global Attention
- 遵循 Gemma 3 的周期性注意力设计
- 5 个 Local Attention 层 + 1 个 Global Attention 层
- Local: RoPE,滑动窗口 512,基频 10,000
- Global: 无位置编码(效率更高)
- GQA: 8 KV heads,每头维度 128
3. LatentMoE 设计
- 共享 down-projection 在 all-to-all dispatch 前应用
- 压缩因子 2x,专家内扩展 3x
- 路由决策基于原始表示
- 8/512 experts 激活,softmax gating
4. Dropless MoE
- 完全无 token dropping
- 可变消息大小的 all-to-all 通信
- 全局 batch 负载均衡损失
模型家族配置
| 模型 | 活跃 | 总参数 | 层数 | 隐藏 | Top-k/Experts |
|---|---|---|---|---|---|
| L12 | 365M | 3.9B | 12 | 1024 | 8/512 |
| L24 | 1.5B | 30B | 24 | 2048 | 8/512 |
| L42 | 6.1B | 159B | 42 | 3584 | 8/512 |
| L66 | 21.7B | 615B | 66 | 5632 | 8/512 |
| L78 | 35.6B | 1015B | 78 | 6656 | 8/512 |
| MAI-Base-1 | 34.7B | 962B | 78 | 6656 | 8/512 |
注意力初始化创新
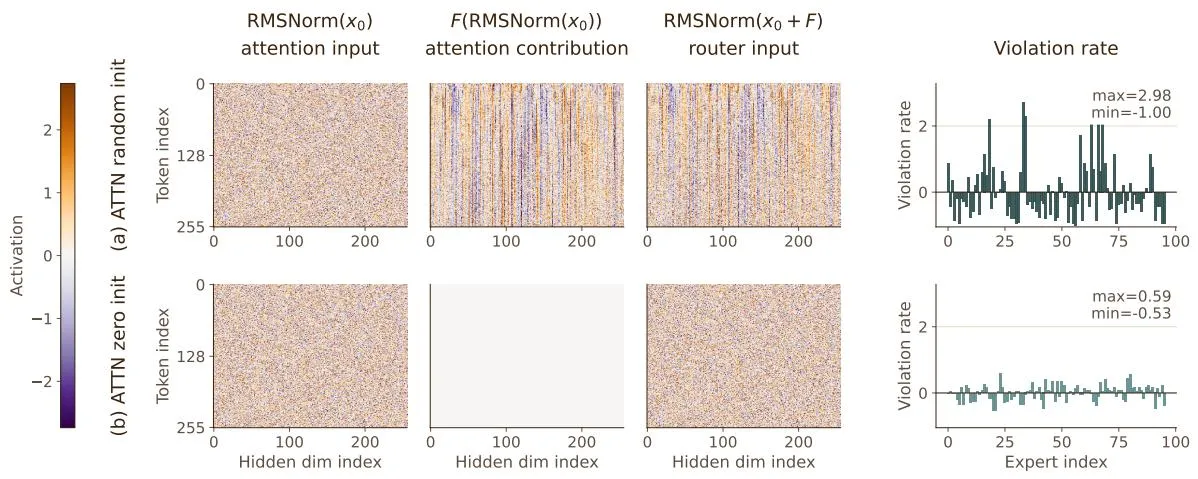
Figure 8: 随机初始化 vs 零初始化的注意力层
关键发现: 随机初始化时,注意力 softmax 接近均匀分布,本质上执行因果均值池化,导致 token 表示坍缩和 MoE 层路由高度不平衡。
解决方案: 将注意力输出初始化为零(RMSNorm gains 设为零),使模型初始行为类似于逐 token 的 FFN 堆叠,注意力层的跨 token 交互在训练过程中逐渐启动。
四、预训练
数据
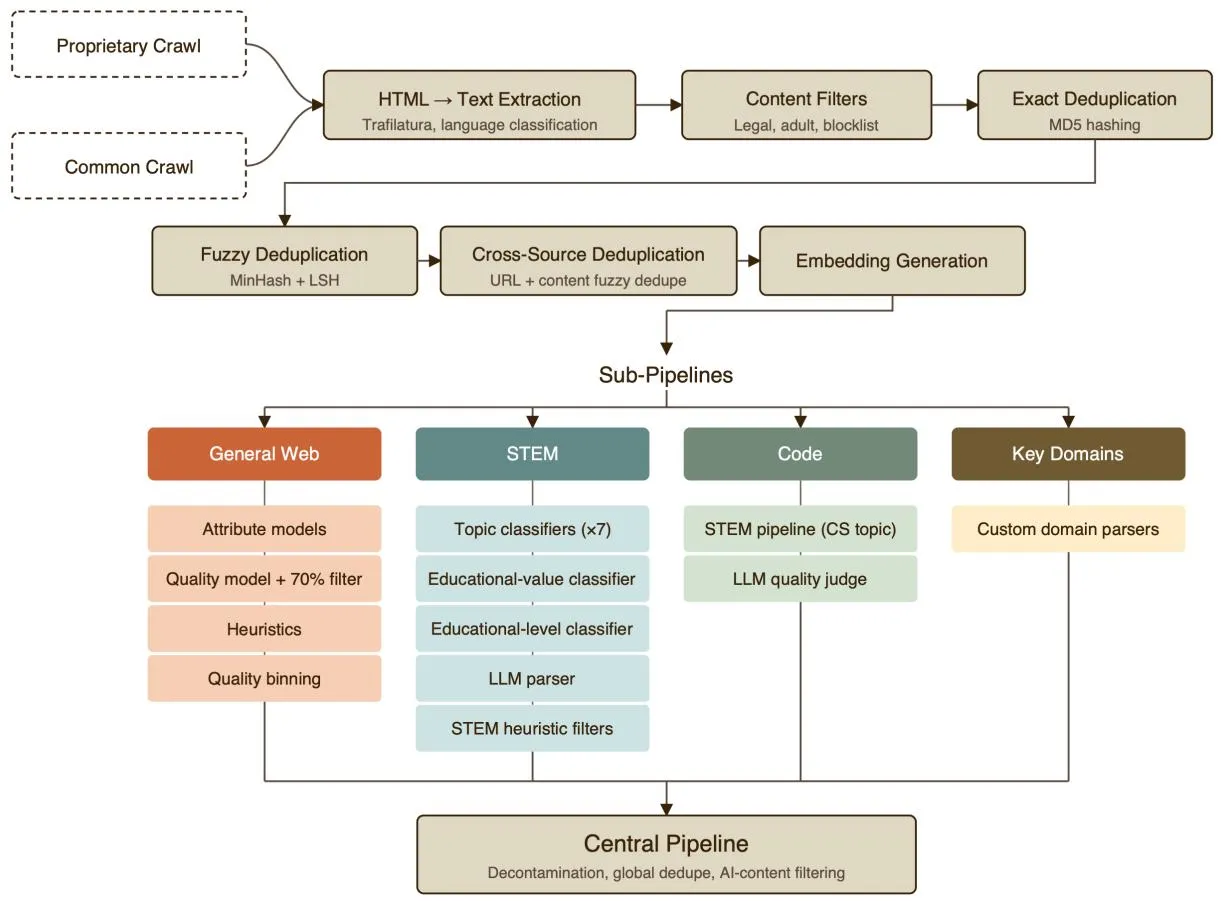
Figure 4: HTML 预训练数据处理管道
- 数据量: 30T tokens 主预训练 + 3.55T tokens 中期训练
- 数据来源: 公开和授权的人类生成数据(web、GitHub、书籍、学术论文、新闻、多语言文本)
- 关键原则: 无合成数据,无第三方蒸馏数据,努力避免和移除 AI 生成内容
- 无开源训练数据集: 常见 ML 数据库从训练数据中去污
训练阶段
| 阶段 | Tokens | 上下文长度 | GB200 GPUs |
|---|---|---|---|
| 预训练 | 30T | 16,384 | 8,192 |
| 中期训练 1 | 3.4T | 65,536 | 8,192 |
| 中期训练 2 | 150B | 262,144 | 4,096 |
训练超参数
| 参数 | 值 |
|---|---|
| 优化器 | AdamW (β₁=0.95, β₂=0.925) |
| 权重衰减 | 0.1(注意力 0.01,嵌入 0.005) |
| 梯度裁剪 | 1.0 |
| 学习率 | 预热 12B tokens,余弦衰减 2e-4 → 2e-5 |
| Dropout | 0.15 |
| 批大小 | 134M tokens |
| 数值精度 | BF16 权重/激活,FP8 GEMM,FP32 敏感位置 |
预训练损失
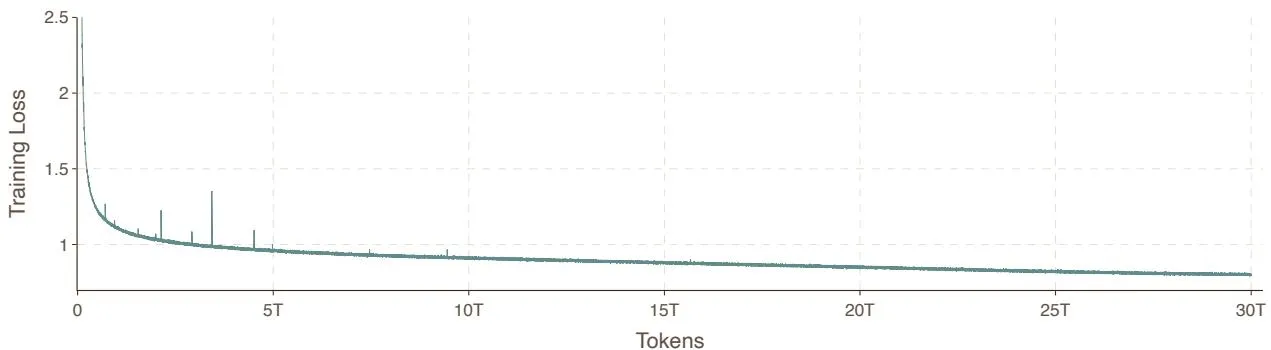
Figure 9: MAI-Base-1 在 30T tokens 上的预训练损失曲线
损失从 ~2.5 降至 ~0.87,多次早期阶段尖峰后快速恢复,无需人工干预。
基础模型对比
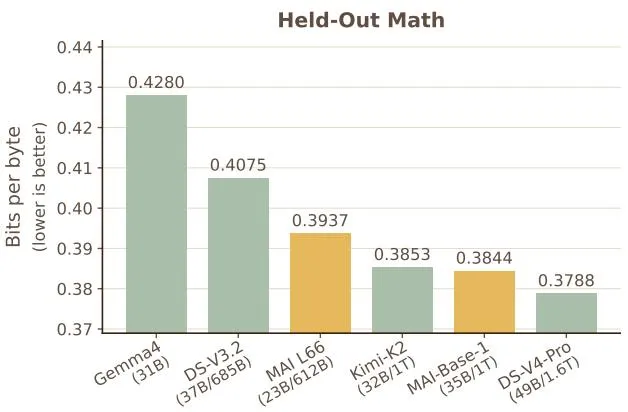
Figure 10: 基础预训练模型的 Bits-per-byte 对比
MAI-Base-1 在所有四个 held-out 任务上以相似活跃参数数取得最低 BPB:
- 优于 Gemma4 (31B)、DeepSeek V3.2 (37B/685B)、Kimi-K2 (32B/1T)
- 仅 DeepSeek V4 Pro (49B/1.6T) 以 1.4x 活跃参数超越
分布式训练框架 YOLO
YOLO (You Only Launch Once) 是微软的内部大规模训练框架:
- 内核: Triton、CUDA、CuteDSL、CUTLASS 自定义内核
- 并行: 数据、张量、上下文、专家、流水线并行
- 确定性: 位级可复现性
- 容错: 分布式检查点 + 快速故障转移到热备
- MFU: 持续保持 >20% MFU
五、强化学习
RL 总览
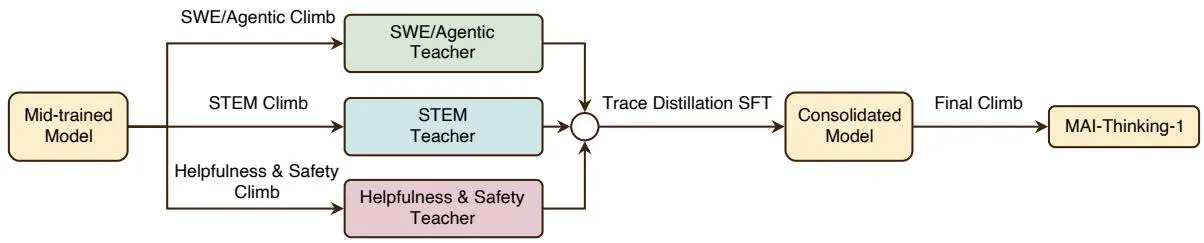
Figure 12: RL 训练总览
三个领域专家模型通过 RL 训练:
- STEM 推理专家: 数学、科学、竞赛编程
- Agentic 编码专家: SWE-Bench、工具使用
- 有用性和安全性专家: 人类偏好、安全信号
通过 Trace Distillation SFT 合并为统一模型,再进行最终 RL 阶段。
RL 目标
基于 GRPO 的 token-level policy gradient:
自适应熵控制: 动态调整上界裁剪以维持目标策略熵
奖励设计
- 任务奖励: 基于代码执行或 AI 评审
- 语言一致性奖励: 抑制 CoT 中的外语 token
- 长度惩罚: 基于问题难度的自适应惩罚
采样策略
- 问题采样: 早退策略 + 二次通过率过滤
- Rollout 采样: top-p 采样,排除 nucleus 外 token
- 长度课程: 从 8K 逐步增加到 128K tokens
自蒸馏
从 RL rollout 收集推理轨迹,对中期训练检查点执行 SFT:
- O(1M) 推理轨迹足以匹配教师性能
- 用于恢复运行失败、迁移到新基础模型、过滤 reward hacking
- 轨迹应来自多个强检查点以增加多样性
STEM 训练
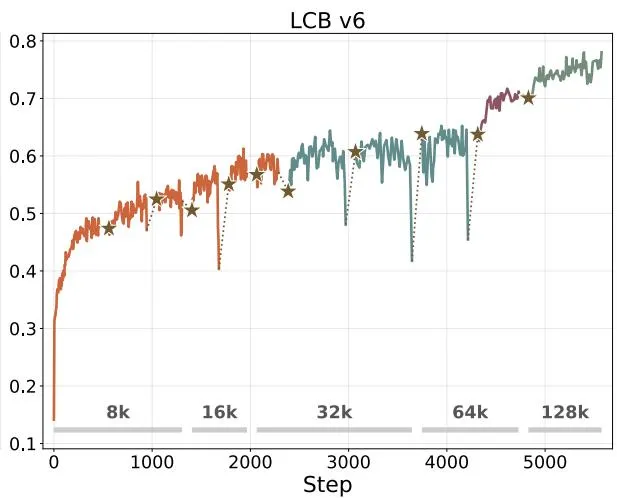
Figure 15: AIME 2025 和 LiveCodeBench v6 上的 STEM 训练进展
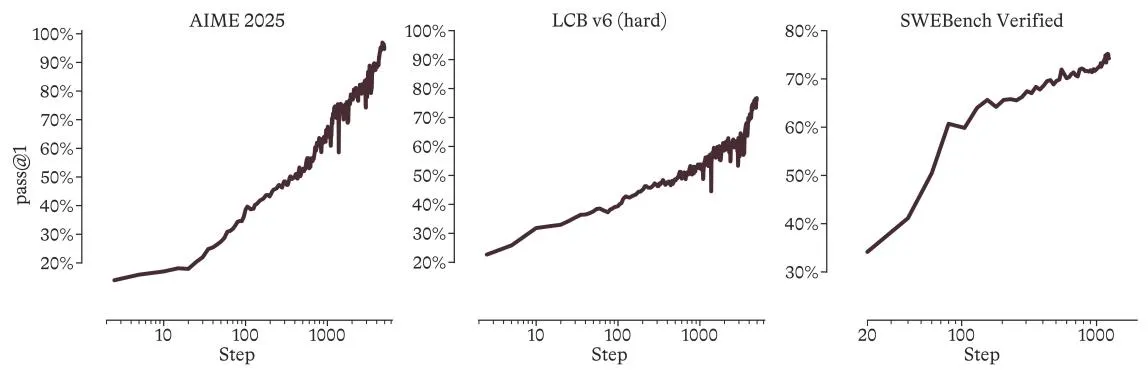
Figure 1: MAI-Thinking-1 的 RL 训练性能
Agentic 训练
- 多步骤编排的 agentic 循环
- SWE 环境使用 bash 和 string-replace 工具
- 前缀缓存命中率达 97-98%
RL 基础设施: Rocket
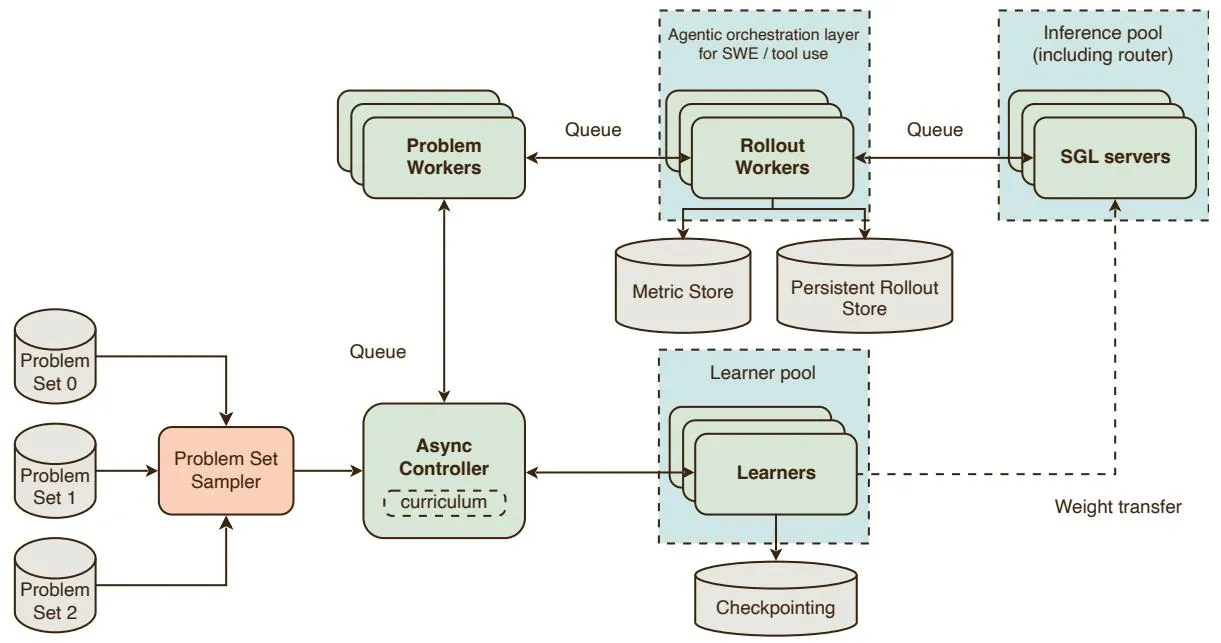
Figure 19: Rocket 大规模 RL 框架
- 推理与学习器比例可达 5:1
- 最大 RL 作业: 4864 GB300 芯片(4096 推理 + 768 学习器)
- 基于 SGLang 的推理栈
六、评估结果
STEM 和 Agentic 编码
| 基准 | MAI-Thinking-1 | Sonnet 4.6 | Opus 4.6 | DeepSeek V3.2 | DeepSeek V4 |
|---|---|---|---|---|---|
| AIME 2025 | 97.0 | 95.6 | 99.8 | 93.1 | — |
| AIME 2026 | 94.5 | — | — | — | — |
| HMMT Feb 2026 | 84.9 | — | — | — | 95.2 |
| GPQA Diamond | 84.2 | 89.9 | 91.3 | 82.4 | 90.1 |
| LCB v6 | 87.7 | — | — | 83.3 | 93.5 |
| SWE-Bench Verified | 73.5 | 79.6 | 80.8 | 73.1 | 80.6 |
| SWE-Bench Pro | 52.8 | — | 53.4 | — | 55.4 |
| Terminal-Bench 2.0 | 46.0 | 59.1 | 65.4 | 46.4 | 67.9 |
通用能力
| 类别 | 基准 | MAI-Thinking-1 | Sonnet 4.6 |
|---|---|---|---|
| 知识 | MMLU Pro | 85 | 87 |
| 知识 | SimpleQA Verified | 31 | 29 |
| 指令跟随 | IF Bench | 69 | 50 |
| 指令跟随 | Adv. IF | 85 | 86 |
| 长上下文 | GraphWalks (≤128k) | 90 | 96 |
| 工具调用 | BFCL v3 | 72 | 76 |
| 安全 | AIR-Bench | 88 | 88 |
| 诚实 | TruthfulQA | 88 | 88 |
| 健康 | HealthBench Prof. | 35 | 38 |
人类评估
| 维度 | vs Sonnet 4.6 | vs Opus 4.6 |
|---|---|---|
| 整体偏好 | +0.07 ± 0.06 | -0.07 ± 0.06 |
| 简洁性和相关性 | +0.11 ± 0.02 | +0.07 ± 0.02 |
| 风格和语调 | +0.08 ± 0.02 | +0.05 ± 0.02 |
| 指令跟随 | -0.01 ± 0.02 | -0.04 ± 0.02 |
| 事实性 | -0.02 ± 0.02 | -0.03 ± 0.02 |
关键发现: 人类评估者偏好 MAI-Thinking-1 而非 Sonnet 4.6(49% 胜 vs 45% 负),但在简洁性和风格上明显优于两者。
安全评估
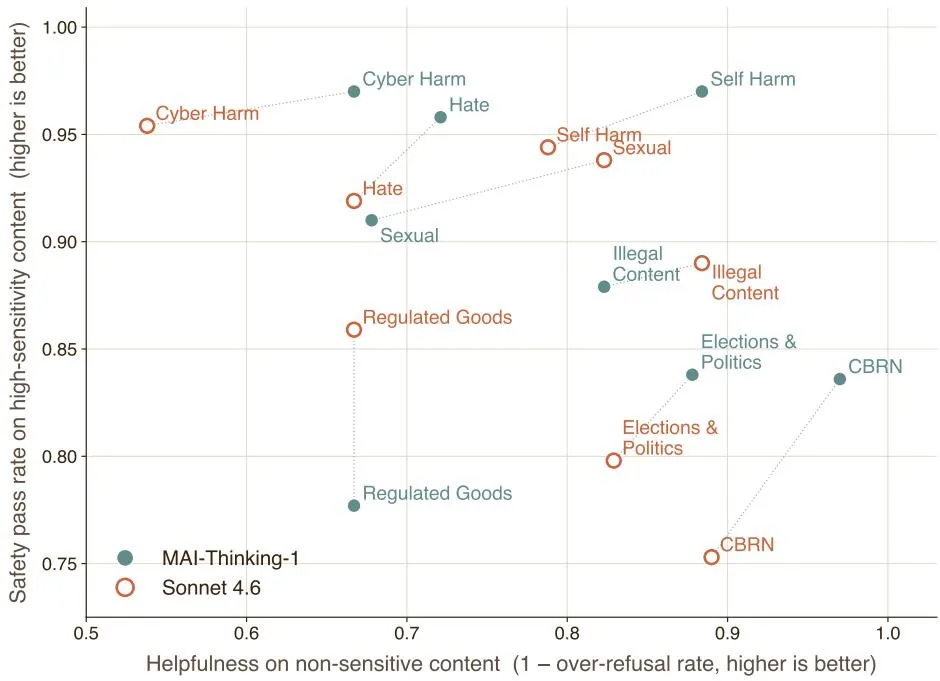
Figure 20: 安全-有用性权衡
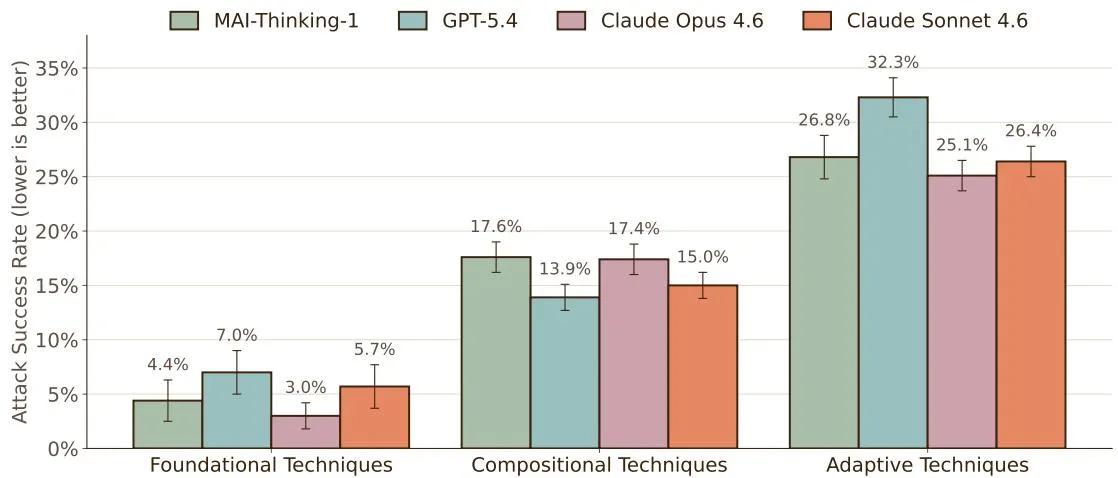
Figure 21: 越狱攻击成功率
| 攻击类型 | MAI-Thinking-1 | Sonnet 4.6 | Opus 4.6 |
|---|---|---|---|
| 基础技术 | 4.4% | 5.7% | 3.0% |
| 组合技术 | 17.6% | 15.0% | 17.4% |
| 自适应技术 | 26.8% | 26.4% | 25.1% |
七、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 从零构建无蒸馏 | 完全使用人类数据训练,无第三方模型蒸馏 | 保证能力的可引导性和鲁棒性 |
| 高稀疏 MoE + Dense 交替 | 8/512 experts + dense FFN 交替 | 比均衡稀疏度更高效 |
| LatentMoE | 压缩潜空间路由 | 减少 all-to-all 通信开销 |
| 注意力零初始化 | RMSNorm gains 设为零 | 消除初始 MoE 路由不平衡 |
| 自适应熵控制 | 动态调整 RL 裁剪上界 | 避免熵爆炸或坍缩 |
| Outer Ratio Clip | 硬外裁剪防止梯度爆炸 | 更稳定的 RL 训练 |
| 自蒸馏 | RL rollout → SFT → 继续 RL | 恢复失败、迁移能力 |
| YOLO 框架 | 确定性、容错的分布式训练 | 90% goodput @ 8K GPUs |
| Dropless MoE | 完全无 token dropping | 避免因果泄漏和容量限制 |
| 全局 batch 负载均衡 | 跨 DP workers 和 micro-batches 聚合 | 比负载均衡损失类型更重要 |
八、训练基础设施
集群环境
- 硬件: 8K GB200 GPUs,单一逻辑集群
- 训练框架: YOLO (You Only Launch Once)
- MFU: >20% 持续保持
- Goodput: 90.0% @ 8K GPUs
- 总开销: 51 小时(其中 6.5 小时重计算,14 小时非步进时间,18 小时 MFU 下降)
数值精度策略
| 位置 | 精度 |
|---|---|
| 模型权重和激活 | BF16 |
| 前向 GEMM | FP8 E4M3 |
| 数据梯度 | FP8 E5M2 |
| 权重梯度 | BF16 |
| 梯度累积 | FP32 |
| 残差流 | FP32 |
| 嵌入、RMSNorm、Router 权重 | FP32 |
| 优化器状态 | FP32 |
推理部署
- 在 Microsoft MAIA-200 硬件上部署
- 比 GB200 部署提高 40%+ token 生成吞吐量(相同机架功率预算)
九、总结
核心贡献
- 从零构建的 35B/1T MoE 推理模型: 无蒸馏,完全使用人类数据
- AIME 2025 达 97.0%: 超越 Sonnet 4.6 (95.6%)
- SWE-Bench Pro 达 52.8%: 接近 Opus 4.6 (53.4%)
- “爬山机器” 方法论: 将模型开发视为系统级优化问题
- YOLO 分布式训练框架: 确定性、容错、高 goodput
- 自适应 RL 熵控制: 动态维持策略熵的简单有效方法
- 安全-有用性平衡: 在多个安全类别上超越 Sonnet 4.6
技术影响
- 无蒸馏范式: 证明从零训练可以达到与蒸馏模型相当的水平
- MoE 架构: 高稀疏度 + dense 交替的有效性
- RL 基础设施: 大规模 RL 训练的工程实践
- 安全训练: 安全-有用性权衡的系统方法
局限性
- Terminal-Bench 2.0 性能较低(46.0% vs Sonnet 59.1%)
- 未使用 Terminal 交互环境训练
- 多语言安全鲁棒性仍需改进
- 108 页技术报告的复杂性
十、参考资源
- 论文: microsoft.ai/pdf/mai-thinking-1.pdf
- 联系: mai-technical-report@microsoft.com
- 训练框架: YOLO (内部)
- 推理硬件: MAIA-200
- 训练硬件: 8K GB200 GPUs (Azure)