Scaling Llama 3 Training with Efficient Parallelism Strategies
Llama 3 405B 模型在 16K H100 GPU 上的四维并行训练系统设计,涵盖灵活流水线并行、上下文并行、大规模调试方法及硬件建议
Scaling Llama 3 Training with Efficient Parallelism Strategies
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Scaling Llama 3 Training with Efficient Parallelism Strategies |
| 作者 | Weiwei Chu†, Xinfeng Xie†, Jiecao Yu†, Jie Wang†, Amar Phanishayee, Chunqiang Tang, Yuchen Hao, Jianyu Huang, Mustafa Ozdal, Jun Wang, Vedanuj Goswami, Naman Goyal, Abhishek Kadian, Andrew Gu, Chris Cai, Feng Tian, Xiaodong Wang, Min Si, Pavan Balaji, Ching-Hsiang Chu, Jongsoo Park |
| 机构 | Meta Platforms, Inc. |
| 会议 | ISCA 2025 (52nd Annual International Symposium on Computer Architecture), Tokyo, Japan |
| DOI | https://doi.org/10.1145/3695053.3731410 |
| 论文 | https://aisystemcodesign.github.io/papers/Llama3-ISCA25.pdf |
| 发布 | 2025-06-20 |
二、核心思想
问题定义
Llama 3 405B 是目前最大的开源大语言模型之一,在 16,384 个 H100 GPU 上使用 FLOPs 进行预训练。训练面临三大核心挑战:
- 效率挑战:这是一个”能力计算”问题——目标是最小化总训练时间。全局 token 预算固定为 16M/step,限制了数据维度的并行度,使得流水线气泡难以隐藏。
- 灵活性挑战:训练分多阶段进行(短上下文→长上下文→多模态),每阶段的 batch size、序列长度、模型架构(如交叉注意力层)都不同,系统需动态适应。
- 实用性挑战:16K GPU 规模下,性能瓶颈和数值问题的调试极其复杂——观察到问题的 rank 往往不是真正的根源。
解决方案概述
Llama 3 采用**四维并行(4D Parallelism)**策略,将 FSDP、TP、PP、CP 组合使用:
| 并行维度 | 作用 | 通信层级 | 典型配置 |
|---|---|---|---|
| FSDP (Fully Sharded Data Parallel) | 沿 batch 维度分片数据,分片参数/梯度/优化器状态 | 最外层(可重叠) | ZeRO-1/2 |
| TP (Tensor Parallelism) | 沿层内张量维度分片(Megatron-LM 方式) | 最内层(NVLink) | TP=8 |
| PP (Pipeline Parallelism) | 沿层间维度分片模型层 | 中间层(P2P) | PP=16 |
| CP (Context Parallelism) | 沿序列维度分片输入 | 中间层(AllGather) | CP=16 |
并行度排序(从内到外):[TP, CP, PP, DP]——通信频率和延迟最高的放在最内层。
核心贡献:
- 灵活 PP 调度:支持任意 batch size 和异构模型架构(多模态训练)
- All-Gather-based CP:支持文档掩码注意力,性能可比肩 RingAttention
- 大规模调试方法论:自顶向下 trace 分析定位慢速 rank,数值问题隔离方法
- 硬件建议:基于 16K GPU 训练经验的未来硬件设计指导
三、技术架构
四维并行总览
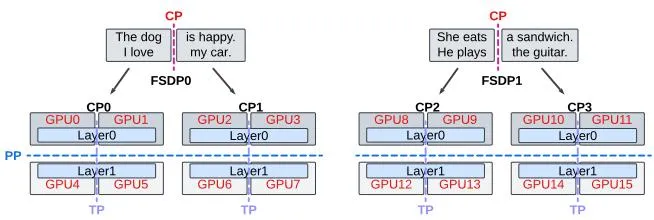
Figure 1 展示了一个两层 LLM 如何通过 4D 并行分布在 16 个 GPU 上:
- FSDP 沿 batch 维度分片输入数据
- CP 沿 sequence 维度分片输入数据
- TP 在同一层内分片模型参数
- PP 跨层分片模型参数
FSDP (Fully Sharded Data Parallel)
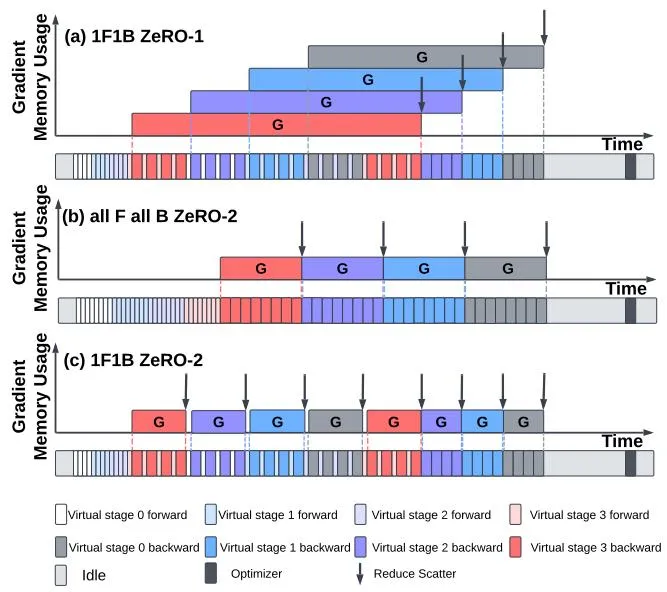
基于 PyTorch FSDP 的自研实现,支持三种 ZeRO 分片策略:
| 策略 | 分片内容 | 通信开销 | 适用场景 |
|---|---|---|---|
| ZeRO-1 | 仅优化器状态 | 最低 | PP + 大 batch size |
| ZeRO-2 | 优化器状态 + 梯度 | 中等 | PP + 小 batch size |
| ZeRO-3 | 优化器状态 + 梯度 + 参数 | 最高 | 2D 并行(无 PP) |
Llama 3 选择:
- 当 时使用 ZeRO-1(通信少,但内存占用高)
- 当 时使用 ZeRO-2(额外 ReduceScatter,但省内存)
- 不使用 ZeRO-3 + PP 组合(FSDP 通信与 PP P2P 争抢带宽)
Tensor Parallelism (TP)
- 遵循 Megatron-LM 方式,将 GEMM 算子沿输入/输出维度切分
- TP=8,恰好等于单节点 GPU 数,利用 NVLink/NVSwitch 节点内高带宽
- 配合序列并行(SP)进一步减少激活内存
Pipeline Parallelism (PP)
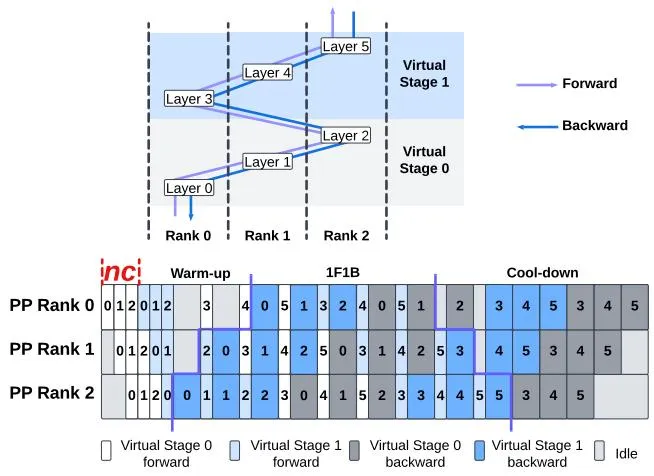
Llama 3 的 PP 基于交错式 1F1B 调度(Interleaved 1F1B),做了三项关键优化:
优化 1:灵活 PP 调度(支持任意 Batch Size)
原始 1F1B 要求 且 (batch size 必须是 PP rank 数的倍数)。Llama 3 训练中 global batch size 频繁变化,因此实现了灵活调度:
Warm-up 微批次数:
其中 = 每个 PP rank 的虚拟阶段数, = 连续微批次数, = 流水线大小, = 流水线 rank 索引。
PP 气泡比率:
为最小化气泡,偏好更小的 、更多微批 、更多虚拟阶段 。
当 时,插入 个额外微批次到 warm-up 阶段,帮助隐藏 P2P 通信:
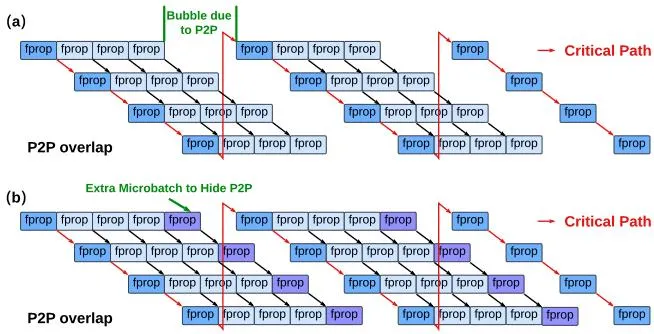
当 时,调度退化为 All-Forward-All-Backward。
优化 2:PP 与模型协同设计(均衡负载)
均匀分层会导致内存和计算不均衡:
- 第一个 PP rank 有 embedding 层(128K 词汇表),内存峰值最高
- 最后一个 PP rank 有 output head,计算量最大
解决方案:从首尾 PP rank 各减少一层,Llama 3 405B 配置为 126 层(而非 128 层)。
优化 3:PP 与 FSDP 协同
FSDP ZeRO-2 + PP 需要额外的梯度 ReduceScatter(跨虚拟阶段累积梯度),而 ZeRO-1 保留非分片梯度,内存换通信。
多模态训练中的 PP 适配
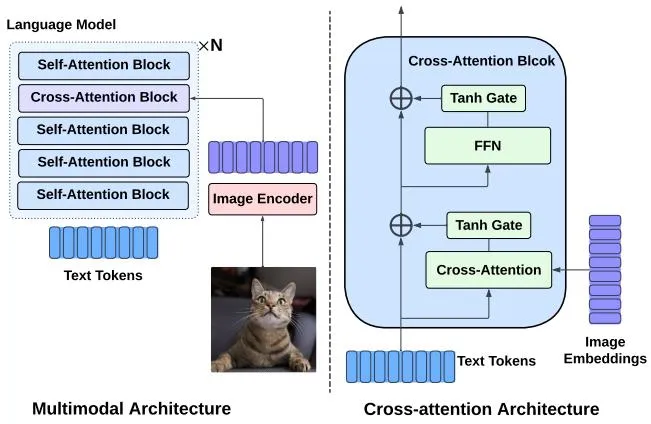
Llama 3 多模态模型在文本 Transformer 层间插入交叉注意力层,冻结自注意力层,仅训练图像编码器和交叉注意力层。
挑战 1:图像编码器分片
评估了三种方案:
| 方案 | 描述 | 优缺点 |
|---|---|---|
| Option 1 | 整体 PP 分片(编码器在首个 PP rank) | 代码改动小,但加剧负载不均衡 |
| Option 2 | 分离图像/文本模型,PP 仅用于文本 | 灵活,但编码器延迟占比高达 33% |
| Option 3 | 跨 PP rank 复制/分片编码器 | 编码器延迟从 33% 降至 8%,最终采用 |
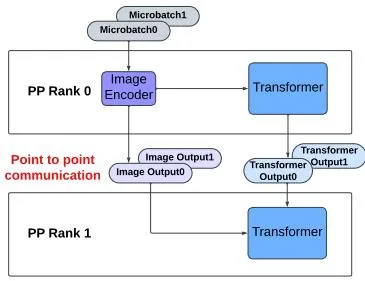
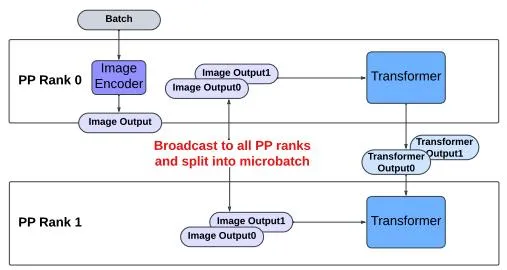
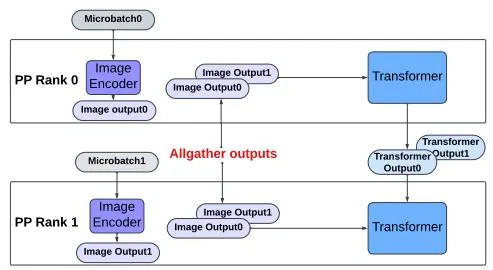
挑战 2:文本模型负载不均衡
- 交叉注意力层输入包含图像序列(1.2K-3K token)+ 文本序列(<200 token),计算量远大于自注意力层
- 反向传播中,冻结的自注意力层仅计算输入梯度,而交叉注意力层需计算权重+输入梯度
最终采用方案:每个虚拟阶段包含 个自注意力层 + 1 个交叉注意力层,交叉:自注意力比例为 4:1。
Context Parallelism (CP)
CP 沿序列维度分割输入 token,支持 128K 长上下文训练。
设计:All-Gather-based CP
采用 All-Gather 方案(而非 Ring Attention),原因:
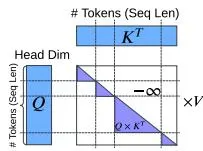
- 灵活性:Llama 3 使用文档掩码(Document Mask),token 只 attend 同文档内的 token,文档边界不规则且输入依赖。Ring Attention 在不规则掩码下难以高效利用带宽。
- 性能可比:由于 GQA/MGA,KV 张量比 Q 小;All-Gather 通信延迟 vs 注意力计算 ,长序列下通信占比小。
实现细节
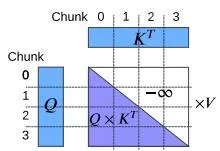
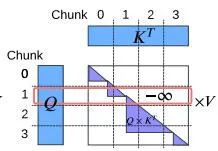
- 将输入 token 均匀分为 个 chunk
- Rank 处理第 个和第 个 chunk(平衡计算负载)
- All-Gather K/V 张量后计算注意力,支持任意掩码
集成考虑
- DP 组:CP 可视为 DP 的扩展——同一 CP 组内的 rank 共享模型参数
- Rank 选择:每个 CP rank 需要完整序列信息来计算注意力掩码
- 数据加载器:对 tokenizer 透明,每个 CP rank 接收完整序列
四、4D 并行配置
并行度尺寸选择
| 阶段 | 上下文长度 | Global Batch Size | TP | CP | PP | DP |
|---|---|---|---|---|---|---|
| 短上下文 | 8,192 | 2,048 | 8 | 1 | 16 | 128 |
| 长上下文 | 131,072 | 128 | 8 | 16 | 16 | 8 |
TP=8 的必然性:16M token 预算 + 8K 序列长度 → 。无论 2D 还是 3D 并行,都要求 才能保证 。设 恰好利用节点内 NVLink。
3D vs 2D 并行:2D(FSDP ZeRO-3 + TP)在 时计算延迟不足以隐藏 FSDP 通信。3D(FSDP ZeRO-1/2 + TP + PP)有更便宜稳定的 P2P 通信。
CP 的引入:长上下文阶段 从 2048 降至 128,若不引入 CP, 降至 1 导致 PP 气泡不可接受。CP=16 使每个 GPU 仍处理 8K 序列长度。
并行度排序
通信频率和延迟从高到低:TP > CP > PP > DP
- TP:每个 Transformer 层 4 次集体通信(注意力 + FFN 各 2 次),完全暴露
- CP:每个 Transformer 层 1 次 All-Gather,完全暴露,但涉及 个 rank 同步
- PP:P2P 通信,无同步,可部分隐藏
- DP:每训练步 1 次 All-Gather + ReduceScatter,可与前向/反向重叠
五、大规模调试方法
性能调试:自顶向下定位慢速 Rank
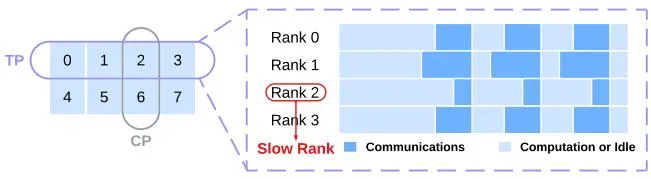
在多维并行中,观察到问题的 rank 不一定是根源。调试方法:
- 从最外层(DP)开始,识别最慢的 DP 组
- 逐层向内(PP → CP → TP)缩小范围
- 定位到具体 rank 后,检查 CPU/GPU 计算和通信 trace
类似分布式系统故障定位——最先崩溃的节点不一定是问题源头。
数值调试
区分实现 bug 与数值差异:
- 将顺序实现拆分为与并行实现相同的累积顺序,检查 bit-wise 匹配
- 例如:维护 2D 并行(DP + TP)+ 微批次来模拟 PP 的累积顺序,作为参考基线
梯度 FP32 累积:
- DP 组 ReduceScatter 梯度使用 FP32
- PP 反向传播中微批次梯度累积使用 FP32
- 多模态训练中,跨所有交叉注意力层的图像 token 梯度 Reduce 使用 FP32
内存优化
- 使用 PyTorch memory snapshot 工具分析内存分配
- 自定义 autograd 算子在前向传播中保存张量 checkpoint
- 手动调整张量 storage 大小释放底层数据
- 这些优化消除了激活重计算需求,避免增加 PP 或 TP
六、性能评估
流水线并行对比
实验使用缩小版 Llama 3 405B(26 层,):
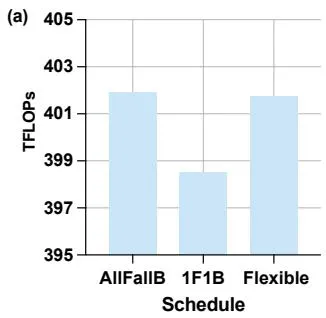
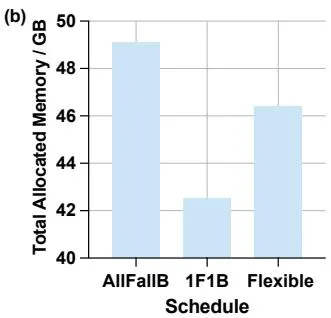
| 调度 | TFLOPs | 最大内存 |
|---|---|---|
| All-Forward-All-Backward | 401.5 | 49.0 GB |
| 1F1B | 398.5 | 42.5 GB |
| Flexible PP | 401.5 | 46.5 GB |
Flexible PP 在内存和吞吐量之间取得平衡。
均衡 PP 效果
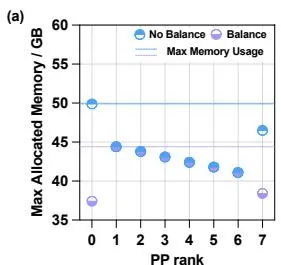
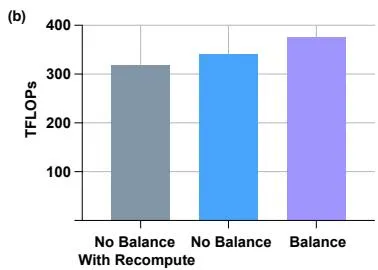
均衡 PP(首尾 rank 各减一层):
- 最大内存减少 5GB
- TFLOPs 提升 6.5%
- 消除激活重计算后 TFLOPs 提升 17.5%
上下文并行效率
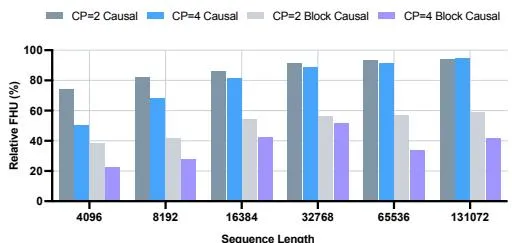
- 长序列下 CP 效率更高:128K 序列时相对 HFU 达 95%
- 因果掩码下效率高于文档掩码(文档掩码导致静态分片与文档边界不对齐)
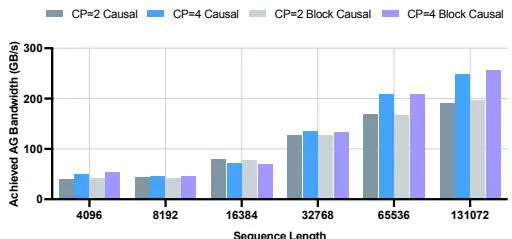
因果掩码和文档掩码的 All-Gather 带宽相当,说明文档掩码效率低源于计算负载不均衡。
CP vs TransformerEngine 对比
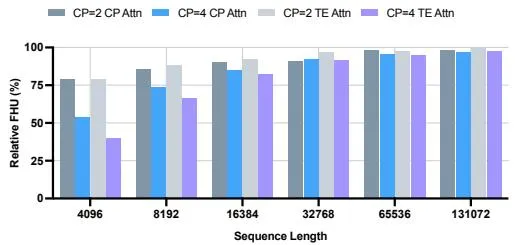
- 时 TE 略优(Ring Attention 重叠通信)
- 时 CP 注意力更优,短序列(4K/8K)提升达 13.53%
- 原因:TE 的 Ring 风格注意力在短序列 + 大 时产生碎片化计算内核和合并开销
端到端性能
- 8K 序列长度:400 TFLOPs/GPU
- 131K 序列长度:380 TFLOPs/GPU
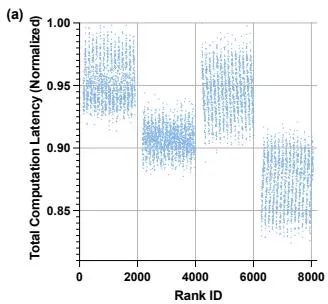
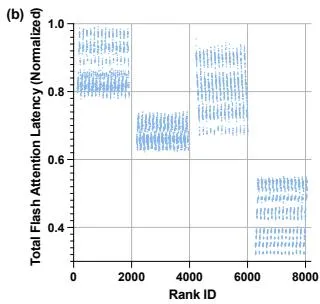
长上下文训练中,CP 通信暴露延迟占总时间 7.64%,其中 65.75% 源于等待最慢 rank。最慢 rank 计算时间是最慢的 1.44×,完全由注意力内核差异导致(文档掩码引起)。
七、硬件设计建议
节点级建议
| 建议 | 说明 |
|---|---|
| 宽范围计算效率 | 并行减小 GEMM 维度,需保证充足内存带宽 |
| 更大 HBM 容量 | 允许探索更多并行配置(如 TP=4 可提升 ~10%) |
| 足够 CPU 性能 | 加速器代际提升快于 CPU,大集群易成 CPU 瓶颈 |
| 确定性 DVFS | 避免不同加速器因动态调频产生瞬时减速 |
集群级建议
| 建议 | 说明 |
|---|---|
| 分层网络优化 | 上层交换机可过载带宽,需根据并行需求协同设计 |
| 健壮网络性能 | 任何两个 rank 间的减速都会影响整个集群 |
| 优先 Perf/Watt | 100K+ GPU 集群受数据中心总功率限制 |
八、核心创新总结
| 创新点 | 说明 | 关键数据 |
|---|---|---|
| 灵活 PP 调度 | 支持任意 batch size,无需是 PP rank 数的倍数 | 气泡比率 |
| 模型协同 PP | 首尾 rank 各减一层均衡负载 | 内存降 5GB,TFLOPs 提升 6.5% |
| All-Gather CP | 支持文档掩码注意力,非 Ring 方案 | 128K 序列相对 HFU 95% |
| 多模态 PP 适配 | 编码器跨 PP rank 复制,4:1 交叉/自注意力比 | 编码器延迟占比 33%→8% |
| 自顶向下调试 | 从 DP→PP→CP→TP 逐层缩小慢速 rank 范围 | — |
| FP32 梯度累积 | DP ReduceScatter + PP 微批次累积使用 FP32 | 消除数值差异 |
九、技术影响
对大规模训练的指导
- 4D 并行成为标准范式:FSDP + TP + PP + CP 的组合已在多个超大规模训练中验证
- 系统-模型协同设计:并行策略需与模型架构(层数、注意力类型)联合优化
- 调试方法论可复用:自顶向下 trace 分析和数值隔离方法适用于任何大规模分布式训练
局限性
- 模型特异性:主要针对 405B 模型,更小/更大模型可能需要不同策略
- 硬件依赖:特定于 NVIDIA H100 + NVLink + InfiniBand 架构
- 文档掩码效率:静态 CP 分片与动态文档边界不对齐导致负载不均衡,理论上限仅 2.62% 改善空间
- 成本:16,384 GPU 的训练成本极高,限制了可复现性
十、参考资源
论文
- 本文: https://aisystemcodesign.github.io/papers/Llama3-ISCA25.pdf
- DOI: https://doi.org/10.1145/3695053.3731410
- Llama 3 技术报告: https://arxiv.org/abs/2407.21783
- Llama 3 Herd of Models: https://arxiv.org/abs/2407.21783
相关工作
- Megatron-LM: TP 实现基础
- RingAttention: CP 对比基线
- DeepSpeed ZeRO: FSDP 分片策略定义
- PyTorch FSDP: FSDP 实现基础
- TransformerEngine: CP 对比基线(Ring 风格注意力)
代码与资源
- Meta AI & Systems Co-Design: https://aisystemcodesign.github.io
- PyTorch FSDP: https://pytorch.org/docs/stable/fsdp.html