LiteTopK: Exploiting the Curse of Dimensionality for a Fused Indexer-TopK Kernel in Long-Context Sparse Attention
A novel fused Indexer-TopK kernel that exploits the curse of dimensionality to accelerate sparse attention in long-context LLM inference, achieving up to 3.38x speedup on B200.
LiteTopK: Exploiting the Curse of Dimensionality for a Fused Indexer-TopK Kernel in Long-Context Sparse Attention
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LiteTopK: Exploiting the Curse of Dimensionality for a Fused Indexer-TopK Kernel in Long-Context Sparse Attention |
| 作者 | Ziqi Yin (Nanyang Technological University), Jianyang Gao (ETH Zurich), Peiqi Yin (The Chinese University of Hong Kong), Jiangneng Li (Nanyang Technological University), Gao Cong (Nanyang Technological University) |
| 机构 | Nanyang Technological University, ETH Zurich, The Chinese University of Hong Kong |
| 论文 | arXiv:2607.11976v1 |
| 代码 | https://github.com/Heisenberg-Yin/LiteTopK |
| 发布 | 2026-07-13 |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
Indexer-TopK 是计算分数并选择每行前 个元素的核心操作,广泛应用于大语言模型(LLM)推理、推荐系统和向量检索中。在长上下文 LLM 推理的 prefill 阶段,注意力计算随着上下文增长到数百万 token 而变得极其昂贵,因此稀疏注意力系统如 DeepSeek Sparse Attention (DSA) 通过仅使用一小部分 token 来近似完整注意力。
具体而言,DSA 将当前文本块视为 queries,将历史上下文视为候选 keys 和 values,并计算 preceding context 与 chunk text 之间的轻量级相关性分数,然后应用 top- 选择来识别最相关的历史 token。然而,现有的 GPU-based Indexer-TopK 内核(如 DSA)由于 excessive global memory traffic、costly synchronization 和 prohibitive memory overhead 而效率低下。
关键挑战包括:
- Memory overhead: DSA kernel 在 1M-token prefill(chunk size=8192)下产生 32 GB 的运行内存开销,因为需要将完整的 score matrix 写入 HBM。以 GLM-5.2 在 8xB200 上部署为例,0.95 内存利用率仅提供 170 GB/GPU,而模型权重、KV cache 和中间激活共消耗 167 GB,仅剩不到 3 GB 的余量。
- Latency overhead: Score matrix 需要写回 HBM 并在 Top- selection 期间多次读取,导致显著延迟。DSA kernel 在 1M context length 下占 GLM-5.2 prefill runtime 的 83.7%。
解决方案概述
本文观察到稀疏注意力分数在高维空间中存在距离集中现象(distance concentration phenomenon),这是由高维空间中的”维度灾难”(curse of dimensionality)引起的。在高维向量空间中,向量间的相似度分数(如欧氏距离和内积)往往集中在狭窄范围内,同时呈现极长尾分布。例如,GLM-5.2 第一层在 1M-token 上下文下,DSA 分数集中在 25 到 35 之间,而 的分数极为罕见(仅约 10K 个)。
基于这一观察,本文提出 LiteTopK — 一个遵循 sample-filter-select 框架的新型融合的 Indexer-TopK 内核:
- Sample: 采样少量数据估计 query-data 分数范围
- Filter: 利用这些估计在线将候选结果划分为 bins,维护紧致的近似阈值,只返回有希望的候选者
- Select: 仅在阈值 bin 内进行尾部 selection
LiteTopK 的设计原则也可扩展到其他稀疏注意力内核。
三、技术架构
整体框架图
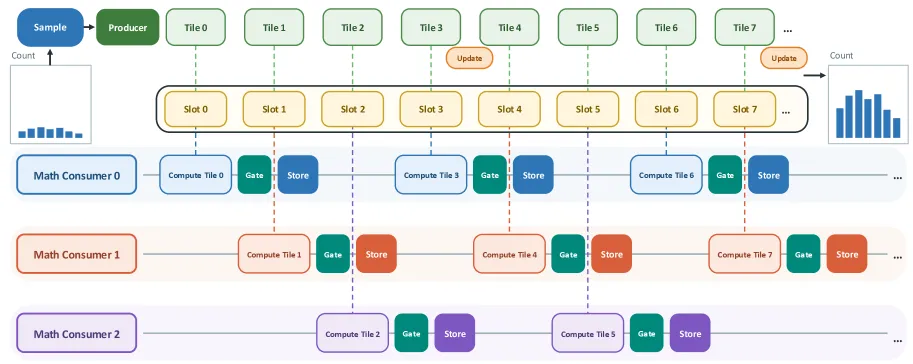
LiteTopK 在每个 CTA 级别融合 top- 选择进入评分内核,通过 sample-filter-select 工作流实现。其核心流程包括四个阶段:
(1) Sample: 在主循环开始前,对小样本 进行评分以估计分数范围,将该范围划分为 个等宽 bins,初始化 histogram 的 bin 计数,并设置初始阈值 bin(包含当前 -th 最大分数的 bin)。
(2) Filter: 在主循环中,每批分数生成后,每个分数映射到其 bin ID 并与阈值 bin ID 比较。仅通过的候选者保留在每个 warp 的列表中,稍后批量刷写到 shared-memory candidate buffer,同时更新 histogram 计数。
(3) Refresh: 定期使用空闲 warp 从 histogram 重新计算阈值 bin,使门控随扫描进行收紧。
(4) Select: 扫描完成后,阈值 bin 上方的候选者直接写入输出,仅在阈值 bin 内进行尾部选择。
核心公式
DSA 索引器评分公式:
其中 是每个 preceding token 存储的 indexer key vector(FP8), 是 query token 的多组 indexer query vectors, 是按 head 聚合的查询相关权重。一个 per-query top- selection()应用于该聚合 score ,产生用于注意力计算的 token 子集。
Top-K 问题定义:
稀疏注意力中 是 indexer score(如 DSA 分数,公式(1))。同样考虑 -nearest-neighbor (-NN) 搜索等其他场景。
Bin-space 评分公式(核心优化):
这里 为 bin 宽度, 存储为倒数以便用乘法而非除法计算 bin ID。bin-space score 是 DSA score 的仿射变换,可在现有 FFMA chain 中直接产出,无需引入额外指令。权重预缩放()只需在扫描前执行一次,FFMA accumulator 初始化为仿射偏移 即可,有效零成本。
采样配置: (对于 DSA),即从上一 chunk 的 top- 结果中最频繁出现的 tokens 作为当前 chunk 的样本。
详细方法
Sampling(采样阶段): 采样有两个目的:必须覆盖分数范围以使 bins 缩放合理,且应包含接近真实 top- 阈值的分数以使初始门控紧凑。对于稀疏注意力,我们利用 prefix keys/values 在各 chunk 间共享的观察——相邻 chunks 自然具有相似语义,因此往往 attend 到相同的 prefix tokens。我们复用上一个 chunk 的 top- 结果中出现最频繁的 个 token(如 DSA 中 )作为当前 chunk 的样本。这些 token 很可能仍然是高分的,从而产生紧致的初始阈值。由于一个 prefill chunk 包含数千个 queries(如 8,192 个 token),选择 top- token 的成本被分摊到数千次评分计算中,且执行是异步的,实际中可忽略不计。对于 -NN 搜索,其分数分布也集中但不存在这种时间结构,随机采样即可。
评分 个候选者以获得最小和最大样本分数 和 ,然后应用等宽量化将 划分为 个 bin,宽度为 。分数 落入 bin 。我们存储倒数 以便用乘法而非除法计算 bin ID,这在 GPU 上更高效。
Filtering(过滤阶段): 过滤与原评分管道融合,不改变评分语义。
当分数由 Tensor Cores 直接生成时(如基于内积的稀疏注意力内核),bin ID 在每个分数生成后立即由 CUDA cores 计算,每个分数仅增加几个标量指令(bin ID 的 FFMA 和门控的比较)。由于此类内核受限于 Tensor Core 且其 CUDA cores 大量空闲,此后处理与后续 tile 的矩阵乘法重叠,引入 negligible overhead。
DSA 更具挑战性:其分数在 CUDA cores 上最终确定,因此任何额外的算术运算都会直接增加延迟。我们将 bin 映射折叠到分数计算本身——关键观察是 bin-space score 是 DSA score 的仿射变换,可由现有计算产生。加权 sum 已通过 FFMA 指令链计算,其 accumulator 通常初始化为零;我们只需将其初始化为仿射偏移 ,几乎零成本。FFMA 链直接输出 ,由此可得 bin ID。对每个 surviving candidate 存储 float 形式的 bin-space score 并丢弃原始分数。由于变换是固定的可逆仿射映射,原始分数可在最终输出阶段从 和 恢复,转换是无损的。
每个 passing candidate 向 histogram bin 发出一次 atomic increment。这些增量是 fire-and-forget:其结果仅由后续的 periodic threshold refresh 消费,从不消费在 critical path 上,因此不阻塞主执行流。
Threshold Refresh(阈值刷新): 随着 histogram 的增长,门控可以收紧超过其初始化值。周期性地在 producer 完成所有 fetch command 后的空闲 warp 中,从最高 bin 向下累积 histogram 计数直到累计数量达到 ,重新计算阈值 bin,并以纯 overwrite write 方式发布(而非 atomic update)。这不需要同步,因此保持 GPU 上现有的并行执行顺序。过时的阈值只是放宽门控, admit 一些额外候选,但在 score concentration 下这种情况很少。阈值维护完全 off the critical path,隐藏在空闲周期中。
Top- Selection(选择阶段): 评分过程完成后,所有 surviving candidates 驻留在 candidate buffer 中连同其 bin-space scores,final threshold bin 已知。根据 refresh rule,threshold bin 上方的 bins 联合包含少于 个候选。这些候选直接写入输出。剩余位置由限制在 threshold bin 内的候选者的尾部选择填充,其数量在 score concentration 下很小。原始分数通过逆仿射映射从存储的 bin-space 值恢复。相比在全部 个物化 score 上运行完整 radix select 的解耦方案,LiteTopK 仅在 threshold bin candidates 之间进行选择,大幅降低了选择成本。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Sample 模块 | 复用前 chunk 的 top-k 高频 token 作为当前 chunk 的采样 | , DSA 中 |
| Bin 分区器 | 将估计的 范围划分为 个等宽 bins | 用于高效 bin ID 计算 |
| Histogram | 统计每个 bin 中的候选者数量,用于动态更新阈值 | 通过 overwrite write 更新(无锁操作) |
| Filter 门控 | 候选者仅当 bin ID threshold bin ID 时通过 | 由空闲 warp(producer)异步刷新 |
| Candidate Buffer | Shared-memory 中的候选者缓冲区,warp-level 批量刷写 | 保守容量 12k = 24,576 candidates |
| Threshold Refresh | 空闲 warp 周期性从 histogram 重建阈值 | 纯 overwrite 写入,无需同步 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首次利用维度灾难 | 首次观察并刻画稀疏注意力中的距离集中现象,追溯到高维空间的维度灾难,并利用此属性改进稀疏注意力内核设计 | DSA 分数在 25-35 之间集中, 的分数仅约 10K 个 |
| 首个 Indexer-TopK 融合内核 | 提出 LiteTopK — 首个 indexer-TopK 融合内核,大幅减少 write-back 内存压力,相比最快的 DSA 内核实现 1.24x 加速 | DSA 产生 32GB 内存开销;LiteTopK 避免 score-logit 物化 |
| 端到端性能提升 | 在 8xB200 GPUs 真实部署中,LiteTopK 在 GLM-5.2 上实现 1.2x 端到端加速并使用更少内存 | 128.4s vs 153.3s, 1.5GB vs 2.0GB 辅助内存 |
五、代码实现分析
LiteTopK 使用 CUDA C++ 实现,基于 CuTe/CUTLASS 库。对比基线使用官方实现:
- DSA baseline: https://github.com/deepseek-ai/DeepGEMM — 自定义 CUDA kernel 用于 score computation + PyTorch
topk操作 - vLLM baseline: Blackwell 架构优化版,替换 PyTorch
topk以减少不必要 I/O 流量 - 源码地址: https://github.com/Heisenberg-Yin/LiteTopK
六、实验结果
实验设置
评估概览: 围绕两个应用领域组织评估:
- 长上下文 LLM serving:首先在端到端 GLM-5.2 prefill 部署中评估 LiteTopK,然后隔离稀疏注意力内核来表征其在受控配置下的 latency 和 memory consumption
- 大规模向量检索:评估 LiteTopK 的收益是否超越稀疏注意力工作负载
End-to-End 部署: GLM-5.2 在 8 张 NVIDIA B200 GPU 上使用 vLLM 0.23,启用 8-way tensor parallelism 和 expert parallelism,torch.compile 和 CUDA graphs,开启异步调度,prefill chunk size=8,192。
Kernel Benchmark: 从 GLM-5.2 第一层注意力激活构建基准输入(Wikipedia 采样数据),上下文长度 256K/512K/768K/1M,chunk size 128-8192, 固定。报告处理 8,192 query tokens 的 aggregate kernel latency。
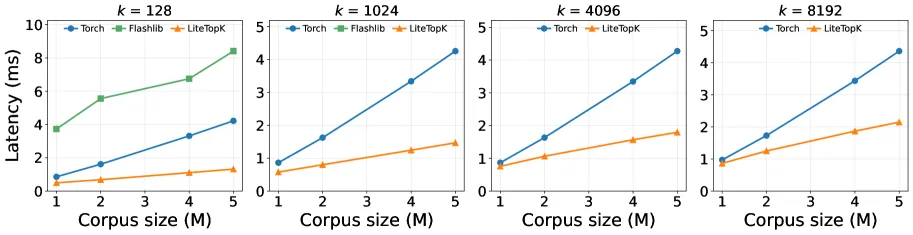
Large-Scale Retrieval: MSMARCO-V2.1 数据集,5M passages,768-dim vectors(Snowflake Arctic-embed-m-v1.5 编码),query set 随机采样 1,000 passages,corpus size 1M/2M/4M/5M,,batch size=64。与 FlashLib 对比。
硬件:NVIDIA B200(180 GB)和 H100,CUDA 12.8,CuTe/CUTLASS 实现。报告时间均为 20 次运行的平均值。
End-to-End 长上下文 Prefilling
在 8xB200 GPUs 上的 GLM-5.2 真实部署实验中(1M-token 上下文长度,chunk size=8,192):
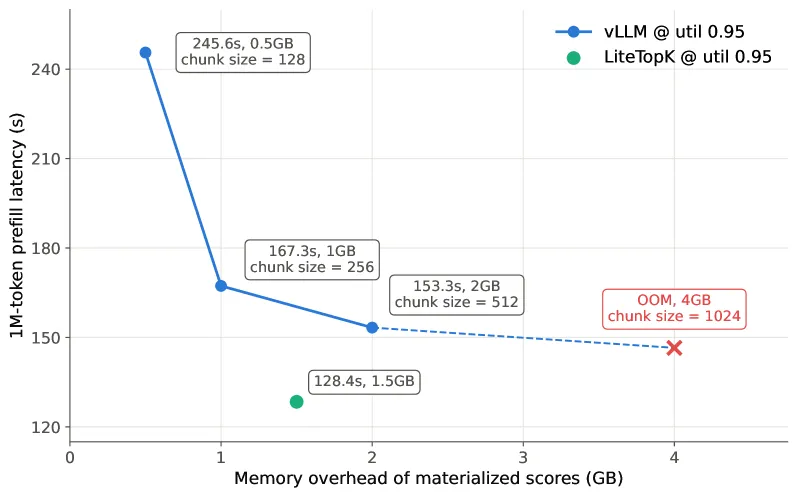
| 指标 | LiteTopK | vLLM Baseline | 改进 |
|---|---|---|---|
| Prefill 延迟 | 128.4 s | 153.3 s | 1.20x 加速 |
| 辅助内存消耗 | 1.5 GB | 2.0 GB | 25% 降低 |
Baseline 最快可行配置使用 sub-chunk size=512,需要 153.3s 处理 1M-token 输入,占用 2.0 GB 辅助内存。LiteTopK 避免了大中间 score logits 的物化,因此能以完整 8,192-token chunk 处理而无需 sub-chunking。
报告的 1.5 GB 内存包含保守的 candidate buffer(容量 12k = 24,576 candidates),实际保留的候选者通常远小于此容量。
Score 分布分析
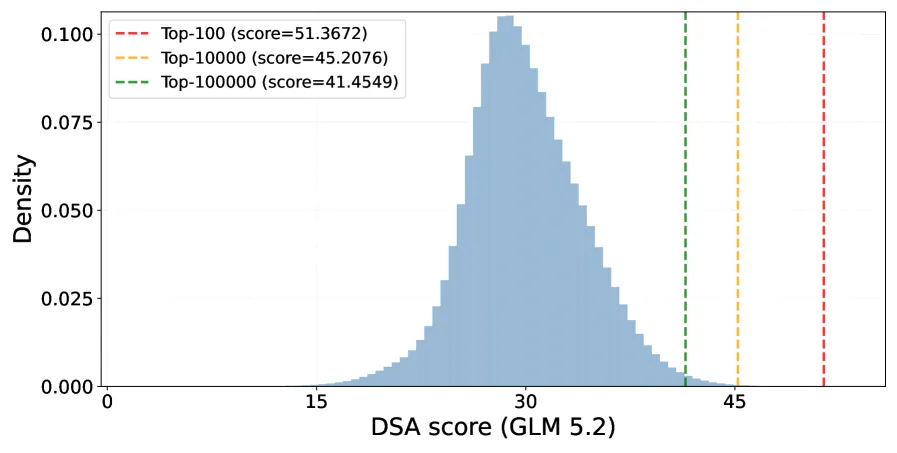
DSA 分数在第一层表现出强烈的集中特性:在 1M-token 上下文中,分数集中在 25 到 35 之间,而 的分数极为罕见(仅约 10K 个)。这种窄范围集中和长尾行为与高维空间的 curse of dimensionality 一致。
Runtime Breakdown
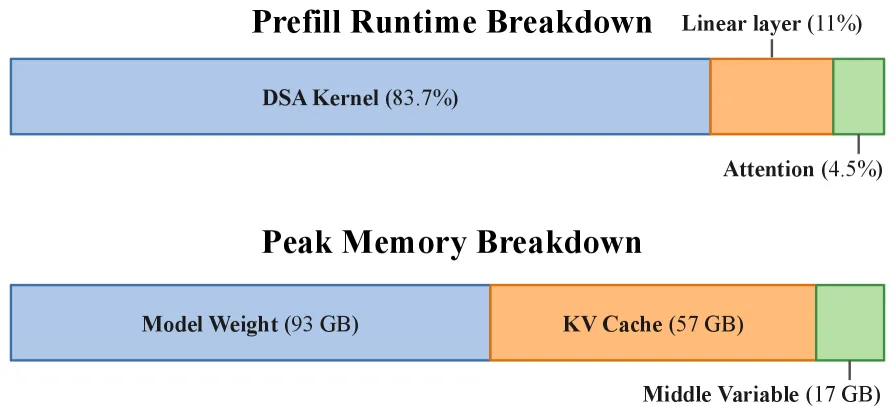
DSA kernel(包括 score computation 和 Top- selection)在 GLM-5.2 prefill 中占据主导地位,在 1M context length 下占总 runtime 的 83.7%。
Sparse-Attention Kernel Benchmark (NVIDIA B200)
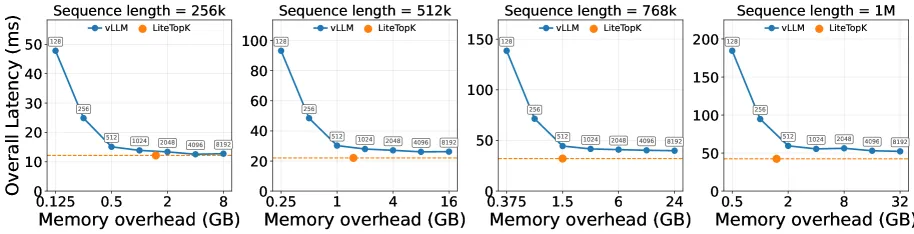
在 chunk size=8,192、context=1M 条件下:
| Kernel | 延迟 | 说明 |
|---|---|---|
| LiteTopK | 43.4 ms | 本文方法 |
| vLLM (Blackwell optimized) | 53.8 ms | 比 LiteTopK 慢 1.24x |
| DSA (official) | 146.6 ms | 比 LiteTopK 慢 3.38x |
当 vLLM 使用更实际的 chunk sizes 时:
- chunk size=512: 59.8ms → LiteTopK 相对加速 1.38x
- chunk size=1,024: 55.6ms → LiteTopK 相对加速 1.28x
Context Length 可扩展性
在 chunk size=8,192 固定条件下:
| Context Length | DSA 延迟 | LiteTopK 延迟 | Speedup |
|---|---|---|---|
| 256K | 36.6 ms | 12.6 ms | 2.90x |
| 512K | — | — | 介于 2.90x ~ 3.38x 之间 |
| 768K | — | — | 介于 2.90x ~ 3.38x 之间 |
| 1M | 146.6 ms | 43.4 ms | 3.38x |
性能优势随上下文长度增加而扩大,表明 LiteTopK 随着候选 token 数量的增长具有更好的可扩展性。
NVIDIA H100 可移植性
在 H100 GPU 上(chunk size=8,192),仅与官方 DSA 对比(vLLM Blackwell 优化不可用):
LiteTopK 在各评估的上下文长度上保持了类似的加速趋势,证明其收益不限于 Blackwell GPU 架构。
Large-Scale Retrieval (MSMARCO)
在 MSMARCO-V2.1 数据集上(5M passages, 768-dim embeddings),LiteTopK 与 FlashLib 对比:
FlashLib 的性能随 增加而急剧下降,因为其在 on-chip 结构中维持有序状态的成本增加。相比之下,LiteTopK 在 large- 配置下保持高效:
- FlashLib 在 时就明显慢于 LiteTopK
- 越大,性能差距越显著
- FlashLib 更适合 very small- 工作负载,而 LiteTopK 适用于大 配置
七、相关工作
稀疏注意力 (Sparse Attention)
- DSA (DeepSeek Sparse Attention): 原生训练的稀疏注意力模块,DeepSeek-V4 和 GLM-5.2 的基础。采用 score-then-select 范式。
- SparQ attention (Ribar et al., 2024): Salience channel approximation 近似 scores
- PQCache (Zhang et al., 2025): Product quantization-based KV cache
- Quest (Tang et al., 2024): Query-aware sparsity
- TidalDecode (Yang et al., 2025): Position persistent sparse attention in decoding
- 训练-free 方法通常引入不可忽视的精度下降
Top- Selection
GPU 上并行 top- 选择算法分为四类(Zhang et al., 2023 综述):
- Sorting-based: Radix sort (Huang et al., 2009)
- Partial-sorting: FAISS library (Douze et al., 2025), HNSW (Johnson et al., 2019)
- Partition-based: Quick multi-select (Komarov et al., 2014), KNN construction (Dashti et al., 2013)
- Hybrid methods: Dr. Top-K (Gaihre et al., 2021)
其中 radix select 被认为是最高效的方法之一,已被广泛采用(PyTorch、NVIDIA RAFT library)。但这些方法通常假设所有分数已在内存中显式物化。
近期工作 FlashLib (Yang et al., 2026) 探索了更 I/O 高效的方案——融合 score computation 和 top- selection。但其受限于有限的 per-block register 容量:仅在非常小的 值(如 )时高效。当 增加时效率急剧下降,不支持 ,限制了应用场景(DSA 常需检索 top-2,048 entries)。
八、总结
核心贡献
- 首次刻画稀疏注意力中的距离集中现象: 首次观察并刻画稀疏注意力中的距离集中现象,将其根源追溯至高维空间中的维度灾难(curse of dimensionality in high-dimensional spaces),并借此改进稀疏注意力内核设计。
- 提出 LiteTopK — 首个 Indexer-TopK 融合内核: 首个 indexer-TopK 融合内核,大幅减少 write-back 内存压力,相比最快的 DSA kernel 实现 1.24x 加速。核心理念可扩展到其他稀疏注意力内核。
- 真实部署验证: 在 8xB200 GPU 部署中,LiteTopK 在 GLM-5.2 上实现 1.2x 端到端加速并使用更少内存。开源代码: https://github.com/Heisenberg-Yin/LiteTopK
技术影响
LiteTopK 的优化策略可直接集成到 vLLM 等 LLM serving 系统中,显著提升长上下文推理的效率。其避免 score-logit 物化的设计为未来研究提供了新的方向。
局限性与未来工作
- 目前主要关注 prefill 阶段,decode 阶段的集成是 promising 的未来方向
- 特别地,将其与 speculative decoding 结合是潜在的扩展路径
- 当前论文以 DSA 为主要对比基准,其他稀疏注意力方法的详细对比有待探索
九、参考资源
| 资源 | 链接 |
|---|---|
| arXiv 论文 | https://arxiv.org/abs/2607.11976 |
| HTML 版本 | https://arxiv.org/html/2607.11976v1 |
| PDF 版本 | https://arxiv.org/pdf/2607.11976 |
| 源代码 | https://github.com/Heisenberg-Yin/LiteTopK |
| DeepSeek Sparse Attention | https://github.com/deepseek-ai/DeepGEMM |
| vLLM | https://github.com/vllm-project/vllm |
| vLLM blog on DSA challenge | https://vllm.ai/blog/2025-09-29-deepseek-v3-2 |
| GLM-5 论文 | https://arxiv.org/abs/2602.15763 |
| Figure 1 | figures/litetopk/figure-1.png — Breakdown of GLM-5.2 Prefill Runtime and Peak Memory Usage Across 8 B200 GPUs |
| Figure 2 | figures/litetopk/figure-2.png — DSA Score Distribution of GLM 5.2’s First Layer during Prefill on Wiki Dataset |
| Figure 3 | figures/litetopk/figure-3.png — Illustration of the LiteTopK Kernel |
| Figure 4 | figures/litetopk/figure-4.png — Memory-overhead vs End-to-End Latency (1M Prefill, GLM-5.2-FP8, 8xB200) |
| Figure 5 | figures/litetopk/figure-5.png — Runtime Comparison on DSA and MSMARCO Workloads |
| Figure 6 | figures/litetopk/figure-6.png — Runtime Comparison on NVIDIA H100 GPUs |
| Figure 7 | figures/litetopk/figure-7.png — Additional performance comparison results |