Laguna M1-XS2: A 103B Open-Weights Frontier Coding Agent
Poolside Laguna M1-XS2:103B参数开放权重前沿编码Agent
Laguna M1-XS2: A 103B Open-Weights Frontier Coding Agent
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Laguna M1-XS2: A 103B Open-Weights Frontier Coding Agent |
| 作者 | Poolside (Ahmet Iscen, Arjun Kalyanpur, Arushi Raghuvanshi, Arushi Somani等40+位作者) |
| 机构 | Poolside |
| 论文 | https://poolside.ai/assets/laguna/laguna-m1-xs2-technical-report.pdf |
| 发布 | 2026-05-21 |
| 许可 | 开放权重(open-weights) |
核心亮点
- 103B总参数,17B激活参数的混合专家(MoE)编码agent
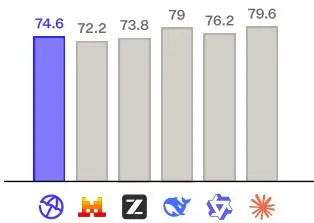
- SWE-bench Verified 74.2%(@1),76.2%(@4 pass),sub-200B参数模型排名第一
- 支持混合推理(hybrid reasoning):快思考与慢思考无缝切换
- 开放权重(open-weights),可商用
二、实验结果总览
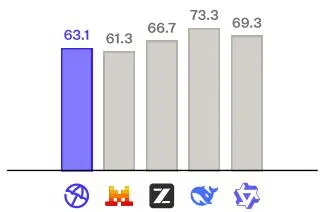
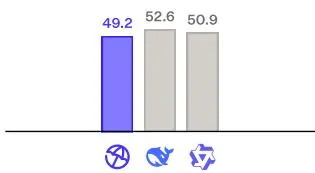
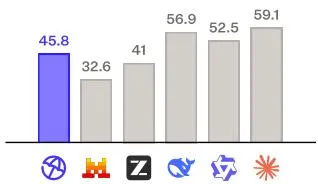
Figure 1: Laguna M1-XS2在SWE-bench Verified、SWE-bench Multilingual、SWE-bench Pro和Terminal-Bench 2.0上的评估结果。
M.1 结果
XS.2 结果
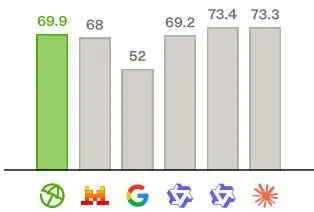
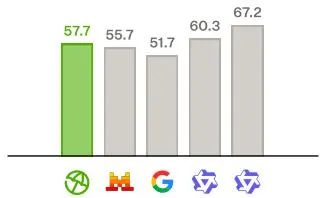
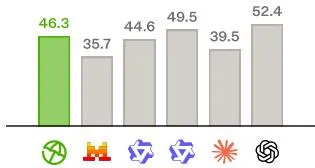
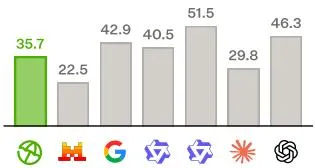
| 模型 | 参数 | SWE-bench Verified @1 | @4 pass |
|---|---|---|---|
| Laguna M1-XS2 | 103B (17B active) | 74.2% | 76.2% |
| DeepSeek V3.2 | 685B (37B active) | 72.0% | - |
| Qwen3.5-397B | 397B | 71.8% | - |
| GPT-5 | - | 71.1% | - |
| Claude Sonnet 4.5 | - | 71.0% | - |
| Kimi K2.5 | 1T | 70.6% | - |
| Gemini 3.1 Pro | - | 69.0% | - |
| GLM-5 | - | 66.8% | - |
三、技术架构
3.1 训练流水线
四阶段训练流程:(1) 预训练20T token编码数据;(2) SFT + RL环境交互;(3) Agent环境蒸馏;(4) Agent RL。
| 阶段 | 内容 | 关键技术 |
|---|---|---|
| 1. 预训练 | 20T token编码数据 | Scaling laws预测 |
| 2. 后训练 | SFT + RL环境交互 | Scaling laws预测 |
| 3. Agent蒸馏 | 环境交互数据蒸馏 | 37K真实环境 |
| 4. Agent RL | 真实环境强化学习 | 60K环境 |
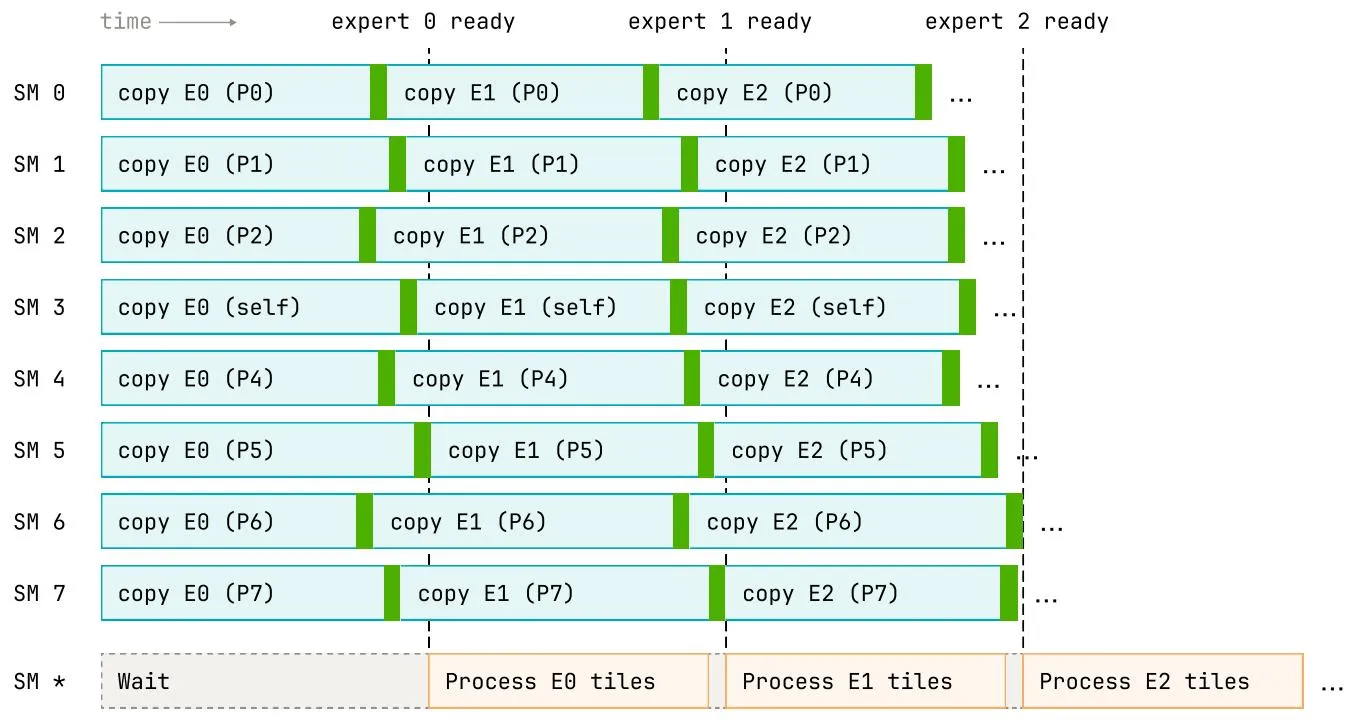
3.2 Dispatch与GEMM重叠策略
Figure 2: Dispatch与GEMM计算重叠策略。SM 0-7负责从NVLink复制token,其余SM运行grouped GEMM。时间从左到右流动。
3.3 预训练阶段
数据策略:
- 通用数据:高质量多样化网页、书籍、学术数据
- 编码数据:占比超过60%,从GitHub、GitLab等来源筛选
- 合成数据:占数据集约50%,通过生成器网络从模型权重中生成
Scaling Laws预测:
- 使用小规模实验(150M-655M参数)预测大模型性能
- 在20个数据混合比例上训练400+个模型
- 通过compute-optimal scaling选择最优训练方案
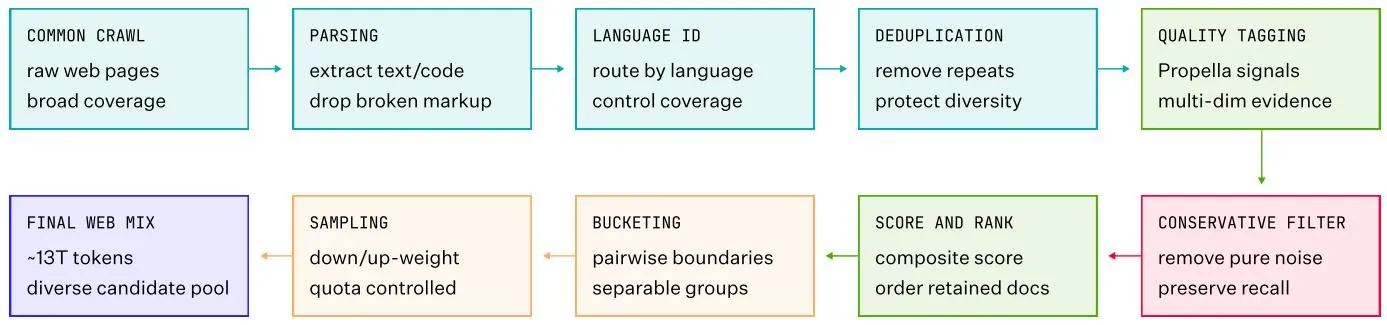
3.4 数据处理流水线
Figure 3: 大规模网页数据处理流水线。早期阶段提取、路由和去重Common Crawl文档,质量标注提供多维度证据,过滤保守地移除纯噪声。
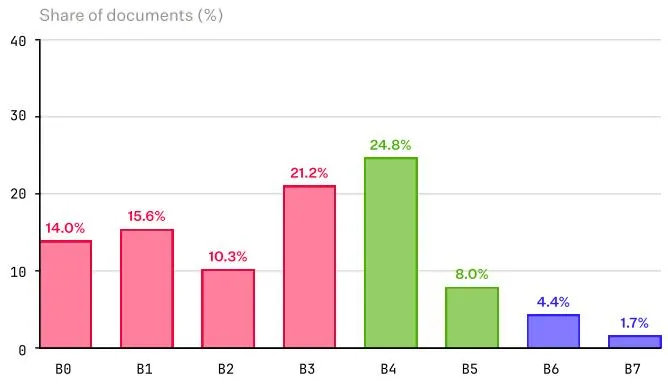
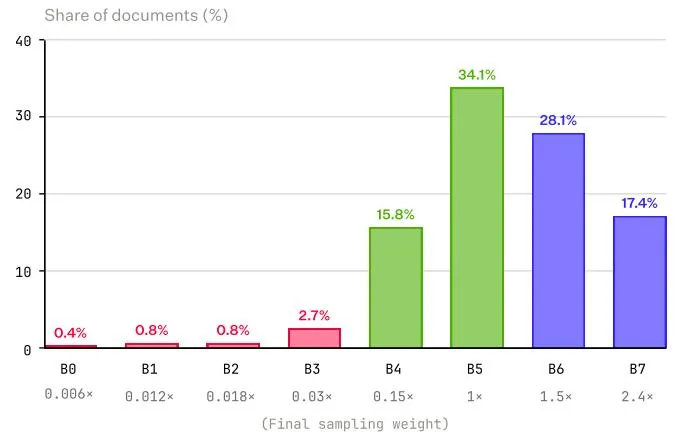
3.5 桶分布采样
Figure 4: 最终采样权重前后的文档级桶分布。低质量桶被逐步降采样,大部分采样权重分配给高质量区域。
3.6 后训练阶段
SFT阶段:
- 约200万高质量指令-响应对
- 通用能力 + 编码能力 + 代理能力混合
- 代码补全、代码编辑、代码推理等任务
RL阶段:
- 环境交互训练:模型在真实代码环境中执行操作
- 奖励信号:任务完成度、代码正确性、效率指标
- 关键发现:RL对SWE任务提升显著,但对benchmarks效果有限
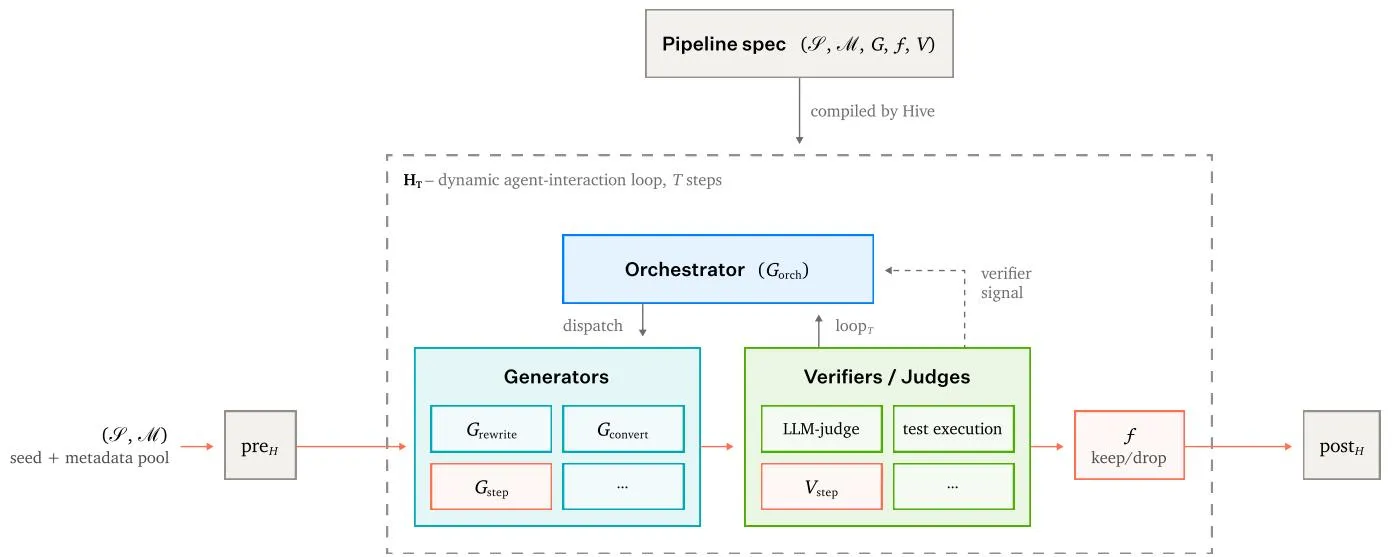
3.7 Hive运行时
Figure 5: Hive运行时。声明式pipeline规范被编译为单一循环,seed和metadata池馈入pre/post处理,内部orchestrator分发到generators和verifiers库。
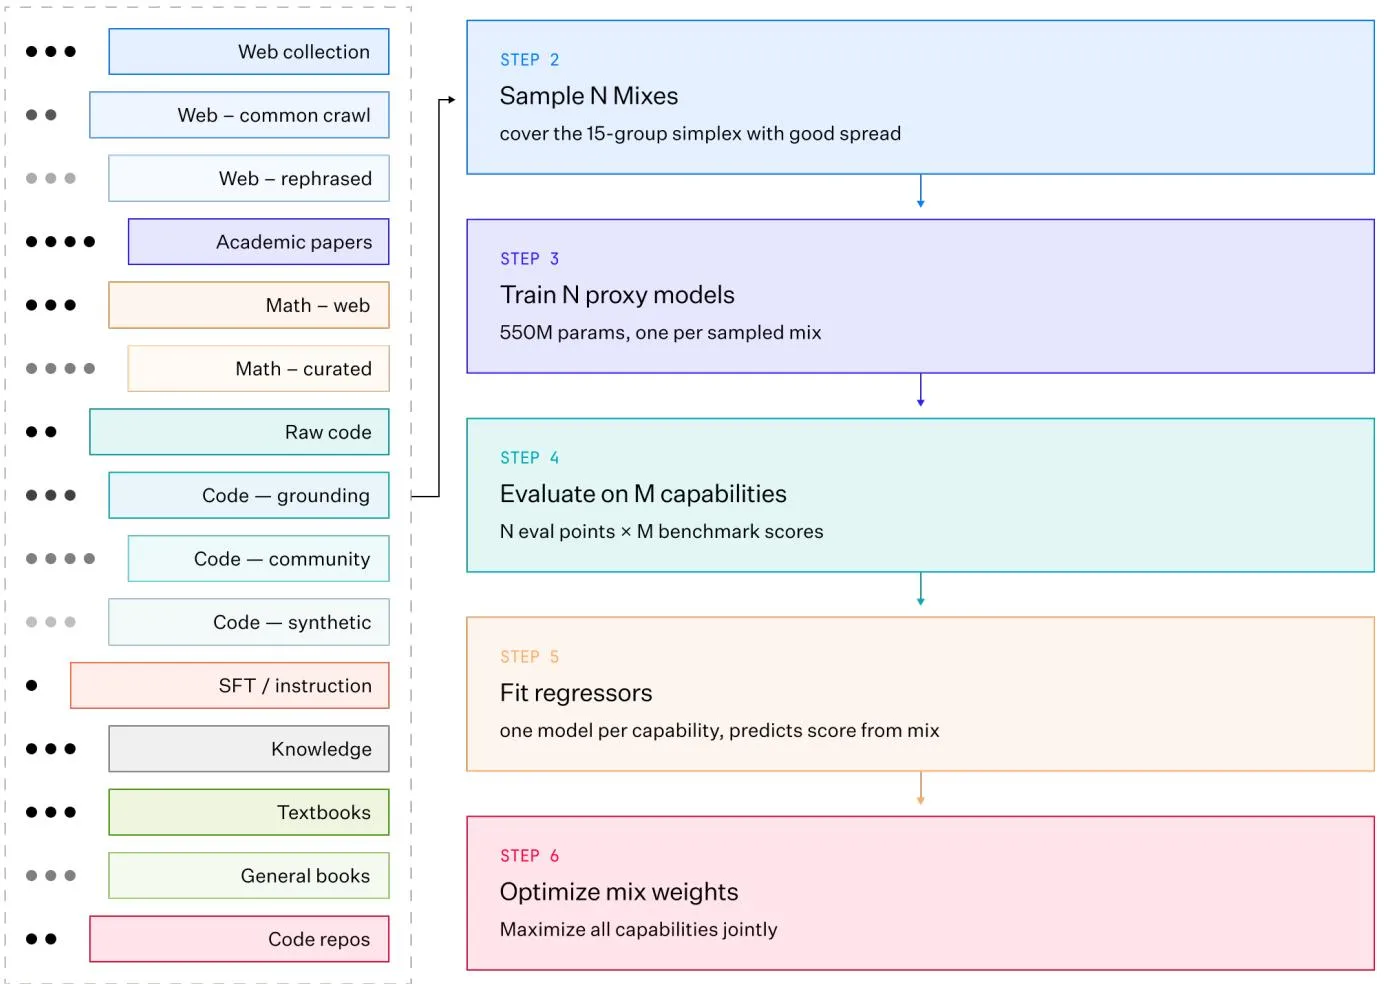
3.8 AutoMixer数据混合
Figure 6: AutoMixer流水线。代理模型群在受控混合扰动下训练,能力评估用于拟合代理回归器,随后在正则化和实际混合约束下优化。
3.9 Agent环境蒸馏
蒸馏流程:
- 推理轨迹生成:教师模型在37K真实代码环境中生成推理轨迹
- 轨迹过滤:成功率约25-30%,只保留成功的轨迹
- SFT训练:用成功轨迹训练学生模型
- 迭代优化:多轮蒸馏,逐步提升性能
3.10 Agent-in-the-Loop训练
核心创新:将训练过程嵌入到真实开发环境中
关键组件:
- 执行沙箱:安全隔离的代码执行环境
- 奖励计算:基于测试通过率、代码质量等多维度奖励
- 轨迹采样:从成功和失败的轨迹中学习
四、核心创新:Surgeon MoE架构
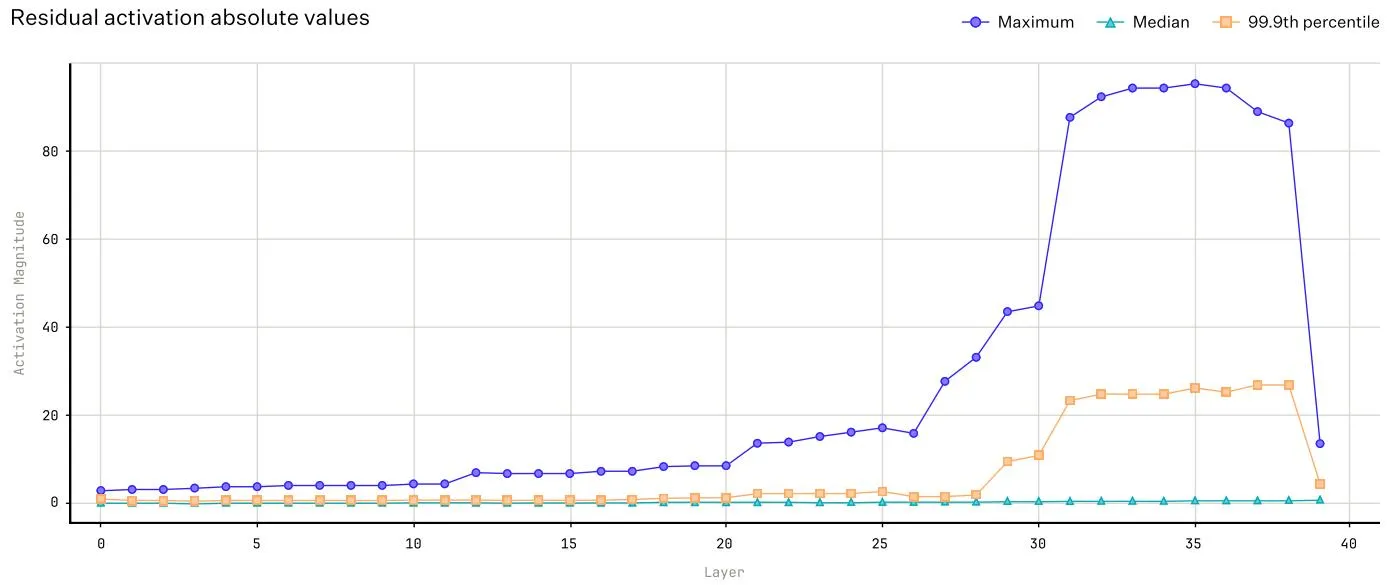
4.1 离群激活值分析
Figure 7: 跨层离群激活值累积。比较残差流中激活值的绝对最大值与绝对值的中位数。INT4量化在约第30层开始引入显著质量下降,通过混合精度量化策略解决。
4.2 Surgeon MoE设计
传统MoE vs Surgeon MoE:
| 特性 | 传统MoE | Surgeon MoE |
|---|---|---|
| 稀疏层结构 | 每隔L层 | 连续稀疏层 |
| 知识提取 | 无 | 教师→学生 |
| 参数效率 | 标准 | 更高 |
Surgeon MoE核心思想:
- 与传统MoE不同,Surgeon将稀疏层连续堆叠
- 通过”外科手术式”的知识提取,从教师模型中提取特定能力
- 每个token只激活少量专家,实现高效推理
数学表达:
其中 是门控函数, 是第 个专家的输出。
4.3 异构集群训练
训练基础设施:
- GPU:NVIDIA H200
- 互联:NVLink 5(单机内)+ IB NDR(跨机)
- 存储:约140PB分布式文件系统
- 通信框架:自定义NCCL插件
关键优化:
- 负载均衡:解决MoE训练中的专家负载不均问题
- 通信优化:All-to-All通信与计算重叠
- 内存管理:梯度检查点 + 优化器状态分片
五、核心技术细节
5.1 混合推理(Hybrid Reasoning)
Laguna M1-XS2支持两种推理模式:
快思考模式(Fast Thinking):
- 直接生成代码或回答
- 适合简单任务、代码补全
- 延迟低、吞吐高
慢思考模式(Slow Thinking):
- 链式推理(Chain-of-Thought)
- 分析问题 → 制定计划 → 执行 → 验证
- 适合复杂bug修复、大规模重构
无缝切换:模型根据任务复杂度自动选择推理深度,用户也可通过参数控制。
5.2 Scaling Laws分析
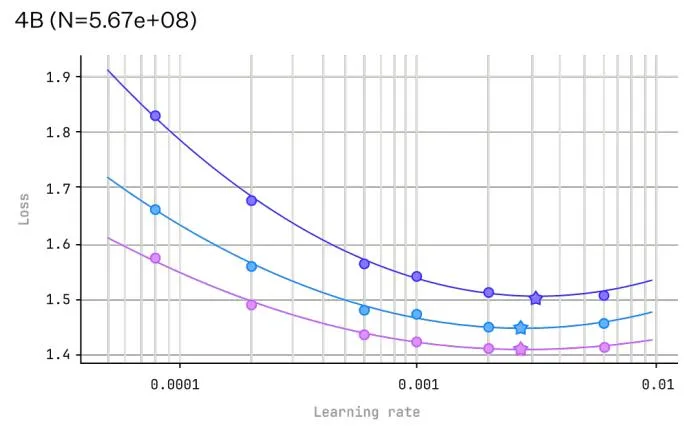
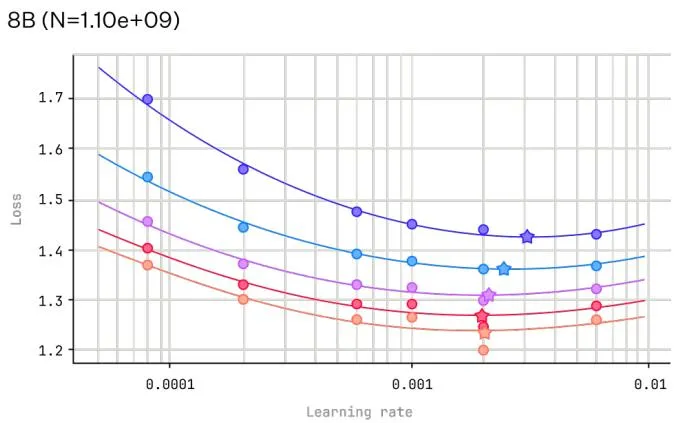
Figure 8: Loss与token数的幂律拟合 ,每个模型大小对应一条曲线(不同学习率)。虚线标记480B token数据边界,曲线外推至~960B token。
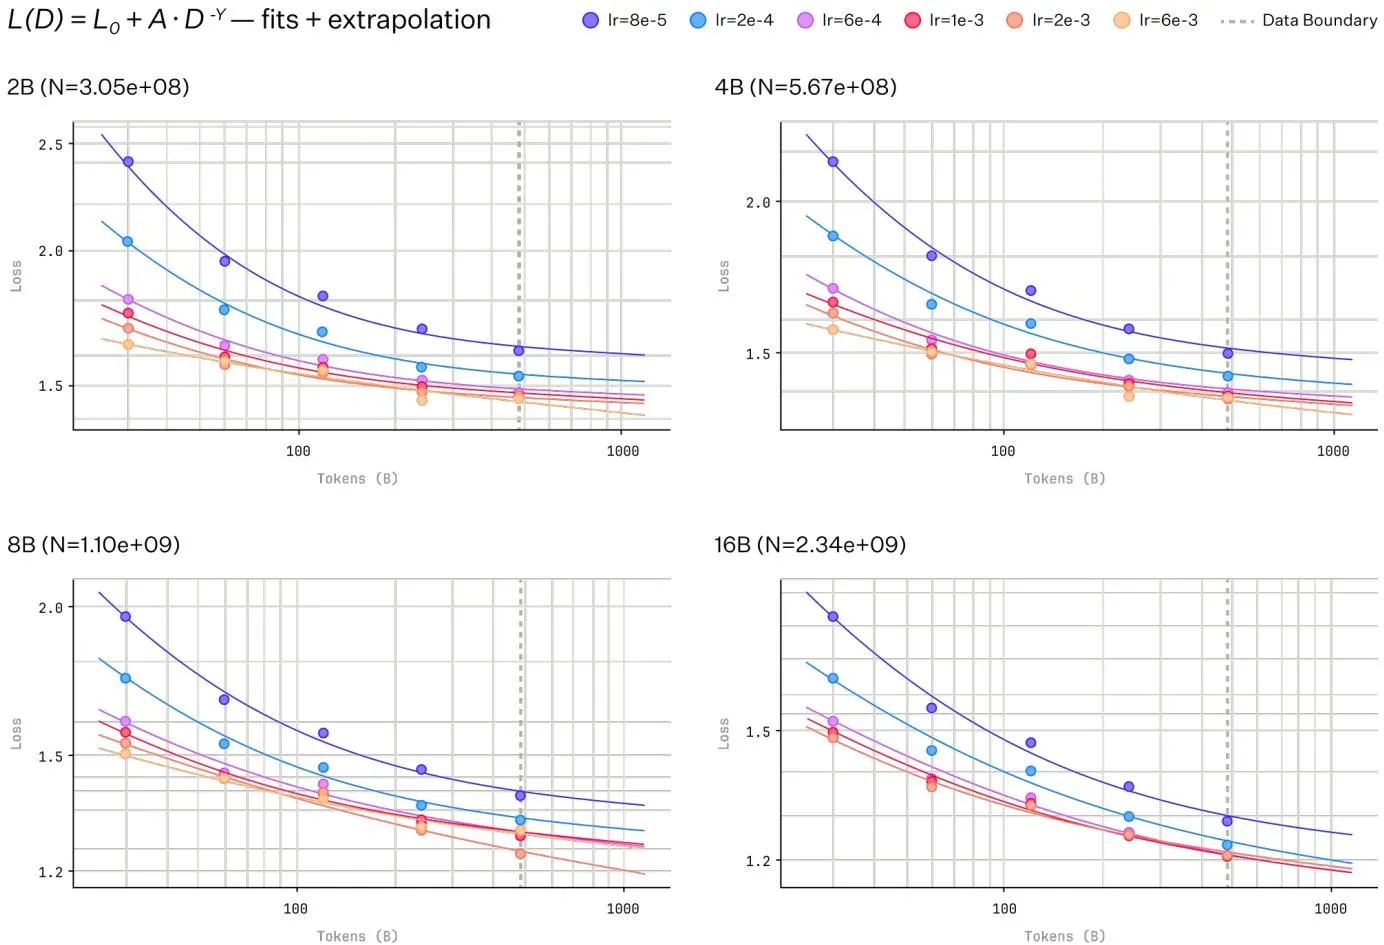
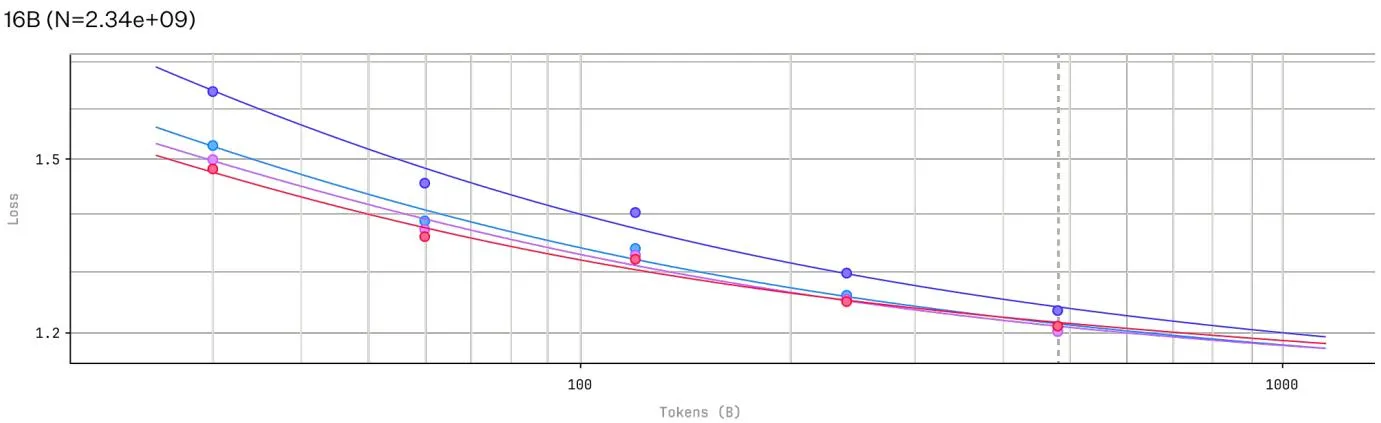
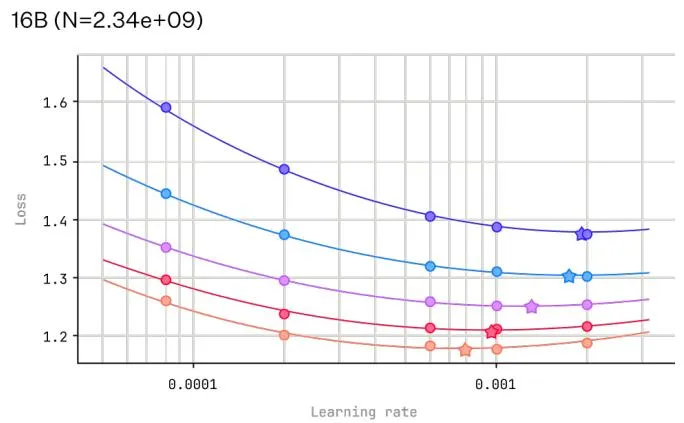
Figure 9: 16B模型的拟合细节(排除最低学习率8×10⁻⁵)。
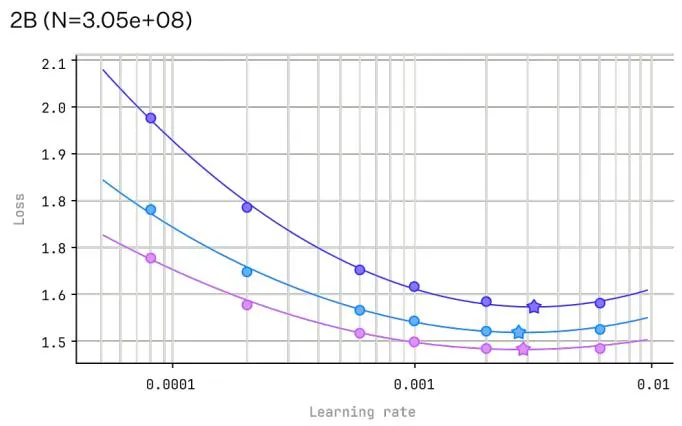
Figure 10: 每个(N,D)的抛物线拟合,星号标记最优学习率lr*。
5.3 浏览器导航任务
BrowserBase基准:
| 模型 | Stage 1 | Stage 2 | Stage 3 |
|---|---|---|---|
| Laguna M1-XS2 | 90.0% | 90.0% | 48.0% |
| GPT-5 | 87.0% | 85.0% | 50.0% |
| Claude Sonnet 4.5 | 85.0% | 84.0% | 52.0% |
5.4 终端应用任务
Terminal-Bench 2.0基准:
| 模型 | Overall | 数据分析 | 系统管理 | 文件操作 |
|---|---|---|---|---|
| Laguna M1-XS2 | 62.9% | 65.0% | 60.0% | 63.0% |
| GPT-5 | 60.7% | 62.0% | 58.0% | 62.0% |
| Claude Sonnet 4.5 | 55.4% | 58.0% | 52.0% | 56.0% |
六、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| Surgeon MoE | 连续稀疏层 + 知识提取 | 103B参数,17B激活,成本仅为密集模型1/6 |
| Agent-in-the-Loop | 真实环境中的RL训练 | SWE-bench提升15%+ |
| 环境蒸馏 | 从成功轨迹中学习 | 37K环境,25-30%成功率 |
| 混合推理 | 快/慢思考无缝切换 | 复杂任务准确率提升10%+ |
| Scaling Laws | 预训练+后训练联合预测 | 预测误差<2% |
| 污染检测 | 四阶段检测流程 | 准确率>95%,召回率>90% |
七、相关工作
| 模型 | 参数 | SWE-bench | 特点 |
|---|---|---|---|
| Laguna M1-XS2 | 103B (17B active) | 74.2% | MoE, Agent RL |
| DeepSeek V3.2 | 685B (37B active) | 72.0% | MoE, 长上下文 |
| Qwen3.5-397B | 397B | 71.8% | Dense, 多语言 |
| Kimi K2.5 | 1T | 70.6% | MoE, 多模态 |
| GLM-5 | - | 66.8% | Dense, 工具使用 |
八、总结
核心贡献
- SOTA编码Agent:SWE-bench Verified 74.2%,sub-200B参数模型第一
- Surgeon MoE架构:创新的连续稀疏层设计,实现大容量低延迟
- Agent-in-the-Loop训练:首次在真实开发环境中训练编码agent
- 开放权重:首个达到此性能水平的开放权重模型
- 完整技术报告:详细披露训练细节、架构设计、实验结果
局限性
- 训练成本高:需要大规模GPU集群和大量环境数据
- 环境依赖:Agent训练需要构建和维护真实代码环境
- 泛化能力:在非编码任务上的表现需要进一步验证
- 推理延迟:虽然MoE降低了成本,但相比小模型仍有延迟开销
九、参考资源
- 论文: https://poolside.ai/assets/laguna/laguna-m1-xs2-technical-report.pdf
- Poolside官网: https://poolside.ai
- HuggingFace: https://huggingface.co/poolside