KVFlow: Efficient Prefix Caching for Accelerating LLM-Based Multi-Agent Workflows
面向LLM多智能体工作流的高效前缀缓存管理框架,通过Agent Step Graph和工作流感知驱逐策略实现最高2.19倍加速
KVFlow: Efficient Prefix Caching for Accelerating LLM-Based Multi-Agent Workflows
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | KVFlow: Efficient Prefix Caching for Accelerating LLM-Based Multi-Agent Workflows |
| 作者 | Zaifeng Pan, Ajjkumar Patel, Yipeng Shen, Zhengding Hu, Yue Guan, Wan-Lu Li, Lianhui Qin, Yida Wang, Yufei Ding |
| 机构 | UCSD、AWS |
| 论文 | arXiv:2505.xxxxx |
| 硬件 | NVIDIA H100 (80GB), PCIe Gen5 |
| 领域 | LLM推理系统、多智能体工作流优化 |
二、核心思想
问题定义
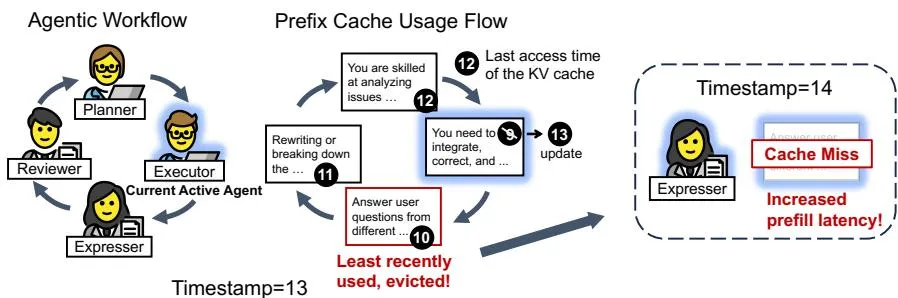
Figure 1: 循环智能体工作流中LRU驱逐策略的问题示例
基于LLM的智能体工作流(Agentic Workflow)通过协调多个专业化智能体来解决复杂任务。现有LLM推理系统使用前缀缓存(Prefix Caching)来复用智能体固定提示词的KV张量,但采用LRU(最近最少使用)驱逐策略存在根本性缺陷:
| 问题 | 描述 | 影响 |
|---|---|---|
| 无法预测未来使用 | LRU仅基于历史访问时间,无法预知即将执行的智能体 | 频繁的缓存未命中 |
| 提前驱逐 | 即将被复用的KV缓存可能因长时间未访问而被驱逐 | 大量重计算开销 |
| 动态后缀保留 | 最近执行的智能体生成的动态后缀(不太可能被复用)反而被保留 | 浪费宝贵的GPU内存 |
核心问题:在多智能体工作流中,LRU策略导致即将执行的智能体KV缓存被错误驱逐,造成不必要的重计算和延迟。
解决方案概述
KVFlow是一个工作流感知的KV缓存管理框架,通过两个关键机制解决上述问题:
- 工作流感知驱逐策略:基于Agent Step Graph预测智能体执行顺序,优先驱逐距离执行较远的智能体KV缓存
- 全重叠KV预取机制:利用工作流信息提前从CPU加载即将执行的智能体KV缓存,消除缓存未命中的停顿
关键创新:
| 组件 | 功能 | 效果 |
|---|---|---|
| Agent Step Graph | 抽象智能体执行依赖关系 | 统一表达多种工作流结构 |
| Steps-to-Execution | 计算每个智能体距离执行的步数 | 指导驱逐决策 |
| 节点级驱逐优先级 | 在缓存树节点级别分配驱逐优先级 | 共享前缀的精细管理 |
| 全重叠预取 | 后台线程异步加载 + 状态感知调度 | 隐藏CPU-GPU传输延迟 |
三、技术架构
整体框架
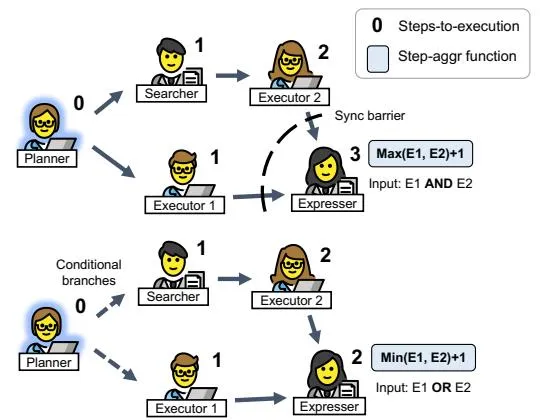
Figure 2(a): 两种不同Agent Step Graph中智能体的steps-to-execution值
KVFlow在SGLang v0.4.4基础上实现,扩展了radix树缓存机制以支持工作流感知驱逐和全重叠预取。
Agent Step Graph与Steps-to-Execution
Agent Step Graph抽象:
Agent Step Graph是一个灵活的抽象,捕获智能体之间的执行依赖关系,支持多种工作流结构:
| 工作流类型 | 步骤聚合函数 | 示例 |
|---|---|---|
| 同步屏障(AND) | max(E1, E2) + 1 | Expresser等待两个Executor都完成 |
| 条件分支(OR) | min(E1, E2) + 1 | Expresser在任一Executor完成后触发 |
Steps-to-Execution计算:
通过递归应用步骤聚合函数,Agent Step Graph能够在任意多智能体工作流中统一计算每个智能体的steps-to-execution值。该值表示智能体距离下次执行的预期步数。
工作流感知驱逐策略
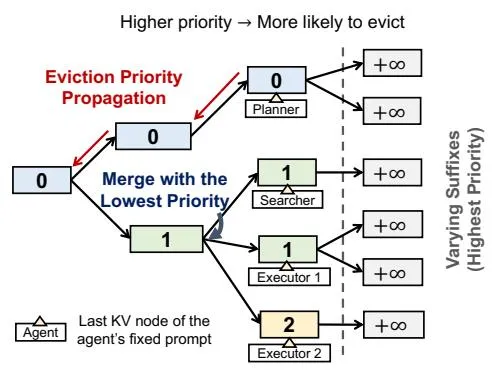
Figure 2(b): 缓存树中每个KV节点的驱逐优先级分配
驱逐优先级分配算法:
Algorithm 1: PriorityAssign(ASG)
  for step, agent in ASG:
    node = agent.last_fixed_prompt_node
    while node != root:
      node.counter[step] += 1
      node.priority = min(node.priority, step)
node = node.parent驱逐过程:
Algorithm 2: Evict(tree_cache, required)
  leaves = get_leaf_nodes(tree_cache)
  heapify(leaves)  // 基于priority构建最大堆
  while free_gpu_memory < required:
    node = heappop(leaves)
    free_gpu_memory += evict(node)
    if node.parent becomes a leaf:
heappush(leaves, node.parent)关键设计决策:
| 决策 | 说明 | 理由 |
|---|---|---|
| 仅分配固定提示词部分 | 动态后缀获得最高驱逐优先级 | 动态内容不太可能被复用 |
| 节点级优先级 | 而非智能体级别 | 共享前缀需要精细管理 |
| 最小值传播 | 共享节点取子节点中最小优先级 | 确保只要有智能体近期需要就保留 |
| 多工作流冲突解决 | 选择最低(最保守)优先级 | 跨工作流的共享节点管理 |
全重叠KV预取
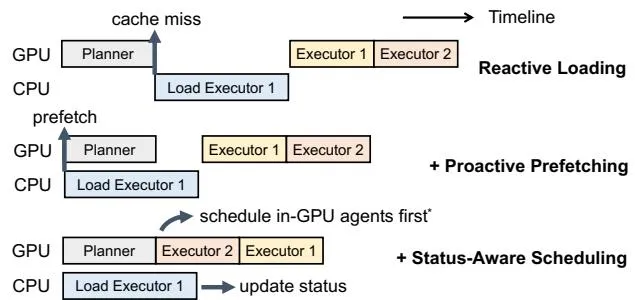
Figure 3: 全重叠KV预取机制示意图
三层优化:
| 层级 | 机制 | 说明 |
|---|---|---|
| 反应式加载 | 基线 | 智能体调度时才开始加载KV |
| 主动预取 | 利用Step Graph预测 | 后台线程提前加载即将执行的智能体KV |
| 状态感知调度 | 跳过加载中的请求 | 优先调度KV已在GPU的智能体 |
预取细节:
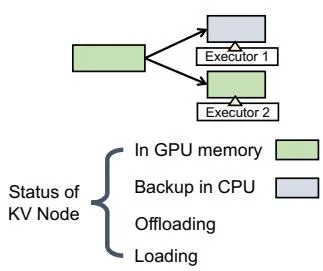
Figure 3(b): 预取过程的详细时间线
缓存节点状态:
| 状态 | 说明 | 调度行为 |
|---|---|---|
in GPU memory | KV在GPU内存中 | 可立即调度 |
backup in CPU | KV已备份到CPU | 需要加载 |
loading | 正在从CPU加载到GPU | 跳过,等待完成 |
offloading | 正在从GPU卸载到CPU | 排除在驱逐决策之外 |
关键优势:
- PCIe支持全双工传输,KV加载与token生成输出不冲突
- 当工作流包含分支时,保守地预取所有可能执行的下一个智能体
- 预取未命中时不会浪费带宽,因为传输仅在活跃计算期间进行
实现细节
步骤信息捕获:
- 假设每个
sgl.function对应一个独立智能体 - 执行时进行即时替换,将工作流元数据嵌入HTTP请求
- 元数据包括:当前智能体身份、所有智能体的steps-to-execution
提示词分割:
- 方案一:用户显式标记固定部分结束位置
- 方案二:启发式方法,跟踪缓存命中历史,将一致命中的前缀视为固定部分
- 自适应机制:如果固定提示词节点超过阈值周期未被复用,自动移除
客户端跟踪:
- 为每个应用分配唯一客户端ID
- 避免不同工作流中同名智能体的命名冲突
四、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| Agent Step Graph | 灵活抽象智能体执行依赖 | 支持条件分支、同步屏障等多种结构 |
| Steps-to-Execution | 预测智能体距离执行的步数 | 指导驱逐决策的基础 |
| 节点级驱逐优先级 | 缓存树节点级别的精细管理 | 共享前缀的高效复用 |
| 全重叠KV预取 | 主动预取 + 状态感知调度 | 消除缓存未命中的停顿 |
| 工作流感知 | 利用工作流结构信息优化系统 | 首个工作流语义驱动的系统级优化 |
与现有方法的关键区别:
| 方法 | 驱逐策略 | 预取机制 | 工作流感知 |
|---|---|---|---|
| SGLang | LRU | 无 | 否 |
| SGLang + HiCache | LRU | 反应式加载 | 否 |
| vLLM | LRU | 无 | 否 |
| KVFlow | Steps-to-Execution | 全重叠预取 | 是 |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 模型 | Qwen2.5-32B, Llama-3.1-8B |
| GPU | NVIDIA H100 (80GB), PCIe Gen5 (64 GB/s) |
| 基线 | SGLang (GPU-only), SGLang w/ HiCache, vLLM |
| 工作流 | 10阶段顺序工作流, PEER风格工作流 |
| 评估指标 | 端到端延迟, 加速比 |
| 解码 | 确定性解码 (temperature=0, greedy sampling) |
单工作流延迟
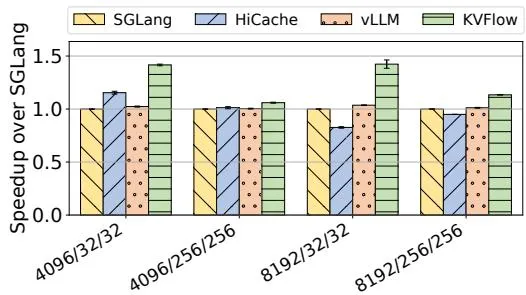
Figure 4(a): Qwen2.5-32B在H100上,branches=1(确定性顺序工作流)的加速比
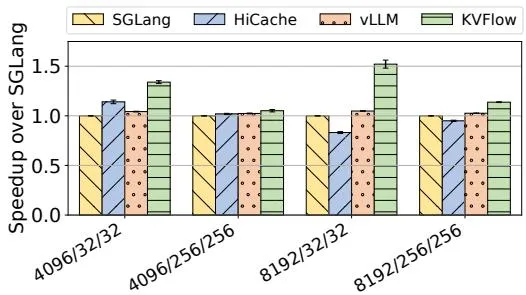
Figure 4(b): Qwen2.5-32B在H100上,branches=2(每个阶段随机选择两个智能体之一)的加速比
配置说明:横轴格式为 固定部分token / 动态部分token / 输出token
关键结果:
| 配置 | SGLang | HiCache | vLLM | KVFlow |
|---|---|---|---|---|
| 4096/32/32, branches=1 | 1.0× | 1.2× | 1.0× | 1.4× |
| 8192/32/32, branches=1 | 1.0× | 0.8× | 1.0× | 1.4× |
| 4096/32/32, branches=2 | 1.0× | 1.15× | 1.0× | 1.35× |
| 8192/32/32, branches=2 | 1.0× | 0.8× | 1.05× | 1.5× |
关键发现:
- KVFlow在所有设置下均实现最高加速比
- 固定前缀越长,KVFlow优势越明显(8192 vs 4096)
- 输出token越多,相对收益递减(解码延迟主导)
- HiCache在某些大上下文设置下性能反而下降
优化分解:
- 仅启用工作流感知驱逐:平均1.11倍加速
- 进一步启用全重叠预取:加速提升至1.29倍
开销分析:
- CPU端优先级分配和预取调度与GPU计算重叠,无暴露CPU开销
- 预取不干扰解码,因为token生成不涉及PCIe传输
- 未使用的预取KV不浪费带宽或内存
高并发工作流性能
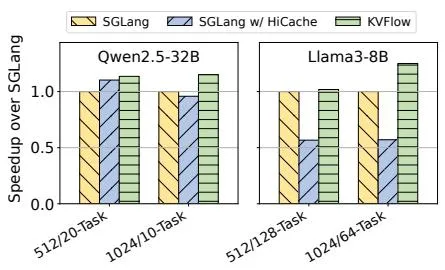
Figure 5: H100上不同固定提示词长度/并发数设置下的高并发工作流性能对比
关键结果:
| 设置 | SGLang | HiCache | KVFlow |
|---|---|---|---|
| Qwen2.5-32B, 512/20-Task | 1.0× | 1.1× | 1.15× |
| Qwen2.5-32B, 1024/10-Task | 1.0× | 0.95× | 1.15× |
| Llama3-8B, 512/128-Task | 1.0× | 0.55× | 1.0× |
| Llama3-8B, 1024/64-Task | 0.95× | 0.55× | 1.25× |
关键发现:
- KVFlow在所有高并发设置下均优于基线
- HiCache在高并发下表现特别差,甚至不如SGLang(0.55倍)
- vs HiCache最高加速:2.19倍(1024固定token,64并发工作流)
PEER风格真实工作流
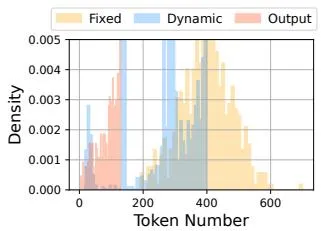
Figure 6: PEER风格工作流中固定、动态和输出部分的token分布
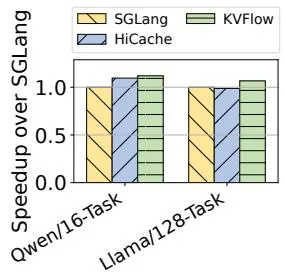
Figure 7: KVFlow在PEER风格多智能体应用上的加速比
关键结果:
- Qwen/16-Task:KVFlow实现1.1倍加速
- Llama/128-Task:KVFlow实现1.1倍加速
- 在真实部署场景中展现出强大的实际应用潜力
局限性
- 主要针对结构化智能体工作流,未来执行顺序可在一定程度上预测
- 对高度不可预测的工作流(无法推断未来执行),KVFlow退化为SGLang默认行为
- 退化时不会引入额外开销或正确性问题
六、相关工作对比
| 方法 | 类型 | 局限 | KVFlow优势 |
|---|---|---|---|
| SGLang | LLM推理引擎 | LRU驱逐,无工作流感知 | 工作流感知驱逐 + 预取 |
| vLLM | LLM推理引擎 | 块级LRU驱逐 | 细粒度节点级驱逐 |
| HiCache | CPU缓存扩展 | 反应式加载,高并发性能差 | 全重叠预取,状态感知调度 |
| InferCept | 工具调用优化 | 不考虑多智能体工作流 | 专门针对智能体工作流 |
| Autellix | 智能体调度 | 不考虑缓存管理 | 缓存管理与调度协同 |
| ParrotServe | 语义变量调度 | 不考虑缓存管理 | 工作流语义驱动优化 |
KVFlow的独特优势:
- 首个利用工作流语义优化LLM推理系统的工作
- 同时优化驱逐策略和预取机制
- 节点级精细缓存管理,支持共享前缀
- 全重叠预取消除缓存未命中的停顿
七、总结
核心贡献
- Agent Step Graph抽象:灵活捕获智能体执行依赖,支持条件分支、同步屏障等多种工作流结构
- Steps-to-Execution计算:通过步骤聚合函数预测智能体距离执行的步数
- 工作流感知驱逐策略:基于steps-to-execution的节点级驱逐优先级,替代LRU策略
- 全重叠KV预取:主动预取 + 状态感知调度,隐藏CPU-GPU传输延迟
- SGLang原型实现:在SGLang v0.4.4基础上实现,可推广到其他推理系统
性能指标
| 指标 | 数值 |
|---|---|
| 单工作流加速(大提示词) | 最高1.83倍 |
| 高并发工作流加速 | 最高2.19倍(vs HiCache) |
| 优化分解-仅驱逐 | 平均1.11倍 |
| 优化分解-驱逐+预取 | 平均1.29倍 |
| PEER真实工作流加速 | 最高1.12倍 |
| 额外开销 | 可忽略 |
技术影响
- 首次证明工作流语义可以用于系统级优化
- 揭示了LRU策略在多智能体工作流中的根本性缺陷
- 为LLM推理系统从通用优化向应用感知优化转变提供了范例
- 代码基于SGLang实现,可推广到vLLM等其他系统
未来方向
- 探索更复杂的动态工作流场景
- 与其他优化技术(推测解码、KV缓存稀疏化)的协同
- 分布式多GPU场景下的工作流感知缓存管理
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | LRU驱逐问题示例 | figure1-lru-problem.jpg |
| Figure 2a | Agent Step Graph示例 | figure2a-agent-step-graph.jpg |
| Figure 2b | 驱逐优先级分配 | figure2b-eviction-priority.jpg |
| Figure 3a | 全重叠预取概述 | figure3a-prefetch-overview.jpg |
| Figure 3b | 预取详情 | figure3b-prefetch-detail.jpg |
| Figure 4a | 加速比(branches=1) | figure4a-speedup-branches1.jpg |
| Figure 4b | 加速比(branches=2) | figure4b-speedup-branches2.jpg |
| Figure 5 | 高并发性能对比 | figure5-high-concurrency.jpg |
| Figure 6 | Token分布 | figure6-token-distribution.jpg |
| Figure 7 | PEER工作流加速比 | figure7-peer-speedup.jpg |