Robust KV Cache Management for LLM Serving under Output Token Length Uncertainty
A robust KV cache management framework using Wasserstein distributionally robust optimization (DRO) to jointly optimize GPU parallelism, cache reservation, request routing, and prefix caching under output token length uncertainty.
Robust KV Cache Management for LLM Serving under Output Token Length Uncertainty
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Robust KV Cache Management for LLM Serving under Output Token Length Uncertainty |
| 作者 | Jiaming Cheng, Duong The Do, Duong Tung Nguyen |
| 机构 | (未明确标注,从 arXiv 分类为 cs.NI) |
| 论文 | https://arxiv.org/abs/2607.16892 |
| 代码 | 未提供 |
| 发布 | 18 Jul 2026 |
| 许可 | 未明确 |
二、核心思想
问题定义
LLM 推理服务系统中,KV 缓存内存是 GPU 集群上的主要瓶颈。一个根本性挑战是:必须在请求到达时预留 KV 缓存,但输出 token 长度在生成完成前未知。预留不足会触发抢占(preemption),强制终止和重新计算请求,产生显著开销;预留过多则浪费内存,降低吞吐量。这形成了内存效率与抢占风险之间的核心权衡。
具体挑战包括:
- 工作负载异质性:不同应用类别的输出长度差异可达几个数量级(聊天数十 token、检索式 QA 数百、代码生成数千)
- 非平稳性:用户行为和流量分布随时间漂移
- 系统异构性:GPU 集群使用不同的张量并行(TP)和流水线并行(PP)配置
解决方案概述
本文提出一个鲁棒 KV 缓存管理框架,联合优化四个控制变量:
- GPU 并行度配置(tensor + pipeline parallelism)
- 每类别 KV 缓存预留量
- 请求路由到异构 serving groups
- 前缀缓存策略
核心创新是使用 Wasserstein 分布鲁棒优化(DRO) 处理输出长度不确定性和工作负载分布漂移,并提出可扩展的块坐标下降算法(BCD-DRO)。理论分析揭示了最优预留遵循临界分位数结构(critical fractile structure),自动适应不同抢占成本和内存成本比。
三、技术架构
整体框架
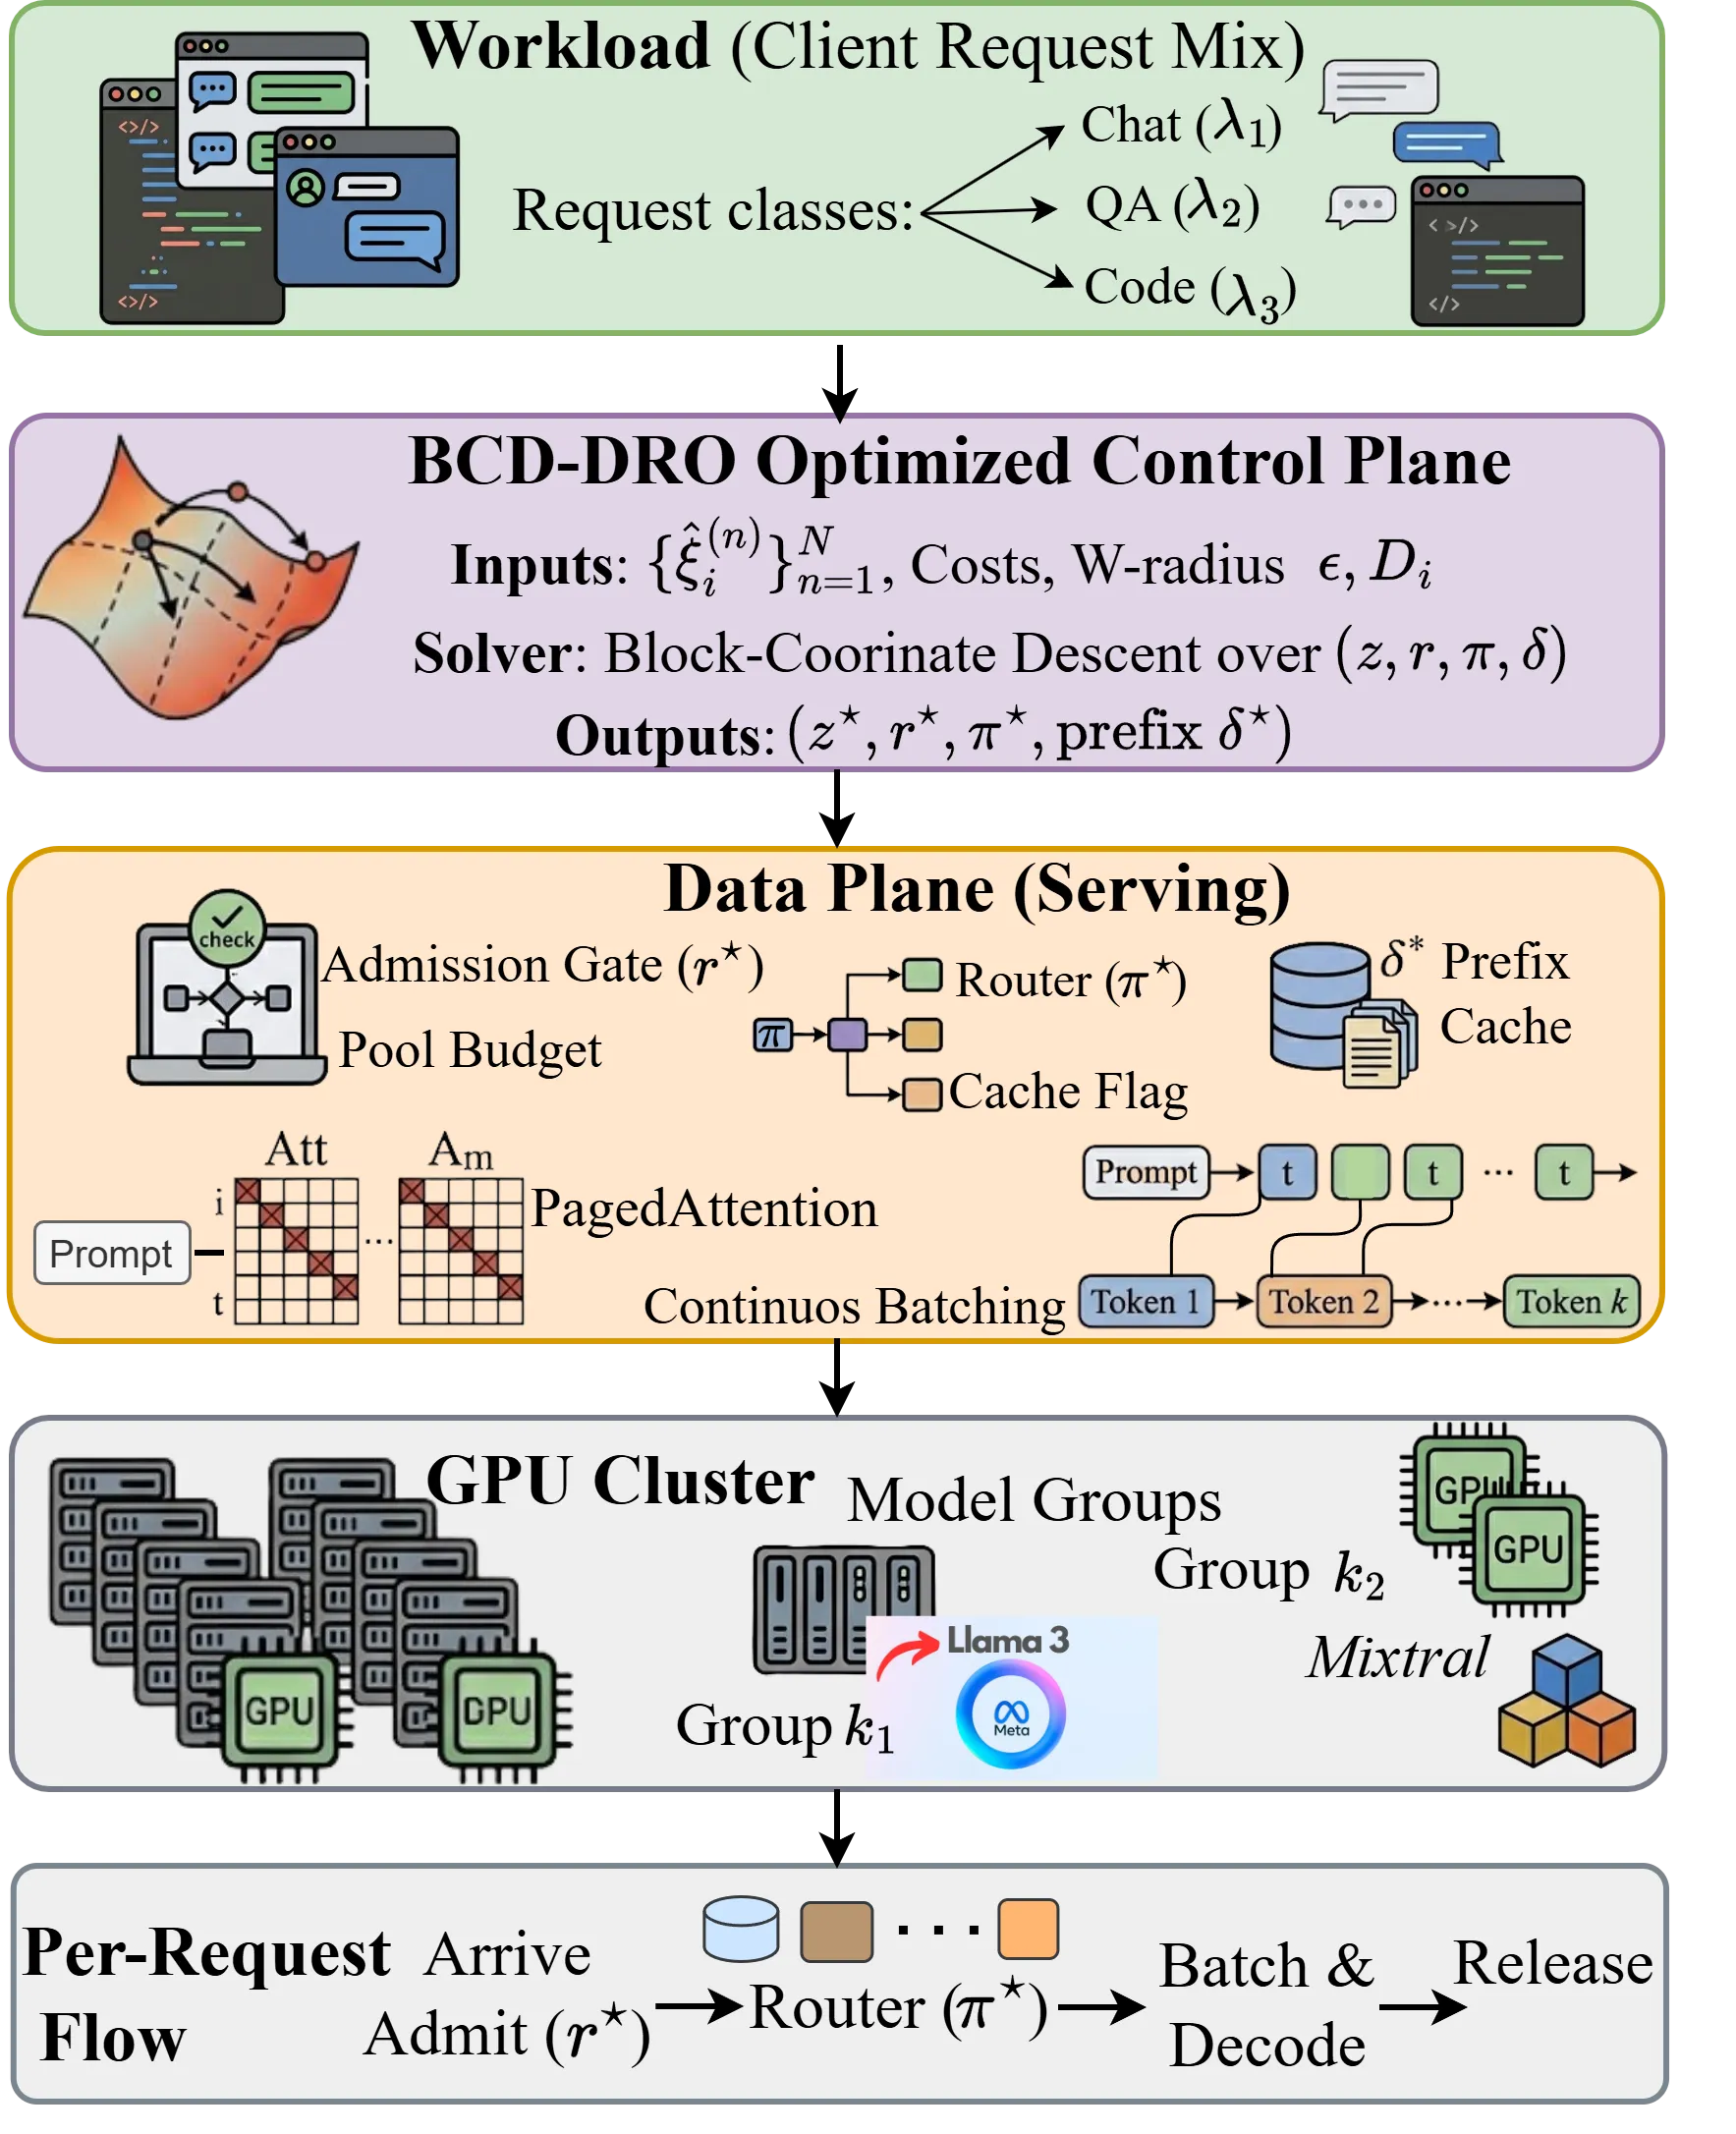
BCD-DRO 是一个控制平面策略,接收历史样本、成本参数和 Wasserstein 半径,在每个重优化周期产生四个控制变量 (z*, r*, pi*, delta*)。数据平面(PagedAttention、连续批处理、可选 P/D 分离)以不变的方式消耗这些变量;GPU 集群执行解码;虚线箭头通过遥测反馈关闭滚动时域循环。
系统模型
GPU 集群:J 个 GPU 划分为若干 serving groups,每个组使用特定并行配置 k in K,其中张量并行度 tau_k、流水线并行度 p_k,每组消耗 tau_k * p_k 个 GPU。
请求类别:请求按应用类型分为 i in I 类(聊天、代码生成、QA),每类有到达率 lambda_i、输入长度 L_in^i(已知)、共享前缀 L_pre^i(可缓存)、延迟 SLO D_i、输出长度 xi_i(生成前未知)。
期望服务时间(公式 1):
其中 alpha, beta 为模型特定常数,N_L 为层数,t_ar 为 all-reduce 延迟。注意服务时间使用 E[xi_i] 而非不确定实现值 xi_i,因为吞吐量是聚合指标——根据大数定律,并发请求间的变异性会相互抵消。
决策变量
所有决策均在观察实际输出长度之前做出:
| 变量 | 说明 |
|---|---|
| z_k in Z_+ | 配置 k 的 serving group 数量,决定 GPU 如何分区 |
| r_i in [L_in^i, L_in^i + L_max^i] | 每类别 i 请求的 KV cache 预留 token 数 |
| pi_{i,k} >= 0 | 类别 i 请求路由到配置 k 的比例 |
| delta_{i,k} in {0, 1} | 是否在配置 k 上缓存类别 i 的共享前缀,有效预留 r~{i,k} = r_i - delta{i,k} L_pre^i |
成本结构
抢占成本(公式 2):当 L_in^i + xi_i > r_i 时发生抢占
浪费成本(公式 3):当预留超过实际需求
总成本(公式 4):
分布鲁棒优化公式
Wasserstein 模糊集(公式 5):
MIBLP 主问题(公式 6a-6f):
其中 W_k = u_k(1+C_{s,k}^2)/(2(1-u_k)) * T_bar_k 为 M/G/1 Pollaczek-Khinchin 队列延迟公式。
核心理论结果:临界分位数结构(Proposition IV.2)
定理(最优预留结构)(公式 9):
其中 rho = c_p/c_w 为成本比,F_i 是最坏情况分布下的输出长度累积分布函数。这是经典的 newsvendor 临界分位数结构:最优预留量 = 输入长度 + 最坏分布的分位数。
关键洞察:阈值分位数 q* = rho/(rho+1) 是边际预留成本等于避免抢占边际收益的点。随着 rho 增大(抢占更昂贵),最优分位数上升,预留更保守。
Kantorovich 对偶重构(Appendix A)
对偶形式(公式 15):
可计算的有限重构(公式 16):
其中 sup 部分在三个关键点(0, xi_hat, L_max)取最大值,得到分段线性闭式解。
BCD-DRO 算法
算法循环三个块:
- Block 1:交替求解 LP1(固定 gamma,theta,r,优化 pi)和 LP2(固定 pi,优化 r,gamma,theta)
- Block 2:delta_{i,k}^{(t)} <- 1[u_{i,k}pi_{i,k}/z_k > 1](前缀缓存闭式更新)
- Block 3:z^{(t)} <- arg min_{z in Z} Obj(z,r,pi,delta^{(t)})(枚举有限配置集)
复杂度:离线阶段通过块坐标下降求解一系列 LP;在线阶段 O(1) per request。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 联合优化框架 | 首次将 GPU 并行配置、KV 缓存预留、请求路由和前缀缓存统一为一个优化问题 | Eq. 6a-6f 完整 MIBLP 公式 |
| Wasserstein DRO | 用 Wasserstein 模糊集捕获输出长度不确定性和工作负载分布漂移 | Proposition IV.1, Appendix A |
| 临界分位数结构 | 理论证明最优预留遵循 rho/(rho+1) 分位数,消除手动调参 | Proposition IV.2, Remark 3 |
| BCD-DRO 算法 | 利用问题的块结构,将混合整数问题分解为可高效求解的 LP 序列 | Proposition IV.3, Table III |
| 滚动时域适应 | 定期重优化以适应非平稳工作负载 | Fig. 5(a) |
五、代码实现分析
论文未提供开源代码。但从描述中可推断实现要点:
- 离线优化器:使用 MIBLP 求解器(如 Gurobi/CPLEX)或 BCD-DRO 算法实现
- 在线服务:O(1) 查询预计算好的 (z*, r*, pi*, delta*),采样路由决策并应用预留
- 模拟器:基于 BurstGPT trace 的仿真器,使用 M/G/1 PK 模型计算队列延迟,抢占请求施加 2.5x 服务时间惩罚
六、实验结果
基准测试
数据集:
- BurstGPT:Azure OpenAI 1.4M 请求(ChatGPT/GPT-4),均值=125, P90=276, P99=1,586 tokens
- Azure LLM 2024:44M 生产请求(Code: 均值=23, P90=49; Conversation: 均值=117, P90=398)
- ShareGPT:368K 众包 ChatGPT 对话
Table II — DRO vs 基线 across 应用场景:
| 场景 | rho | DRO | P90 | P95 | DRO 增益 |
|---|---|---|---|---|---|
| Batch | 2 | 184 | 255 | 365 | 28-50% |
| Async API | 5 | 360 | 380 | 459 | 5-22% |
| User-facing | 10 | 587 | 588 | 617 | 0-5% |
| Latency-sensitive | 20 | 931 | 1003 | 931 | 0-7% |
| Critical | 50 | 1575 | 2250 | 1875 | 16-30% |
| Real-time | 100 | 1919 | 4328 | 3448 | 44-56% |
Table IV — 成本 vs 延迟全面对比(rho ∈ {2, 10, 100}):
| 方法 | rho=2 | rho=10 | rho=100 | P99(s)@rho=10 | SLO违反@rho=10 |
|---|---|---|---|---|---|
| DRO | 1,270 | 3,083 | 4,807 | 11.47 | 15.6% |
| P90 | 1,852 | 3,095 | 17,080 | 11.39 | 14.8% |
| P95 | 2,890 | 3,320 | 8,153 | 12.50 | 23.2% |
| P99 | 4,308 | 4,349 | 4,811 | 17.12 | 33.7% |
| Mean | 1,275 | 4,666 | 42,811 | 12.03 | 21.7% |
| Max | 4,752 | 4,756 | 4,807 | 19.04 | 36.7% |
| LP+1sigma | 1,729 | 3,143 | 19,055 | 11.30 | 13.2% |
| LP+2sigma | 2,615 | 3,207 | 9,865 | 11.80 | 18.0% |
关键发现:DRO 是唯一在所有 rho 范围内成本保持有界的唯一方法。P90 在 rho=100 时成本飙升至 17,080(DRO 的 3.5x),Mean 在 rho=100 时飙升至 42,811(DRO 的 8.9x)。
算法可扩展性(Table III)
| 问题规模 | MIBLP 时间(s) | BCD-DRO 时间(s) |
|---|---|---|
| 3x4x100 | 0.07 (最优) | 0.17 (0% gap) |
| 4x4x150 | 1.2 (最优) | 0.8 (0% gap) |
| 5x5x200 | 33.7 (最优) | 4.3 (0% gap) |
| 6x6x300 | >300 (超时) | 10.5 |
| 8x6x500 | >300 (超时) | 22.4 |
| 10x8x1000 | — | 81.2 |
| 15x12x2000 | — | 257.7 |
BCD-DRO 在中等规模即超越 MIBLP,大规模问题中 MIBLP 超时而 BCD-DRO 仍收敛。
消融实验(Table V,rho=20, 2.5x 分布偏移)
| 变体 | 成本 | P99(s) | Goodput | SLO 违反(%) |
|---|---|---|---|---|
| BCD-DRO (ours) | 13,476±208 | 8.12±0.65 | 5.01±0.25 | 26.4±3.7 |
| -Routing (uniform pi) | 93,878±5,152 | 177.62±11.90 | 0.63±0.06 | 93.8±0.6 |
| -DRO (SAA) | 24,864±1,534 | 11.02±1.55 | 3.68±0.35 | 45.8±5.2 |
| -Prefix caching (delta=0) | 13,476±208 | 9.95±1.29 | 4.39±0.37 | — |
关键发现:
- 移除路由使成本暴增 7x(93,878 vs 13,476),P99 延迟增加 22x
- 移除 DRO(退化为 SAA)使成本增加 85%,SLO 违反增加 73%
- 移除前缀缓存不改变成本(因为 delta 只进入队列/容量模型),但 P99 延迟从 8.12s 增至 9.95s
分布偏移鲁棒性(Fig. 6)
在 3.0x 最大分布偏移下:DRO 的 P99 从 3.0s 温和增长至 9.1s,而 SAA 从 5.4s 激增至 18.0s——约为 DRO 的两倍,SLO 违反率攀升至 67.7%(vs DRO 的 35.6%)。
七、相关工作
| 工作 | 方法 | 局限 |
|---|---|---|
| PagedAttention / vLLM | 分页内存管理 | 无预留策略优化 |
| Orca | 分布式 serving 系统 | 无不确定性建模 |
| Sarathi-Serve | 吞吐-延迟权衡 | 固定预留启发式 |
| H2O / SnapKV | KV token 驱逐 | 减少内存而非优化预留 |
| Length predictors | 输出长度预测 | 无鲁棒性保证 |
| BCD-DRO (本文) | Wasserstein DRO + 联合优化 | 自动适应任何成本结构 |
八、总结
核心贡献
- 统一优化框架:联合协调 GPU 并行配置、KV 缓存预留、请求路由和前缀缓存,在输出长度不确定性和延迟 SLO 约束下
- Wasserstein DRO 公式 + 临界分位数理论:揭示最优预留遵循 rho/(rho+1) 分位数,消除手动调参需求
- BCD-DRO 可扩展算法:支持周期性重优化以适应工作负载漂移,在线阶段 O(1) per request
- 生产级实验验证:在 BurstGPT、Azure、ShareGPT 真实 trace 上,相比固定分位数基线最高降低 56% 成本
技术影响
为 LLM 推理服务的 KV 缓存管理提供了第一个具有鲁棒性保证的联合优化框架,将操作领域的库存管理理论(newsvendor problem)与系统优化相结合。
局限性
- 服务时间使用 E[xi_i] 而非实际 xi_i(基于大数定律近似),对少量并发请求可能不够精确
- 配置枚举集 Z 的大小随候选配置数量指数增长(虽在实验中可行)
- 未考虑多模型共存的场景