通过张量核心与 CUDA 核心并行执行提升 GPU 吞吐
UNT 与 William & Mary 提出的纯硬件 GEMM 卸载方案:在张量核心执行 GEMM 时,将部分 WMMA 指令翻译为 MAC 指令下放到空闲的 CUDA 核心并行执行,配合额外 load-store 单元缓解访存瓶颈,在 GPGPU-Sim 上最高提升 29% 性能,CUDA 核心利用率从近零提升至平均 ~73%。
通过张量核心与 CUDA 核心并行执行提升 GPU 吞吐
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Improving GPU Throughput through Parallel Execution Using Tensor Cores and CUDA Cores |
| 作者 | Khoa Ho, Hui Zhao(UNT), Adwait Jog(William & Mary), Saraju Mohanty(UNT) |
| 机构 | University of North Texas;William & Mary |
| 会议 | 2022 IEEE Computer Society Annual Symposium on VLSI (ISVLSI),pp. 223–228 |
| DOI | 10.1109/ISVLSI54635.2022.00051 |
| 主题 | GPU 微架构、加速器、机器学习、并行调度 |
| 资助 | NSF Grants 1828105、2046186、2008911 |
二、核心思想
现代 GPU(Volta/Turing/Ampere)用 张量核心(Tensor cores) 加速深度学习核心算子——通用矩阵乘(GEMM)。但当一个 SM 执行 GEMM 内核时,只能运行一个内核,计算全部分配给张量核心,而 CUDA 核心(FP32/INT32 单元)几乎全程空闲,只偶尔做寻址等轻量计算。这既浪费硬件资源,又因空闲 CUDA 核心持续耗电而带来功耗开销。
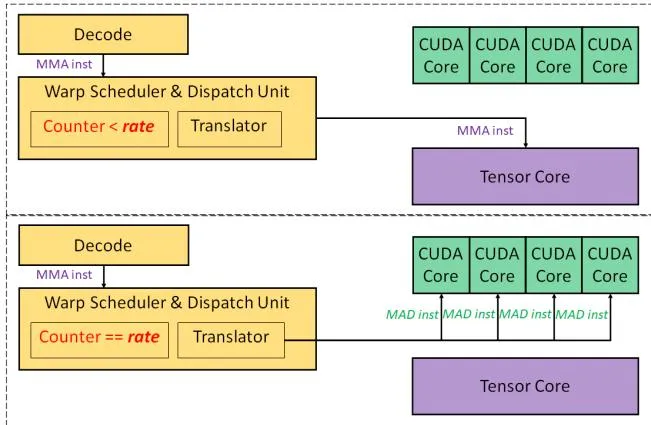
本文提出一种纯硬件的解决方案:在 GEMM 内核执行期间,把一部分本应交给张量核心的工作卸载(offload)到空闲的 CUDA 核心并行执行。做法是把部分 WMMA 矩阵乘指令(MMA)翻译为多条 MAC 指令,调度到 CUDA 核心的 FP32 计算单元上。
与已有方法的差异
- 不需要编译器/软件支持、不修改 ISA,对程序员完全透明。
- 不需要额外的非 GEMM 应用:对比 Zhao et al.(intra-SM 并行,在 CUDA 核心上跑另一个 HPC 内核)的方法,本文只用单个机器学习应用即可提升吞吐。
- 避免资源争用:一个 SM 内仍只运行一个内核,不会像多内核共享 SM 那样争抢共享内存等资源。
三、技术架构
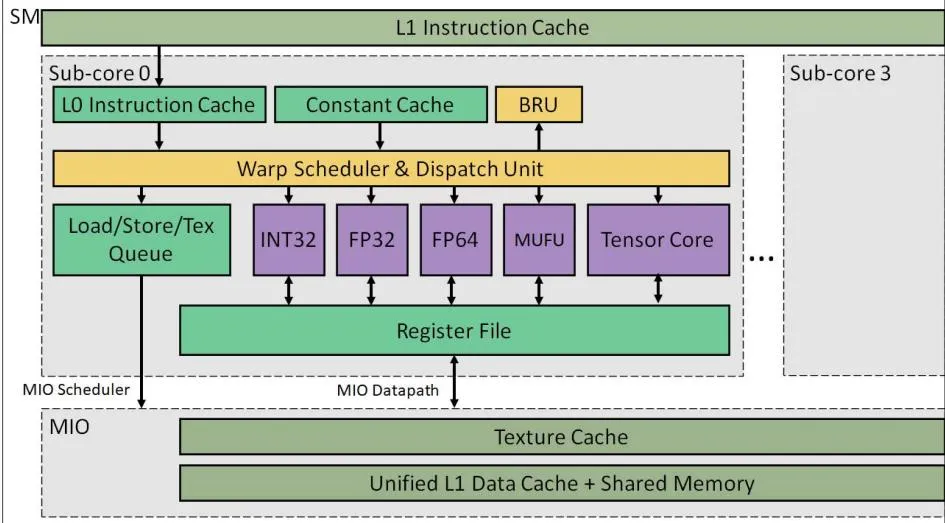
Volta SM 采用 4 个 sub-core 结构,每个 sub-core 含 1 个 warp scheduler、张量核心与 CUDA 核心(FP32/INT32 单元)等功能单元(Turing 结构类似,仅功能单元数量不同):
3.1 WMMA API 背景
CUDA 9(PTX ISA 6.0)引入 warp 级矩阵乘累加(WMMA) API 编程张量核心,执行 (A、B、C、D 为大矩阵的 tile)。一个 warp 内的线程协作完成矩阵乘累加。tile 尺寸记为 ,基础尺寸为 16×16×16(PTX 6.1 增加 8×32×16、32×8×16 变体)。三个相关函数:load_matrix_sync、store_matrix_sync、mma_sync。
3.2 从张量核心卸载到 CUDA 核心
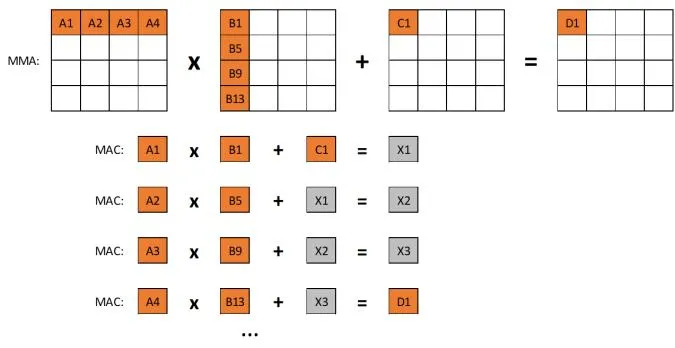
核心机制是把 MMA 指令翻译成多条 MAC warp 指令。以实验中的 m16n16k16 tile 为例:
- 一次完整矩阵乘 = 次乘加运算;
- CUDA 核心以 SIMD 模型执行,每 warp 32 线程;
- 因此一条 MMA 指令可翻译为 条 MAC warp 指令。
Warp Scheduler 需要两个新增子单元:一个计数器和一个指令翻译器(把 MMA 翻译为在同一组寄存器上工作的多条 MAC 指令)。调度有两种情形:正常把 MMA 发给张量核心,或翻译后把 MAC 指令发给 CUDA 核心。
数据类型转换:GEMM 内核多用 FP16,CUDA 核心主要用 FP32/INT32,需要类型转换。自 Pascal + CUDA 8 起,GPU 已在流水线执行中内建数据类型转换,无需独立转换操作、不影响性能。
3.3 卸载调度算法(Algorithm 1)
Input: mma_inst = 解码后的 MMA 指令
       mma_counter = 距上次卸载以来的 MMA 计数
m, n, k = mma_inst.mnk
mma_latency = 64          // Volta TitanV & Turing RTX2060 @ GPGPU-Sim 4.0.1
mac_latency = 4
threads_per_warp = 32

num_of_mac_inst = (m * n * k) / threads_per_warp
offload_rate = 1 + (num_of_mac_inst * mac_latency) / mma_latency
               // m=n=k=16 时 offload_rate = 9

if ((mma_counter + 1) == offload_rate) && cuda_cores_is_available():
    translate_and_issue_to_cuda_cores(mma_inst)
    mma_counter = 0                   // 重置计数器
else:
    issue_to_tensor_cores(mma_inst)
    if mma_counter < offload_rate:
        mma_counter++                 // 仅当 counter < rate 时递增
        // 若 counter==rate 但 CUDA FP32 流水线被占用,
// 则把该 MMA 发给张量核心但保留计数器卸载率公式(决定每多少条 MMA 卸载一条给 CUDA 核心):
对 :,代入 。即每 9 条 MMA 卸载 1 条给 CUDA 核心,使两类核心的完成时间大致平衡。
3.4 额外 load-store 单元优化
GEMM 执行的另一瓶颈是全局内存与共享内存之间的长数据路径,导致张量核心与 CUDA 核心都长时间停顿。在 Volta/Turing 上,global↔shared 的数据必须先经过寄存器中转;Ampere 起引入 global↔shared 的直接异步数据路径解决了该问题。
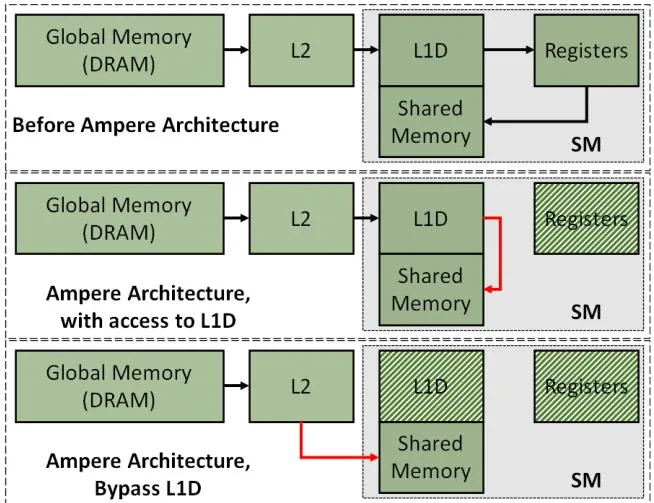
作者发现卸载后 load-store 单元(ldst)成为性能瓶颈,提出两种设计(对应 Fig. 5):
| 设计 | 说明 | 适用架构 |
|---|---|---|
| (a) baseline | 原始单 ldst 单元 | — |
| (b) full ldst-unit | 增加一个通用 ldst 单元,为所有访存操作增加带宽(在 L1D↔ldst↔寄存器路径上加并行数据流水线) | Volta/Turing |
| (c) shared-memory-side ldst-unit | 只处理共享内存↔寄存器之间的数据事务,仅在该段加并行流水线 | Ampere 及以后(已移除冗余流水线,更适用) |
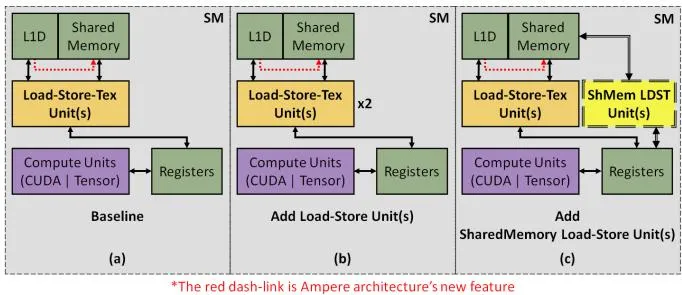
额外硬件成本:计数器、MMA 指令转换器、额外链路;追求更高性能则需更复杂的额外 ldst 单元。
四、实验设置
| 项目 | 配置 |
|---|---|
| 模拟器 | GPGPU-Sim 4.0.1 + CUDA Toolkit + CUTLASS 1.3 |
| 基准 | CUTLASS 1.3 性能测试套件中的 WMMA-GEMM 内核 |
| 负载 | 方阵 GEMM,规模从 128×128 到 2048×2048 |
| 基线 1(Volta) | TitanV:80 SM @1.2GHz,64 CUDA 核/SM(共 5120),8 张量核/SM(共 640),96KB 共享内存 |
| 基线 2(Turing) | RTX2060:30 SM @1.365GHz,64 CUDA 核/SM(共 1920),8 张量核/SM(共 240),64KB 共享内存 |
| 调度策略 | 每 SM 4 个 warp scheduler(每 sub-core 一个),Greedy-Then-Oldest |
| 评估指标 | ① 归一化性能(执行时间倒数,相对基线归一化);② 核心占用率(occupancy 相对总执行时间;occupancy rate 相对 online 时间) |
五、核心实验结果
5.1 归一化性能提升
三种方案(仅卸载 / +共享内存侧 ldst / +full ldst)的性能提升:
| 平台 | 仅卸载(平均 / 峰值) | +共享内存 ldst(平均) | +full ldst(平均 / 峰值) |
|---|---|---|---|
| Volta TitanV | 4.5% / 5.71% | 10.86% | 21.16% / 29.03% |
| Turing RTX2060 | 7.27% / 9.07% | 13.53% | 18.25% / 22.72% |
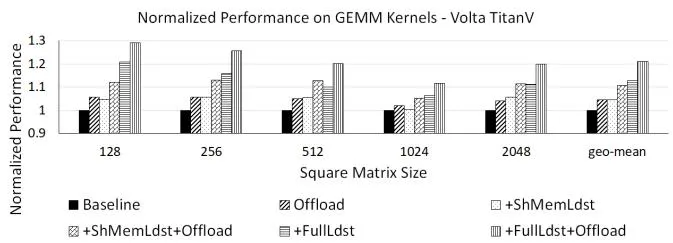
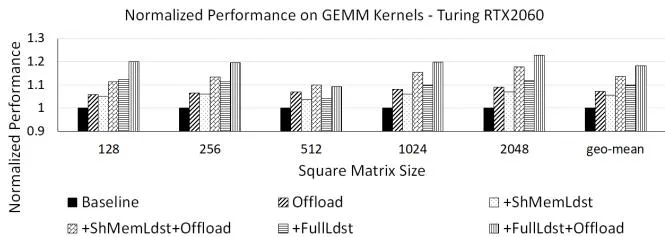
超线性协同:两种技术组合的收益大于各自单独收益之和。例如 TitanV 上,单加 full ldst 提升 12.75%、单卸载提升 4.50%(合计 17.82%),但同时使用两者提升 21.16%——说明组合能开辟更多资源利用机会。
论文标题中的 “19%” 指结论中报告的整体最大提升 19.69%(峰值单点可达 29.03%)。
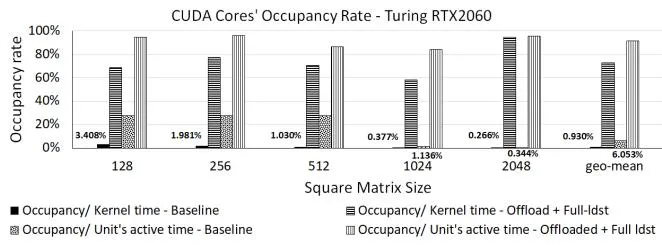
5.2 CUDA 核心利用率
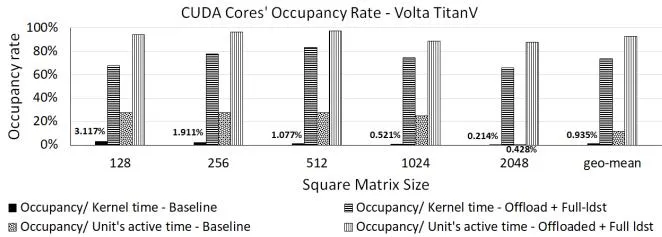
- 基线:CUDA 核心(FP32/SP 单元)利用率接近零;矩阵越大、内核越长,利用率越低。SM 通常在第一轮执行接近结束时才激活 SP 单元(多为辅助张量核心收尾);若有第二轮任务,SP 单元虽保持 online 却大部分时间空闲。
- 本文方案(卸载 + 额外 ldst):两种占用率均显著提升。
- CUDA 核心利用率从近零 → TitanV 峰值 83.06%、平均 73.44%;RTX2060 峰值 94.34%、平均 72.76%。
- CUDA 核心相对 online 时间的占用率 → TitanV 峰值 97.07%、平均 92.62%;RTX2060 峰值 95.95%、平均 91.11%。
- 原因:SM 更早激活 CUDA 核心(而非第一轮末尾),并能持续加载指令占满大部分 online 时间。
六、相关工作对比
| 工作 | 层级 | 方法 | 局限 |
|---|---|---|---|
| Adriaens et al. (HPCA’12) | inter-SM | 空间多任务,把 SM 在不同应用间分区 | 粒度粗,SM 间划分 |
| Zhao et al. (ICCD’21) | intra-SM | 在 CUDA 核心上并行运行另一个非 GEMM 应用 | 需两类不同应用;内核需足够长以摊销调度开销;仅适用数据中心;共享资源争用 |
| 本文 | intra-SM | 把同一 GEMM 的部分 MMA 翻译为 MAC 下放 CUDA 核心 | 只需单个 ML 应用;无需编译器/软件支持;无资源争用 |
七、核心创新与贡献
| 创新点 | 说明 |
|---|---|
| 单应用内 intra-SM 卸载 | 首次在同一 GEMM 内核内做张量核心→CUDA 核心的工作卸载,无需第二个应用 |
| 纯硬件、对软件透明 | 仅需 warp scheduler 增加计数器 + MMA→MAC 翻译器,无需编译器/ISA 改动 |
| 卸载率模型 | 用指令延迟推导 offload_rate,平衡两类核心完成时间(16³ tile → 每 9 条 MMA 卸载 1 条) |
| 访存瓶颈缓解 | 识别 ldst 单元为卸载后的瓶颈,提出 full / shared-memory-side 两种 ldst 增强,与架构演进(Ampere 直连路径)对应 |
八、总结与局限
核心贡献
- 提出并模拟了一种纯硬件 GEMM 卸载架构,在张量核心执行 GEMM 时把部分工作并行下放到空闲 CUDA 核心。
- 建立卸载率模型并设计 warp scheduler 调度算法(Algorithm 1)。
- 识别并缓解 load-store 单元瓶颈,最高实现 29.03% 单点、19.69% 整体性能提升,CUDA 核心利用率从近零升至平均 ~73%。
局限性
- 仅在 GPGPU-Sim 4.0.1 模拟上评估,非真实硬件。
- 仅覆盖 Volta(TitanV)与 Turing(RTX2060) 两代架构;Ampere 之后的直连数据路径会改变 ldst 优化的适用性。
- 仅评估 CUTLASS WMMA-GEMM 方阵内核(FP16),未覆盖端到端网络、非方阵或更小数据类型(INT8/INT4)。
- 需额外硬件(计数器、指令转换器、额外 ldst 单元与链路),带来面积/功耗成本,论文未量化。
九、参考资源
- 论文(IEEE Xplore):Improving GPU Throughput through Parallel Execution Using Tensor Cores and CUDA Cores(ISVLSI 2022)
- 关键引用:Zhao et al., “Exploiting Intra-SM Parallelism in GPUs via Persistent and Elastic Blocks”(ICCD 2021);Adriaens et al., “The case for GPGPU spatial multitasking”(HPCA 2012);GPGPU-Sim(Raihan et al., ISPASS 2019)
- 相关文档:
- GPU 架构基础:内存层次、CUDA 与张量核心(CUDA 核心 / 张量核心 / WMMA / 内存层次背景)
- Blackwell GPU 架构综述(第五代张量核心 tcgen05、TMEM、Ampere 后的内存路径演进)
- Chopper: 多层次 GPU 表征工具及 LLM 训练低效来源分析(另一 GPU 利用率/低效来源表征工作,AMD MI300X)