InfoFlow KV: Information-Flow-Aware KV Recomputation for Long Context
A selective KV recomputation method using attention-norm criteria from query to context tokens to identify information-flow-critical tokens for long-context inference
InfoFlow KV: Information-Flow-Aware KV Recomputation for Long Context
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | InfoFlow KV: Information-Flow-Aware KV Recomputation for Long Context |
| 作者 | Xin Teng, Canyu Zhang, Shaoyi Zheng, Danyang Zhuo, Tianyi Zhou, Shengjie Wang |
| 机构 | 未明确标注 |
| 论文 | arXiv:2603.05353 |
| 代码 | 未提供 |
| 发布 | 2026-03-05 (v1, 6,286 KB) |
| 许可 | CC BY 4.0 |
| 领域 | Machine Learning (cs.LG) |
二、核心思想
检索增强生成(RAG)已成为大语言模型和视觉语言模型问答的主流范式。在 RAG 中,模型反复检索并条件化大量外部文档,通常涉及数万甚至数十万 token,而仅生成简短答案。
一种自然的效率策略是:离线预计算各个文档/KV 缓存,在查询时通过复用这些缓存状态来组装检索到的上下文。然而,自回归解码需要一个全局有序的单序列,具有跨检索证据的全局因果依赖关系,而每个文档的 KV 缓存是独立计算的——这导致了缓存组装与全局因果注意力之间的不匹配。
现有方法通过选择性 KV 重计算来缓解这一问题,但它们的 token 选择标准存在局限:CacheBlend 基于缓存 KV 状态与完整上下文注意力的偏差,EPIC 则固定重计算每个 chunk 的初始 token,两者均未考虑信息流的结构化特性。
InfoFlow KV 将选择性 KV 重计算视为一个信息流问题——目标是恢复检索到的证据能够有效影响答案生成的路径。作者发现,一个来自 query 到 context token 的**注意力范数(attention-norm)**准则在识别同时具备语义相关性和结构位置传播能力的 token 方面非常有效。
问题定义
给定 个 token 的输入,划分为 个不相交 chunk 。每个 chunk 独立预填充,使用 chunk-local RoPE 位置编码。在推理时,检索到的 chunk 与 prompt 拼接后需要全局因果掩码下的重计算来恢复跨 chunk 交互。
关键挑战:
- RoPE 几何失配:chunk-local 位置分配与全局推理位置不一致,导致 token 重要性评估失真
- token 选择标准:如何准确识别对信息流最关键的 token 进行重计算
解决方案概述
- 注意力范数准则:使用 prompt-to-context 注意力矩阵的行和作为 token 重要性分数
- 全局位置重建:为检索到的 chunk 重建全局 RoPE 位置,确保 token 选择的推理一致性
- 信息流引导的 chunk 重排序:将信息量更大的 chunk 放置在更靠近 prompt 的位置
超越 RAG 的适用性
尽管主要针对”带预计算文档级 KV 缓存的 RAG”场景,该 chunking-and-recompute 策略在没有预计算缓存时同样适用:非 RAG 长上下文推理中可将输入切分为独立预填充的 chunk,再在全局因果掩码下选择性重计算。由此带来两个实际收益:(i) 在多查询/交互式场景中,预取的 KV 缓存可存储复用以摊销预填充成本;(ii) chunk-wise 预填充天然支持多 GPU 并行(各 chunk 在重组与重计算前独立处理)。
三、技术架构
整体框架
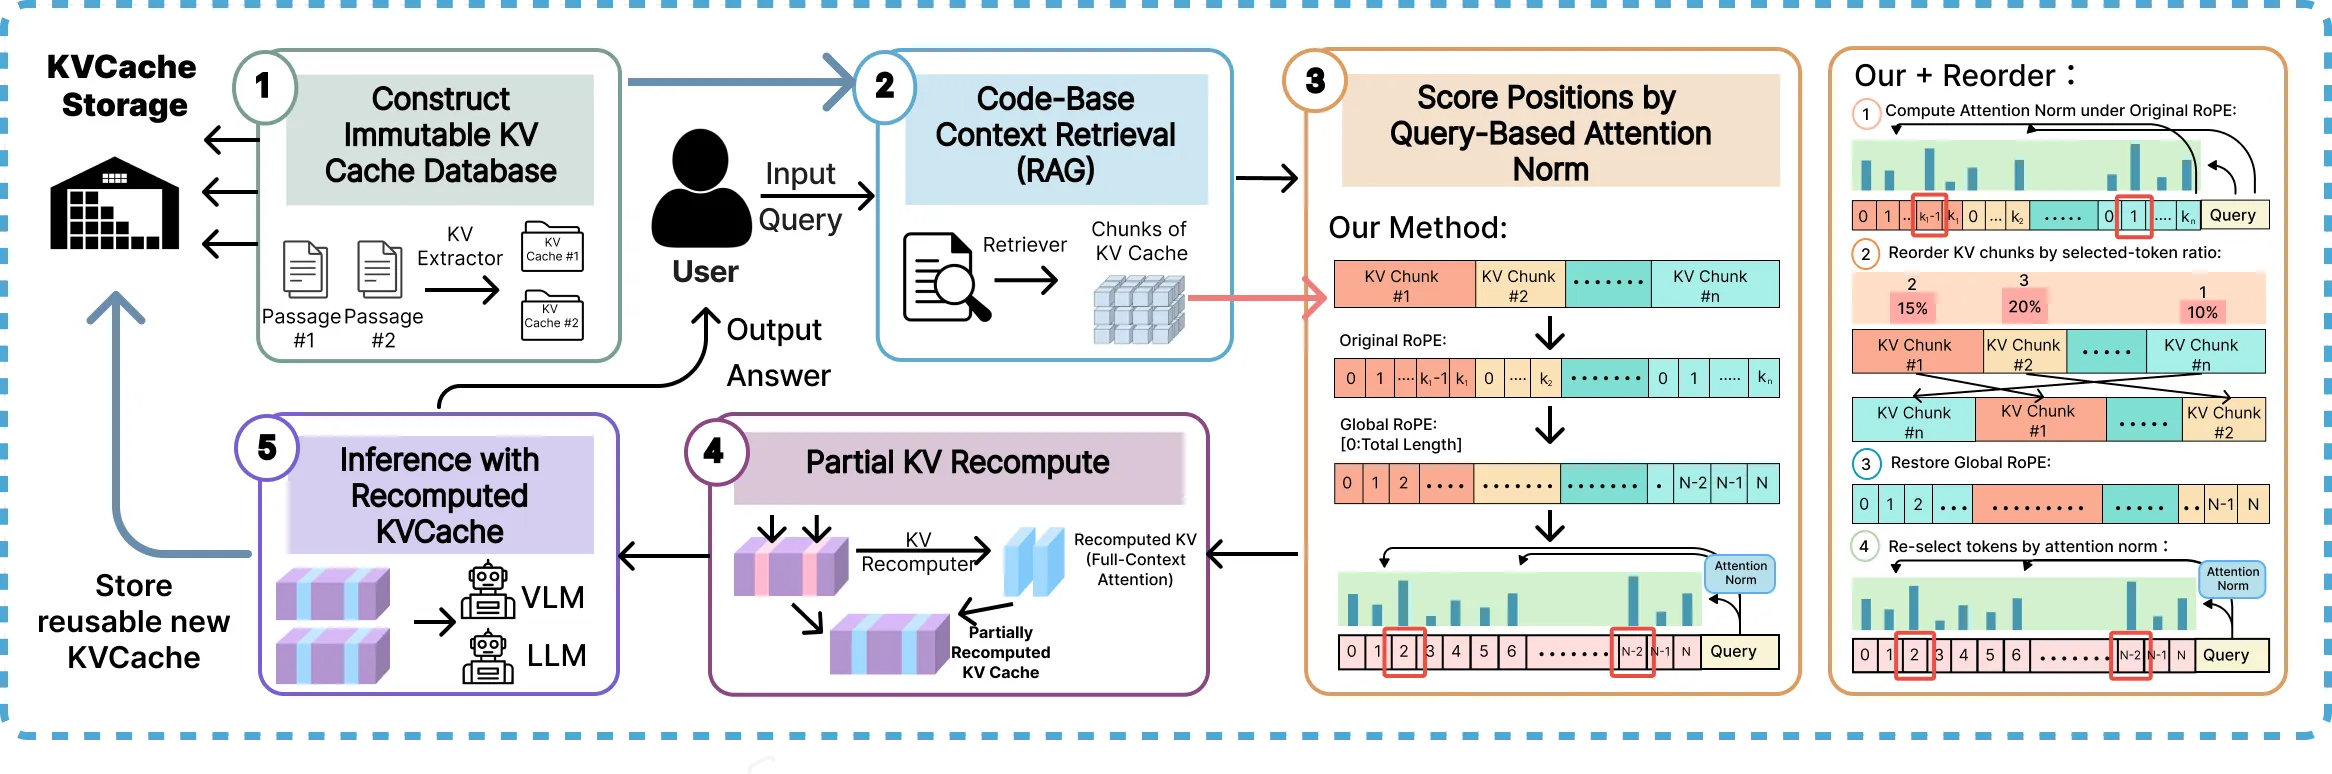
┌─────────────────────────────────────────────────────────────────┐
│                    InfoFlow KV Pipeline                          │
├─────────────────────────────────────────────────────────────────┤
│                                                                 │
│  Phase 1: Chunk-wise Prefill (Offline)                          │
│  ┌──────────┐  ┌──────────┐  ┌──────────┐                      │
│  │ Chunk 1   │  │ Chunk 2   │  │ Chunk K   │                   │
│  │ pos: 0..n │  │ pos: 0..m │  │ pos: 0..p │                   │
│  │ KV₁ cached│  │ KV₂ cached│  │ KVₖ cached│                   │
│  └──────────┘  └──────────┘  └──────────┘                      │
│                                                                 │
│  Phase 2: Global Position Reconstruction                        │
│  Chunk i global start: g(t) = Δ_ctx + p_i(t)                    │
│  Prompt global start:  g(p) = Δ_pr + p_pr(p)                    │
│                                                                 │
│  Phase 3: Token Selection (Attention-Norm Criterion)            │
│  A ∈ ℝ^(M×N)  prompt-to-context attention matrix               │
│  s_j = Σᵢ A_ij   →   S = Top-k({s_j})                          │
│                                                                 │
│  Phase 4: Selective KV Recomputation                            │
│  Recompute only selected tokens under global causal mask        │
│                                                                 │
│  Phase 5 (Optional): Chunk Reordering                           │
│  Two-stage selection → place informative chunks closer to prompt│
│                                                                 │
└─────────────────────────────────────────────────────────────────┘
核心公式
KV Cache 定义:
其中 为第 层位置 的隐藏状态, 为每头维度。
RoPE 旋转位置编码:
全局位置重建:
Chunk 内 token 的全局位置:
Prompt token 的全局位置:
其中 指定 chunk 在整个上下文中的起始位置, 为 chunk 内的局部位置索引。
Token 选择——注意力范数准则:
prompt-to-context 注意力矩阵 ,其中 为 prompt 大小, 表示第 个 prompt token 对第 个 context token 的注意力权重。每个 context token 的重要性分数:
重计算目标选择 top- 最大重要性分数的 context token:
作者使用 prompt-to-token 注意力而非 token-to-prompt 注意力作为选择信号,因为 prompt-to-token 注意力直接决定了从每个 context token 中检索多少信息,对 next-token prediction 有即时影响。
四种 RoPE 配置
| 配置 | Prompt 位置 | Context 位置 | 说明 |
|---|---|---|---|
| GLOBAL | 与推理时一致(默认) | ||
| HL-HP | Head-only, high prompt | ||
| HL-TP | Head-only, truncated prompt | ||
| TL-TP | Truncated, both |
其中 为总序列长度。
RoPE 几何为何决定 token 选择质量
论文的关键理论洞察:注意力范数准则只有在与推理解码一致的 RoPE 几何下计算才可靠;chunk-local 或错配的位置配置会产生不稳定、误导性的 token 排序。信息从 context token 传向下游自回归解码的有效性,取决于拼接后 RoPE 分配的两个内在几何性质:
- Context token 所处的 RoPE 频率区间:决定 token 间相对位置差异被 RoPE 编码的敏感程度(低索引维度=高频、对位置差异更敏感);
- Prompt 与 context 之间的相对 RoPE 位置邻近度:决定在因果约束下 prompt-to-context 注意力能否被有效建立。
因此 HL-HP、TL-TP 等把 prompt 与 context 分配到分离或截断位置区间的配置会明显拉低分数,而 GLOBAL(与推理布局完全一致)始终最优——这为”token 选择的位置布局必须匹配解码布局”提供了几何层面的解释(Table 1、Table 2 佐证)。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 全局位置重建模块 | 将 chunk-local 位置映射到全局位置 | , |
| 注意力范数计算器 | 计算 prompt-to-context 注意力矩阵的行和 | 中间偏晚层(22–25 层) |
| Top-k 选择器 | 按重要性分数选择重计算 token | = 总 token 数的 15% |
| Chunk 重排序器 | 两阶段选择 + chunk 重排 | 第一阶段 HL-TP 鼓励多样性 |
| 全层重计算 | 对所有 Transformer 层重计算选中 token 的 KV | 保证全局因果一致性 |
训练流程
InfoFlow KV 是一个推理时方法,不修改预训练模型。其工作流程:
- Chunk-wise Prefill:离线独立预计算各 chunk 的 KV 缓存
- 全局位置重建:在推理时为检索到的 chunk 分配全局位置
- Token 选择:从预填充阶段的注意力矩阵计算重要性分数
- 选择性重计算:对 top-k token 在全局因果掩码下重计算 KV
- 可选重排序:两阶段选择后将信息量大的 chunk 前置
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 信息流视角 | 将选择性 KV 重计算重新定义为信息流恢复问题 | 发现注意力范数同时捕获语义相关性和全局因果图上的结构位置 |
| 注意力范数准则 | prompt-to-context 注意力矩阵行和作为 token 重要性信号 | Table 3: 在 3 个 LLM 和 4 个基准上持续优于 CacheBlend 和 EPIC |
| 推理一致的 RoPE 排序 | 引入全局位置重建确保 token 选择的推理一致性 | Table 1: GLOBAL 配置在所有基准上 consistently best |
| Chunk 重排序策略 | 基于信息流关键 token 将检索到的 chunk 重新排序 | 在 passage-split 和 narrative 场景中获得额外增益 |
五、代码实现分析
本文未提供开源代码。根据 Appendix B 的实现细节:
Norm 层选择:实验表明中间偏晚层(layers 22–25)的注意力范数 consistently yield 最佳下游检索准确率。
重计算范围:选中 token 后,在所有 Transformer 层重计算其 KV 状态,确保重计算 token 与全局因果注意力几何完全一致。
数值差异说明:Ring Attention 设置下与单 GPU 全预填充基线存在微小数值差异,主要源于浮点算术非结合性——ring attention 改变了部分统计量(softmax 的行最大值和归一化器,以及随后的加权约简)的计算顺序。
六、实验结果
LLM 实验
Table 3: LongBench 长上下文 QA 性能对比(固定 chunk=2048,passage-split 设置)
| 模型 | 方法 | 2WikiMQA | MuSiQue | HotpotQA | NarrativeQA |
|---|---|---|---|---|---|
| Qwen | |||||
| Baseline | 0.5161 | 0.3718 | 0.5922 | 0.1654 | |
| No Recompute | 0.3948 | 0.1342 | 0.4633 | 0.1137 | |
| Our | 0.5089 | 0.3384 | 0.5967 | 0.2110 | |
| Our + Reorder | 0.4773 | 0.2872 | 0.5053 | 0.2251 | |
| CacheBlend | 0.4417 | 0.2611 | 0.5352 | 0.2170 | |
| EPIC (15%) | 0.4321 | 0.2368 | 0.5284 | 0.1999 | |
| LLaMA | |||||
| Baseline | 0.4588 | 0.3285 | 0.5410 | 0.1623 | |
| No Recompute | 0.4738 | 0.4213 | 0.5594 | 0.2803 | |
| Our | 0.4635 | 0.3104 | 0.5150 | 0.2891 | |
| Our + Reorder | 0.4455 | 0.3044 | 0.5053 | 0.2957 | |
| CacheBlend | 0.4131 | 0.2823 | 0.4720 | 0.2685 | |
| EPIC (15%) | 0.4087 | 0.2638 | 0.4755 | 0.2701 | |
| ChatGLM | |||||
| Baseline | 0.5253 | 0.3946 | 0.6003 | 0.3264 | |
| No Recompute | 0.4370 | 0.2833 | 0.5024 | 0.2758 | |
| Our | 0.5064 | 0.3688 | 0.5739 | 0.3239 | |
| Our + Reorder | 0.5176 | 0.3786 | 0.5820 | 0.3140 | |
| CacheBlend | 0.4226 | 0.2624 | 0.5177 | 0.2970 | |
| EPIC (15%) | 0.4401 | 0.2902 | 0.5362 | 0.2962 |
关键发现:
- Our 方法在 3 个 LLM 和 4 个基准上均取得最佳或次佳结果
- 在多跳推理任务(2WikiMQA, MuSiQue, HotpotQA)上提升尤为显著,这些任务需要聚合分散证据
- Our + Reorder 在 NarrativeQA 和部分 passage-split 场景中提供额外增益
VLM 实验
Table 4: Qwen3-VL-8B 视觉语言 QA 基准性能
| 模型 | 方法 | RealWorldQA | ChartQA | OCRBench | HRBench4K | infoVQA val |
|---|---|---|---|---|---|---|
| k=0 | ||||||
| Baseline (No Recompute) | 0.7059 | 83.08 | 878 | 0.74875 | 83.07 | |
| k=2 | ||||||
| No Recompute | 0.6745 | 71.32 | 839 | 0.72750 | 71.64 | |
| Our | 0.6810 | 73.48 | 842 | 0.72625 | 73.07 | |
| CacheBlend | 0.6758 | 71.72 | 845 | 0.72375 | 72.00 | |
| EPIC | 0.6745 | 70.92 | 836 | 0.72500 | 71.51 | |
| k=4 | ||||||
| No Recompute | 0.6588 | 62.00 | 781 | 0.68875 | 57.88 | |
| Our | 0.6667 | 65.68 | 802 | 0.69125 | 62.23 | |
| CacheBlend | 0.6562 | 62.68 | 786 | 0.68625 | 58.56 | |
| EPIC | 0.6549 | 62.48 | 785 | 0.67250 | 57.82 |
改进在结构性要求高的任务(ChartQA, OCRBench)上最为明显,这些任务需要整合分散的视觉元素信息。
消融实验
Table 1: RoPE 几何配置消融(Qwen, passage-split)
| RoPE 配置 | 2WikiMQA | MuSiQue | HotpotQA | NarrativeQA |
|---|---|---|---|---|
| HL-HP | 0.4455 | 0.2871 | 0.5529 | 0.1481 |
| TL-TP | 0.4458 | 0.2970 | 0.5693 | 0.1923 |
| HL-TP | 0.4722 | 0.3072 | 0.5651 | 0.2106 |
| GLOBAL | 0.5019 | 0.3386 | 0.5954 | 0.2288 |
GLOBAL 配置在所有基准上 consistently best,证明 token 选择的位置布局应与推理时解码布局紧密匹配。
Table 2: RoPE 相似性统计(Mean-of-Max & Max)
| Model | Method | 2WikiMQA MoM | 2WikiMQA Max | HotpotQA MoM | HotpotQA Max |
|---|---|---|---|---|---|
| LLaMA | Norm-based | 0.5324 | 0.9773 | 0.5219 | 0.9766 |
| CacheBlend | 0.5243 | 0.9133 | 0.5191 | 0.8570 | |
| EPIC | 0.5049 | 0.6734 | 0.4985 | 0.6852 | |
| Qwen | Norm-based | 0.4548 | 0.9805 | 0.4179 | 0.9805 |
| CacheBlend | 0.4505 | 0.8078 | 0.4226 | 0.8891 | |
| EPIC | 0.4129 | 0.5656 | 0.3835 | 0.6555 |
Norm-based 选择在 RoPE 相似性指标上 consistently 高于 prior methods,揭示注意力显著性与 RoPE 诱导的位置结构之间的一致性。
效率分析
Table 5: TTFT 延迟与加速比(4× NVIDIA H100, sequence parallel)
| 序列长度 | 方法 | 重计算比例 | TTFT (ms) | 加速比 |
|---|---|---|---|---|
| 8192 | Single-GPU Prefill | — | 566.7 | 1.00× |
| Ring Attention | — | 247.5 | 2.29× | |
| Ours | 0.15 | 232.0 | 2.44× | |
| 16384 | Single-GPU Prefill | — | 1285.8 | 1.00× |
| Ring Attention | — | 707.8 | 1.82× | |
| Ours | 0.15 | 427.6 | 3.01× | |
| 32768 | Single-GPU Prefill | — | 3190.5 | 1.00× |
| Ring Attention | — | 2350.1 | 1.36× | |
| Ours | 0.15 | 914.0 | 3.49× |
在 32K 上下文长度下,InfoFlow KV 相比单 GPU 预填充实现 3.49× 加速,且优于 ring attention。
Table 6: Ring Attention vs Ours F1 对比
| 数据集 | Ring Attention | Ours | 提升 |
|---|---|---|---|
| HotpotQA | 56.53 | 57.83 | +1.30 |
| 2WikiMQA | 48.94 | 51.49 | +2.55 |
| Musique | 32.10 | 33.54 | +1.44 |
Needle-in-a-Haystack 分析
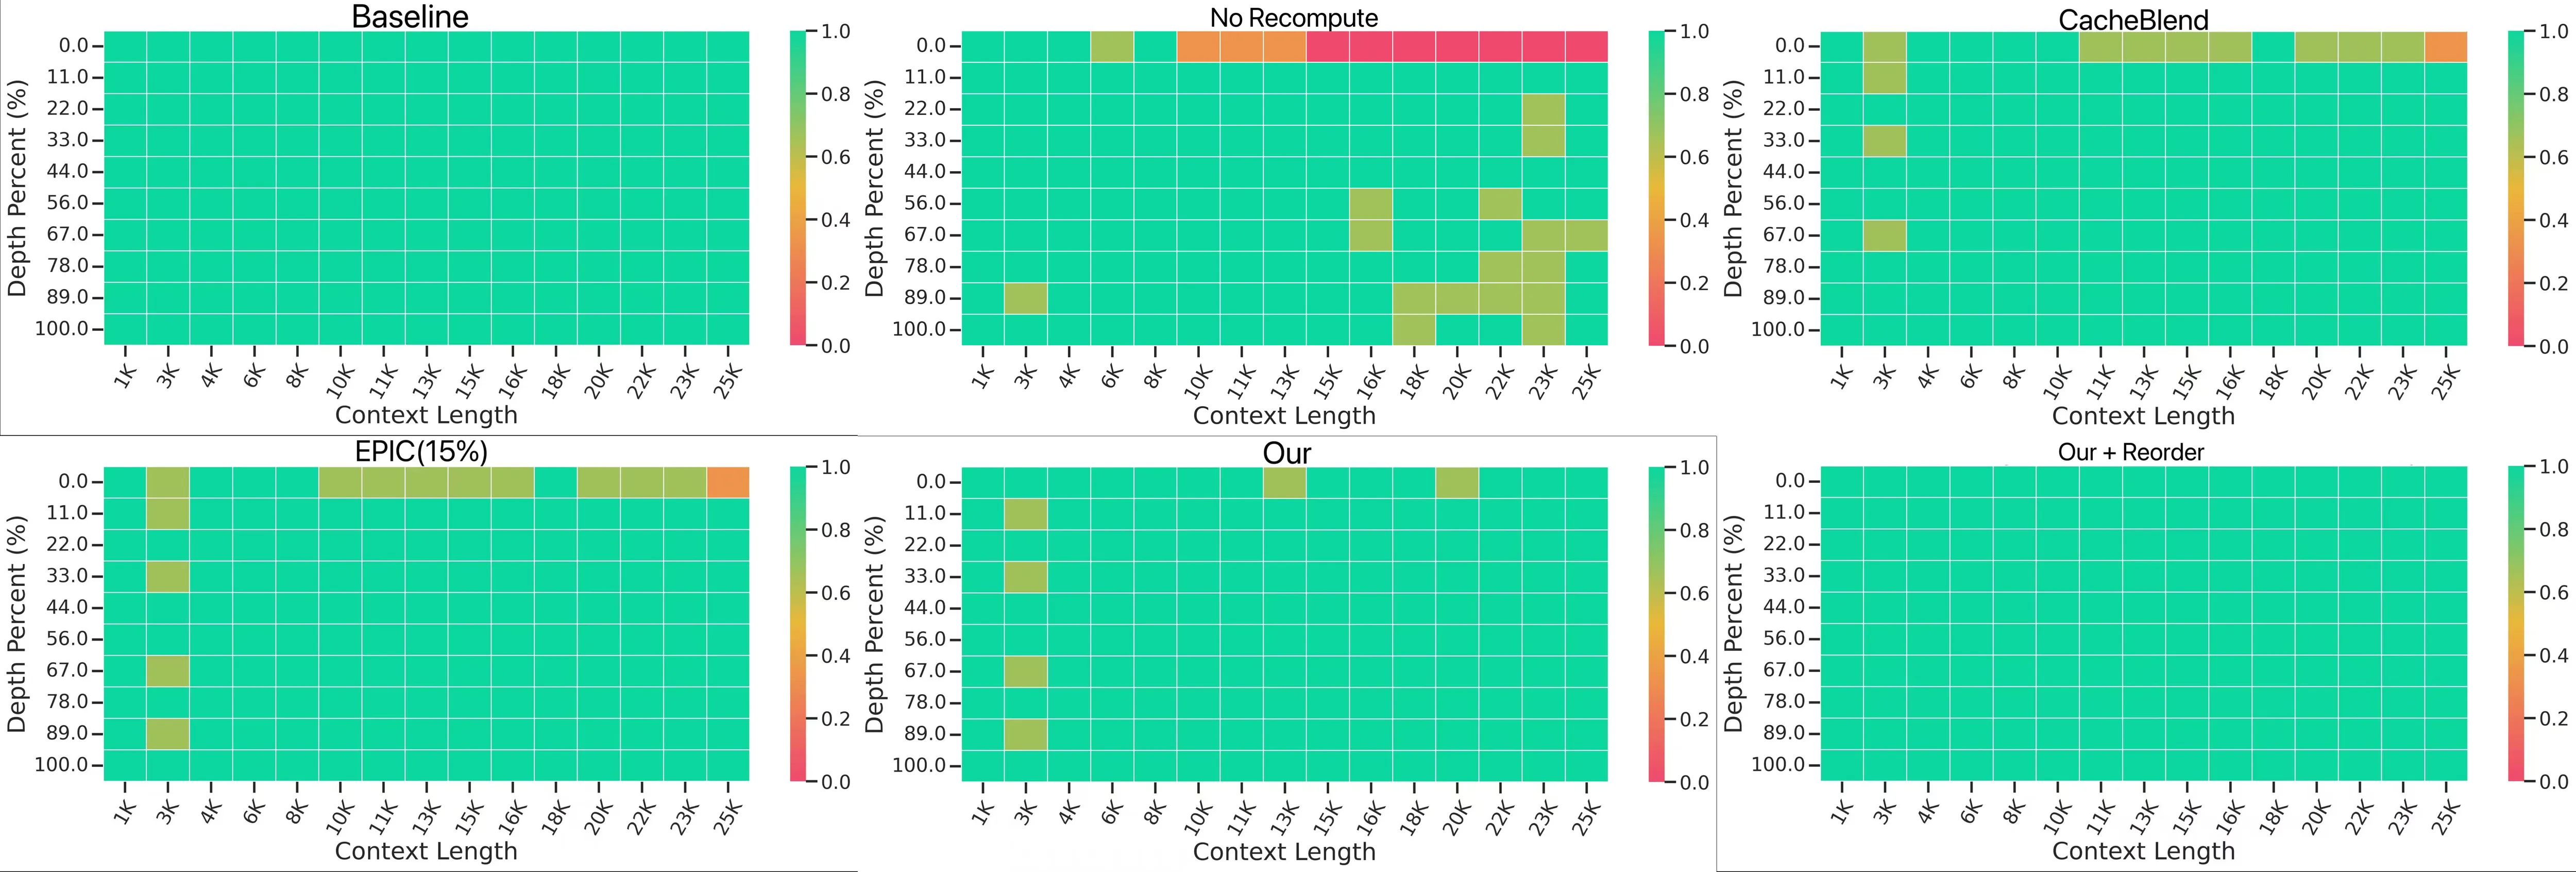
Baseline 在所有深度和上下文长度下维持近完美检索准确率。Chunk-wise prefilling without recomputation 随上下文长度增加呈现严重退化。Selective KV recomputation 大幅缓解此失效模式,Our 和 Our + Reorder 在大部分深度恢复高检索准确率。
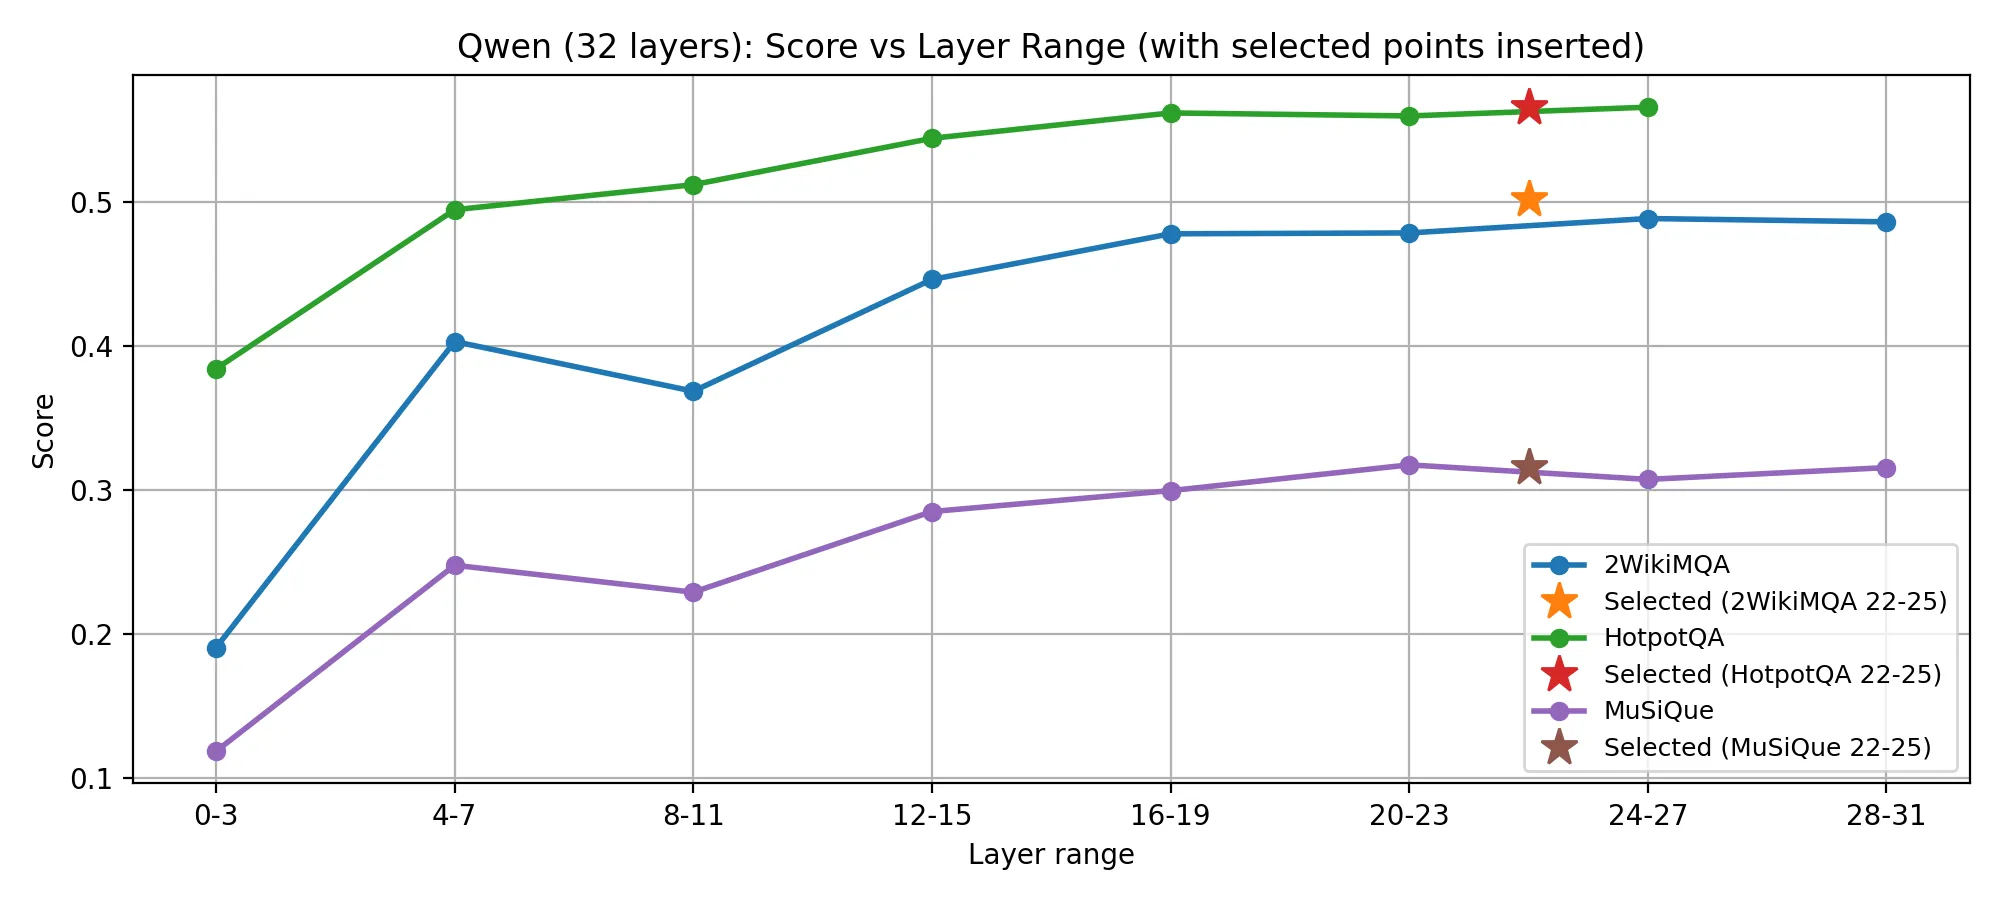
中间偏晚期层(特别是 layers 22–25)的注意力范数 consistently yield 最佳下游检索准确率。
七、相关工作
| 方法 | 核心思路 | 与 InfoFlow KV 的区别 |
|---|---|---|
| H2O | 基于回收/重要性启发式丢弃 KV | eviction 方法,不恢复跨 chunk 交互 |
| StreamingLLM | 基于 recency 的 KV 驱逐 | 适用于流式场景,但不处理 chunk 拼接问题 |
| Pyramid KV | 压缩 KV 精度 | 降低存储,不涉及选择性重计算 |
| CEPE | 轻量编码器并行编码 chunks | cross-attention 架构,需 decoder 修改 |
| CacheBlend | 基于缓存 KV 与完整上下文偏差选择 | 不考虑位置/RoPE 结构对信息流的影响 |
| EPIC | 固定重计算 chunk 初始 token | 位置固定,不感知语义相关性 |
八、总结
核心贡献
- 信息流视角:首次将选择性 KV 重计算重新定义为信息流恢复问题,提出 prompt-conditioned 注意力范数作为 token 重要性信号
- 推理一致的 RoPE 排序:证明可靠的 token 选择需要推理一致的 RoPE 排序,引入检索 chunk 的全局位置重建
- Chunk 重排序策略:基于信息流关键 token 的可选 chunk 重排,进一步提升下游注意力效果
- 广泛的实验验证:在 3 个 LLM(Qwen3-14B, LLaMA-3.1-8B, GLM-4-9B)和 1 个 VLM(Qwen3-VL-8B)上持续优于 CacheBlend 和 EPIC
技术影响
- 在 LongBench 多跳推理任务上显著提升 accuracy(如 Qwen 2WikiMQA 从 0.39→0.51)
- 在 VLM 基准上同样有效(ChartQA +2.16pp, OCRBench +3 points)
- 多 GPU sequence parallel 设置下实现最高 3.49× 加速
- 避免 ring attention 的全量 KV all-gather,仅通信选中的少量 token
局限性
- 不规则注意力掩码:选择性重计算需要关注动态选定的 token 子集到完整上下文,产生既非完全密集也非严格因果的不规则掩码,现有优化 attention kernel(如 FlashAttention)不支持此模式,导致硬件利用率次优
- 需要 HTML 版本:依赖 arXiv HTML 版本的数学公式提取,PDF 提取可能丢失公式结构
- 全层重计算开销:当前实现对所有 Transformer 层重计算选中 token,partial-layer recomputation 虽可行但未深入探索
九、参考资源
- arXiv: https://arxiv.org/abs/2603.05353
- 代码: 未公开
- License: CC BY 4.0 (https://creativecommons.org/licenses/by/4.0/)
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 主流程图:chunk-wise prefill → 全局位置重建 → 注意力范数 token 选择 → 选择性重计算 → 可选 chunk 重排 | main_overview.png |
| Figure 3 | Needle-in-a-Haystack 准确率热力图:不同上下文长度和 needle 深度下的鲁棒性分析(Appendix A) | needle_in_a_haystack.png |
| Figure 4 | Layer-wise 注意力范数分析:不同 Transformer 层对 haystack 检索准确率的影响(Appendix B) | norm_layer_selection.png |
| Figure 2 | (SVG inline in HTML) - 速度-准确率 Pareto 曲线对比四种 RoPE 配置 | 内联 SVG,未单独提取为 PNG |