HyMCache: A KV Cache Framework for Multi-Turn LLM Serving with CXL-Hybrid Memory
Cost-Efficient Remote KV-Cache Tier Using CXL-Hybrid Memory for Scalable LLM Serving
HyMCache: KV Cache Framework for Multi-Turn LLM Serving with CXL-Hybrid Memory
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | HyMCache: A KV Cache Framework for Multi-Turn LLM Serving with CXL-Hybrid Memory |
| 作者 | Hakbeom Jang¹, Inho Song², Sam H. Noh², Jongryool Kim¹ |
| 机构 | ¹SK hynix America, ²Virginia Tech |
| 论文 | arXiv:2607.18141 |
| 代码 | 无公开代码仓库 |
| 发布 | 20 Jul 2026 (v1), 13 pages (9 body + 4 appendix) |
| 许可 | arXiv.org perpetual non-exclusive license |
二、核心思想
问题定义
LLM 推理正从单轮 prompt 转向长上下文、多轮对话和 agentic 应用,KV cache reuse 成为减少重复计算的关键。但这将瓶颈从计算转移到了存储和分发可复用 KV 状态的内存层。GPU HBM 和主机 DRAM 成本太高,无法扩展到 TB 级共享上下文容量。远程 SSD 方案(如 NVMe-oF)虽然成本低,但延迟高且软件栈复杂。
现有 CXL 内存扩展方案面临两难:纯 DRAM 的 CXL memory expander/pool 提供低延迟但扩展成本高;storage-backed 方案容量大但需要存储节点软件来 staging。
解决方案概述
HyMCache 提出了一种结合两者优势的中间路线:CXL-hybrid memory (CXL-HM)——一个在 CXL 接口后面融合了少量片上 DRAM 和大量 SSD 容量的设备。HyMCache 利用多轮 KV cache 访问的三个关键特性:
- 读主导(read-dominant):已生成的 KV blocks 在多轮间只读不写
- 可预测(predictable):prefix-cache lookup 可以提前获知下一轮需要的 KV blocks 有序列表
- 追加写入(append-only):每轮只写入新生成 token 对应的 KV blocks
基于这些洞察,HyMCache 设计了两个核心机制:
- Request-level prefix prefetching:通过 issue–wait–release API 让 serving runtime 提前将 KV blocks prefetch 到 CXL-HM 内部 DRAM
- Opportunistic write buffering:将写操作隔离到独立 buffer,异步批量刷入 SSD,避免与读路径竞争
在真实 CXL-HM 原型上评估:与同等 DRAM 预算的本地 LMCache 相比,单机部署加速 3.0×,PD 分离部署加速 1.45×;与 1TB 分布式 DRAM 的 Mooncake 相比,性能仅低约 30%,但 DRAM 用量少 16×。
三、技术架构
整体框架图
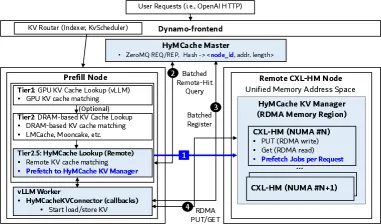
HyMCache 集成于 Dynamo + vLLM 栈中,核心由四个软件模块和一个硬件组件组成:
┌─────────────────────────────────────────────────────────┐
│                   LLM Worker (vLLM + Dynamo)              │
│  ┌──────────┐  ┌──────────┐  ┌──────────┐  ┌─────────┐ │
│  │ GPU KV   │  │ Lookup   │  │ Master   │  │ KV Conn │ │
│  │ Cache    │  │ Module   │  │ Module   │  │ ector   │ │
│  └──────────┘  └──────────┘  └──────────┘  └─────────┘ │
│       │             │               │            │        │
│       ▼             ▼               ▼            ▼        │
│  [RDMA over 100/200 Gbps NIC]                                 │
└──────────────────────┬────────────────────────────────────┘
                       │ RDMA GET/PUT
                       ▼
┌─────────────────────────────────────────────────────────┐
│              CXL-HM Remote Storage Node                    │
│  ┌──────────────────────────────────────────────────┐   │
│  │         HyMCache KV Manager                        │   │
│  │  ┌────────────────────────────────────────────┐  │   │
│  │  │     CXL-HM Device (FPGA-based prototype)    │  │   │
│  │  │  ┌─────────────┐  ┌──────────────────────┐ │  │   │
│  │  │  │ Internal     │  │ SSD-Backed Region    │ │  │   │
│  │  │  │ DRAM (64 GB) │  │ (2 TB TLC NAND)      │ │  │   │
│  │  │  │ [staging]    │  │ [capacity tier]      │ │  │   │
│  │  │  └─────────────┘  └──────────────────────┘ │  │   │
│  │  │  Prefetch API:                               │  │   │
│  │  │  chm_prefetch_object() → chm_prefetch_wait() │  │   │
│  │  │           → chm_prefetch_release()           │  │   │
│  │  └────────────────────────────────────────────┘  │   │
│  └──────────────────────────────────────────────────┘   │
└─────────────────────────────────────────────────────────┘
多级 KV Cache 层次结构
论文使用 NVIDIA G1–G4 分类框架:
| Tier | 名称 | 典型系统 |
|---|---|---|
| G1 | GPU HBM | vLLM PagedAttention |
| G2 | Host DRAM | LMCache, Mooncake (local) |
| G3.5 | CXL-HM (DRAM+SSD) | HyMCache (本文) |
| G3 | Local SSD | KV offloading |
| G4 | Remote storage | Mooncake NVMe-oF, remote DRAM pools |
核心设计决策
1. 为什么 CXL-HM 优于传统 DRAM-SSD 分层
传统 DRAM-SSD 分层的远程访问路径:
- Worker 查询 metadata server 获取 block 所在节点
- 请求转发到存储节点
- 存储节点二次元数据查找判断 block 在 DRAM 还是 SSD
- 若在 DRAM,返回 RDMA 地址;若在 SSD,先 stage 到 DRAM buffer 再返回新地址
CXL-HM 路径:
- Worker 查询 metadata server
- Metadata server 直接返回最终
<node_id, addr> - Worker 立即发起 RDMA read/write,无需额外地址解析或软件 staging
2. 多轮工作负载特征分析
通过对 Llama-3.1-8B + vLLM 的多轮 chat 工作负载分析,发现四个关键特性:
Observation ① Read traffic grows across turns:累积上下文增长导致每轮需要 reload 更多 prefix KV blocks
Observation ② KV reuse is read-heavy and read-only:已生成的 KV blocks 在多轮间只读不修改
Observation ③ Sequential KV reads with weak locality:KV blocks 按 context 顺序顺序读取,呈现 one-hit-wonder 模式——每个 block 在一轮中被读取一次后短期内不会被再次访问。例如 Turn 6→7 增加的 prefix-read footprint 就超过 64 GB。这使 LRU 等基于近期性的缓存策略失效
Observation ④ Writes are append-only:每轮只写入新生成 output tokens 对应的 KV blocks,写流量在多轮间相对稳定
3. LRU 在 CXL-HM 上的失败原因
商业 CMM-H 设备使用透明 LRU 缓存管理内部 DRAM。对于多轮 LLM 工作负载,LRU 存在两个致命问题:
- LRU-induced refills:one-shot-wonder blocks 在被消费后仍留在缓存中,占据了下一轮真正需要的 prefix blocks 的空间
- Dirty eviction:新写入的 KV blocks 为防数据丢失被快速回写到 flash,导致读流量与后端 writeback 交错,降低有效读带宽
4. CXL-HM 硬件原型设计
针对 LLM 服务定制的 CXL-HM 设计:
KV-object prefetching:serving runtime 通过 prefix-cache lookup 获知有序 KV objects 列表,传递给 CXL-HM 进行预取
Latency-hiding staging window:固定深度的 staging window + 可扩展的 SSD-to-DRAM refill pipeline。内部 DRAM 作为 latency-hiding staging window 而非容量缓存
Read-prioritized write-isolated KV flushing:预留小 write-side buffer,admitted KV objects 异步批量 flush 到 SSD,preferably when read pressure is low
Prefetch API(issue–wait–release 协议):
chm_prefetch_object(ptr, size)— 将 object 从 SSD region prefetch 到内部 DRAM,返回 request handlechm_prefetch_wait(req)— 等待 prefetched object 就绪chm_prefetch_release(req)— 释放 internal DRAM staging region
5. HyMCache 软件模块
Master:维护全局 metadata,映射每个 prefix/KV identifier 到远程访问信息(target CXL-HM node, remote address, length)。metadata footprint 极小:10 TB remote KV capacity(16 MB blocks)对应 ~6.5×10⁵ KV objects,仅需 ~40 MB(64 B/metadata entry)
Lookup:early remote-hit matching,batched metadata lookup,最多 32 blocks/request 的批量查询。一旦第一个 remote hit 识别目标节点,立即对剩余候选块发出 prefetch
KV Connector:轻量级 vLLM KV-transfer callback 集成。 unmatched prefix blocks 通过 batched RDMA reads 加载到 GPU KV cache。host-side CPU staging buffer(默认 5 GB)。remote KV 不可用时 fallback 到 recomputation(10 秒超时)
KV Manager(CXL-HM 侧):协调并发请求的 prefetch,动态分配 prefetch window(每请求最多 ~128 MB,即 16 MB blocks 的 8 个或 32 MB blocks 的 4 个)。每个 prefetched block 用 opaque read token 管理
Unified CXL-HM Address Space:每个 CXL-HM device 暴露为 CPU-less NUMA node。使用 request-level NUMA assignment(round-robin 或 load-aware),保持同一请求的 KV blocks 有序访问
核心公式
Metadata footprint estimation:
其中 。对于 10 TB / 16 MB blocks:,metadata ≈ 40 MB。
Prefetch window sizing:
其中 为 KV block 大小, 为该请求的前缀命中数。对于 16 MB blocks:;对于 32 MB blocks:。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| CXL-HM for LLM serving | 首次将 CXL-hybrid memory(DRAM+SSD)引入 KV cache tiering,在 SSD 成本和 DRAM 延迟之间取得平衡 | Table 1:15.36 TB 容量下,DRAM 成本 ~815K,CXL-HM 成本比 ~2.9× base NAND,差距巨大 |
| Workload-characterized DRAM management | 发现多轮 LLM KV cache 访问的 read-dominant、sequential、weak-locality 特性,证明 LRU 在此场景下失效 | Section 3.1 profiling + Figure 5:LRU 下 bandwidth 从 RDMA line rate 崩溃到 ~5 GB/s |
| Issue–wait–release prefetch API | 让 serving runtime 控制 CXL-HM 内部 DRAM 的 prefetch,将 predictability 转化为低延迟 | Section 4.2:prefetch 开启后峰值带宽接近 200 Gbps 网络限制,端到端延迟降低 14% |
| Opportunistic write buffering | 写路径与读路径隔离,write buffer 满时 skip 而非 stall,避免阻塞 inference | Section 3.3:即使跳过 >15% 的 KV insertion,读性能不受影响 |
| RDMA-based deployment model | CXL-HM 放在远程节点上,workers 通过 RDMA 访问而非 CXL fabric,兼容现有数据中心基础设施 | Figure 1(b):不需要 CXL switch,利用已有 100/200 Gbps NIC |
五、实验设置
硬件配置
PD-disaggregated setup(4P–1D–1S):
- 6× Dell PowerEdge R770:双 Intel Xeon 6730 CPU, 256 GB DDR5, NVIDIA A100 80GB
- 4× prefill workers, 1× decode worker, 1× CXL-HM storage node
- NIC:prefill worker 各 1×100 Gbps(PD path)+ 1×100 Gbps(HyMCache);decode/storage 各 1×200 Gbps
- CXL-HM 原型:FPGA-based,64 GB 内部 DRAM + 2× Gen5 1TB SSD = 2 TB 可见容量
Single-node setup:1× compute node(A100 GPU)直连 CXL-HM remote tier
基线系统
| Baseline | Tier | 容量 | 说明 |
|---|---|---|---|
| Recomputation | None | – | 无 KV reuse,全部重新 prefill |
| GPU Prefix Caching | G1 (GPU HBM) | – | vLLM 原生 prefix caching |
| Local LMCache | G1+G2 | 64 GB/worker × 4 | 本地 DRAM KV 缓存 |
| Distributed Mooncake | G1+G4(remote DRAM) | 1 TB | 分布式 DRAM 远端缓存 |
| Mooncake NVMe-oF | G1+G4(remote SSD) | – | 远程 NVMe-oF SSD 缓存 |
| HyMCache | G1+G3.5(CXL-HM) | 2 TB SSD-backed | 本文方案 |
模型与工作负载
- 模型:Llama-3.1-8B (16 MB/block), Qwen2.5-32B (32 MB/block),FP16/BF16,vLLM block size = 128 tokens
- 基准:Dynamo AIPerf(synthetic mooncake trace),LMSYS dataset(realistic multi-turn)
- Max decode tokens = 1:隔离 KV cache reuse 效果
六、实验结果
PD-Disaggregated Serving(Qwen2.5-32B, AIPerf)
TTFT 性能(Figure 8):
- 在 Turn 7 时,local caches(GPU prefix caching, LMCache)hit rate 已很低,因为有效容量已被超出
- Distributed Mooncake (1 TB) 覆盖约 2/3 的 1.5 TB reusable KV footprint
- HyMCache 通过更大 SSD-backed 容量保留更多 reusable prefix blocks,hit rate 比 Mooncake 高约 10%
- Mooncake TTFT 比 HyMCache 低约 30%,主要来自更低的 DRAM fetch latency 和 shared distributed cache pool
- 但随着 turn 推进,gap 缩小:HyMCache 保留更多小缓存会 evict 的 blocks
Transfer-buffer 敏感性(Figure 10):
- Mooncake 对 transfer buffer 敏感:相同 10 GB host DRAM 下 suffer from severe transfer-buffer pressure
- HyMCache 不敏感:opportunistic insert policy 在 write buffer 满时 skip 而非 stall,10 GB 以上性能不再提升
Single-Node Serving(Llama-3.1-8B, LMSYS dataset)
端到端性能(Figure 11):
- Recomputation:延迟随 turn 递增(累积 prefix 越来越长)
- GPU prefix caching:Turn 3 后开始丢失有效 reuse
- LMCache local CPU caching:Turn 4 后开始丢失有效 reuse
- HyMCache:维持 ~90% hit rate,避免 recomputation latency 增长
- HyMCache 比 local LMCache (64 GB/worker, 256 GB total) 快 3.0×
与 Redis-backed LMCache 对比(Figure 12):
- Redis-only 64 GB:频繁 store failure 破坏 prefix chain
- LMCache (64 GB local) + Redis (64 GB remote):更稳定但仍依赖两级缓存
- HyMCache 在 Turn 6 保持相似延迟分布,证明 remote CXL-HM 可替代 memory-based cache hierarchy
Prefetch 效果(Figure 13)
- Microbenchmark(heavy random reads):prefetch 开启比关闭性能提升 37%
- LMSYS workload:平均远程 KV loading 带宽提升 >35%,峰值接近 200 Gbps 网络限制
- 端到端执行时间降低 14%
成本分析
| 方案 | 容量 | 估算成本 | 成本倍数 |
|---|---|---|---|
| 120× 128GB DDR5 | ~15 TB | ~$782K | 57.5× |
| 60× 256GB DDR5 | ~15 TB | ~$815K | 59.9× |
| Gen5 TLC NAND | ~15 TB | ~$13.6K | 1.0× |
| CXL-HM (Gen5 TLC) | ~15 TB | ~$40K | ~2.9× |
CXL-HM 比 Distributed Mooncake (1 TB DDR5, ~40K per node) 便宜 2.8–3.8×(含 FPGA prototyping overhead)。
与 NVMe-oF 对比(Figure 9)
NVMe-oF over RDMA baseline 性能接近 recomputation:remote KV fetch 频繁超时 fallback 到 recomputation。主要原因:
- Raw NVMe-oF block-device:~23 GB/s(接近 200 Gbps 限制)
- 挂载 XFS 文件系统后:降至 ~6.5 GB/s
- HyMCache 通过 memory-like semantics 避免 file-system stack 在 critical read path 上
七、相关工作
CXL-based Memory Expansion and Pooling
- CXL memory expanders (SK hynix, Samsung), switch-based pools (Samsung, SK hynix, XCENA)
- CXL-aware tiered memory management (TPP)
- HyMCache 不同:target remote KV caching for multi-turn LLM serving 而非 generic memory expansion
Multi-tier KV Cache and Prefetching
- FlexGen, DeepSpeed Inference: GPU/CPU/NVMe partitioning
- LMCache, Mooncake: KV sharing and disaggregated architecture
- HyMCache 不同:提供 CXL-HM based remote memory backend,耦合 serving-level prefix reuse knowledge 与 device-level DRAM staging
DPU-based Storage and Remote KV Caching
- LEED, Gimbal, NVMe-oF target offload, Ditto, FORD
- HyMCache 不同:build memory-addressable remote KV tier using CXL-HM,避免依赖 DPU cores 或 storage-node software
八、总结
核心贡献
- Workload characterization:系统分析多轮 LLM 服务的 KV cache 访问模式(read-dominant, sequential, weak-locality, append-only),揭示 LRU 在此场景下的根本性缺陷
- LLM-targeted CXL-HM design:设计面向 LLM 的 CXL-HM 原型,包含 prefetch API、write-isolated flushing、latency-hiding staging window
- HyMCache framework:集成 Master/Lookup/KV Connector/KV Manager 四大模块到 Dynamo+vLLM 栈,实现 request-level prefix prefetching + opportunistic write buffering
- Real CXL-HM prototype evaluation:在真实 FPGA-based CXL-HM 原型上验证,单机 3.0×、PD-disaggregated 1.45× 超越 local LMCache,仅以 30% 性能差距换取 16× DRAM 节省
局限性
- FPGA prototyping cost:当前 CXL-HM 原型基于 Agilex 7 FPGA board,占成本 91–95%,ASIC 实现后成本将进一步降低
- RDMA deployment only:原型通过 RDMA 访问 CXL-HM,尚未在 native CXL.mem fabric 上评估
- Transfer buffer not eliminated:Mooncake 的性能高度依赖 transfer buffer 大小,HyMCache 对此不那么敏感但仍有 5 GB staging buffer
未来方向
- ASIC 实现的 CXL-HM device(消除 FPGA overhead)
- Native CXL.switch fabric 部署评估
- 扩展到更多模型和工作负载模式
九、参考资源
- 论文: https://arxiv.org/abs/2607.18141
- DOI: https://doi.org/10.48550/arXiv.2607.18141
- NVIDIA CMX: https://www.nvidia.com/en-us/deep-learning-ai/solutions/data-science/context-memory-storage/
- Dynamo: https://github.com/ai-dynamo/dynamo
- NIXL: https://github.com/ai-dynamo/nixl
- LMCache: https://github.com/LMCache/LMCache
- Mooncake: https://github.com/kjyim2/mooncake