FlexInfer: Flexible LLM Inference with CPU Computations
利用CPU计算实现灵活的LLM推理
FlexInfer: Flexible LLM Inference with CPU Computations
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FlexInfer: Flexible LLM Inference with CPU Computations |
| 作者 | Seonjin Na, Geonhwa Jeong, Byung Hoon Ahn, Aaron Jezghani, Jeffrey Young, Christopher J. Hughes, Tushar Krishna, Hyesoon Kim |
| 机构 | Georgia Tech, Intel |
| 论文 | tmpfiles.org PDF |
| 领域 | cs.LG, LLM推理优化, CPU-GPU混合执行 |
二、核心思想
问题定义
LLM推理面临严峻的内存挑战,现有卸载方法存在严重性能瓶颈:
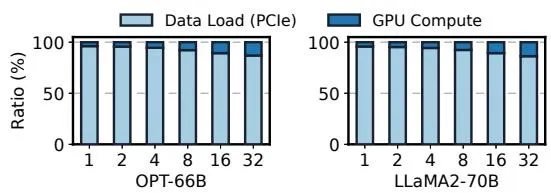
卸载方法的PCIe瓶颈:
| GPU | 模型 | PCIe传输占比 |
|---|---|---|
| A100 | OPT-66B | 91.6% - 97.6% |
| A100 | LLaMA2-70B | 89.2% - 97.3% |
| H100 | OPT-66B | 87% - 96.2% |
| H100 | LLaMA2-70B | 86.3% - 95.8% |
关键发现:即使使用H100 + PCIe 5.0,PCIe传输仍然主导执行时间。
CPU计算的机会
CPU vs GPU性能对比:
| 场景 | CPU优势 | GPU优势 |
|---|---|---|
| Decode阶段 | TPOT降低29.5%-70.8% | - |
| Prefill阶段(短输入) | SPR CPU在batch=1时快16.5%-68.2% | - |
| Prefill阶段(长输入/大batch) | - | GPU显著更快 |
核心洞察:
- Prefill阶段:计算密集,GPU更优(尽管有PCIe开销)
- Decode阶段:内存密集,CPU更优(无PCIe传输)
解决方案概述
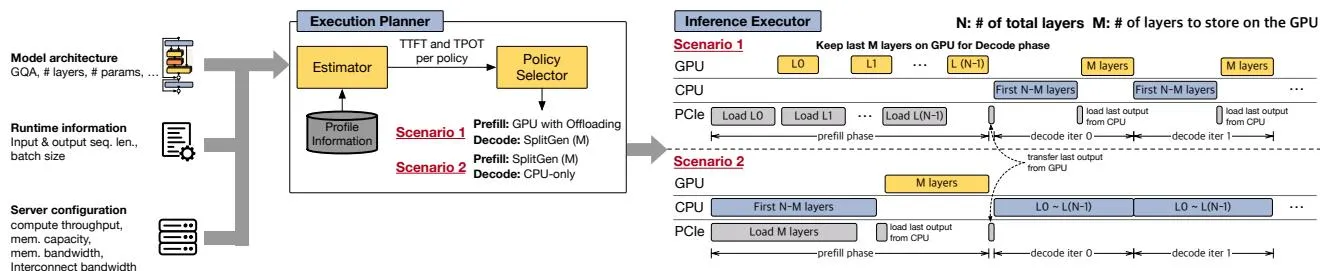
FlexInfer提出阶段感知的动态执行策略选择:
| 组件 | 功能 |
|---|---|
| Execution Planner | 分析硬件和运行时参数,选择最优策略 |
| Inference Executor | 根据选定策略执行推理 |
三、技术架构
整体框架
三种执行策略
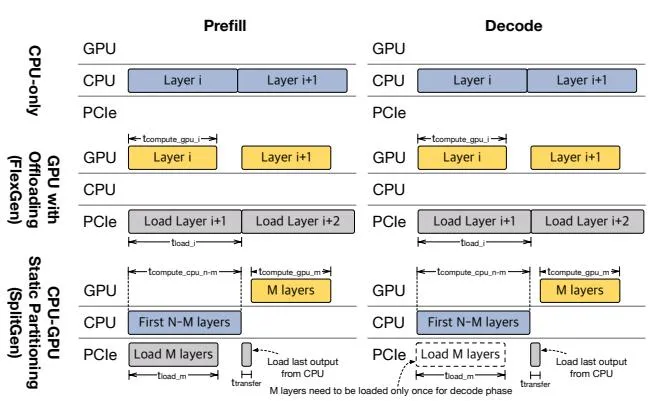
| 策略 | 说明 | 适用场景 |
|---|---|---|
| CPU-only | 所有计算在CPU上执行 | 内存密集、长输出 |
| GPU with Offloading (FlexGen) | 数据从CPU传输到GPU计算 | 计算密集、短输入 |
| CPU-GPU Static Partitioning (SplitGen) | 前N-M层CPU,后M层GPU | 混合场景 |
性能估算器
TTFT估算(Prefill阶段):
CPU-only:
GPU Offloading:
SplitGen:
TPOT估算(Decode阶段):类似公式,考虑KV Cache访问。
策略选择逻辑
FlexInfer为Prefill和Decode阶段独立选择最优策略:
| 场景 | Prefill策略 | Decode策略 |
|---|---|---|
| 短输入、小batch | CPU或SplitGen | CPU-only |
| 长输入、大batch | GPU Offloading | CPU-only或SplitGen |
| 内存受限 | SplitGen | CPU-only |
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| 阶段感知策略选择 | Prefill和Decode独立选择最优策略 | 延迟降低75%-76% |
| 性能估算器 | 分析模型预测TTFT/TPOT | 准确选择最优策略 |
| CPU-GPU混合执行 | 充分利用CPU计算资源 | Decode阶段CPU显著更优 |
| 动态适应 | 根据运行时参数调整策略 | 适应不同batch size和序列长度 |
五、实验结果
实验设置
| 配置 | Server 1 | Server 2 |
|---|---|---|
| CPU | 2× Xeon 8352Y (ICL) | 2× Xeon 6454S (SPR) |
| CPU吞吐量 | 9.0 TFLOPS (BF16) | 144.2 TFLOPS (BF16) |
| CPU内存 | 256 GB | 512 GB |
| GPU | NVIDIA A100 40GB | NVIDIA H100 80GB |
| GPU吞吐量 | 312 TFLOPS (BF16) | 756 TFLOPS (BF16) |
| 互连 | PCIe 4.0 (32 GB/s) | PCIe 5.0 (64 GB/s) |
模型:OPT-30B, OPT-66B, LLaMA2-70B, LLaMA3-70B
基线:CPU-only, FlexGen, FlexGen_Opt, SplitGen
端到端延迟
关键结果:
| 对比 | Server 1加速 | Server 2加速 |
|---|---|---|
| FlexInfer vs FlexGen | 75% | 76% |
| FlexGen_Opt vs FlexGen | 23% | 50% |
| SplitGen vs FlexGen | 37% | 61.7% |
FlexInfer优势:
- 动态选择最优策略
- Prefill用GPU Offloading,Decode用CPU/SplitGen
- 最小化PCIe传输
TTFT和TPOT
OPT-66B结果:
| 指标 | Server 1 | Server 2 |
|---|---|---|
| TPOT降低 | 77.7% | 79.6% |
| TTFT降低 | 匹配FlexGen | 6.6% |
关键发现:
- SplitGen在大batch时TTFT增加7.7×(Server 1)和2.6×(Server 2)
- FlexGen_Opt在Server 1上TPOT仅降低7.7%,Server 2上降低49.1%
- FlexInfer始终选择最优策略
PCIe流量分析
| 策略 | PCIe流量 | 说明 |
|---|---|---|
| CPU-only | 无 | 所有数据在CPU内存 |
| SplitGen | 最小 | 仅传输CPU→GPU输出 |
| FlexGen | 最高 | 传输权重和KV Cache |
| FlexGen_Opt | 中等 | 部分数据在GPU内存 |
| FlexInfer | 动态优化 | 根据策略选择 |
不同输入长度
| 输入长度 | Server 1加速 | Server 2加速 |
|---|---|---|
| 128-1024 | 72.9% | 70.2% |
FlexInfer在所有输入长度下一致优于FlexGen。
不同输出长度
| 输出长度 | Server 1加速 | Server 2加速 |
|---|---|---|
| 128-1024 | 73.3% | 70.5% |
随着输出长度增加,CPU-only和FlexInfer优势更明显(Decode阶段主导)。
六、相关工作
| 方法类别 | 代表方法 | 特点 | 与FlexInfer的区别 |
|---|---|---|---|
| 卸载方法 | FlexGen, DeepSpeed-ZeRO | CPU内存存储,GPU计算 | 固定策略,PCIe瓶颈 |
| CPU-GPU混合 | HeteGen, PowerInfer | 张量并行或稀疏性 | 固定策略,不适应运行时 |
| 阶段分离 | TetriInfer, Splitwise, DistServe | Prefill/Decode分离GPU | 未利用CPU计算 |
| CPU优化 | IPEX, NeoCPU | CPU专用内核 | 仅CPU执行 |
七、总结
核心贡献
- 阶段感知策略选择:首次为Prefill和Decode独立选择最优执行策略
- 性能估算器:准确预测不同策略的TTFT/TPOT
- CPU-GPU混合执行:充分利用CPU计算资源,特别是Decode阶段
- 显著性能提升:端到端延迟降低75%-76%
技术影响
- 延迟降低:75%-76% vs FlexGen
- PCIe优化:最小化数据传输
- 资源利用:充分利用CPU和GPU
- 适应性:动态适应不同硬件和运行时参数
局限性
- 模型支持:目前仅支持LLaMA和OPT系列
- 策略数量:仅三种基线策略,可扩展
- 离线调优:效率因子需要离线profiling
- 单GPU:仅考虑单GPU + CPU场景
八、参考资源
- 论文:tmpfiles.org PDF
- 相关项目:FlexGen, HeteGen, PowerInfer, IPEX
- 硬件支持:Intel AMX, NVIDIA A100/H100