Flash Sparse Attention: An Alternative Efficient Implementation of Native Sparse Attention Kernel
FSA 通过交换 NSA selected attention 内核的两层循环顺序(从 query 分组改为 KV 块分组),消除小 GQA group 下的 padding 浪费,实现最高 3.5× 内核加速、1.25× 端到端训练加速。
Flash Sparse Attention (FSA):Native Sparse Attention 内核的高效替代实现
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Flash Sparse Attention: An Alternative Efficient Implementation of Native Sparse Attention Kernel |
| 作者 | Ran Yan*, Youhe Jiang*, Binhang Yuan†(* 共同一作,† 通讯作者) |
| 机构 | 香港科技大学(The Hong Kong University of Science and Technology) |
| 论文 | arXiv:2508.18224 |
| 代码 | https://github.com/Relaxed-System-Lab/Flash-Sparse-Attention |
| 图表数 | 11 张图 |
摘要要点: 稀疏注意力(sparse attention)在降低长上下文 LLM 训练/推理计算成本方面潜力巨大。Native Sparse Attention(NSA)是当前 SOTA 的原生可训练、硬件对齐稀疏注意力方案,能在保持接近 full attention 精度的同时带来显著的系统级性能收益。然而 NSA 的内核实现依赖 query-grouping(查询头分组) 策略,只有在 GQA group size 足够大时才高效;而现代 LLM 普遍采用较小的 GQA group(g ∈ {1,2,4,8}),这严重限制了 NSA 算法优势的实际落地。
本文提出 Flash Sparse Attention (FSA),通过一套替代性的内核设计,使 NSA 计算能在各种较小 GQA group size 的主流 LLM 上高效运行。相比原版 NSA 内核,FSA 实现:
- (i) 内核级延迟:最高 3.5×、平均 1.6× 降低;
- (ii) 端到端训练:最高 1.25×、平均 1.09× 加速;
- (iii) 端到端 prefill:最高 1.36×、平均 1.11× 加速。
二、核心思想
问题定义
Full attention 的二次复杂度是长上下文 LLM 的核心瓶颈——在 64k 上下文下 attention 可占解码延迟的 70–80%,8B 模型处理百万 token prompt 在单卡上可能耗时约 30 分钟。稀疏注意力让每个 query 只关注 KV 的一个子集,理论上大幅降低运算量,但理论 FLOPs 节省往往无法转化为实际墙钟加速,因为每个 query 动态选择不同的 KV 会导致不规则的 HBM 访存,GPU 大量时钟周期耗在等待非连续内存读取上。
NSA 为解决系统侧难题,为 selected attention 模块设计了两层循环内核:
- 外循环:加载一个 query token,并把共享同一 KV head 的多个 query attention head 打包(batch query heads);
- 内循环:迭代加载被选中的 KV block 并做注意力计算。
该策略在 GQA group size 足够大时有效。但问题出在硬件对矩阵乘 tile 形状的约束:NVIDIA GPU 的 warp 级 MMA PTX 指令要求 tile 每个维度不小于某阈值(Hopper 上至少 8)。当 GQA group size 较小(g < 8)时,NSA 内核必须把 query head 填充(pad)到 8才能满足硬件要求,对 padding 出来的数据做无谓的数据加载与计算——虽然可用额外 mask 保持结果正确,但浪费了 GPU 资源、拉低了内核性能。
解决方案概述
FSA 的核心洞察极其简洁:交换 NSA selected attention 内核两层循环的顺序。
| 外循环 | 内循环 | 打包对象 | |
|---|---|---|---|
| NSA | query tokens | KV blocks | query heads(共享同一 KV head) |
| FSA | KV blocks | query tokens | 关注同一 KV block 的非连续 query tokens |
由于关注同一个 KV block 的 query token 数量通常远大于硬件要求的阈值,FSA 天然满足 tile 形状约束,无需任何 padding,从而显著减少不必要的访存与 FLOPs。
FSA 的优势伴随两个挑战:
- 非连续访存:按 query token 打包会带来非连续内存访问,降低 GPU L2 cache 命中率;
- 跨块归约:单个 query token 的注意力结果需要在多个不同 KV block(分属不同 thread block)之间做 online softmax 与结果累加,正确性实现复杂。
三、技术架构
3.1 循环顺序对比(设计原则)
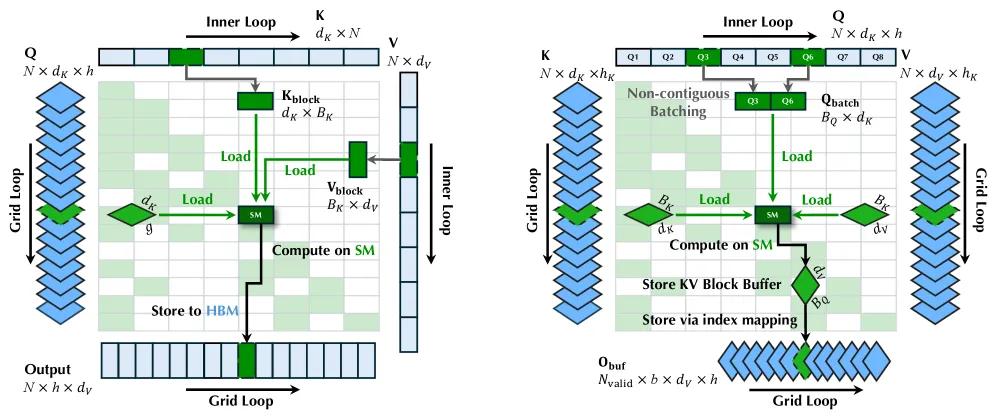
Figure 1 直观展示了两者的差异。NSA 通过打包 query head 满足硬件要求,当共享同一 KV head 的 query head 数量不足时需 padding;FSA 改为打包 query token,从根本上消除 padding 数据的访存与计算开销。
3.2 注意力形式化
Full attention(带因果性):给定序列长度 、query/key head 维度 、value head 维度 、 个 query head、 个 KV head,对第 个 query head:
NSA 稀疏注意力:对第 个 query head、第 个 query token ,通过三类机制 只关注 个 KV token,配合可训练门控分数 :
FSA 只重写其中的 selected attention 内核(NSA 的系统瓶颈),完全保留上述算法语义,仅改变执行顺序与归约方式,不改变输出结果。
3.3 FSA 内核实现(三个内核)
FSA 把 selected attention 拆成三个协作内核,以在避免原子操作(atomic add)的前提下完成跨块归约:
① FSA selected attention 内核
- 每个 thread block 处理一个 (Query head, KV block) 对;对应的 KV block 只从主存加载一次;
- 内层迭代非连续 query token 的 batch,通过索引张量 (加载)/ (存储)访问,二者由 NSA 稀疏选择索引张量 计算得到(记录每个 query token 选中的 KV block 索引);
- 由于稀疏性,每个 KV block 只被 个 query token 的子集关注,故 ;
- Early return:当 中记录的 query batch 耗尽,thread block 提前返回,不再有任何访存与计算;
- 反向传播类似,但 直接从前向缓存中读取,无需重算索引张量(这是反向加速尤为显著的原因)。
② FSA online softmax 内核
- 与 selected attention 内核结构类似,但:按 KV head 调用、不加载/计算 V 张量、不存储中间注意力分数,仅为每个 (query token, KV block) 对存储一个标量(running max / sum-of-exp 统计量);
- 保证在处理第 个 KV block 的 thread block 中, 能用正确的历史 running maximum 做缩放,维持数值正确性。
③ FSA reduction 内核
- 引入的 FLOPs 可忽略;对每个 query token,加载其 个 KV block 的部分结果并写出最终注意力结果;
- 为什么要独立归约:单个 query 的结果分散在多个独立 thread block(各处理不同 KV block)中计算,若在 selected attention 内核里直接归约就必须用原子加来防竞态——原子操作开销高昂。FSA 因此解耦”计算”与”累加”:先由 selected attention 内核把带 online softmax 的部分结果写入中间缓冲,再由专用 reduction 内核高效归约成最终输出。
3.4 访存量与 FLOPs 分析(FSA 优势的理论依据)
假设 、每个数据占 2 字节、KV block 数 、每个 query token 以等概率关注各 KV block。
FSA 三内核合计:
其中各内核分解:selected attention 内核 字节、 FLOPs;online softmax 内核 字节、 FLOPs;reduction 内核 字节、FLOPs 可忽略。
NSA selected attention 内核: 启动 个 thread block,外循环加载 1 个 query token 及 个共享 KV head 的 Q head;当 GQA < 8 时必须加载 8 个 query head( 元素)再 mask 掉多余结果:
关键对比: 在 、序列长度 64K、GQA = 4(LLM 常见配置)下,FSA 理论上把访存量降到 NSA 的 21.3%、FLOPs 降到 56.2%。且 越大 FSA 优势越明显——NSA 对大 KV block 存在固有低效:为维持因果性,对部分违反因果的 KV block 需 mask 掉大量 token,造成”加载的数据只有一部分有效”的浪费访存。
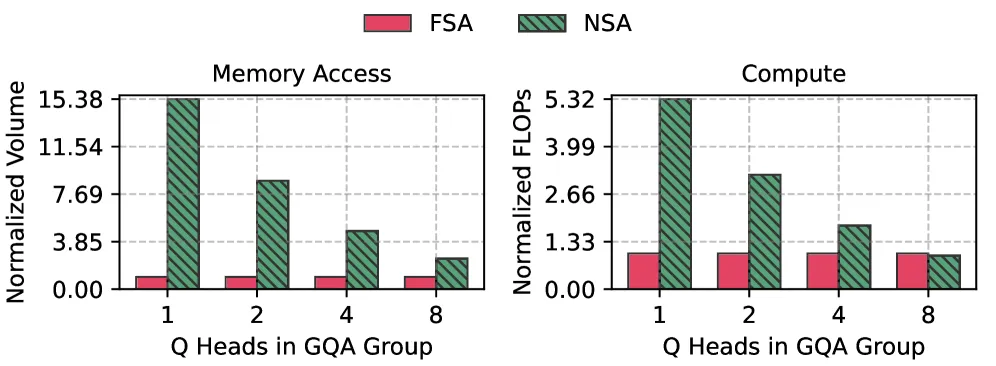
3.5 内核实测性能(break-even 点)
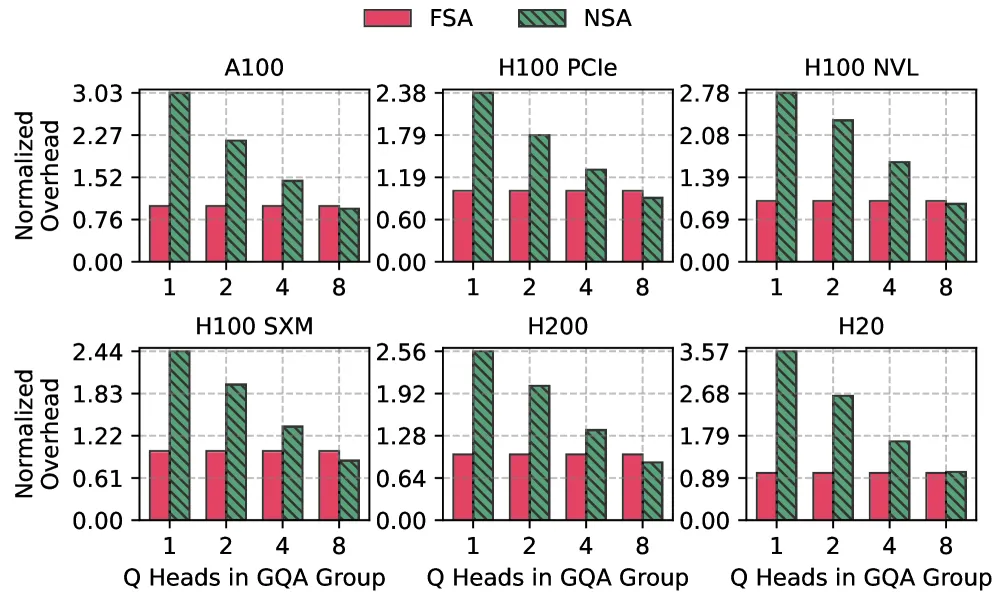
实测证实:尽管 FSA 受非连续访存拖累,其从”减少访存量与 FLOPs”获得的收益仍超额补偿了非连续访存的开销。在多数 GPU 上、 时,FSA 在 GQA group size 区间超越 NSA;具体 break-even 点随硬件与 NSA 超参 、 而变。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 循环顺序交换(KV-block-grouping) | 将 NSA selected attention 内核从 query-token 外循环改为 KV-block 外循环,打包非连续 query token 而非 query head | Figure 1;消除 padding |
| 消除 padding 浪费 | 关注同一 KV block 的 query token 数远超硬件 tile 阈值,无需 pad 到 8 | GQA=4 时访存降至 21.3%、FLOPs 降至 56.2%(式 3/4,Figure 2) |
| 三内核解耦 + 无原子归约 | selected/online-softmax/reduction 三内核分离,用中间缓冲 + 专用 reduction 内核替代原子加 | §3.3;规避 atomic add 高开销 |
| Early return 提前退出 | 索引张量 耗尽即返回,跳过无效访存与计算 | 消融:禁用后掉速最高 25.2% |
| 反向复用前向索引 | 反向直接从缓存读取 ,避免重算 | 反向对 NSA 加速最高 4.32×(Figure 7) |
五、代码实现分析
开源地址:https://github.com/Relaxed-System-Lab/Flash-Sparse-Attention(Triton 实现)。
FSA selected attention 内核前向要点:
- 外循环遍历 KV block,每个 thread block 绑定一个 (Query head, KV block) 对;
- KV block 一次性载入片上(shared memory),仅加载一次;
- 内循环通过索引张量 加载非连续 query token 的 batch();
- 计算部分注意力分数并施加 online softmax,写入中间输出缓冲 (不做归约、不用原子加);
- 耗尽时 early return。
online softmax 内核: 按 KV head 调用,只算 的 running max / sum-exp 标量,省去 V 加载与中间分数存储。
reduction 内核: 对每个 query token,聚合其 个 KV block 的部分结果,结合 online softmax 统计量写出最终输出;反向的梯度归约同理。
反向传播: 与前向对称地非连续加载 query token 并算梯度,但 从前向缓存提取,省去索引张量重算——这是反向加速比前向更显著的关键。
六、实验结果
6.1 实验设置
| 项目 | 配置 |
|---|---|
| GPU | NVIDIA H20(148 TFLOPS,4 TB/s)、H200(989 TFLOPS,4.8 TB/s);NVLink 450 GB/s |
| Baseline | NSA(Triton 内核)、Full Attention(Triton 版 Flash Attention,带因果性) |
| GQA group | ( 即标准 MHA) |
| NSA 超参 | |
| 序列长度 | 内核测试 ;端到端 32K / 64K |
| 端到端模型 | Llama3-8B、Qwen3-14B、Qwen2.5-32B(模型超单卡时用流水线并行) |
| 指标 | 内核执行延迟、训练/推理端到端延迟 |
6.2 内核基准测试
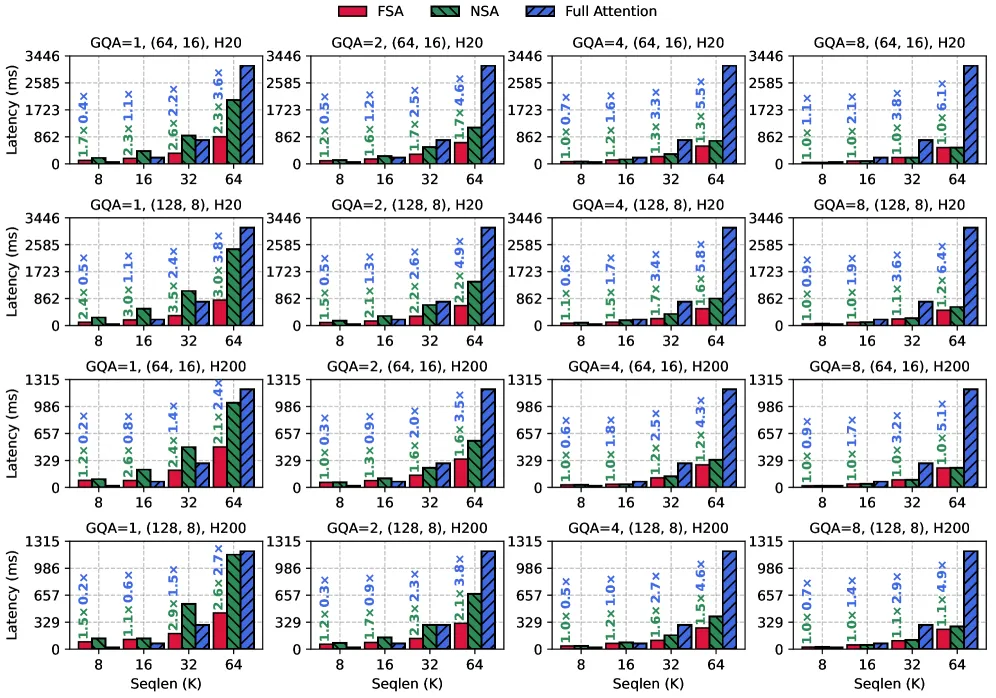
- vs NSA:H20 上最高 3.5×、平均 1.8×;H200 上最高 2.9×、平均 1.4×。GQA 越小()、序列越长(32K/64K)差距越大;峰值 3.5× 出现在 、32K。
- vs Full Attention:H20 上最高 6.4×、平均 2.4×;H200 上最高 4.9×、平均 2.3×。GQA 越大差距越大;峰值 6.4× 出现在 、64K。值得注意:未经 FSA 优化的 NSA 在许多场景反而不如 full attention(如 32K、 时 NSA 持续落后 full attention,而 FSA 领先)。
6.3 端到端性能
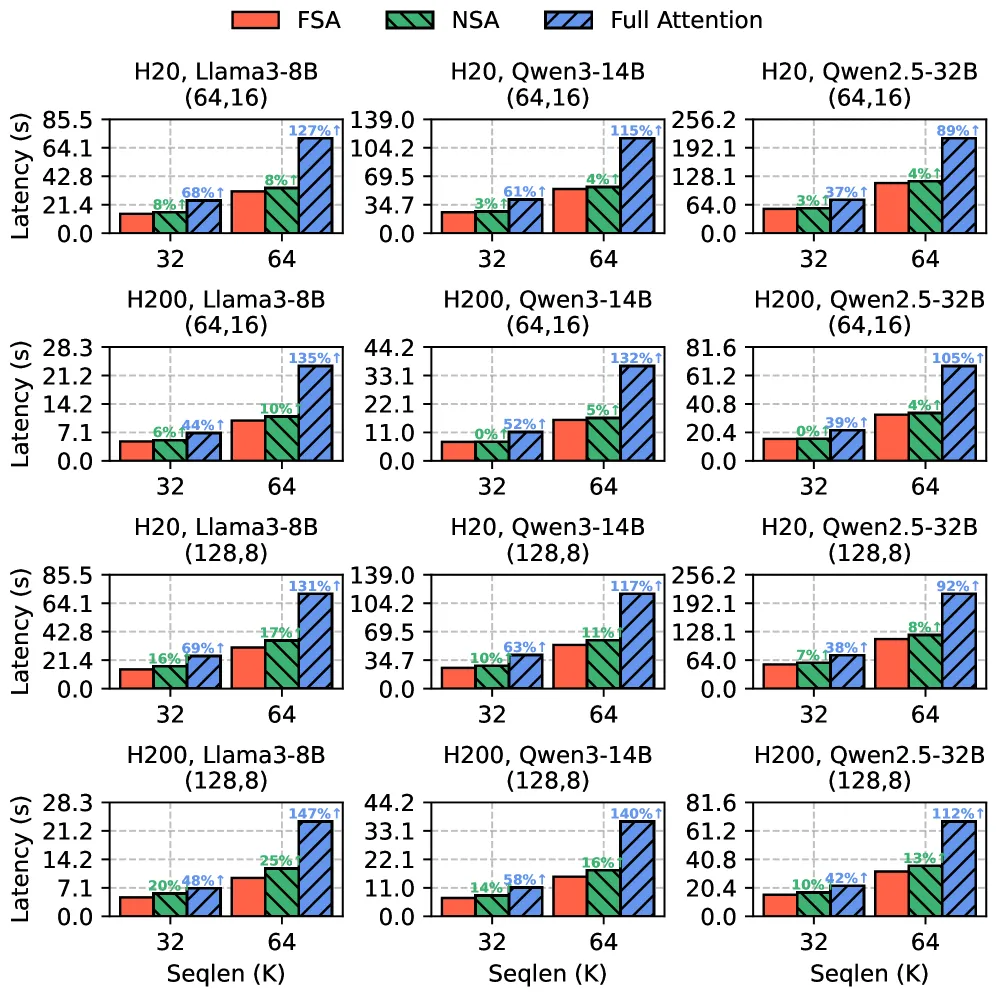
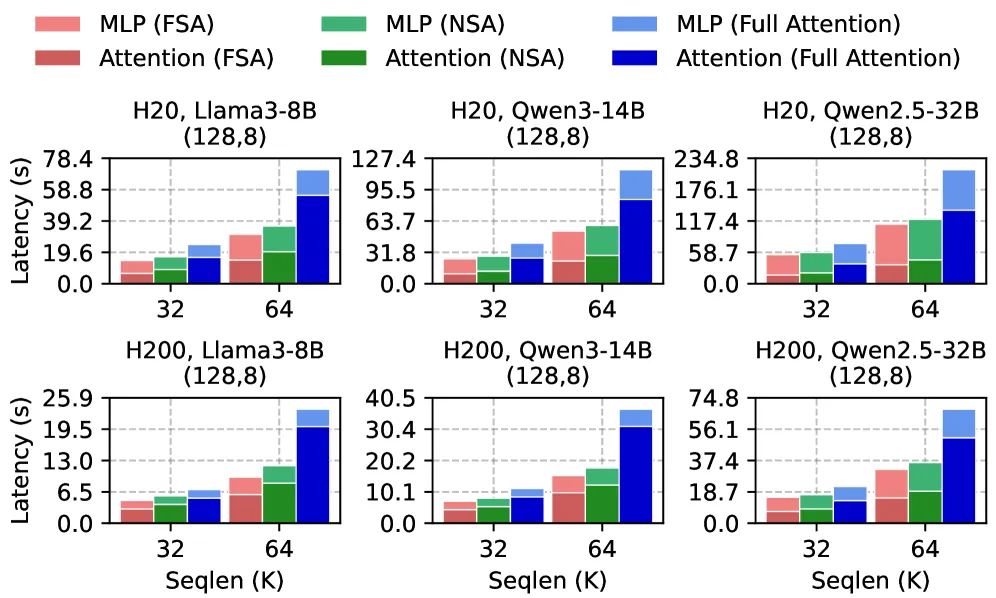
训练: FSA 在所有评测场景一致降低训练延迟——相比 NSA 最高 1.25×、平均 1.09×;相比 full attention 最高 2.47×、平均 1.86×。上下文越长、硬件越强(H200)收益越明显。
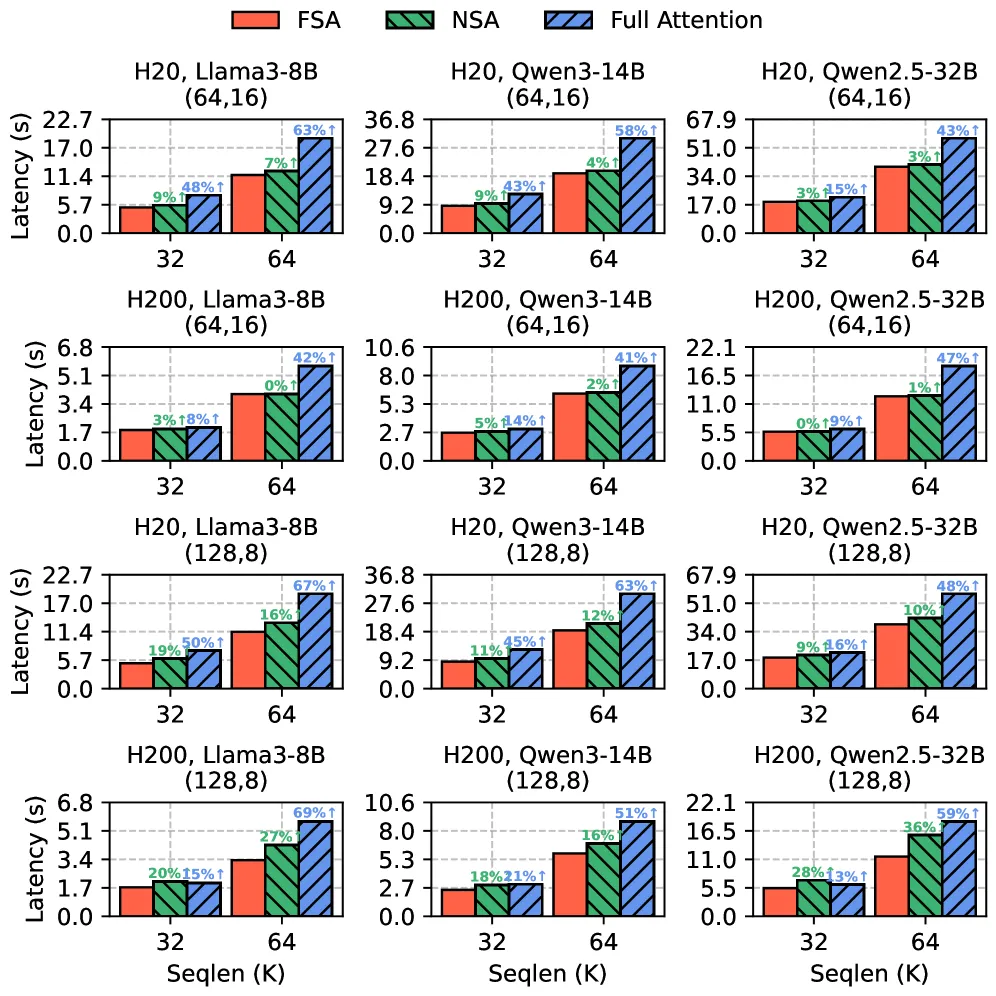
推理(prefill): 相比 NSA 最高 1.36×、平均 1.11×;相比 full attention 最高 1.69×、平均 1.39×。解码(decoding) 阶段 FSA 与 NSA 持平(NSA 通过只加载压缩 token + 选中 token + 滑窗近期 token 降低解码访存)。
6.4 前向/反向 + 三机制拆解
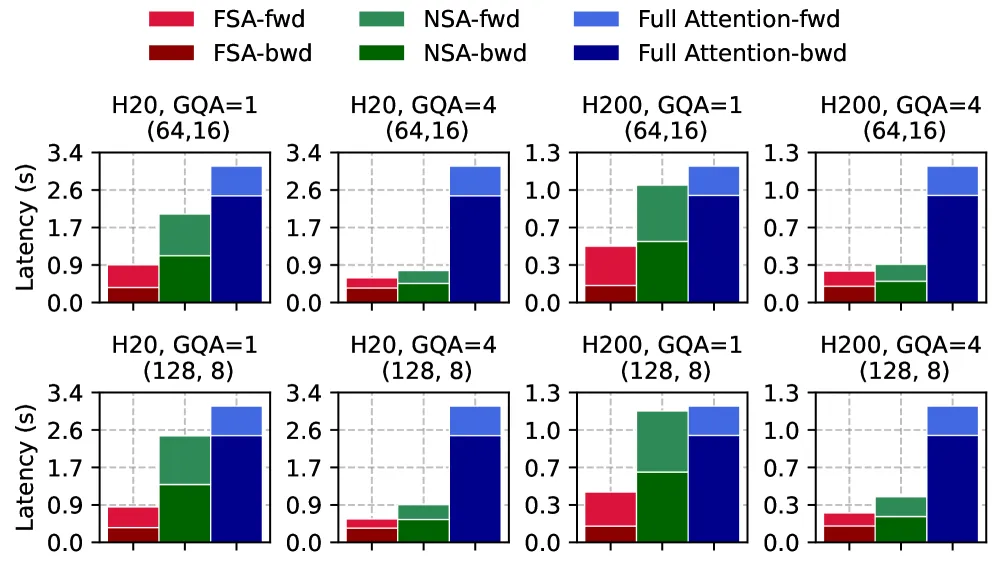
- 前向:vs NSA 最高 2.36×、平均 1.62×;vs full 最高 3.23×、平均 1.83×。
- 反向:优势更大——vs NSA 最高 4.32×、平均 2.59×;vs full 最高 7.45×、平均 6.89×(因 FSA 反向复用前向缓存的索引张量,省去重算)。
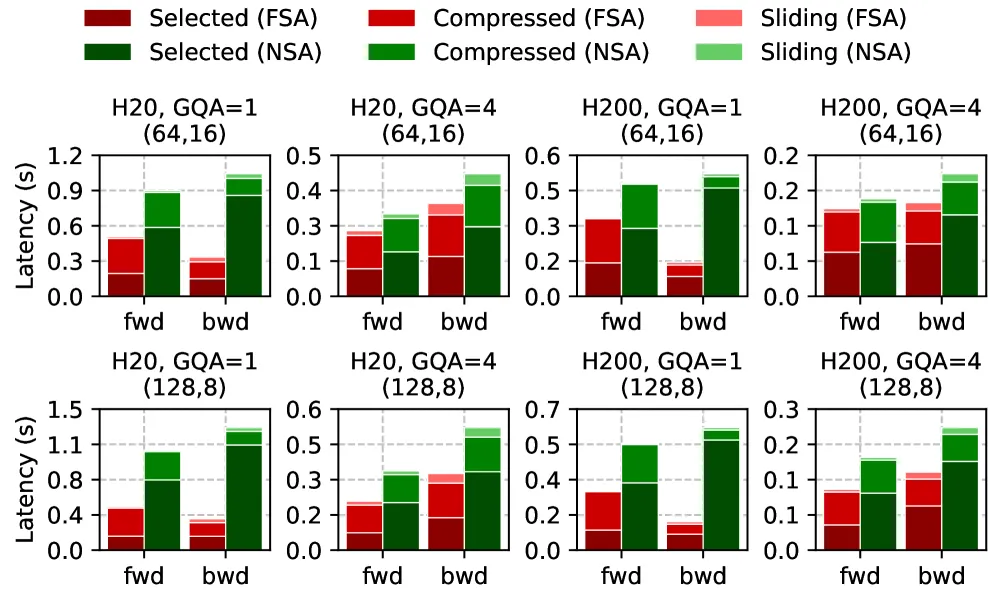
- selected attention 占主导:占总注意力开销最高 79%、平均 65%;FSA 在该关键阶段相比 NSA 最高 7.6×、平均 3.4×——印证 FSA 的收益主要来自对 selected attention 的高效处理。
6.5 消融与正确性
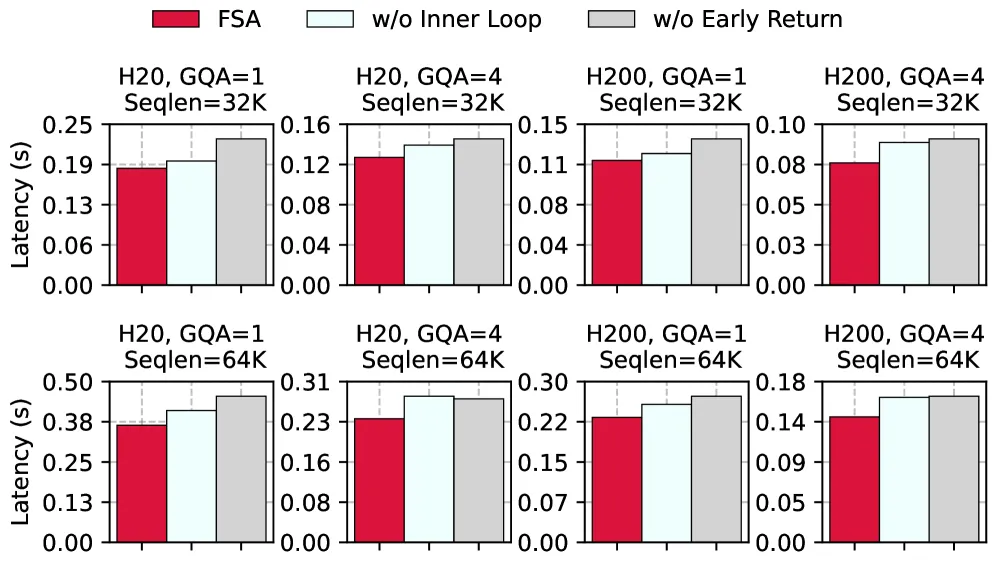
- 消融:禁用内循环优化掉速最高 18.9%、平均 11.9%;禁用 early return 掉速最高 25.2%、平均 18.2%——两项设计均关键。
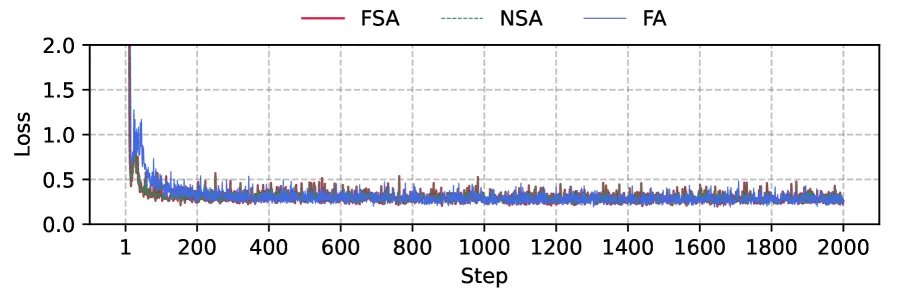
- 正确性:在 ML-ArXiv-Papers 数据集上微调 Llama3-8B(用 FSA / NSA 替换 attention 模块),三者收敛稳定且相近,FSA loss 曲线与 NSA 高度一致,验证内核实现正确。
- 端到端拆解:FSA 的性能提升明确来源于 attention 计算部分。
七、相关工作
- Native Sparse Attention (NSA):原生可训练、硬件对齐的稀疏注意力,将 KV 组织成块,通过 compressed / selected / sliding 三个并行模块处理;FSA 直接以其为优化对象,只重写 selected attention 内核而保留算法。
- Flash Attention:full attention 的高效实现,用两层循环 + online softmax 最小化冗余访存;FSA 的 online softmax 处理借鉴其思想,并作为本文 full attention baseline。
- 其他稀疏注意力与系统优化:论文引用了大量稀疏注意力算法与内核/系统侧优化工作,FSA 属于”在不改算法的前提下做内核级系统优化”这一路线。
八、总结
核心贡献
- 诊断瓶颈:指出 NSA selected attention 内核的 query-grouping 策略在小 GQA group 下因 padding 产生大量无效访存与计算,是限制 NSA 落地的系统瓶颈。
- 提出 FSA:交换两层循环顺序(KV-block-grouping),配合三内核解耦(selected / online-softmax / reduction)与 early return,消除 padding、规避原子操作,在保持 NSA 算法语义不变的前提下大幅提速。
- 系统分析:给出 FSA 与 NSA 的访存量/FLOPs 闭式估计(式 3/4),量化证明 GQA=4 时访存降至 21.3%、FLOPs 降至 56.2%。
- 充分验证:在 H20/H200、多种 GQA 与序列长度、三个主流模型上验证内核级 3.5×、端到端训练 1.25×、prefill 1.36× 加速,并用 loss 曲线验证正确性。
技术影响
- 让 NSA 这类”原生稀疏注意力”算法优势能真正落地到采用小 GQA group 的现代主流 LLM(Llama3、Qwen 系列);
- 证明纯内核级系统优化(不改算法)即可显著提升端到端性能,为稀疏注意力工程化提供了可复用范式。
局限性
- 仅针对 NSA 内核优化,对其他稀疏注意力(如 DSA、Top-K 类)不直接适用;
- 性能收益高度依赖 GPU 架构与内存层次;非连续访存的收益/代价平衡存在随硬件变化的 break-even 点;
- 解码阶段仅与 NSA 持平,未带来额外加速。