FastTree: Optimizing Attention Kernel and Runtime for Tree-Structured LLM Inference
优化树结构LLM推理的注意力内核和运行时
FastTree: Optimizing Attention Kernel and Runtime for Tree-Structured LLM Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FastTree: Optimizing Attention Kernel and Runtime for Tree-Structured LLM Inference |
| 作者 | Zaifeng Pan, Yitong Ding, Yue Guan, Zheng Wang, Zhongkai Yu, Xulong Tang, Yida Wang, Yufei Ding |
| 机构 | University of California San Diego, University of Pittsburgh, AWS |
| 会议 | MLSys 2025 |
| 论文 | OpenReview |
| 代码 | GitHub |
| 许可 | Apache-2.0 |
| 领域 | LLM推理优化、注意力计算、GPU内核、树结构推理 |
二、核心思想
问题定义
在现代LLM应用中,**树结构前缀共享(tree-structured prefix sharing)**非常普遍,包括few-shot learning、文档QA、tree of thoughts等场景。现有的LLM服务系统使用基数树(radix tree)来组织全局KV缓存,促进不同查询之间的缓存重用,从而减少不必要的内存使用。
然而,这些系统仍然依赖传统的计算模式进行注意力操作,导致严重的性能问题:
- 冗余内存加载:共享的KV缓存需要从慢速全局内存为每个查询重复加载
- GPU张量核心利用率不足:解码阶段的GEMV操作难以有效利用高性能张量核心
- 共享内存使用不充分:不同查询的线程块无法直接访问彼此的共享内存进行数据重用
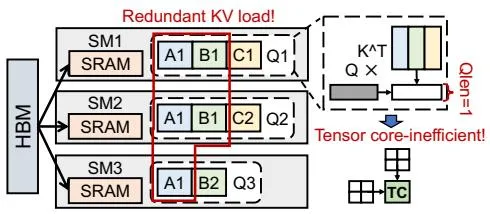
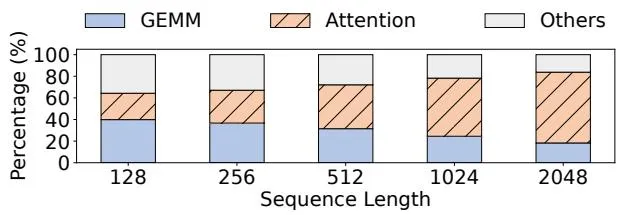
关键观察:
- 当序列长度为2048时,注意力计算可占模型前向时间的65%
- FlashAttention在填充Q矩阵后,有效计算不到1%
- 批处理查询只能帮助增加projection和MLP层的计算强度,无法直接 benefit 注意力
解决方案概述
FastTree提出为高效处理通过基数树共享上下文的查询定制GPU内核:
- 树结构自适应运行时优化:使用贪心启发式算法划分树以最小化开销
- 高效树结构注意力内核:针对树结构查询优化的GPU内核
- 长上下文分割:分割冗长的上下文以缓解尾部效应
三、技术架构
整体框架图
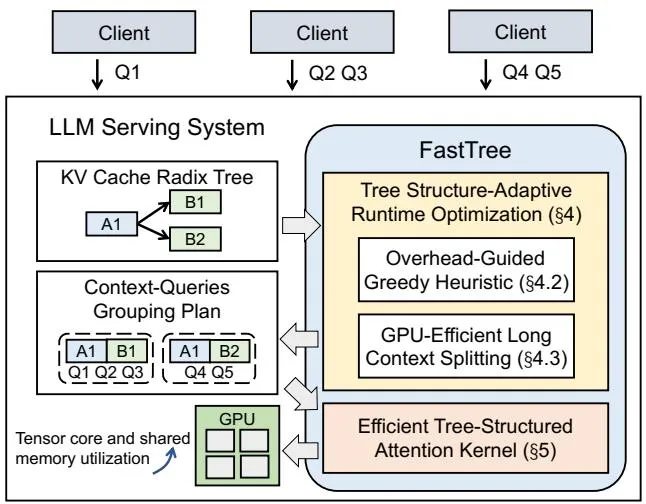
FastTree作为SGLang的插件实现,加速给定基数树的KV缓存注意力计算。系统工作流程:
- 客户端发送查询请求到LLM服务系统
- 系统组织全局KV缓存为基数树
- FastTree运行时生成上下文-查询分组计划
- 高效注意力内核执行优化的注意力计算
核心公式
自注意力计算:
其中d是头维度。
问题形式化:
给定运行时的KV缓存树 ,目标是确定赋值函数 以最小化GPU内核执行延迟:
其中:
- :基于二元边赋值将原始树转换为虚拟树
- :将虚拟树映射为分组计划
- :评估GPU内核延迟
核心组件
1. 树结构自适应运行时优化
上下文-查询分组:
给定KV缓存树,存在多种可能的分组计划。例如,查询 到 共享前缀A1和B1,而查询 到 共享A1和B2。
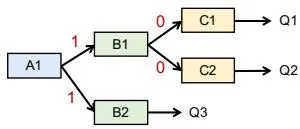
不同分组计划的性能差异:
- 案例1(M=N=8,tile大小=16):计划2需要填充,导致性能下降
- 案例2(M=N=128):计划1引入更多中间结果和归约步骤
二元边赋值:
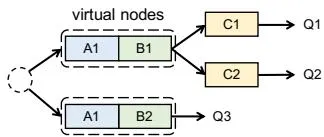
将问题形式化为二元边赋值任务:
- 赋值1:连接两个节点
- 赋值0:保持分离
- 生成虚拟树指导分组策略
2. 贪心启发式算法
算法1:贪心二元边赋值
输入:基数树 T = (V, E)
1: 初始化 A 为每个节点的关联查询数
2: 初始化 L 为每个节点的上下文长度
3: for 节点 v in BFS(V) do
4:   nQ_curr = A[v]  ▷ 当前聚合查询数
5:   len_v = L[v]    ▷ 累积上下文长度
6:   for l in leaves(v) do
7:     nQ_l = A[l], len_l = L[l]
8:     C_0 = SplitKVCost(nQ_curr, nQ_l, len_l, len_v)
9:     C_1 = SplitQCost(nQ_curr, nQ_l, len_l, len_v)
10:    if C_0 >= C_1 then
11:      赋值1给边 v → l
12:      nQ_curr = nQ_curr - nQ_l
13:      L[l] = len_l + len_v
14:    else
15:      赋值0给边 v → l
16:    end if
17:  end for
18: end for开销模型:
填充开销函数:
其中填充函数:
中间结果开销:
3. GPU高效的长上下文分割
问题:GPU利用率不足的两种情况:
- 块级并行不足:启动的线程块数小于GPU容量
- 长尾效应:部分节点具有极长上下文,导致最后几波活跃块数很少
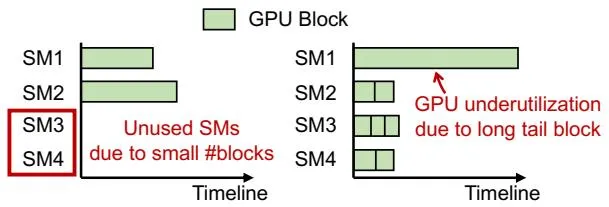
解决方案:在运行时分割超过阈值的长上下文节点,虽然引入中间结果归约开销,但性能提升完全掩盖开销。
高效树结构注意力内核设计
内核架构:
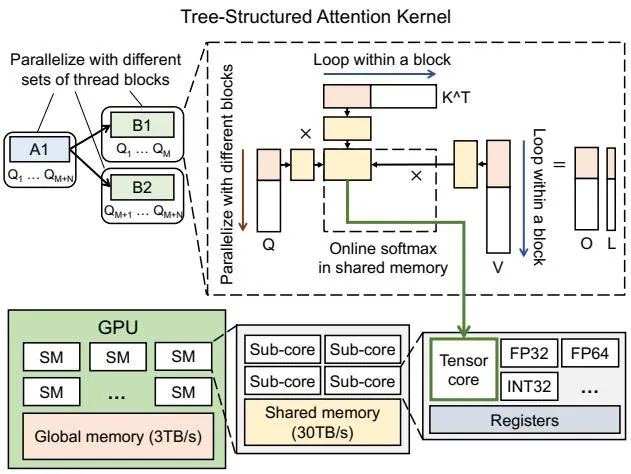
关键设计:
- 单内核处理所有组:不同上下文-查询组分派到不同的线程块集
- FlashAttention风格处理:逐tile处理,利用在线softmax技术
- 多阶段tiling:自适应选择查询维度的tile大小
- 树根附近:更大tile大小,最大化KV重用
- 叶子附近:更小tile大小,避免共享内存浪费
优化效果:
- 减少慢速全局内存事务
- 将GEMV操作转换为GEMM操作
- 有效利用张量核心
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 树结构注意力内核 | 针对树结构查询定制的GPU内核 | 减少冗余内存加载,提升张量核心利用率 |
| 贪心启发式分组 | 线性时间复杂度的最优分组搜索 | 平衡填充开销和中间结果开销 |
| 长上下文分割 | 解决GPU利用率不足问题 | 最高1.9×加速 |
| 多阶段tiling | 自适应选择tile大小 | 平衡并行性和数据重用 |
| SGLang集成 | 作为SGLang插件实现 | 无缝集成现有系统 |
五、实验结果
实验设置
- 硬件:NVIDIA H100 GPU (80GB),CUDA 12.2
- 实现:基于Triton实现内核,作为SGLang v0.2.13插件
- 基线:
- FlashAttention v2.6.3
- FlashInfer v0.1.6
- SGLang Triton内核 v0.2.13
- DeFT
- Multi-Level Cascade Attention (CascadeAttn)
- 模型:Llama-2-7B (GQA=1),Mistral-7B (GQA=4)
- 基准测试:
- (A) 多级系统提示
- (B) 多few-shot学习
- (C) 多链推理
- (D) 多文档QA
内核基准测试
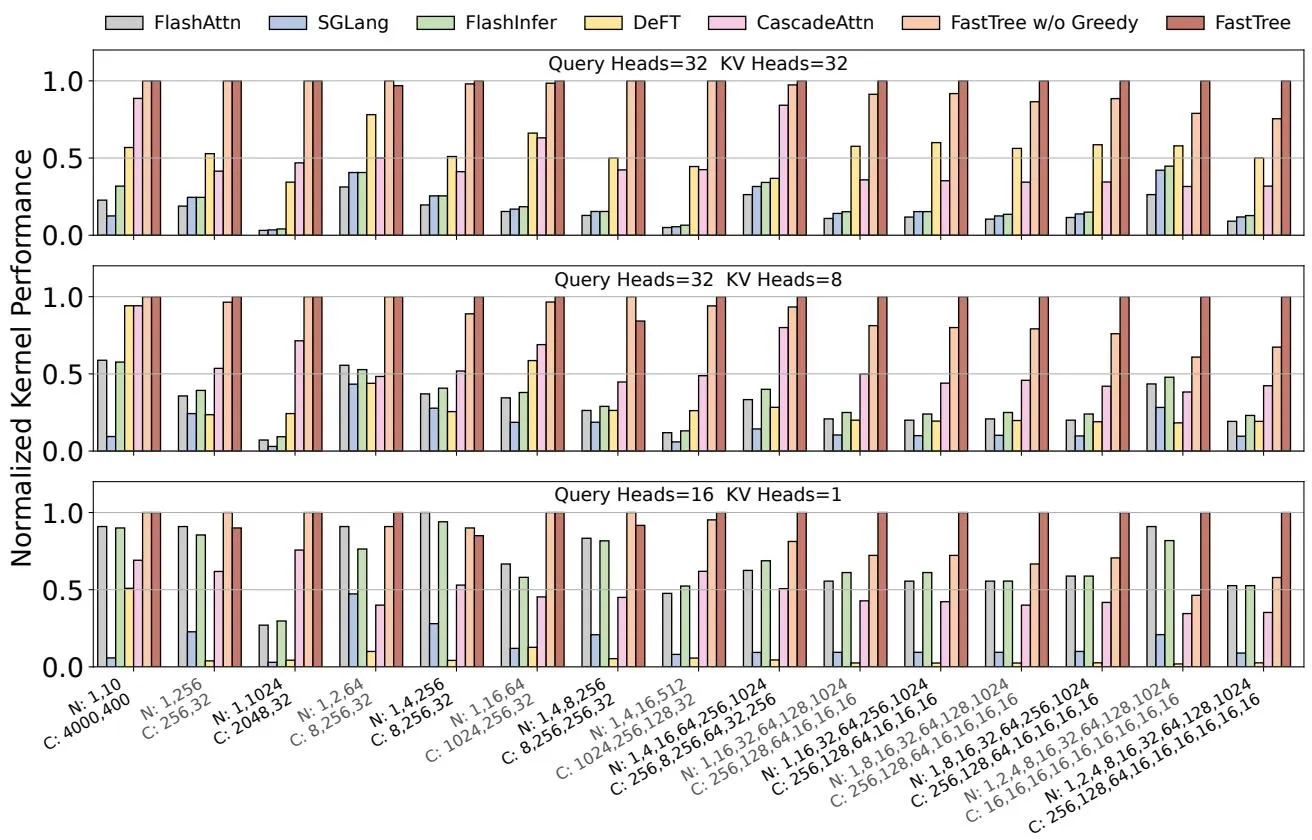
关键结果:
| 基线 | 平均加速比 |
|---|---|
| FlashAttention | 5.1× |
| SGLang Triton | 9.2× |
| FlashInfer | 4.2× |
| DeFT | 10.6× |
| CascadeAttn | 2.1× |
树配置说明:
- N:每层的节点数
- C:每层的每节点上下文长度
- GQA比率:1, 4, 16
关键发现:
- GQA比率低时,FastTree相比FlashAttention和FlashInfer加速更显著
- 即使GQA=16,FastTree仍优于查询分离的内核
- 贪心启发式在复杂树结构中可带来最高2.2×加速
端到端性能
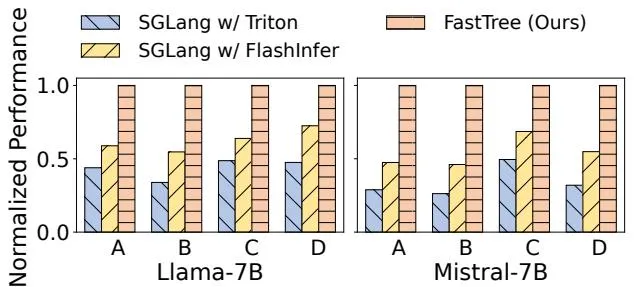
关键结果:
| 模型 | 基线 | 平均加速比 |
|---|---|---|
| Llama-2-7B | SGLang Triton | 2.4× |
| Llama-2-7B | SGLang FlashInfer | 1.6× |
| Mistral-7B | SGLang Triton | 3.1× |
| Mistral-7B | SGLang FlashInfer | 1.9× |
整体提升:FastTree将SGLang的吞吐量提升高达 2.2×(相比FlashInfer后端)
执行时间分解
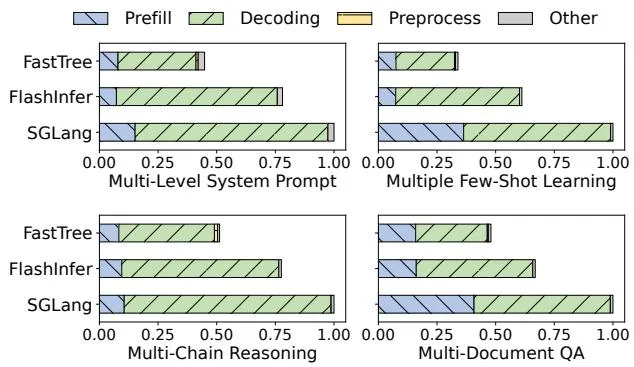
关键发现:
- FastTree显著减少解码延迟
- CPU预处理开销可忽略不计
- 解码加速:相比SGLang-Triton 2.3×,相比SGLang-FlashInfer 1.9×
GPU内核分解
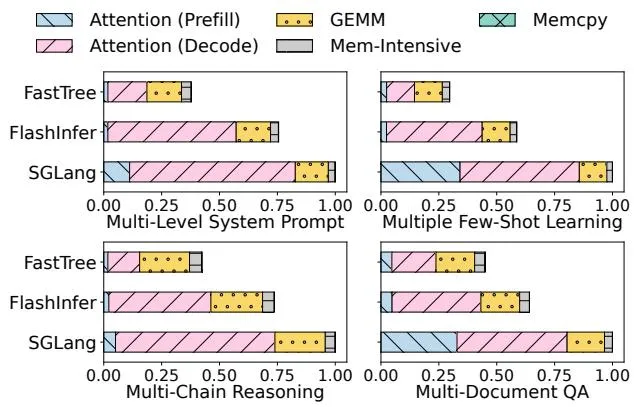
关键发现:
- 未优化的注意力操作占总内核执行时间的很大比例
- FastTree显著减少注意力计算时间
- 其他内核(element-wise和reduction)只占很小比例
消融实验
贪心优化效果:
- 简单树结构:贪心启发式倾向于直接聚合
- 复杂树结构:贪心启发式可带来最高2.2×加速
长上下文分割效果:
- 配置N=1,10,C=4000,400:最高1.9×加速
- 解决GPU SM利用率不足问题
六、相关工作
| 方法 | 特点 | 与FastTree的区别 |
|---|---|---|
| SGLang | 基数树KV缓存管理 | FastTree优化注意力内核 |
| vLLM | 连续批处理、分页KV缓存 | 未针对树结构优化 |
| FlashAttention | IO感知的注意力内核 | 不支持树结构共享 |
| FlashInfer | 优化的CUDA内核库 | 查询分离计算 |
| DeFT | 树结构优化 | 固定tile大小,额外masking |
| CascadeAttn | 多级级联注意力 | 未解决分组挑战 |
七、总结
核心贡献
- 树结构注意力内核:首次为树结构LLM推理定制GPU内核
- 运行时优化:提出树结构自适应的贪心启发式运行时优化策略
- 长上下文分割:解决GPU利用率不足问题
- 系统集成:作为SGLang插件实现,易于部署
- 显著性能提升:内核加速最高10.6×,端到端吞吐量提升最高2.2×
技术影响
- 性能提升:显著提升树结构LLM推理的吞吐量
- 内存效率:减少冗余的KV缓存加载
- GPU利用率:通过查询聚合提升张量核心利用率
- 通用性:适用于各种树结构配置和GQA比率
- 实用性:作为SGLang插件,易于集成到现有系统
局限性
- 硬件依赖:超参数仅针对H100调优,未利用Hopper特定特性(如TMA)
- 树结构限制:主要针对基数树结构优化
- 实现复杂度:需要定制化GPU内核
- 预填充优化:当前仅优化解码阶段
八、参考资源
- 论文:OpenReview
- 代码:GitHub
- 相关项目:SGLang, FlashAttention, FlashInfer, DeFT