EPD-Serve: A Flexible Multimodal EPD Disaggregation Inference Serving System on Ascend
面向多模态大模型的EPD阶段解耦推理系统,在昇腾NPU上实现57-69%吞吐量提升
EPD-Serve: A Flexible Multimodal EPD Disaggregation Inference Serving System on Ascend
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | EPD-Serve: A Flexible Multimodal EPD Disaggregation Inference Serving System on Ascend |
| 作者 | Fan Bai, Pai Peng, Zhengzhi Tang, Zhe Wang, Gong Chen, Xiang Lu, Yinuo Li, Huan Lin, Weizhe Lin, Yaoyuan Wang, Xiaosong Li |
| 机构 | 华为技术有限公司 |
| 论文 | arXiv:2601.11590 |
| 硬件 | 华为昇腾 (Ascend) NPU |
| 领域 | 多模态推理系统、阶段解耦 |
二、核心思想
问题定义
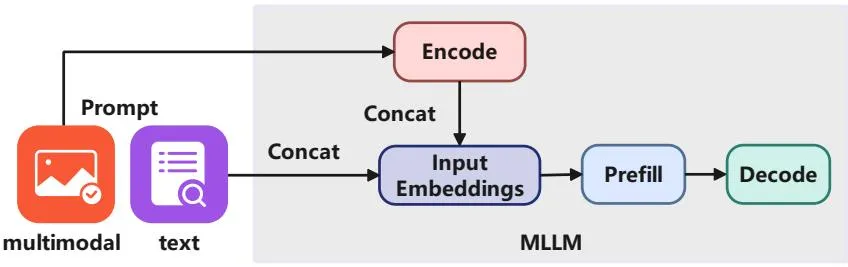
Figure 1: 大型多模态语言模型的推理流程
多模态大语言模型 (MLLMs) 需要处理文本、图像、音频、视频等多种模态。现有推理系统普遍采用单体架构,将 Encode、Prefill、Decode 三个阶段紧密耦合在同构硬件上,导致:
- 硬件利用率低下
- 系统吞吐量受限
- 跨阶段资源干扰
延迟瓶颈分析
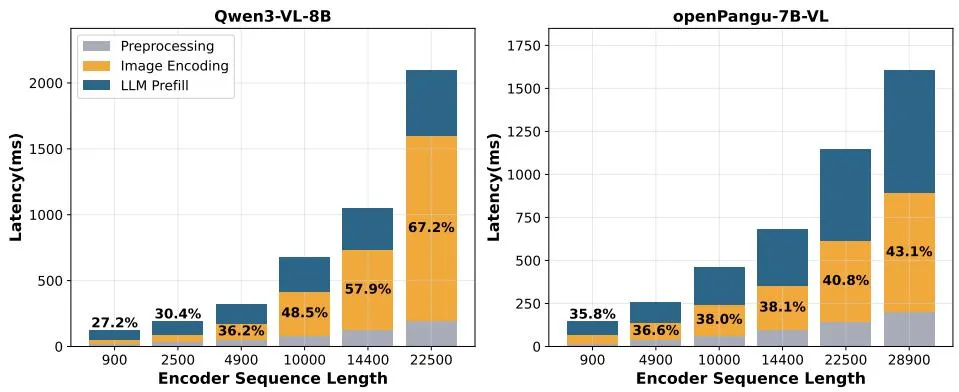
Figure 2: 主流MLLM随编码器序列长度增加的延迟比例
关键发现:
- 视觉编码器(ViT)参数量达数亿至数十亿
- 视觉编码生成的 token 序列远长于语言模型处理的序列
- 注意力复杂度随序列长度二次增长
- 编码阶段延迟可超过 LLM 的 Prefill 时间
三种异构性
| 异构类型 | 描述 | 影响 |
|---|---|---|
| 数据异构 | 多种模态格式、动态变化的序列长度 | 统一数据流管理困难 |
| 模型异构 | ViT/CNN编码器 vs 自回归解码器 | 系统级调度复杂 |
| 计算异构 | 纯文本 vs 多模态请求 | 工作负载不均衡 |
现有方法局限
| 问题 | 描述 |
|---|---|
| 执行干扰 | 视觉编码和文本预填充竞争共享资源 |
| 统一并行策略 | 无法满足阶段特定优化需求 |
| 串行执行 | 阶段间无法资源复用 |
解决方案概述
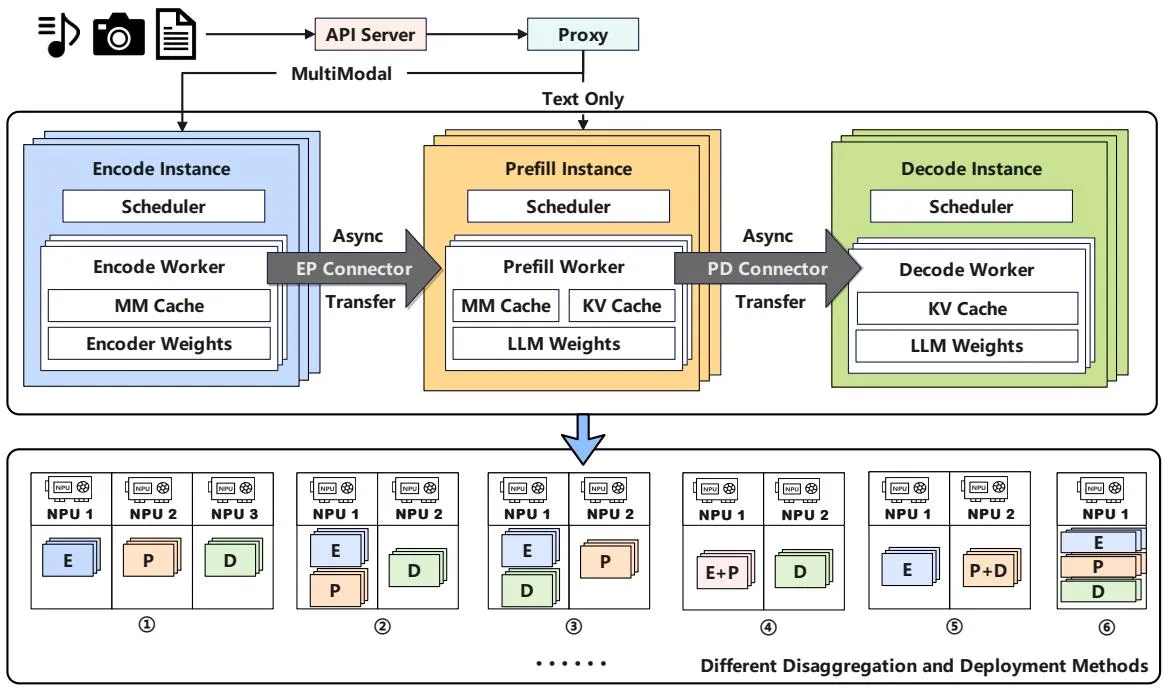
Figure 3: EPD-Serve 解耦推理架构概述
EPD-Serve 将推理流水线解耦为三个独立阶段:
- Encode (E):处理多模态输入,生成高维嵌入序列
- Prefill (P):处理文本提示和多模态特征,生成首token和KV缓存
- Decode (D):自回归生成后续token
灵活部署策略:
- E-P-D:完全解耦
- EP-D:编码与预填充共置
- ED-P:编码与解码共置
- E-PD:预填充与解码共置
三、技术架构
核心公式
Encode 阶段:
其中 表示 个多模态 token,每个具有 维特征向量。
Prefill 阶段:
生成首个输出 token 和 KVCache 。
Decode 阶段:
自回归迭代直到生成 <eos> 或达到最大长度。
E-P 解耦传输机制
Figure 4: E-P解耦的异步特征传输与流水线
多模态缓存池 (MM Store)
- 使用多模态输入的哈希作为键
- 存储对应的特征向量作为值
- 避免重复缓存和传输
- 支持跨请求特征复用
事件驱动异步预取
- Encode 完成后,仅异步发送特征哈希到目标 Prefill 实例
- 监听器接收事件后,从 MM Store 检索特征
- 写入本地缓存
- 传输轻量级哈希值,并行化执行和数据传输
容错重计算
- 如果 Prefill 实例无法从 MM Store 检索特征
- 触发本地重计算生成缺失向量
- 保持流水线连续性
P-D 解耦传输机制
分层分组 KV 传输
层间 KV 传输:
- KVCache 由每个 Transformer 层独立产生
- 将缓存划分为层间传输单元
- 减少一次性 KV 传输的瞬时带宽需求
- 当 Prefill 计算第 (L+1) 层时,异步传输第 L 层的 KVCache
- 实现通信与计算的时间重叠
调度策略
- 多路调度:适应多模态输入特性
- 实例级负载均衡:动态分配请求
- 多阶段硬件资源共置:物理层空间复用
算子级硬件共置
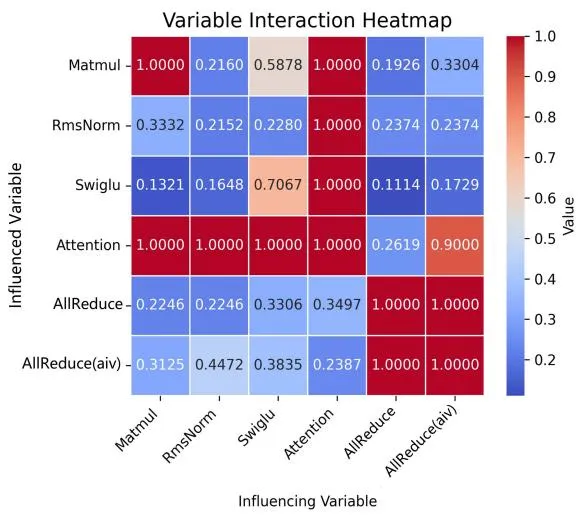
Figure 6: 算子级硬件共置的资源分配与性能分析
关键洞察:
- AI Core 和 AI Vector Core 对硬件资源需求不同
- Encode 和 Prefill 阶段的算子可以互补共置
- 实现物理层空间复用,提高硬件利用率
四、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| EPD阶段解耦 | 将推理流水线解耦为E/P/D三阶段 | 消除跨阶段干扰 |
| 异步特征预取 | 事件驱动+缓存池+容错重计算 | 降低E-P传输延迟 |
| 分层KV传输 | 层间异步传输,通信与计算重叠 | 降低P-D传输开销 |
| 灵活共置策略 | E-PD/EP-D/ED-P多种部署模式 | 适配不同工作负载 |
| 算子级硬件共置 | AI Core/Vector Core空间复用 | 提高硬件利用率 |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 硬件 | 华为昇腾 (Ascend) NPU |
| 模型 | openPangu-7B-VL |
| 工作负载 | ShareGPT-4o |
| 负载 | 平均12请求/秒/NPU |
| SLO约束 | TTFT ≤ 2000ms, TPOT ≤ 50ms |
Encode阶段解耦效果
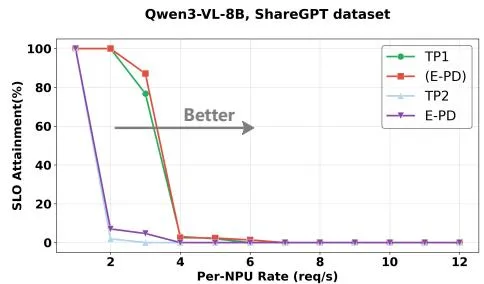
Figure 8: Encode阶段解耦与单体部署的SLO达成率对比
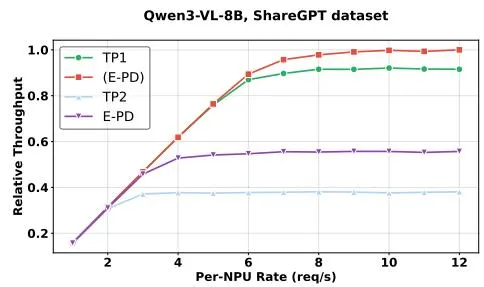
Figure 9: Encode阶段解耦与单体部署的吞吐量对比
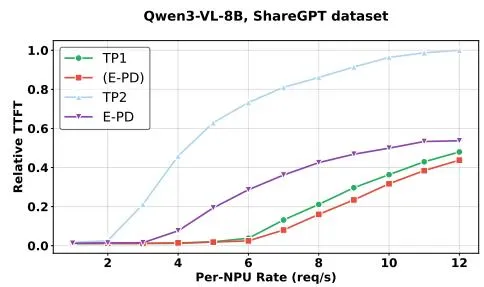
Figure 10: Encode阶段解耦与单体部署的TTFT延迟对比
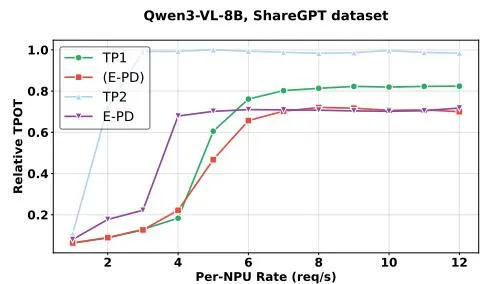
Figure 11: Encode阶段解耦与单体部署的TPOT延迟对比
E-PD 部署(编码与预填充解耦后共置于单个NPU):
- SLO达成率提升
- 吞吐量超越单体部署
- TTFT延迟降低
- TPOT保持稳定
Decode阶段解耦效果
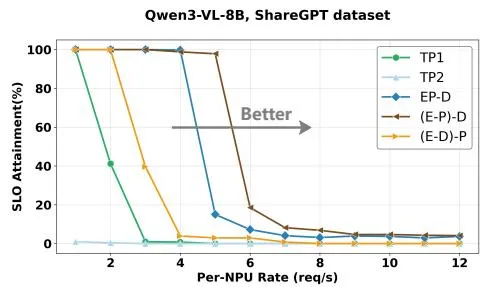
Figure 12: Decode阶段解耦与单体部署的SLO达成率对比
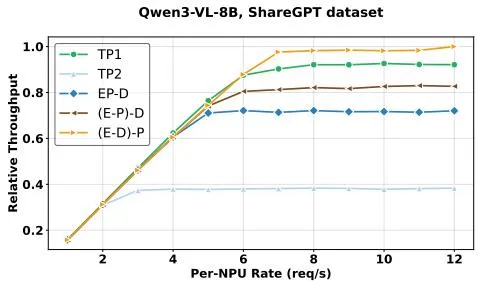
Figure 13: Decode阶段解耦与单体部署的吞吐量对比
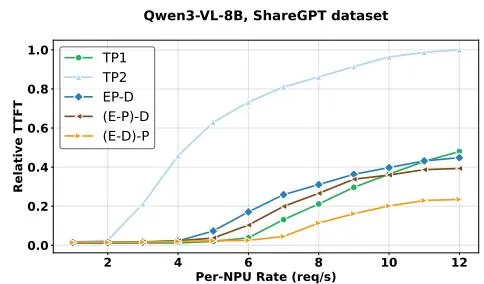
Figure 14: Decode阶段解耦与单体部署的TTFT对比
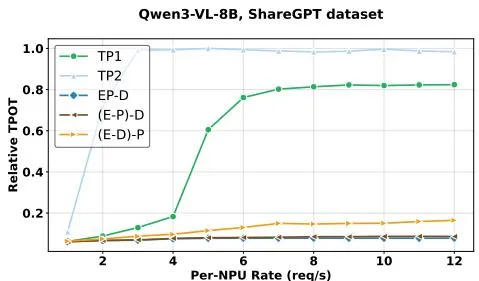
Figure 15: Decode阶段解耦与单体部署的TPOT对比
(E-P)-D 部署(在Decode阶段解耦基础上进一步解耦E和P):
- 缓解来自Decode阶段的干扰
- EP-D部署降低TPOT延迟
- 吞吐量显著提升
综合性能

Figure 17: openPangu-7B-VL在不同部署下的TTFT、TPOT和吞吐量性能
关键结果
表2: 吞吐量对比
| 部署方式 | 吞吐量 (tokens/s) | 相对PD解耦 |
|---|---|---|
| 单体部署 | 313.14 | 0.59x |
| PD解耦 | 528.35 | 1.00x |
| EPD-Serve (E-P-D) | 834.15 | 1.58x |
| EPD-Serve (EP-D) | 857.81 | 1.62x |
核心结果:
- 相比PD解耦部署:57.37-69.48%吞吐量提升
- 满足严格SLO约束:TTFT ≤ 2000ms, TPOT ≤ 50ms
- 在高并发多模态场景下表现优异
六、相关工作对比
| 方法 | 策略 | EPD-Serve优势 |
|---|---|---|
| vLLM/SGLang/TGI | 单体架构 | EPD解耦消除干扰 |
| Splitwise/DistServe | PD解耦 | 增加Encode阶段解耦 |
| HydraInfer | EPD逻辑解耦 | 物理层共置+空间复用 |
| SpaceServe | EPD独立部署 | 灵活共置策略 |
| ModServe | 模态感知路由 | 算子级硬件共置 |
七、总结
核心贡献
- EPD阶段解耦:将多模态推理流水线解耦为独立的Encode、Prefill、Decode阶段
- 异步特征预取:事件驱动+MM Store缓存池+E-P异步传输
- 分层KV传输:层间异步传输,通信与计算重叠
- 灵活部署策略:E-PD/EP-D/ED-P多种共置模式
- 算子级硬件共置:AI Core/Vector Core空间复用
实际意义
- 在昇腾NPU上实现高性能多模态推理
- 吞吐量提升57-69%
- 满足严格SLO约束
- 支持高并发多模态场景
技术影响
- 为多模态推理系统架构优化提供新方向
- 证明EPD解耦的有效性
- 推动昇腾NPU在大模型推理领域的应用
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 多模态推理流程 | figure1-mllm-inference-flow.jpg |
| Figure 2 | 延迟比例分析 | figure2-latency-proportion.jpg |
| Figure 3 | EPD-Serve架构 | figure3-epd-serve-architecture.jpg |
| Figure 6 | 算子级共置 | figure6-operator-colocation.jpg |
| Figure 8 | SLO Encode阶段 | figure8-slo-encode-stage.jpg |
| Figure 9 | 吞吐量 Encode阶段 | figure9-throughput-encode-stage.jpg |
| Figure 10 | TTFT Encode阶段 | figure10-ttft-encode-stage.jpg |
| Figure 11 | TPOT Encode阶段 | figure11-tpot-encode-stage.jpg |
| Figure 12 | SLO Decode阶段 | figure12-slo-decode-stage.jpg |
| Figure 13 | 吞吐量 Decode阶段 | figure13-throughput-decode-stage.jpg |
| Figure 14 | TTFT Decode阶段 | figure14-ttft-decode-stage.jpg |
| Figure 15 | TPOT Decode阶段 | figure15-tpot-decode-stage.jpg |
| Figure 17 | 雷达图综合性能 | figure17-radar-performance.jpg |