EnViT: Enhancing the Performance of Early-Exit Vision Transformers via Exit-Aware Structured Dropout-Enabled Self-Distillation
通过退出感知结构化dropout增强早期退出Vision Transformer性能
EnViT: Enhancing the Performance of Early-Exit Vision Transformers via Exit-Aware Structured Dropout-Enabled Self-Distillation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | EnViT: Enhancing the Performance of Early-Exit Vision Transformers via Exit-Aware Structured Dropout-Enabled Self-Distillation |
| 作者 | Yonghao Dong, Qiang He, Penghong Rui, Zhenzhe Zheng, Zhao Li, Feifei Chen, Hai Jin, Yun Yang |
| 机构 | Huazhong University of Science and Technology, Swinburne University of Technology, Shanghai Jiao Tong University, Zhejiang Lab, Deakin University |
| 领域 | cs.CV (Computer Vision), Adaptive Inference |
| 论文 | PDF (tmpfiles.org) |
二、核心思想
问题定义
Vision Transformers (ViTs) 在计算机视觉任务中表现出色,但在资源受限的边缘设备上部署面临严重挑战:
| 模型 | 参数量 | FLOPs | 延迟 (Jetson Orin NX) |
|---|---|---|---|
| ViT-Base | 86M | 17.6 GFLOPs | 56ms |
| ViT-Large | 307M | 61.6 GFLOPs | 154ms |
| ViT-Huge | 632M | 167.3 GFLOPs | 411ms |
早期退出(Early Exit)的两个关键挑战:
- 早期退出性能有限:早期层只能基于低层特征做决策,性能受限
- 晚期退出精度退化:知识蒸馏会加剧梯度冲突,导致晚期退出精度下降
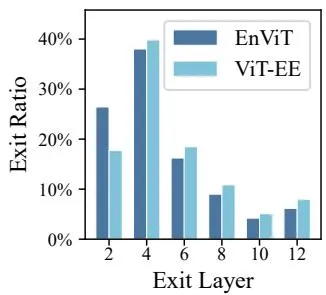
动机验证:
- EnViT使第一个退出的样本数量增加1.5倍,加速比提升10%
- 直接使用知识蒸馏会导致最后三个退出分别下降-0.70%、-1.17%、-1.67%
解决方案概述
EnViT提出退出感知结构化dropout与自蒸馏相结合的训练方法:
- 结构化dropout:为每个样本在每层独立生成dropout mask,创建虚拟子模型
- 退出感知概率:浅层低dropout概率,深层高dropout概率,鼓励更多样本从早期退出
- 自蒸馏:完整模型作为教师,虚拟子模型作为学生,有效传递知识
- 缓解梯度冲突:通过虚拟子模型减少不同退出间的梯度重叠
三、技术架构
整体框架
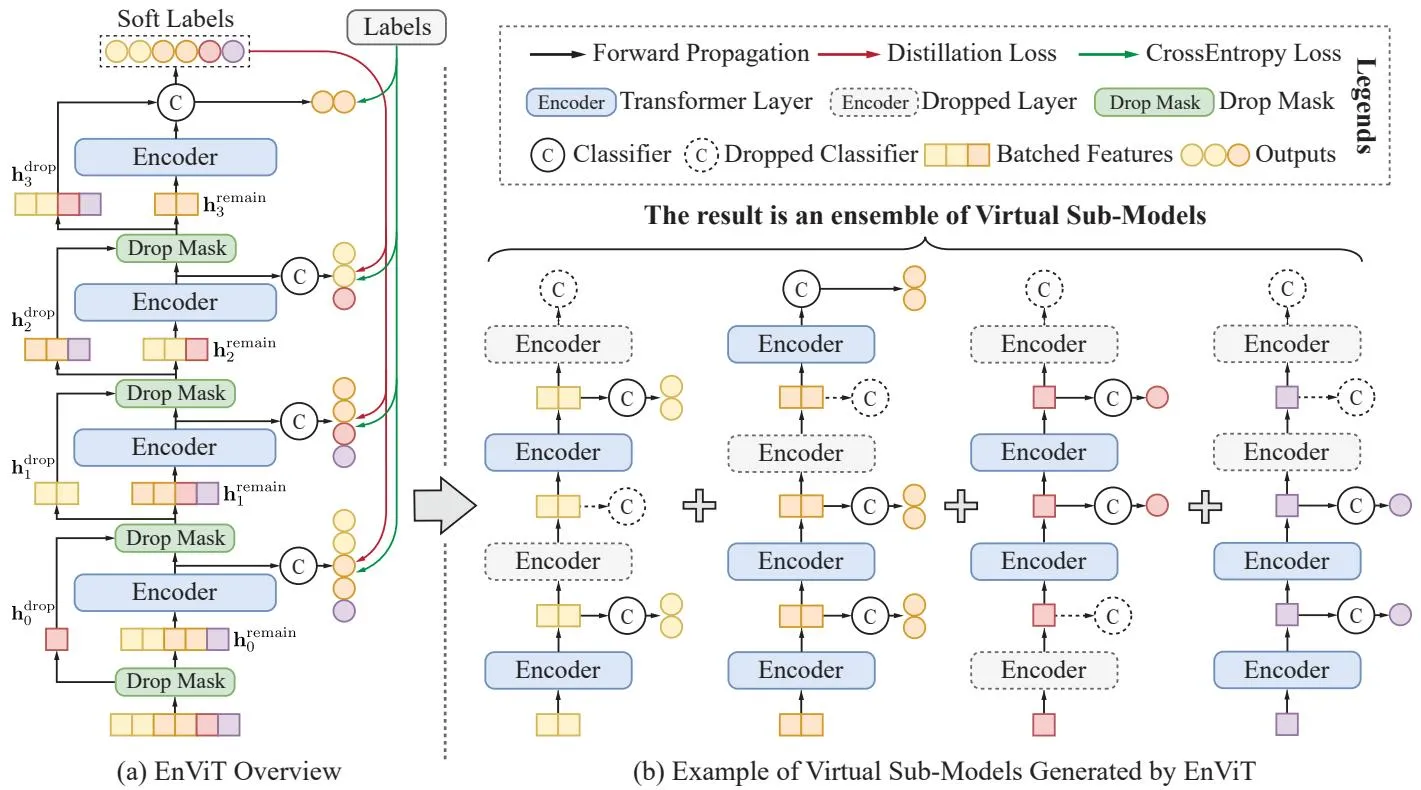
EnViT训练框架:
- (a) 训练时应用退出感知结构化dropout,不同样本(彩色数字)根据dropout mask走不同计算路径
- (b) 可视为训练虚拟子模型的集成,每个子模型处理样本子集
核心公式
早期退出ViT前向传播:
早期退出预测:
传统训练损失:
结构化dropout mask生成:
退出感知dropout概率:
自蒸馏软标签:
蒸馏损失:
总体训练目标:
早期退出条件:
理论分析
定理3.1(梯度缩放):在退出感知结构化dropout下,层ℓ接收的期望梯度缩放因子为。
定理3.2(正则化效应):EnViT添加隐式层特定正则化,鼓励层对不同复杂度样本进行专业化。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 退出感知结构化dropout | 根据退出位置分配不同dropout概率 | 鼓励更多样本从早期退出 |
| 虚拟子模型集成 | 每个样本通过不同虚拟子模型 | 缓解梯度冲突 |
| 自蒸馏机制 | 完整模型作为教师,子模型作为学生 | 避免晚期退出精度退化 |
| 梯度缩放理论 | 证明dropout对梯度的缩放效应 | 早期退出获得更大梯度 |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 数据集 | CIFAR-100, ImageNet-1k, Food-101, Stanford Cars, Flowers-102 |
| 骨干网络 | ViT-B/16 (预训练于ImageNet) |
| 优化器 | AdamW, 学习率5e-5 |
| 超参数 | α=0.5, τ=4, pM=0.3, batch=128 |
| 退出位置 | 每隔一层设置退出 |
| 硬件 | 4× NVIDIA A40 GPU |
整体性能对比
| 方法 | CIFAR-100 | ImageNet-1k | Food-101 | Stanford Cars | Flowers-102 |
|---|---|---|---|---|---|
| ViT-B/16 | 91.66% (1.00×) | 81.63% (1.00×) | 91.19% (1.00×) | 87.75% (1.00×) | 97.67% (1.00×) |
| ViT-EE | 87.63% (1.83×) | 77.57% (1.79×) | 88.85% (1.75×) | 83.41% (2.04×) | 94.26% (2.13×) |
| LGViT | 88.14% (1.94×) | 78.61% (1.51×) | 88.46% (1.97×) | 79.11% (1.45×) | 93.14% (1.63×) |
| BEEM | 88.87% (1.66×) | 76.54% (1.69×) | 89.15% (2.06×) | 83.70% (1.70×) | 93.04% (2.14×) |
| EnViT | 89.23% (2.05×) | 80.45% (1.72×) | 89.15% (2.20×) | 87.03% (2.05×) | 95.33% (2.23×) |
关键结果:
- 精度提升0.36%-7.92%
- 加速比1.72×-2.23×
精度-效率权衡
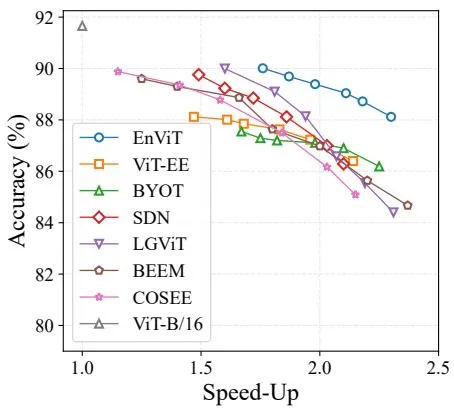
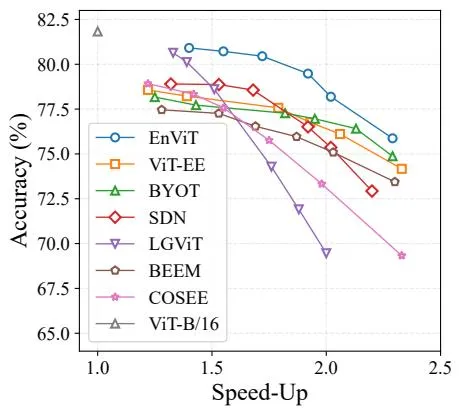
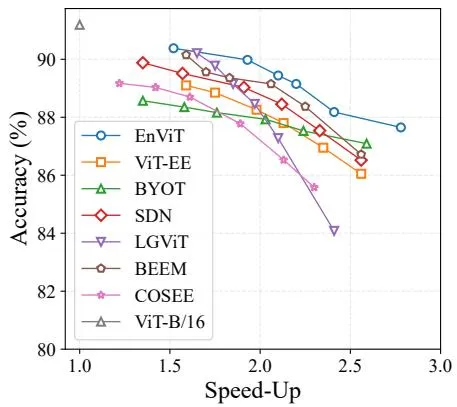
EnViT在所有加速比水平上都优于基线方法。
消融实验(CIFAR-100)
| 配置 | Exit 1 | Exit 2 | Exit 3 | Exit 4 | Exit 5 | Exit 6 |
|---|---|---|---|---|---|---|
| Baseline | 60.48% | 75.61% | 83.13% | 87.21% | 88.85% | 89.40% |
| EnViT-SD | 60.51% | 76.23% | 83.57% | 87.19% | 89.12% | 89.88% |
| EnViT-KD | 61.37% | 78.05% | 83.46% | 86.51% | 87.68% | 87.73% |
| EnViT | 61.94% | 79.02% | 84.67% | 87.72% | 88.85% | 89.94% |
关键发现:
- 仅结构化dropout(EnViT-SD):小幅提升,不损害晚期退出
- 仅自蒸馏(EnViT-KD):早期退出提升大,但晚期退出严重退化
- 完整EnViT:所有退出都获得最佳性能
六、相关工作
| 方法 | 特点 | 与EnViT的区别 |
|---|---|---|
| ViT-EE | 直接添加分类头 | 无特殊训练策略 |
| SDN | 中间层分类器+加权训练 | 无梯度冲突缓解 |
| BYOT | 自蒸馏多退出 | 蒸馏加剧梯度冲突 |
| LGViT | 局部感知头+全局聚合头 | 增加大量参数 |
| BEEM | 多退出分类器作为专家 | 聚合置信度分数 |
| COSEE | 校准加权机制 | 强调可能退出的样本 |
| LayerSkip | 层dropout训练 | 用于自推测解码 |
七、总结
核心贡献
- 问题识别:揭示早期退出性能瓶颈和晚期退出精度退化的关键因素
- 退出感知结构化dropout:根据退出位置动态生成虚拟子模型
- 自蒸馏机制:完整模型作为教师,子模型作为学生,避免梯度冲突
- 显著性能提升:精度提升0.36%-7.92%,加速比1.72×-2.23×
技术影响
- 边缘部署:为资源受限设备提供实用的ViT加速方案
- 自适应推理:通过调整阈值灵活控制速度-精度权衡
- 训练方法:可推广到其他多退出网络架构
局限性
- 退出位置:目前固定每隔一层设置退出
- 阈值调优:需要根据具体场景调整退出阈值
- 模型依赖:主要验证于ViT架构
八、参考资源
- 论文:PDF (tmpfiles.org)
- 相关项目:ViT, LGViT, BEEM, COSEE