DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation
DSpark 结合半自回归生成和置信度调度验证,统一高吞吐并行生成与自适应负载感知验证,在 DeepSeek-V4 生产系统中实现 60%-85% 生成加速
DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation |
| 作者 | Xin Cheng, Xingkai Yu, Chenze Shao, Jiashi Li, Yunfan Xiong 等 |
| 机构 | Peking University / DeepSeek-AI |
| 论文 | tmpfiles.org/dl/wywuyO3r1WWs/dspark_paper.pdf |
| 代码 | github.com/deepseek-ai/DeepSpec |
| 发布 | 2025 (arXiv preprint) |
| 许可 | Apache 2.0 |
二、核心思想
问题定义
推测解码(Speculative Decoding)通过解耦草稿生成和目标验证来加速 LLM 推理,但现有方法面临两个核心瓶颈:
| 瓶颈 | 说明 | 影响 |
|---|---|---|
| 接受率衰减 | 并行草稿器独立预测每个位置,缺乏 token 间依赖建模 | 后缀位置接受率急剧下降 |
| 验证浪费 | 不加区分地验证所有草稿 token,在高并发下浪费批处理容量 | 系统吞吐量严重退化 |
核心观察:
- 并行草稿器(如 DFlash)可高效生成长草稿块,但缺乏 token 间依赖建模导致后缀衰减
- 自回归草稿器(如 Eagle3)有强建模能力,但草稿延迟随块大小线性增长
- 固定长度验证在高负载下浪费大量计算资源
解决方案概述
DSpark 采用两个互补机制统一高吞吐并行生成与自适应验证:
| 机制 | 说明 | 解决的问题 |
|---|---|---|
| 半自回归生成 | 并行骨干 + 轻量顺序模块 | 兼顾草稿速度和 token 间依赖 |
| 置信度调度验证 | 置信度头 + 硬件感知调度器 | 动态调整验证长度,避免验证浪费 |
三、技术架构
整体框架
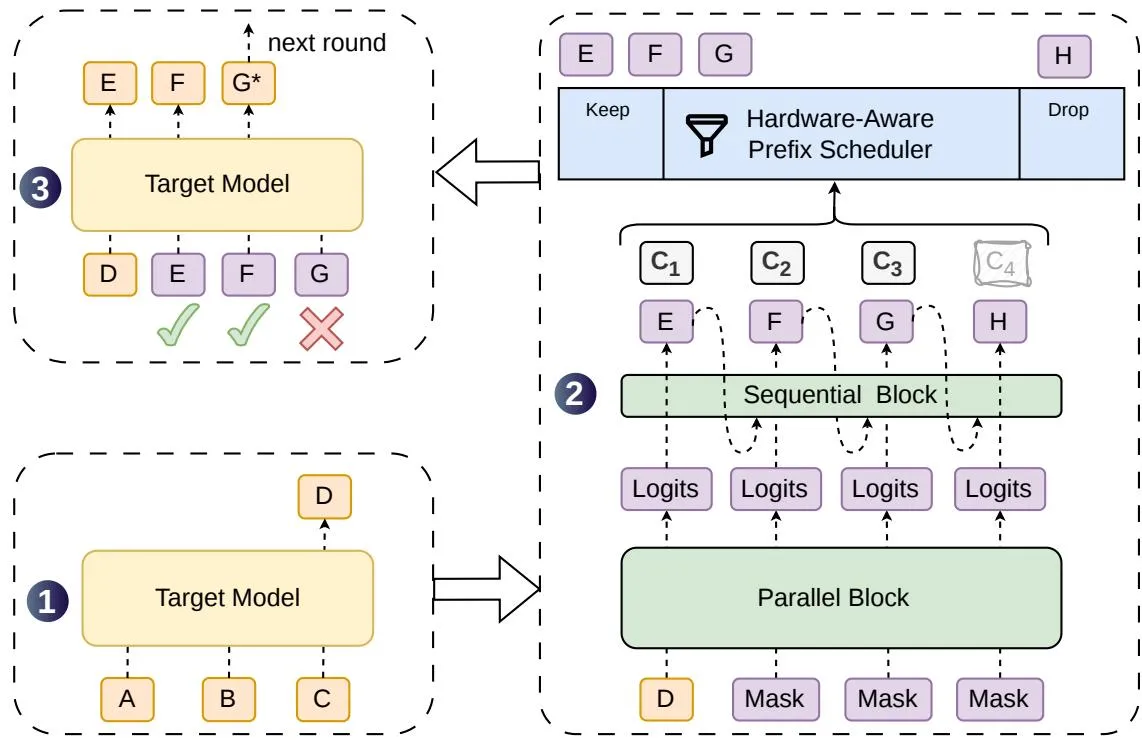 图 1:DSpark 架构与解码循环。给定提示 token ABC,目标模型执行一步生成下一个 token D,作为草稿阶段的锚点。DSpark 使用重型并行骨干和轻量顺序头生成草稿 token EFGH 及其对应的置信度分数 c1-c4。硬件感知前缀调度器评估这些分数以保留前缀 EFG 并丢弃低置信度 token H。最后,目标模型并行验证调度的前缀。
DSpark 架构与解码循环
├── 目标模型 (Target Model)
│   └── 生成锚点 token D
├── 草稿阶段 (Drafting Phase)
│   ├── 并行骨干 (Parallel Backbone)
│   │   └── DFlash: 单次前向传播生成 γ 个 token
│   └── 顺序模块 (Sequential Block)
│       └── 注入 token 间依赖 (Markov/RNN Head)
├── 置信度评估 (Confidence Assessment)
│   └── 置信度头: 估计每个位置的前缀存活概率 c₁-c₄
├── 硬件感知调度 (Hardware-Aware Scheduler)
│   └── 保留高置信度前缀 EFG,丢弃低置信度后缀 H
└── 验证阶段 (Verification Phase)
    └── 目标模型并行验证,接受 E、F,拒绝 G
核心公式
推测解码延迟公式:
其中 是每周期接受的 token 数, 是草稿时间, 是验证时间。
加速策略:
- 降低 :并行草稿器(DSpark 保留此优势)
- 提高 :半自回归生成(DSpark 的第一个创新)
- 降低有效 :置信度调度验证(DSpark 的第二个创新)
半自回归生成公式:
其中:
- :上一验证周期的锚点 token
- :并行骨干在位置 的基础 logit 向量
- :前缀依赖的转换偏置
- :词汇表
Markov Head 转换偏置:
其中 和 是低秩分解矩阵。
模型组件
| 组件 | 说明 | 关键特性 |
|---|---|---|
| 并行骨干 | DFlash 架构 | 单次前向传播生成 γ 个 token |
| 顺序模块 | Markov/RNN Head | 轻量级,注入 token 间依赖 |
| 置信度头 | 估计前缀存活概率 | 动态调整验证长度 |
| 硬件感知调度器 | 基于引擎吞吐量配置文件 | 路由目标验证预算到高回报 token |
半自回归生成详解
两阶段设计:
| 阶段 | 说明 | 延迟 |
|---|---|---|
| 并行阶段 | DFlash 骨干单次前向传播 | (固定) |
| 顺序阶段 | 轻量顺序模块采样 |
Markov Head:
- 限制 仅依赖前一个 token
- 低秩分解 避免全 矩阵
- 嵌入查找表 + 线性投影
RNN Head(可选):
- 使用 RNN 编码完整前缀历史
- 更强的依赖建模能力
- 适合需要长程依赖的任务
置信度调度验证
核心思想:根据每个 token 的置信度动态调整验证长度
| 组件 | 说明 |
|---|---|
| 置信度头 | 估计每个位置的前缀存活概率 |
| 硬件感知调度器 | 基于引擎实时吞吐量配置文件 |
| 动态验证长度 | 保留高置信度前缀,丢弃低置信度后缀 |
调度策略:
- 置信度头为每个草稿 token 生成置信度分数
- 调度器根据当前引擎负载和置信度分数决定验证长度
- 轻负载时验证更多 token(接近自由)
- 重负载时仅验证高置信度 token(避免浪费批处理容量)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 半自回归生成 | 并行骨干 + 轻量顺序模块 | 兼顾草稿速度和 token 间依赖 |
| 置信度调度验证 | 动态调整验证长度 | 避免验证浪费,提升系统效率 |
| 硬件感知调度 | 基于引擎吞吐量配置文件 | 适配不同负载条件 |
| 低秩 Markov Head | 转换矩阵的低秩分解 | 轻量级依赖建模 |
| DeepSpec 开源 | 算法驱动的推测解码训练仓库 | 支持社区研究 |
五、实验结果
位置级接受率分析
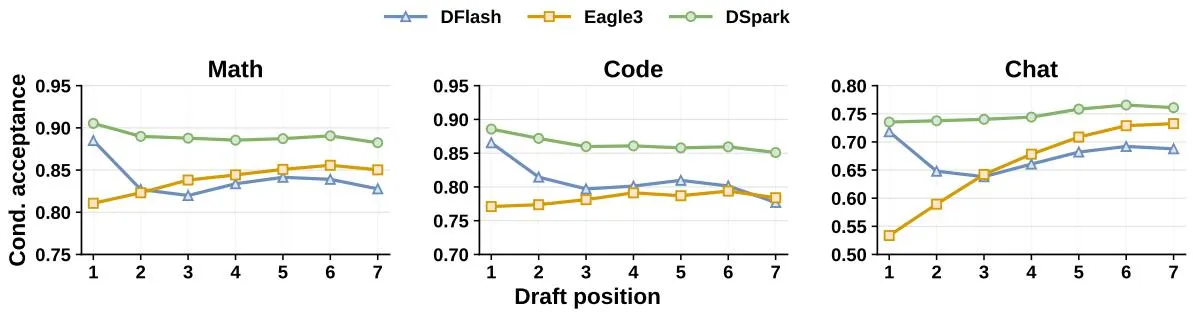 图 2:位置级条件接受率。我们报告每个草稿位置的经验条件接受率,使用 Qwen3-4B 目标模型在各领域内跨基准平均。与标准前缀存活率不同,该指标通过移除先前拒绝的惩罚来隔离位置 k 的基线预测质量。自回归草稿器(Eagle3)保持稳定或呈上升趋势,而并行草稿器(DFlash)遭受后缀衰减。
离线基准测试
| 目标模型 | vs Eagle3 (自回归) | vs DFlash (并行) |
|---|---|---|
| Qwen3-4B | +30.9% 接受长度 | +16.3% 接受长度 |
| Qwen3-8B | +26.7% 接受长度 | +18.4% 接受长度 |
| Qwen3-14B | +30.0% 接受长度 | +18.3% 接受长度 |
关键发现:
- DSpark 在所有目标模型上一致超越强基线
- 结合了并行模型的高初始 token 容量和自回归模型的后缀连贯性
- 位置级分析显示 DSpark 成功缓解了后缀衰减
消融实验
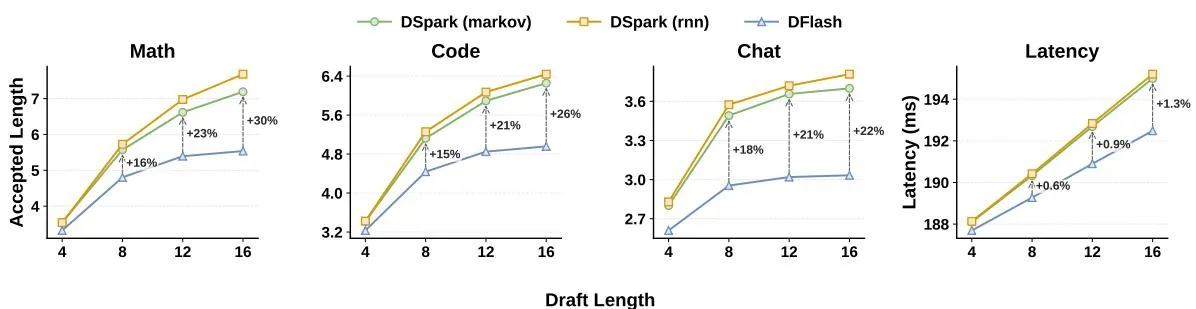 图 3:草稿器深度效果。在固定提案长度下,DSpark 的性能随着草稿器层数增加而提升。值得注意的是,浅层 2 层 DSpark 优于更深的 5 层 DFlash 基线,突出了顺序建模的参数效率。
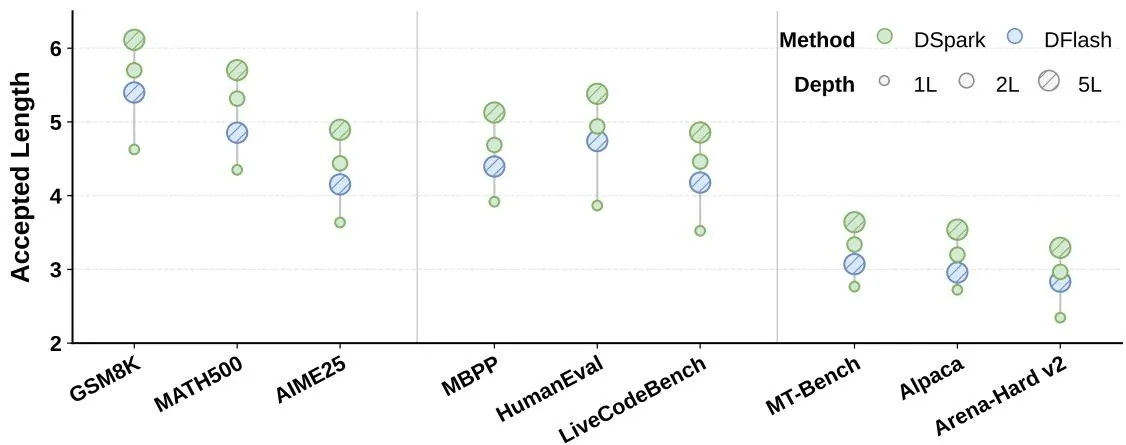 图 4:提案长度和延迟开销效果。DSpark 在各种块大小下始终优于 DFlash(左三个面板)。最右侧面板表明顺序头在服务期间引入最小的延迟开销。
置信度调度效果
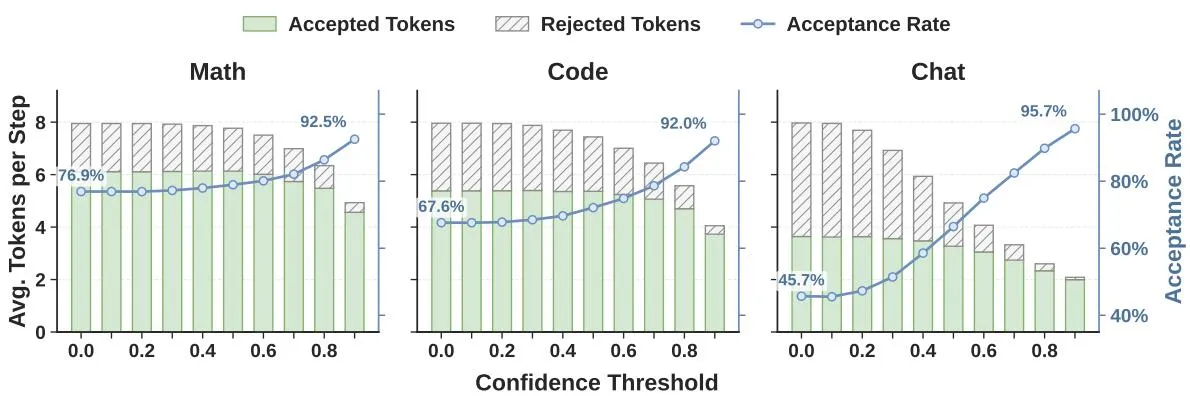 图 5:置信度阈值扫描。阈值 0 对应标准固定长度验证。随着阈值增加,整体接受率稳步上升,因为置信度头有效剪枝了最终会被拒绝的 token(哈希条)。
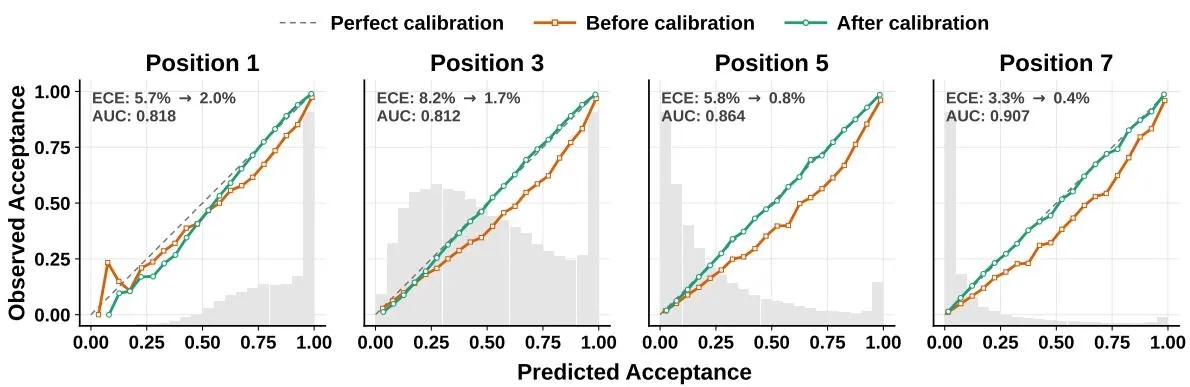 图 6:Alpaca 数据集上的可靠性图。虽然原始置信度估计器实现了强判别力,但其预测固有过自信。应用事后校准有助于将前缀存活概率与经验接受率对齐。阴影背景直方图表示不同置信度区间内的样本频率分布。
在线部署结果(DeepSeek-V4)
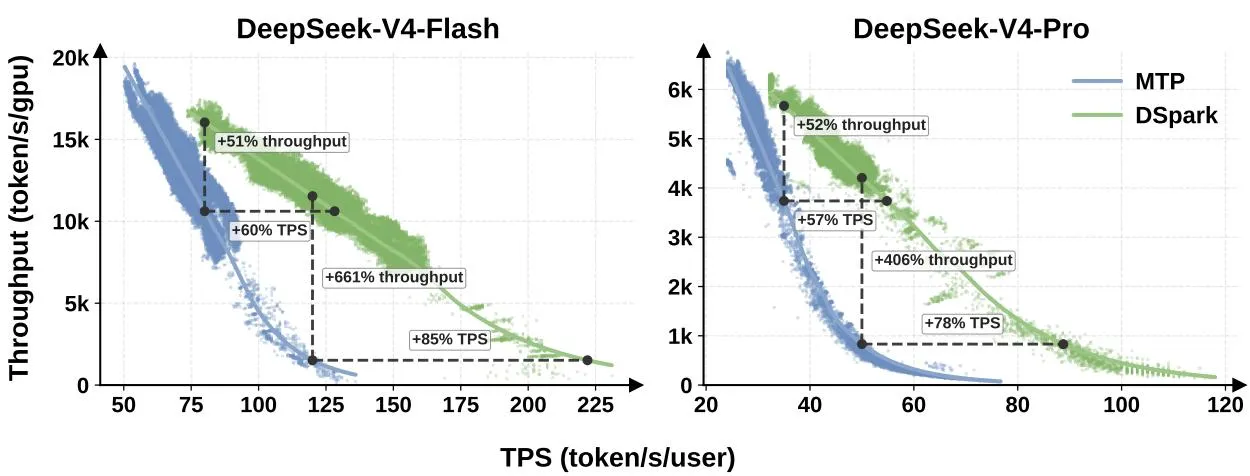 图 7:吞吐量 vs TPS。在实时流量下,聚合输出 token 吞吐量与每请求生成速度(tok/s/user)的关系。在我们的生产部署中,DSpark 相对于 MTP-1 基线改善了观测到的吞吐量-交互性前沿。
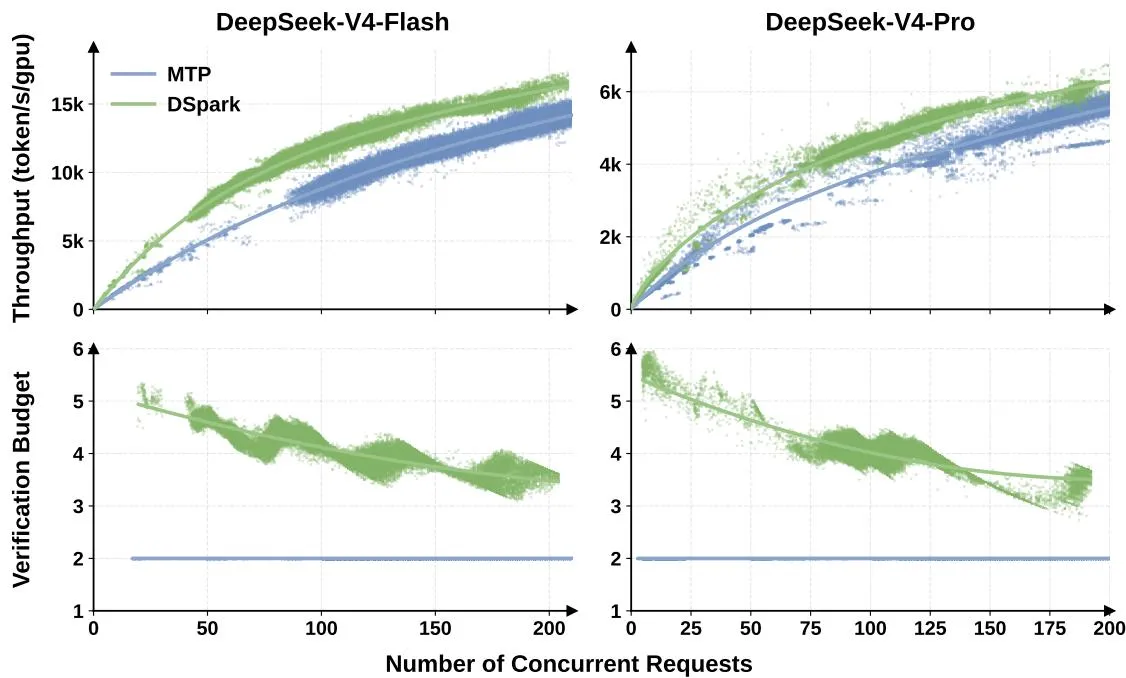 图 8:负载自适应吞吐量和验证预算。上行(a, b):在不同系统并发级别下的聚合输出吞吐量。下行(c, d):每个请求分配的平均目标验证预算。随着并发负载增加,动态调度器自动限制每个请求的验证长度以防止资源争用。
| 模型 | 生成加速 | 吞吐量保持 |
|---|---|---|
| V4-Flash | 60%-85% | 匹配水平 |
| V4-Pro | 57%-78% | 匹配水平 |
生产环境关键发现:
- 在严格 SLA 下(如 Flash 120 TPS, Pro 50 TPS),基线容量严重退化
- DSpark 缓解验证开销,维持稳定吞吐量
- 解锁了之前不可达的严格交互层级
- 有效移动了 LLM 服务的 Pareto 前沿
系统效率分析
| 指标 | 说明 |
|---|---|
| 验证效率 | 置信度调度减少不必要的验证计算 |
| 批处理容量 | 高负载下保留更多容量服务其他请求 |
| 交互层级 | 解锁之前不可达的严格交互性能层级 |
六、相关工作
| 工作 | 方法 | 与 DSpark 的差异 |
|---|---|---|
| Eagle3 | 自回归草稿器 | 草稿延迟随块大小线性增长 |
| DFlash | 并行草稿器 | 缺乏 token 间依赖建模 |
| Medusa | 多头并行草稿 | 固定长度验证 |
| SpecInfer | 树状验证 | 验证 token 数多,降低吞吐 |
| MTP-1 | DeepSeek 生产基线 | 固定验证策略 |
七、总结
核心贡献
- 半自回归生成:并行骨干 + 轻量顺序模块,兼顾草稿速度和 token 间依赖
- 置信度调度验证:动态调整验证长度,避免验证浪费
- 硬件感知调度:基于引擎实时吞吐量配置文件,适配不同负载条件
- 生产验证:DeepSeek-V4 部署,60%-85% 生成加速
- 开源贡献:DSpark 检查点 + DeepSpec 训练仓库
技术影响
- 推理加速:显著提升 LLM 推理速度
- 系统效率:在高并发下维持高吞吐量
- Pareto 前沿:解锁之前不可达的性能层级
- 社区贡献:开源检查点和训练仓库
局限性
- 架构复杂度:需要同时维护并行和顺序模块
- 训练成本:需要额外训练置信度头和顺序模块
- 评估范围:主要在 DeepSeek-V4 系统验证
- 硬件依赖:硬件感知调度需要特定引擎配置
八、参考资源
- 论文: tmpfiles.org/dl/wywuyO3r1WWs/dspark_paper.pdf
- 代码: github.com/deepseek-ai/DeepSpec
- 相关工作:
- [Eagle3](https://github.com/S Webster/3) - 自回归草稿器
- DFlash - 并行草稿器
- DeepSeek-V4 - 生产系统