Diffusion Transformer Explained(TDS 博客精读)
Mario Larcher 在 Towards Data Science 对 DiT 论文《Scalable Diffusion Models with Transformers》的教学式讲解精读,含扩散公式、无分类器引导、潜在扩散、Patchify、adaLN-Zero 等背景与核心设计
Diffusion Transformer Explained:DiT 架构教学式精读
本文是对 Towards Data Science 博客文章 “Diffusion Transformer Explained” 的总结分析。原文是一篇教学性讲解,系统拆解了 Peebles & Xie 的 DiT 论文《Scalable Diffusion Models with Transformers》。原始论文的完整分析见本仓库
docs/2212.09748-dit.md(paper_list #121),本篇侧重原文提供的背景铺垫与直觉性解释。
一、文章概述
| 项目 | 内容 |
|---|---|
| 标题 | Diffusion Transformer Explained |
| 副标题 | Exploring the architecture that brought transformers into image generation |
| 作者 | Mario Larcher |
| 出处 | Towards Data Science (TDS) |
| 发布 | 2024-02-28(更新 2025-01-23) |
| 原文 | https://towardsdatascience.com/diffusion-transformer-explained-e603c4770f7e/ |
| 对应论文 | Scalable Diffusion Models with Transformers (Peebles & Xie), https://arxiv.org/abs/2212.09748 |
| 篇幅 | 约 2534 词 |
DiT 用 Transformer 替代 U-Net 作为扩散模型的骨干网络,影响了 PIXART-α、Sora、Stable Diffusion 3 等一系列后续模型。原文特别指出一则趣闻:这篇如今奠基性的工作最初在 CVPR 2023 被拒稿——提醒我们即便是专家也很难预判什么工作会产生影响,学术会议的评审过程远非完美。
二、背景铺垫(文章前半部分)
原文用近一半篇幅铺垫三个前置概念,这正是它作为”讲解”文章的价值所在。
2.1 扩散建模公式(Diffusion formulation)
直觉:扩散模型先对图像逐步加入高斯噪声,再训练神经网络反向去噪(预测所加噪声,某些情况下还预测其协方差矩阵)。噪声程度由时间步 控制: 时 是原图, 时 近乎纯噪声。
前向过程(forward process):每一步从条件高斯采样 :
可重参数化为:
其中 是预设的方差调度。关键便利:生成 无需先生成所有 ,可直接由 一步得到(闭式解,累积 )。
训练:采样一批图像及各自的 ,加噪后连同 输入模型,最小化预测噪声与真实噪声的 MSE。神经网络记为 ,它同时接收 作为输入。
反向过程(生成):从纯噪声出发,迭代按条件分布采样:
- DDPM: 为固定对角矩阵;
- iDDPM(Improved DDPM): 为学习得到的对角矩阵——DiT 采用 iDDPM,这也是后文解码器输出 通道的原因。
原文强调:一步去噪效果差,采用逐步部分去噪、偶尔重新注入”新鲜”噪声(Langevin 动力学)的迭代过程效果更好。
2.2 无分类器引导(Classifier-free Guidance, CFG)
动机:模型常会忽视我们的 prompt(DiT 用的是类别标签 作为条件,即 class conditioning)。
对比 classifier guidance:后者依赖 ——需要一个分类器。问题:(1) 需为数据集类别训练分类器;(2) 预训练分类器针对”干净”图像,而非被高斯噪声污染的图像;(3) 无法处理文本等非类别条件。
CFG 的做法:训练时以一定概率把 prompt embedding 替换为一个表示”无 prompt”的可学习空嵌入 。推理时计算两个噪声估计(有 prompt / 无 prompt),按下式组合:
- 引导尺度 时退化为标准条件生成; 时把估计推向更贴合 prompt 的方向。
- 代价:每次评估需两次噪声预测,计算量翻倍;且质量与多样性存在权衡—— 越大保真度越高但多样性越低。
- DiT 论文使用 进行类别条件生成。
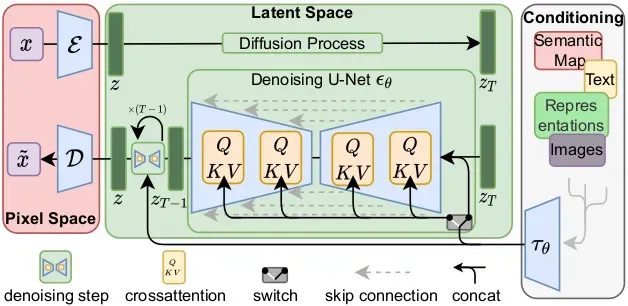
2.3 潜在扩散模型(Latent Diffusion Models, LDM)
动机:图像空间的扩散受目标分辨率制约(如 1024×1024),且反向过程需多次运行重型模型。用 Transformer 更严重:注意力二次方缩放,且图像 token 数也随分辨率二次方增长——256×256 → 512×512 时 token 数从 变 ,注意力操作从 变 。
两种解法:
- 低分辨率 + 超分:DALL·E 2、Imagen 采用;
- 潜在空间:DiT/Stable Diffusion 采用——用 VAE 将图像压缩为保留语义的低维潜表示。例如目标 256×256×3,潜变量 可为 32×32×4(通道数不再受限于 3)。训练时用 VAE 编码器压缩图像;生成时从纯噪声 出发去噪,最后用 VAE 解码器解压为图像。
三、DiT 设计空间(文章核心)
3.1 Patchify(分块 token 化)
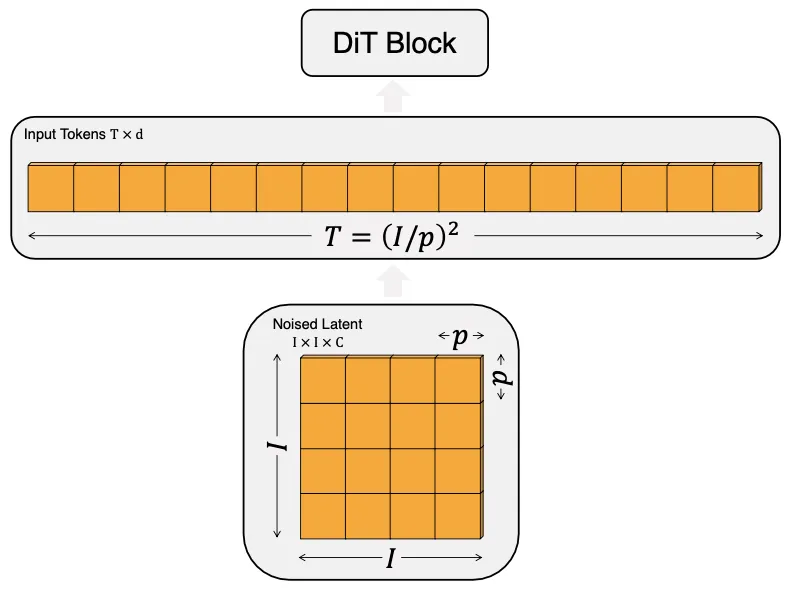
Transformer 输入是集合(顺序仅由位置编码给出),因此先把潜张量 (32×32×4)转为 token 序列:
- 将 划分为 网格,每个 块线性投影为 ( 为超参);
- 实现上等价于一个 kernel=stride=、输出通道 的卷积,得到 ;
- 定义 token 数 ,重排后一批得到 ;
- 减半 → 翻 4 倍 → Transformer Gflops 至少翻 4 倍。作者试了 : 越小结果越好但计算越贵。
3.2 位置编码
由于注意力对顺序无感知,需给所有 token 加位置编码。DiT 用静态 2D 正弦编码(原文指出论文称之为 “embedding” 其实不准确,因为并非训练学到):
- 对网格的 x 坐标做标准 1D 正弦编码,对 y 坐标同样处理,再对每个 token 拼接两者;
- 相比对”展平”图像做 1D 编码,2D 方式能保证网格中相邻 token 有相似编码。
3.3 DiT Block 设计:adaLN-Zero
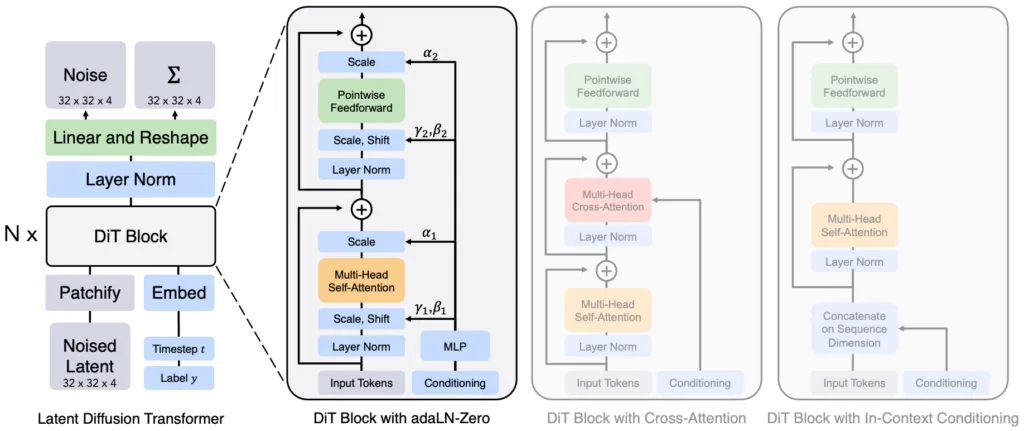
原文聚焦作者实验中效果最好的 adaLN-Zero 条件注入方式。
条件向量构造:
- 类别标签 :为每个类初始化一个可学习嵌入向量;
- 时间步 :先做正弦编码,再经一个小 MLP(Linear → SiLU → Linear);
- 将两个嵌入拼接为条件向量。
adaLN 调制:条件向量先经 SiLU 再线性投影(代码中称 adaLN_modulation),输出切分为 6 个维度为 的块:,分别用于在 DiT Block 不同位置缩放和平移。
原文给出的核心代码:
def modulate(x, shift, scale):
    return x * (1 + scale.unsqueeze(1)) + shift.unsqueeze(1)

class DiTBlock(nn.Module):
    ...
    def forward(self, x, c):
        shift_msa, scale_msa, gate_msa, shift_mlp, scale_mlp, gate_mlp = \
            self.adaLN_modulation(c).chunk(6, dim=1)
        x = x + gate_msa.unsqueeze(1) * self.attn(modulate(self.norm1(x), shift_msa, scale_msa))
        x = x + gate_mlp.unsqueeze(1) * self.mlp(modulate(self.norm2(x), shift_mlp, scale_mlp))
        return x
流程:
- 输入 token 经 LayerNorm(
norm1); modulate用 (shift_msa, scale_msa)缩放平移;- 多头自注意力
attn; - 输出用 (
gate_msa)缩放后残差相加; - 对 Pointwise Feedforward
mlp重复上述(用 )。
adaLN-Zero 的关键:把 adaLN_modulation 的权重初始化为零。这样初始时 不被改变(每个 DiT Block 初始为恒等映射),网络逐渐学到最优的缩放平移参数——与 ResNet 残差块零初始化思想一致,显著稳定深层 Transformer 的训练。
3.4 Transformer 解码器
最后的解码器是一个线性层 + 归一化:把最终输出 ()变换为 ,其中 是输入通道数。
- 仅当同时预测对角协方差 时成立(DiT 用 iDDPM 故为 );否则为 ;
- 再”unpatchify”(重排)为预测噪声(及 )。
四、核心要点提炼
| 要点 | 说明 |
|---|---|
| U-Net → Transformer | DiT 证明 Transformer 可替代卷积 U-Net 作为扩散骨干,且可扩展性更好 |
| 在潜在空间工作 | 借助 VAE 压缩,缓解注意力与 token 数的二次方缩放问题 |
| Patchize + 2D 正弦编码 | patch 大小 直接决定 token 数 与算力(↓ 效果↑算力↑) |
| adaLN-Zero | 最有效的条件注入:SiLU+线性产生 6 组调制参数,权重零初始化使 block 初始为恒等映射 |
| iDDPM + CFG(s=4) | 预测噪声及学习的对角协方差;类别条件 + 无分类器引导 |
| 历史趣闻 | DiT 曾被 CVPR 2023 拒稿,后成为 Sora/SD3 的基石 |
五、与原论文分析的关系
本文是对 DiT 论文的通俗讲解,未包含论文的完整实验数据(scaling 曲线、Gflops-FID 相关性、256/512 基准表等)。若需要论文的定量结果、消融、四种条件注入方式(in-context / cross-attention / adaLN / adaLN-Zero)的完整对比,请参见本仓库 docs/2212.09748-dit.md。
原文的独特价值在于:
- 清晰的背景铺垫(扩散公式、CFG、LDM 三段直觉性讲解);
- 对 adaLN-Zero 逐行代码级的拆解;
- 对 patchify 算力缩放关系的直观说明。
六、参考资源
- 原文:https://towardsdatascience.com/diffusion-transformer-explained-e603c4770f7e/
- DiT 论文:https://arxiv.org/abs/2212.09748 | 代码:https://github.com/facebookresearch/DiT
- 本仓库 DiT 论文精读:
docs/2212.09748-dit.md - 延伸阅读:DDPM、Improved DDPM、Elucidating the Design Space (EDM)、High-Resolution Image Synthesis with Latent Diffusion Models、The Illustrated Transformer