DesireKV: Decoupling Sensitivity and Importance for Reasoning-Aware KV Cache
解耦敏感度与重要性:面向推理的KV缓存压缩框架
DesireKV: Decoupling Sensitivity and Importance for Reasoning-Aware KV Cache
Compression’---
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DesireKV: Decoupling Sensitivity and Importance for Reasoning-Aware KV Cache Compression |
| 作者 | Pengyu Cheng*, Jiacheng Wang*, Tianle Chen*, Bei Liu, Xiaofeng Hou, Jiacheng Liu* |
| 机构 | The Hong Kong University of Science and Technology, Xi’an Jiao Tong University, Shanghai Jiao Tong University |
| 论文 | tmpfiles.org |
| 领域 | KV Cache压缩, 推理模型优化, 内存效率 |
二、核心思想
问题定义
大语言模型执行链式思维(CoT)推理时,会生成大量中间序列,导致KV缓存内存消耗急剧增长。
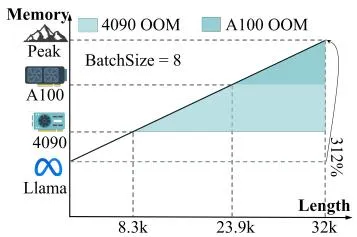
推理模型的独特挑战:
| 特性 | 传统生成 | 推理模型 (CoT) |
|---|---|---|
| 输出长度 | 相对可预测和有限 | 16K-128K tokens |
| 信息密度 | 较高 | 较低(重复逻辑模式) |
| 注意图模式 | 相对稳定 | 动态演变 |
| 量化容忍度 | 均匀 | 异构 |
核心数据:DeepSeek-R1-Distill-Llama-8B在batch size=8时,32K推理tokens消耗约32.8GB KV缓存。
三大挑战
| 挑战 | 说明 |
|---|---|
| 动态重要性演变 | 早期不重要的token可能成为后期逻辑连接的关键锚点 |
| 异构量化敏感度 | 数学表达式和逻辑运算符对量化误差高度敏感,而解释性文本则非常鲁棒 |
| 实时压缩决策 | 推理生成过程中需要在线做出压缩决策,无法预知完整序列结构 |
核心洞察:重要性-敏感度失配
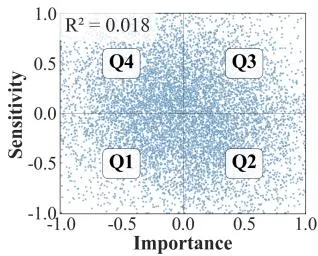
关键发现:token的上下文重要性与其量化敏感度在推理序列中基本解耦()。
这产生了四个象限:
| 象限 | 重要性 | 敏感度 | token类型 | 压缩策略 |
|---|---|---|---|---|
| Q1 | 低 | 低 | 非关键且鲁棒 | 驱逐 |
| Q2 | 高 | 低 | 关键但鲁棒 | 量化(4-bit) |
| Q3 | 高 | 高 | 关键且敏感 | 保留(高精度) |
| Q4 | 低 | 高 | 非关键但敏感 | 驱逐 |
关键数据:27.17%的token落在Q2象限(重要但不敏感),这是单一标准方法错失的压缩机会。
三、技术架构
整体框架
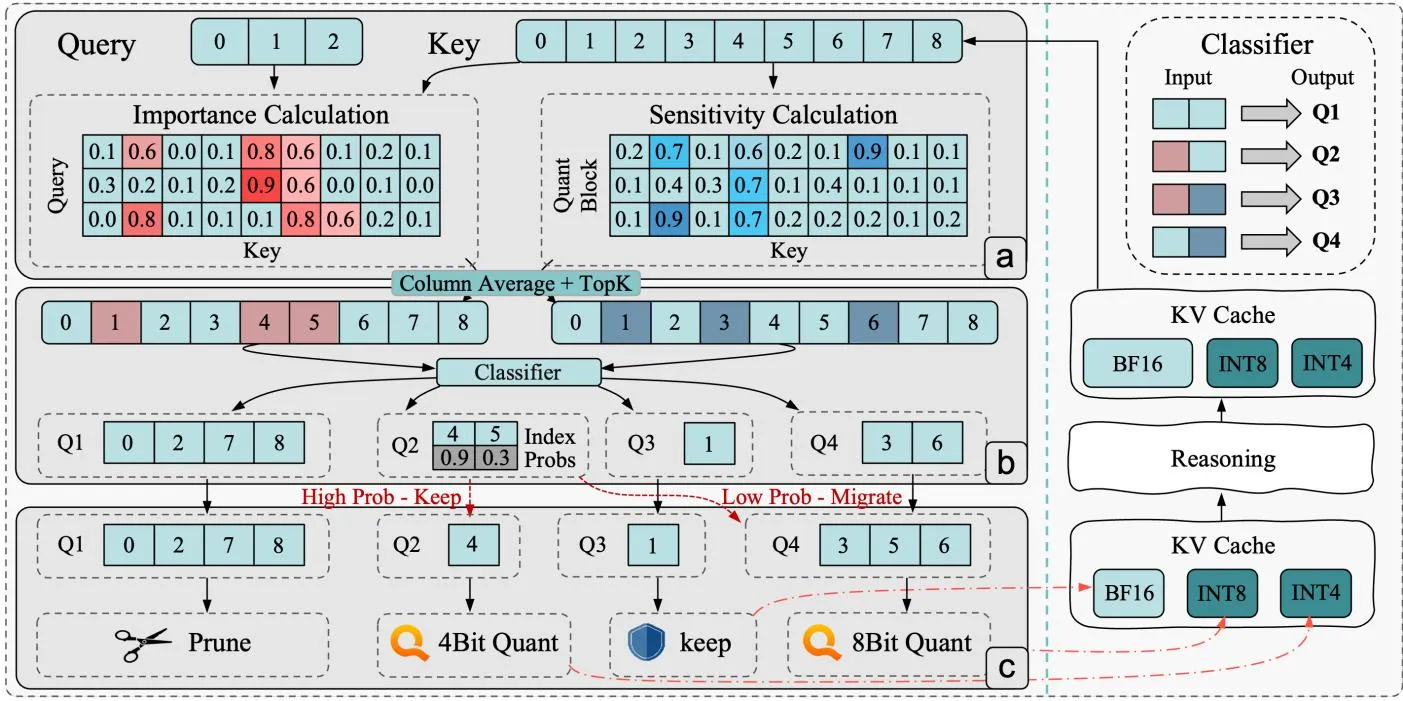
DesireKV框架包含三个核心组件:
1. 注意力驱动的重要性评估 (Section 4.2)
使用最近生成的R个token作为”选择窗口”来评估历史token的重要性:
然后应用滑动窗口平滑:
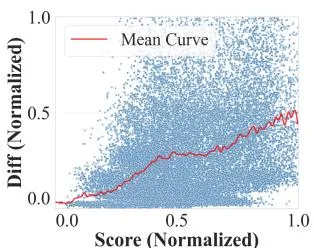
2. 基于异常值的敏感度测量 (Section 4.3)
使用四分位距(IQR)方法检测key向量中的异常值:
计算异常值分数:
3. 推理感知的token保护 (Section 4.4)
使用生成置信度识别推理转换点:
当时,标记当前token 为受保护的推理token。
压缩决策
基于二维坐标系的差异化压缩:
| 象限 | 操作 | 精度 |
|---|---|---|
| Q1 (低重要性, 低敏感度) | 驱逐 | - |
| Q2 (高重要性, 低敏感度) | 量化 | 4-bit |
| Q3 (高重要性, 高敏感度) | 保留 | BF16 |
| Q4 (低重要性, 高敏感度) | 驱逐 | - |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 重要性-敏感度失配 | 首次发现并验证推理序列中的失配现象 | ,近乎零相关 |
| 二维决策空间 | 基于重要性和敏感度的双标准决策 | 比单一标准提升3-7%准确率 |
| IQR敏感度测量 | 基于统计异常值的实时敏感度评估 | 与实际重建误差强正相关 |
| 推理感知保护 | 使用生成置信度识别推理转换点 | AIME2024提升1.3% |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 模型 | DeepSeek-R1-Distill-Qwen-7B, DeepSeek-R1-Distill-Llama-8B |
| 数据集 | GSM8K, MATH, AIME2024, GPQA-Diamond |
| 基线 | BF16, K8V4, K4V4, RPC, DDKS |
| 指标 | Pass@1, 平均比特宽度, 内存占用, 吞吐量 |
准确率对比
DeepSeek-R1-Distill-Qwen-7B:
| 方法 | GSM8K | 损失 | MATH | 损失 | AIME2024 | 损失 | GPQA | 损失 | 平均比特 | 平均损失 |
|---|---|---|---|---|---|---|---|---|---|---|
| BF16 | 89.15% | - | 91.85% | - | 54.17% | - | 47.85% | - | 16 | - |
| K8V4 | 88.11% | 1.2% | 91.23% | 0.7% | 53.33% | 1.5% | 46.00% | 3.9% | 6.0 | 1.8% |
| K4V4 | 87.95% | 1.4% | 90.31% | 1.7% | 50.42% | 6.9% | 45.58% | 4.7% | 4.3 | 3.7% |
| RPC | 85.74% | 3.8% | 88.85% | 3.3% | 42.50% | 21.5% | 44.31% | 7.4% | 4.0 | 9% |
| DDKS | 86.98% | 2.4% | 89.25% | 2.8% | 47.50% | 10.9% | 44.07% | 7.9% | 5.9 | 6% |
| DesireKV | 87.97% | 1.3% | 90.28% | 1.7% | 53.43% | 1.3% | 47.60% | 0.5% | 3.0 | 1.2% |
DeepSeek-R1-Distill-Llama-8B:
| 方法 | GSM8K | 损失 | MATH | 损失 | AIME2024 | 损失 | GPQA | 损失 | 平均比特 | 平均损失 |
|---|---|---|---|---|---|---|---|---|---|---|
| BF16 | 88.36% | - | 87.05% | - | 46.67% | - | 47.59% | - | 16 | - |
| K8V4 | 87.62% | 0.8% | 85.95% | 1.3% | 45.83% | 1.8% | 46.91% | 1.4% | 6.0 | 1.3% |
| K4V4 | 86.24% | 2.4% | 85.05% | 2.3% | 35.86% | 23.2% | 41.41% | 13.0% | 4.0 | 10.2% |
| RPC | 86.97% | 1.6% | 84.25% | 3.2% | 43.33% | 7.2% | 40.15% | 15.6% | 4.0 | 6.9% |
| DDKS | 85.61% | 3.1% | 83.25% | 4.4% | 33.75% | 27.7% | 40.47% | 15.0% | 5.5 | 12.6% |
| DesireKV | 88.11% | 0.3% | 85.95% | 1.3% | 46.25% | 0.9% | 46.84% | 1.6% | 2.9 | 1.0% |
效率评估
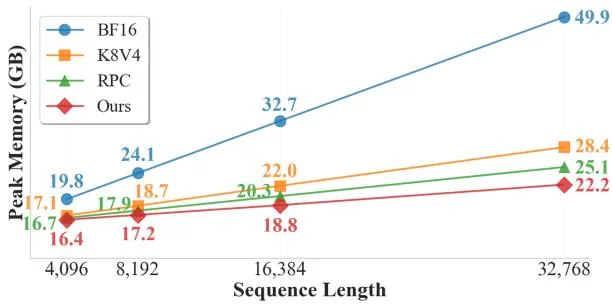
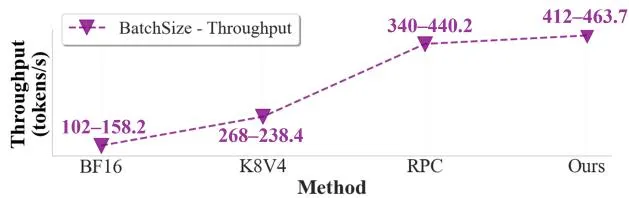
内存优化:
- 相比BF16:节省55%内存
- 相比RPC:额外节省11.6%
吞吐量提升:
- 相比BF16:提升193.1%(2.93×)
- 支持更大batch size
消融实验
| 变体 | GSM8K | MATH | AIME2024 | GPQA |
|---|---|---|---|---|
| DesireKV (完整) | 88.11% | 85.95% | 46.25% | 46.84% |
| -I (移除重要性) | 87.00% | 84.55% | 43.75% | 44.70% |
| -S (移除敏感度) | 86.14% | 82.60% | 42.92% | 44.32% |
| -P (移除保护) | 87.56% | 85.45% | 45.83% | 45.95% |
关键发现:移除敏感度感知(-S)导致最大性能下降,验证了保护数值敏感token免受激进量化比识别上下文重要性更关键。
技术影响
- 压缩比:5.5×以上
- 准确率保持:近99%原始推理准确率
- 吞吐量:提升2.93×
- 内存节省:55%
六、相关工作
| 方法类别 | 代表方法 | 特点 | 与DesireKV的区别 |
|---|---|---|---|
| 驱逐方法 | H2O, SnapKV, RPC | 基于注意力的token驱逐 | 丢失重要token,推理能力下降 |
| 量化方法 | KVQuant, KIVI | 降低数值精度 | 均匀量化,忽略敏感度异构 |
| 混合方法 | DDKS, GEAR, LeanKV | 结合驱逐和量化 | 缺乏重要性-敏感度解耦 |
| 上下文感知 | ChunkKV, FastKV, SepLLM | 语义结构理解 | 未针对推理特性优化 |
七、总结
核心贡献
- 首次发现重要性-敏感度失配:推理序列中token的上下文重要性与量化敏感度基本解耦
- 二维决策框架:基于重要性和敏感度的双标准压缩决策
- 实时敏感度评估:基于IQR异常值检测的在线敏感度测量
- 推理感知保护:使用生成置信度识别推理转换点
- 显著性能提升:5.5×压缩比,2.93×吞吐量提升,近99%准确率保持
技术影响
- 内存效率:显著降低推理模型的KV缓存内存需求
- 推理速度:吞吐量提升近3倍
- 准确率:在AIME2024等复杂推理任务上保持接近原始性能
- 通用性:适用于DeepSeek-R1等多种推理模型
局限性
- 超参数调优:选择窗口大小P和R需要根据数据集难度调整
- 阈值敏感性:推理保护阈值λ需要网格搜索确定
- 模型依赖:主要在DeepSeek-R1系列上验证
- 离线分析:部分超参数需要离线确定
八、参考资源
- 论文:tmpfiles.org PDF
- 相关项目:RPC, KIVI, DDKS, SnapKV