CudaDMA: Optimizing GPU Memory Bandwidth via Warp Specialization(通过 Warp 特化优化 GPU 内存带宽)
SC11 经典论文,提出 CudaDMA——一个通过 warp 特化(warp specialization)优化 GPU 显存带宽的可扩展 C++ 头文件库。核心思想:把一个 CTA(线程块)内的 warp 分成两类——DMA warp 专门负责片外 DRAM 与片上 shared memory 之间的数据搬运,compute warp 专门负责计算,从而把数据传输的形状/维度与计算的形状/维度解耦。DMA warp 借助 float4 向量化访存、指针算术外提、细粒度命名屏障(PTX bar.arrive/bar.sync)生产者-消费者同步,仅用 4 个 DMA warp/SM 即可饱和内存带宽(vs 基线需 40 warp)。提供 cudaDMASequential / cudaDMAStrided / cudaDMACustom 三类实例与单缓冲/双缓冲/手动双缓冲三种缓冲策略。在 NVIDIA Fermi (Tesla C2050) 上,微基准最高 1.37×,SGEMV 最高 3.2×、3D 有限差分 stencil 1.15×,FFT 通过降低占用率省寄存器。
CudaDMA: Optimizing GPU Memory Bandwidth via Warp Specialization(通过 Warp 特化优化 GPU 内存带宽)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | CudaDMA: Optimizing GPU Memory Bandwidth via Warp Specialization |
| 作者 | Michael Bauer(Stanford)、Henry Cook(UC Berkeley)、Brucek Khailany(NVIDIA Research) |
| 会议 | SC’11(Supercomputing 2011) |
| lightsighter.org/pdfs/cudadma-sc11.pdf | |
| 硬件 | NVIDIA Tesla C2050(Fermi,14 SM,1.15 GHz,144 GB/s 峰值带宽,ECC off) |
| 工具链 | CUDA 4.0 RC,270.* 驱动 |
一句话总结:CudaDMA 借鉴 Cell BE / Imagine Stream Processor 上的异步硬件 DMA 引擎思想,在 GPU 上以纯软件方式模拟 DMA 引擎:通过 warp 特化把 CTA 内的 warp 分为 DMA warp(专司搬运)与 compute warp(专司计算),将”数据布局的形状/维度”与”计算/线程块的形状/维度”解耦,同时提升可编程性与内存带宽利用率。
二、核心思想
问题定义
随着 GPU 算力按摩尔定律增长,越来越多应用受限于内存带宽。CUDA 编程模型要求用同一套线程层级同时完成计算和数据搬运,这在两种情形下产生问题:
- 可编程性挑战:当 CTA 的大小/维度与数据的大小/维度不匹配时(如多维 stencil:CTA 大小由输出点决定,而需搬运的数据量由 stencil 阶数决定),程序充斥条件分支,代码难写难维护。
- 性能挑战:对于计算-访存比接近硬件平衡点的应用(如 BLAS2),性能同时受计算和访存瓶颈制约。
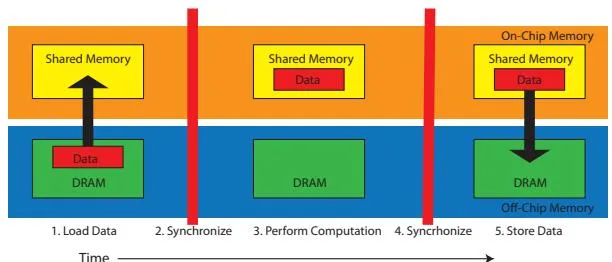
论文用合成微基准量化了这一问题:CTA 拷贝 2KB 数据 DRAM→shared memory→计算。在低计算强度(BLAS1)下带宽维持峰值 144 GB/s 的约 75%(实际上限约 85%);但在平衡点 0.14 B/FLOP 处,只能维持约 50% 峰值带宽——这正是 staging 通过 shared memory 造成的最大退化区。
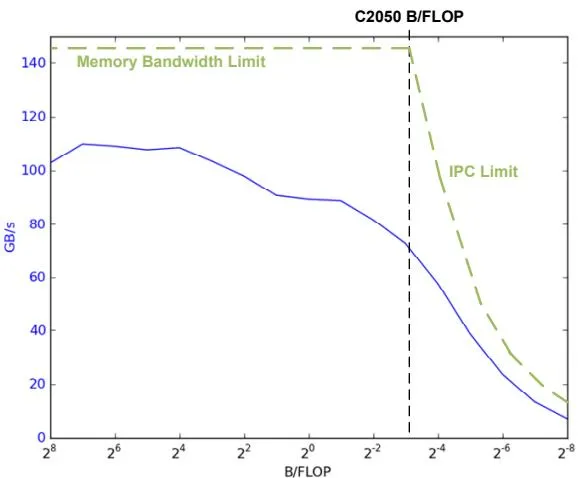
瓶颈的耦合性(关键洞见)
计算瓶颈(长延迟访存填满缓冲、粗粒度同步、访存模式导致 warp 内分歧)与内存瓶颈(指令发射受阻、访存不合并降低 MLP)是相互耦合的,根因是 CUDA 要求同一 CTA 的线程既做访存又做计算。通过创建专门化的 warp 分别执行计算和访存,就能把两类瓶颈解耦、各自独立优化。
解决方案概述
Warp 特化:只要在 warp 粒度(32 线程)上分化,就不会有 warp 内分歧的性能惩罚(warp 间分歧无害)。DMA warp 与 compute warp 通过生产者-消费者同步协作,DMA warp 封装专家级带宽优化技巧供应用程序员零成本复用。
三、技术架构
3.1 CudaDMA API
CudaDMA 是对象式的库。在 device kernel 内创建 cudaDMA 对象管理某个 shared memory 缓冲区,多个对象可管理多个缓冲区。基类接口:
class cudaDMA {
  __device__ cudaDMA(
    const int dmaID,               // 同步用唯一标识
    const int num_dma_threads,     // DMA 线程数
    const int num_compute_threads, // 参与同步的 compute 线程数
    const int dma_threadIdx_start);// 本次传输线程在块内的起始位置
  __device__ void execute_dma(void* src_ptr, void* dst_ptr);
  __device__ bool owns_this_thread();
  __device__ void start_async_dma();     // compute 侧:缓冲已空,非阻塞
  __device__ void wait_for_dma_start();  // DMA 侧:阻塞等待开始
  __device__ void finish_async_dma();    // DMA 侧:传输完成,非阻塞
  __device__ void wait_for_dma_finish(); // compute 侧:阻塞等待完成
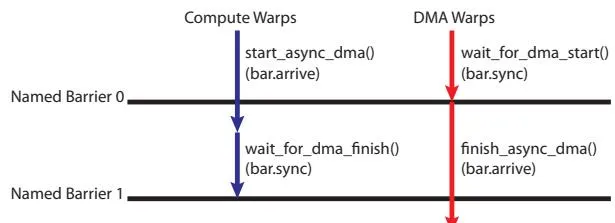
};两个同步点(每个 cudaDMA 对象):
- 缓冲已空(数据被消费完):compute 用非阻塞
start_async_dma()通知;DMA 用阻塞wait_for_dma_start()等待。 - 传输完成(缓冲可读):DMA 用非阻塞
finish_async_dma()通知;compute 用阻塞wait_for_dma_finish()等待。
3.2 CudaDMA 实例(Instances)
| 实例 | 访问模式 | 额外参数 |
|---|---|---|
| cudaDMASequential | 连续内存块 | 传输字节数 sz |
| cudaDMAStrided | 多块等距分布数据 | 元素大小 el_sz、元素数 el_cnt、源/目的 stride |
| cudaDMACustom | 自定义(仅提供同步,传输行为留空) | 由程序员实现 |
模板参数 MAX_BYTES_PER_THREAD(每线程最大传输字节数,编译期常量)用于计算常量偏移,配合常量折叠提升效率但不强制运行期传输大小。关键洞见:程序员只声明访问模式的”性质与参数”,无需指定”如何执行传输”——由专家编写的优化实例复用。
3.3 通用性(Generality)
CudaDMA 假设计算是 streaming computation:循环处理放不进片上内存的大数据集,每次迭代处理一个子块(先载入 shared memory 再消费)。这使得 compute/DMA warp 协调开销可在多次输入上摊销。任何 CUDA 程序都可改造为 streaming——让一个 CudaDMA CTA 承担原来多个 CTA 的工作即可,因此该方法具有普适性。
四、CudaDMA 方法论(优化技巧)
4.1 Warp 特化的性能技巧
| 技巧 | 说明 |
|---|---|
| 指针算术外提 | 把指针运算从内循环提到构造函数,预计算偏移,省整数指令与寄存器 |
| 模板参数化 | 用模板给参数设界,编译器常量折叠省整数运算与寄存器 |
| 利用 MLP | DMA warp 发射 float4 向量化 load/store 饱和带宽,省访存指令槽 |
| 利用 ILP | 低占用率下靠 ILP 提性能;解耦后 compute warp 更少、省寄存器 |
| 细粒度同步 | 生产者-消费者原语降低屏障开销,保证 SM 总有活跃 warp 可调度 |
| 预取数据 | DMA warp 先把数据预取进寄存器,再等 compute 指示写入 shared memory |
| 避免访存冲突 | DMA warp 不受数据逻辑结构约束,可为最大全局访存合并、最小 shared bank 冲突而工程化 |
此外,warp 特化把访存流与计算流分成两个独立指令流,大幅简化编译器的指令调度与资源分配,生成更优机器码。
4.2 细粒度同步(Fine-Grained Synchronization)
__syncthreads() 是 CTA 全宽屏障,所有 warp 必须等最慢者。CudaDMA 改用命名屏障(named barriers)——通过内联 PTX 汇编实现,是支持 CTA 内子集 warp 屏障的硬件资源。每个 cudaDMA 对象关联两个命名屏障(跟踪缓冲”满/空”两状态):
bar.arrive:非阻塞地标记到达(生产者填满缓冲后继续干活;消费者读空缓冲后通知)。bar.sync:阻塞地在命名屏障上等待。
4.3 缓冲技术(Buffering Techniques)
| 技术 | 机制 | 特点 |
|---|---|---|
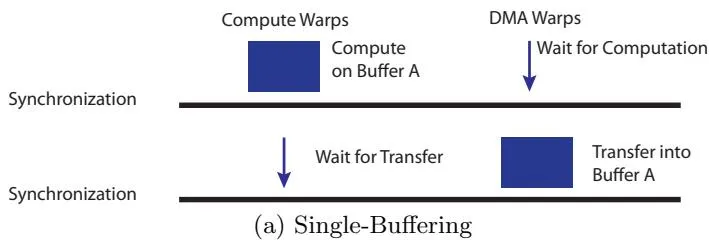
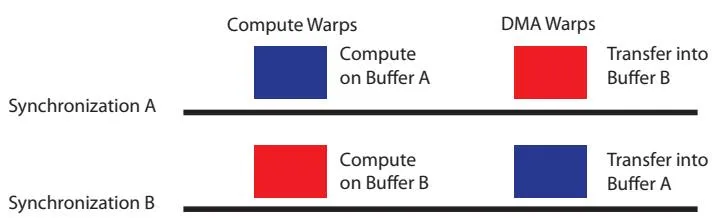
| 单缓冲(Single) | 每个传输一个缓冲 + 一个 cudaDMA 对象 | 任一时刻只有 DMA 或 compute 活跃;靠多 CTA 驻留 SM 来重叠 |
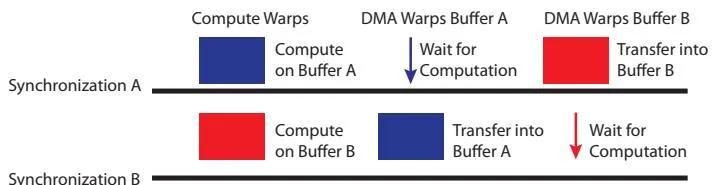
| 双缓冲(Double) | 两缓冲 + 两组 DMA warp | compute 恒忙于其一,至少一组 DMA 恒在发访存,MLP 更好;但 DMA warp 多、受寄存器限制时浪费 |
| 手动双缓冲(Manual Double) | 一组 DMA warp 跨两缓冲/两对象共享 | 所有 warp 恒活跃、资源利用最高、对调度控制最强;但非严格优于双缓冲 |
五、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| Warp 特化封装为库 | 将 DMA/compute warp 分化封装为通用 API,供广泛工作负载复用 | Sec 3 |
| 形状解耦 | 数据布局与线程块布局解耦,提升可编程性 | Sec 2.2 / 3 |
| 命名屏障生产者-消费者同步 | PTX bar.arrive/bar.sync 实现子 CTA 粒度细粒度同步 | Sec 4.2 |
| 少量 DMA warp 饱和带宽 | 仅 4 DMA warp/SM 即达峰值带宽(基线需 40 warp) | Fig 9 |
| 三种缓冲策略 | 单/双/手动双缓冲,权衡 MLP 与寄存器占用 | Sec 4.3 |
| 可扩展实例 | Sequential/Strided/Custom,专家优化+应用复用 | Sec 3.2 |
六、实验结果
6.1 微基准(Micro-benchmarks)
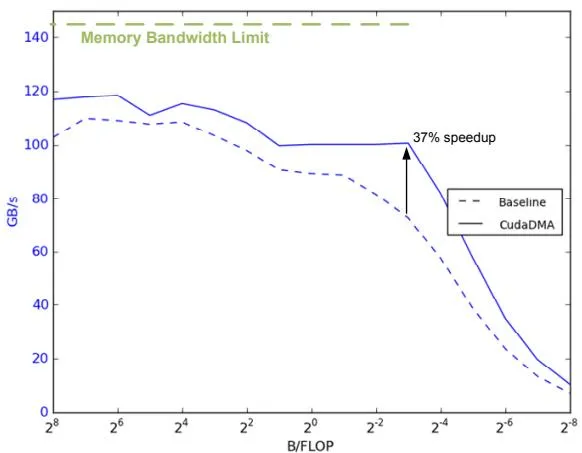
- staging 微基准:基线 16 warp(512 线程),CudaDMA 用 16 compute warp + 4 DMA warp,每次迭代 stage 相同 2KB。低计算强度下靠低开销生产者-消费者同步获中等加速;接近机器平衡点时靠 warp 特化暴露更多 MLP 获最大加速;高计算强度下同步开销/MLP 需求下降,加速减小。微基准整体最高 1.37×。
- DMA warp 数(saxpy,B/FLOP=6):基线需 40 warp 才达 120 GB/s 可达峰值;CudaDMA 仅需 4 DMA warp/SM 即可饱和,且与 compute warp 数无关。
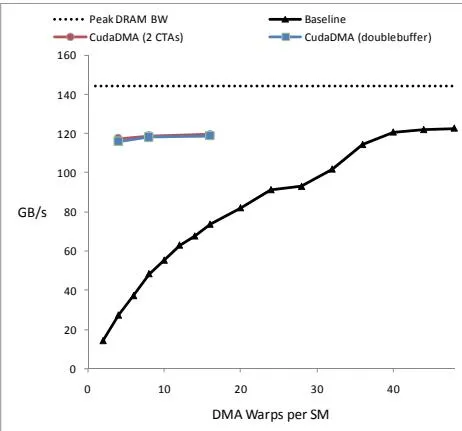
低 warp 数饱和带宽的意义:(1) 小数据集缺乏足够并行线程时仍可用 DMA 线程暴露 MLP;(2) 把访存从 compute warp 移走可释放寄存器用于中间结果,更省寄存器。
6.2 SGEMV(BLAS2)
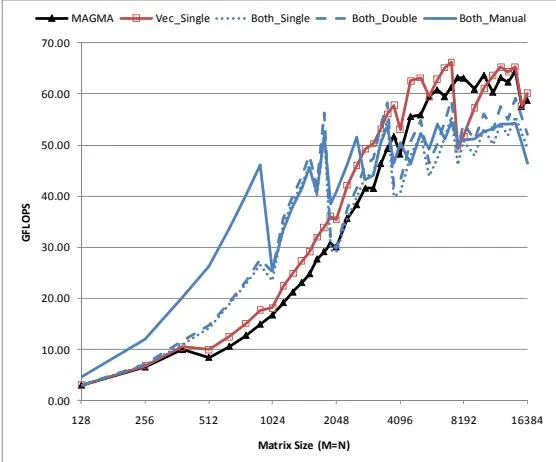
实现 6 个版本(vec-single/double/manual、both-single/double/manual),对比开源 Magma BLAS。小矩阵下 both-* 版本最高 3.2× 加速(额外 MLP 收益大),vec-single 无加速;大矩阵下并行行数增多、MLP 自然充足,both-* 反而可能拖慢,vec-single 因同步开销更低仍有 2%–10% 提升。
6.3 3D 有限差分 Stencil(8 阶)
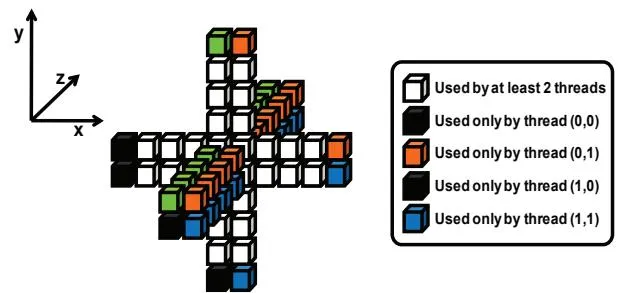
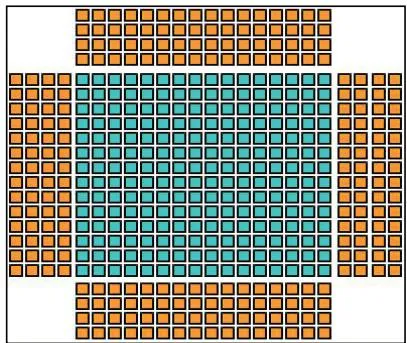
用自定义 cudaDMA 对象加载 halo(边界)数据(2 个 DMA warp 载垂直 halo,每 16 行 1 个 DMA warp 载水平 halo),与优化的 Micikevičius 代码对比:
| 版本(512³) | 时间(ms) | 带宽(GB/s) | 加速 |
|---|---|---|---|
| Reference | 27.83 | 76.85 | 1.00 |
| halo-only-single | 26.38 | 81.08 | 1.055 |
| halo-only-double | 31.66 | 67.58 | 0.879 |
| halo-only-manual | 26.12 | 81.85 | 1.065 |
| block-halo-single | 24.16 | 88.53 | 1.152 |
三种问题规模(512³/640×640×400/800×800×200)下 block-halo-single 稳定 1.13–1.15× 加速。double 因 DMA warp 过多超订内存资源反而变慢(0.88×),manual double 能挽回。
6.4 1D FFT(CUFFT 128/256 点 radix)
CUFFT 已饱和带宽但需 32 warp/SM 且溢出寄存器到 local memory。CudaDMA 用 16 compute + 8 DMA warp 在更低占用率下达到相同带宽、省寄存器避免溢出。探索了 48 种 CudaDMA 对象变体(float2/float4、主存/纹理缓存、每线程 4/8/16 点、不同转置)。结果多为小幅加速(0.93×–1.02×),核心价值是低占用率省寄存器——随算力/带宽差距扩大、片上内存愈发稀缺,未来收益更大。
七、相关工作
- 硬件 DMA 引擎:Cell Broadband Engine、Imagine Stream Processor——CudaDMA 以软件模拟其异步 DMA 思想。
- OpenCL 异步拷贝:主要面向 Cell 硬件 DMA,需全 CTA 参与、无 warp 特化机会、只支持顺序拷贝、屏障粗粒度。
- Warp 特化:此前用于 GPU 排序算法;CudaDMA 将其封装为通用库。
- 虚拟化 warp:仍映射到执行相同指令流的物理 warp,与 CudaDMA 不同。
- 编程框架:Sequoia、Python/Scala 高层并行框架可将 CudaDMA 作为后端目标。
八、总结
核心贡献
- 提出 warp 特化编程范式并封装为可扩展 API CudaDMA,把 DMA warp 与 compute warp 分离,解耦数据形状与计算形状。
- 用命名屏障(PTX bar.arrive/bar.sync)实现子 CTA 粒度的生产者-消费者细粒度同步。
- 提供 Sequential/Strided/Custom 实例与单/双/手动双三种缓冲策略,封装专家级带宽优化。
- 实证:微基准 1.37×,科学计算 kernel 1.15×–3.2× 加速(Fermi)。
技术影响
CudaDMA 是”warp 特化 + 生产者-消费者”这一 GPU 编程模式的奠基工作之一,其思想深刻影响了后续 GPU kernel 设计——现代高性能 attention/GEMM kernel(如 FlashAttention-3、ThunderKittens)广泛采用的 producer-consumer warp specialization + 异步内存搬运(TMA) 正是同一思想在 Hopper 硬件上的延续。
局限性
- 依赖计算为 streaming 形式(可改造但需人工重构)。
- 仅头文件库、无 warp-specialization-aware 编译器支持,寄存器等资源共享靠人工管理。
- 收益主要集中在计算-访存比接近硬件平衡点的应用;对已饱和带宽或强 MLP 的大规模问题收益有限甚至为负。
- 未探索稀疏访存模式(作者列为 future work)。
九、参考资源
- 论文 PDF:CudaDMA: Optimizing GPU Memory Bandwidth via Warp Specialization (SC’11)
- 相关文档:
- Lean Attention(注意力 kernel 的访存/调度优化)
- Veda: 蒸馏式稀疏注意力(其 kernel 用 Hopper TMA + Warp Specialization 生产者-消费者范式,正是 CudaDMA 思想的现代延续)