CommitMoE: Efficient Fallback-Free MoE Inference with Offloading under GPU Memory Constraints
通过量化填充、专家内存池和层感知调度实现无回退的高效MoE推理,相比MoE-Infinity加速2.86倍
CommitMoE: Efficient Fallback-Free MoE Inference with Offloading under GPU Memory Constraints
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | CommitMoE: Efficient Fallback-Free MoE Inference with Offloading under GPU Memory Constraints |
| 作者 | Haiyang Xu, Minghao Tian, Zixuan Zheng, Yuan Yang, Xin Liu, Zijian Wang, Hao Zhang |
| 机构 | 阿里巴巴集团、北京大学计算机学院 |
| 论文 | |
| 硬件 | NVIDIA RTX 4090 (24GB VRAM) |
| 领域 | LLM推理优化、MoE卸载 |
二、核心思想
问题定义
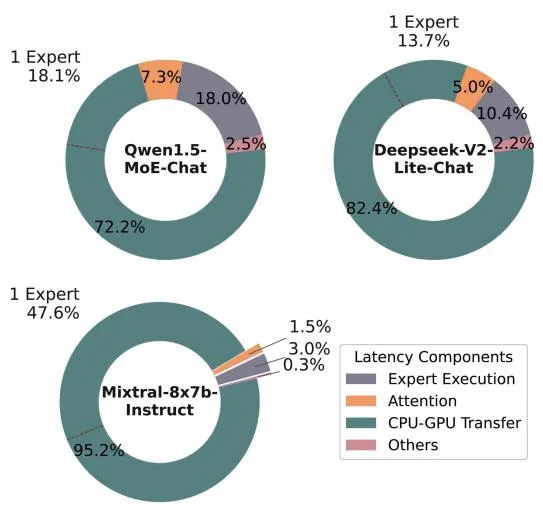
Figure 1: 典型MoE模型(分别激活2、4、6个专家)在RTX 4090上的逐块推理延迟分解
大型语言模型(LLMs)采用混合专家(MoE)架构,每个token仅激活部分专家,实现性能与计算效率的平衡。将非活跃专家卸载到CPU内存是在有限GPU内存下运行大型MoE模型的有效方法。
现有方法的局限:现有卸载方法在GPU资源不足时会回退到CPU计算,导致显著延迟开销。
内存浪费的三个来源
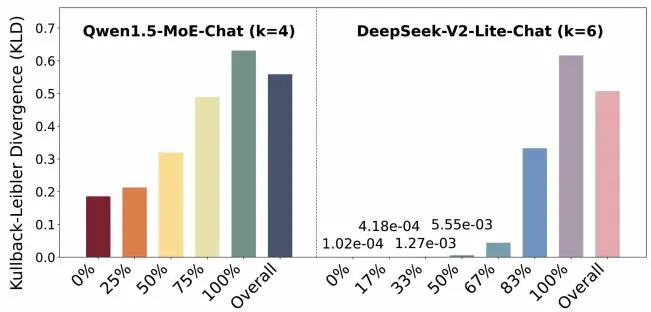
Figure 2: Qwen1.5-MoE-Chat (k=4) 和 DeepSeek-V2-Lite-Chat (k=6) 在GSM8K数据集上的KL散度与预测准确率
通过实验发现,MoE推理中的内存浪费来自三个主要来源:
1. 量化后专家大小不均匀
| 指标 | Mixtral-8x7B | Mixtral-8x22B |
|---|---|---|
| 专家大小范围 (8-bit) | 0.57GB - 1.15GB | 0.57GB - 1.15GB |
| 标准差 | 0.13GB | 0.18GB |
原因:
- 原始专家参数维度不同(如Mixtral-8x7B的ffn.*.w1维度为[3584, 14336])
- 均匀量化粒度无法适配所有专家
- 专家具有不同的活跃参数数量
- 量化引入非均匀数据打包(0.26%方差)
- 即使同名专家在不同transformer层也可能不同(0.02%方差)
2. 动态变化的专家大小导致无效内存管理
卸载系统推理过程:
- 分析待处理token确定需加载的专家
- 将专家从CPU复制到GPU内存
- GPU执行专家计算
GPU内存不足时的处理:
- 必须从GPU内存中移除某些专家
- 但因为专家大小不均匀,GPU内存无法充分利用
- 需要频繁加载和驱逐专家
3. 回退机制导致的冗余计算
MoE-Infinity的回退策略:
- 驱逐”最不常用”(LFU)专家
- 如果该专家被多次引用,后续计算将回退到CPU
回退开销:
- 一次推理可能有多层和多个专家需要回退
- 每次回退需要3次CPU-GPU同步操作:
- 将隐藏状态从GPU复制到CPU
- CPU计算
- 将结果复制回GPU
- 相比原生GPU计算,回退导致2.28倍延迟开销
三、CommitMoE解决方案
推理时间线对比
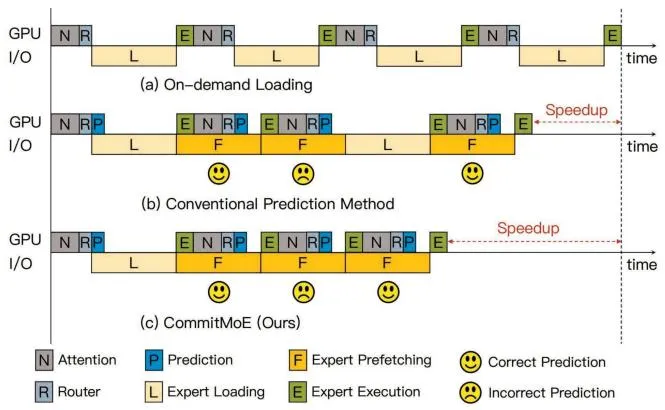
Figure 3: 卸载下的推理时间线对比:(a) 标准按需加载, (b) 带回退的预取, (c) CommitMoE的无回退执行
系统概述
CommitMoE采用以GPU为中心的设计,实现无回退的MoE推理,同时最小化CPU-GPU数据移动。
核心技术
1. 量化填充 (Quantization Padding)
目标:统一对齐同一transformer块内的专家大小,消除内存碎片
方法:
- 分析量化后所有专家的数据类型和大小
- 应用适当填充使所有专家大小相等
- 通过统一专家大小,减少主机-设备传输延迟
效果:
- 消除专家大小方差
- 实现高效的GPU内存管理
- 降低CPU-GPU数据传输开销
2. 专家内存池 (Expert Memory Pool)
目标:最大化GPU内存利用率,实现高效专家缓存
设计要点:
- 专用内存分配器管理专家数据
- 最大化GPU内存利用以缓存更多专家
- 避免频繁的内存分配和释放
优势:
- 消除内存碎片
- 提高专家缓存命中率
- 减少不必要的数据移动
3. 层感知专家调度 (Layer-Aware Expert Scheduling)
目标:感知transformer层结构,最小化CPU-GPU数据移动
方法:
- 基于transformer层结构优化专家加载顺序
- 考虑不同层的专家需求
- 智能预取和驱逐策略
效果:
- 最小化CPU-GPU数据移动
- 提高整体推理效率
四、系统架构
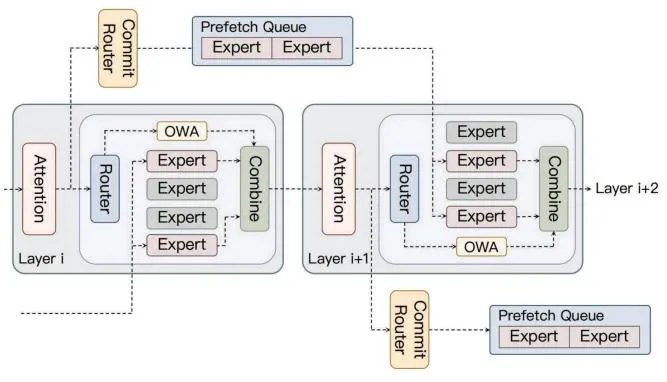
Figure 4: CommitMoE系统架构,展示Commit Router在当前层执行时预测下一层的专家,以及Output Weight Adjustment (OWA)机制
CommitMoE采用分析-执行的两阶段方法:
分析阶段
- 配置解析:处理transformer块的隐藏大小、专家数量、专家中间大小等
- 量化:
- 激活感知校准对FFN层进行W4A16量化
- 对注意力层进行W8A8量化
- 模型分片:根据分析结果将模型组件分配到GPU内存
执行阶段
- 运行时推理引擎
- CPU-GPU数据传输管理
- 专家缓存管理
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| GPU | NVIDIA RTX 4090 (24GB VRAM) |
| 模型 | Mixtral-8x7B, Mixtral-8x22B, DeepSeek-V2-Lite |
| 量化 | W4A16 (FFN), W8A8 (注意力) |
| 数据集 | WikiText-2, PIQA, HellaSwag, WinoGrande, ARC |
性能对比
表1: 与现有系统的性能对比 (Mixtral-8x7B)
| 系统 | 吞吐量 (token/s) | 相对性能 |
|---|---|---|
| 无限GPU内存 (上限) | 9.65 | 1.00x |
| CommitMoE | 9.55 | 0.99x |
| MoE-Infinity | 3.34 | 0.35x |
| FlexMoE | 7.54 | 0.78x |
| FlowMoE | 5.28 | 0.55x |
关键结果:
- CommitMoE仅比无限GPU内存上限慢1%
- 相比MoE-Infinity:2.86倍加速
- 相比FlexMoE:1.27倍加速
- 相比FlowMoE:1.81倍加速
质量评估
表2: 质量对比 (Mixtral-8x7B)
| 系统 | WikiText-2 (PPL) | HellaSwag | PIQA | WinoGrande | ARC |
|---|---|---|---|---|---|
| 原始模型 | 3.83 | 0.64 | 0.74 | 0.52 | 0.65 |
| MoE-Infinity | 3.84 | 0.64 | 0.74 | 0.52 | 0.65 |
| FlexMoE | 3.83 | 0.64 | 0.74 | 0.52 | 0.65 |
| FlowMoE | 3.84 | 0.64 | 0.74 | 0.52 | 0.65 |
| CommitMoE | 3.84 | 0.64 | 0.74 | 0.52 | 0.65 |
质量结论:
- CommitMoE在所有基准测试中保持与原始模型相同的质量
- 困惑度(PPL)方差仅为0.24%
- 精度损失可忽略不计
不同模型规模
表3: 不同模型的性能提升
| 模型 | CommitMoE加速比 |
|---|---|
| Mixtral-8x7B | 2.86x |
| Mixtral-8x22B | 2.82x |
| DeepSeek-V2-Lite | 1.93x |
六、关键创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 量化填充 | 统一对齐专家大小 | 消除内存碎片 |
| 专家内存池 | 专用GPU内存管理 | 最大化缓存利用率 |
| 层感知调度 | 感知transformer层结构 | 最小化数据移动 |
| 无回退设计 | 消除CPU回退计算 | 避免同步开销 |
七、相关工作对比
| 方法 | 策略 | CommitMoE优势 |
|---|---|---|
| MoE-Infinity | CPU回退 + LFU驱逐 | 2.86x加速,无回退开销 |
| FlexMoE | 灵活卸载 | 1.27x加速,更好内存管理 |
| FlowMoE | 流水线卸载 | 1.81x加速,层感知调度 |
八、总结
核心贡献
- 问题诊断:识别MoE推理中内存浪费的三个来源(量化不均匀、动态大小、回退开销)
- 量化填充:统一对齐专家大小,消除内存碎片
- 专家内存池:专用GPU内存管理,最大化缓存利用率
- 层感知调度:最小化CPU-GPU数据移动
- 无回退设计:完全消除CPU回退计算,避免同步开销
实际意义
- 在24GB GPU内存上高效运行大型MoE模型
- 仅需1%的性能损失(相比无限GPU内存)
- 保持原始模型的推理质量
- 显著降低MoE部署成本
技术影响
- 为资源受限环境下的MoE部署提供了实用解决方案
- 证明了无回退卸载的可行性和优越性
- 为MoE系统优化提供了新的设计思路
九、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | MoE推理延迟分解 | figure1-latency-breakdown.jpg |
| Figure 2 | KL散度与预测准确率 | figure2-kl-divergence-accuracy.jpg |
| Figure 3 | 推理时间线对比 | figure3-inference-timeline-comparison.jpg |
| Figure 4 | CommitMoE系统架构 | figure4-system-architecture.jpg |