CasMoE: A Cascaded Framework for Efficient MoE Inference on Resource-constrained
通过级联规划器(EAM+EAP)实现高效专家预取,在资源受限设备上加速MoE推理,吞吐量提升65.13%
CasMoE: A Cascaded Framework for Efficient MoE Inference on Resource-constrained Devices
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | CasMoE: A Cascaded Framework for Efficient MoE Inference on Resource-constrained Devices |
| 作者 | Chengcheng Wang, Haowen He, Liang Zhao, Xiaoheng Deng, Lixin Duan, Shaohua Wan |
| 机构 | 电子科技大学 (UESTC)、沈阳航空航天大学、中南大学 |
| 论文 | |
| 硬件 | 4× NVIDIA RTX 4090, 2× Intel Xeon Gold 6330 |
| 领域 | MoE推理优化、专家预取 |
二、核心思想
问题定义
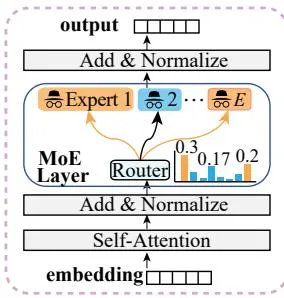
Figure 1a: MoE架构通过门控机制实现高效的条件计算
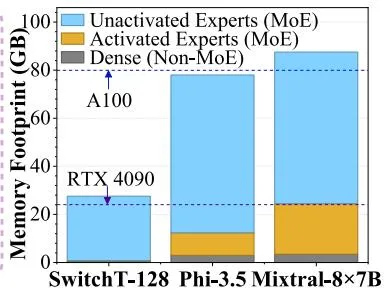
Figure 1b: MoE模型的内存消耗分析
MoE架构通过门控机制选择性激活少量专家模块,实现高效的条件计算。然而,专家模块的内存需求对资源受限设备上的推理提出了巨大挑战:
- Mixtral-8×7B:推理需要约87GB显存,超过A100-80GB的容量
- 但实际使用仅约24GB权重(密集组件+激活专家)
- 在SST-2数据集上,专家加载占推理时间的40.8%
现有方法局限
| 方法 | 策略 | 局限 |
|---|---|---|
| 模型压缩 | 减小模型大小 | 牺牲精度 |
| 按需加载 | 动态加载专家 | 高通信开销 |
| SE-MoE | 预加载下一层所有专家 | 内存和延迟增加 |
| Mixtral-Offloading | 基于激活相似性预测 | 精度不足 |
| MoE-Infinity | 序列级专家追踪 | 效率-质量难平衡 |
解决方案概述
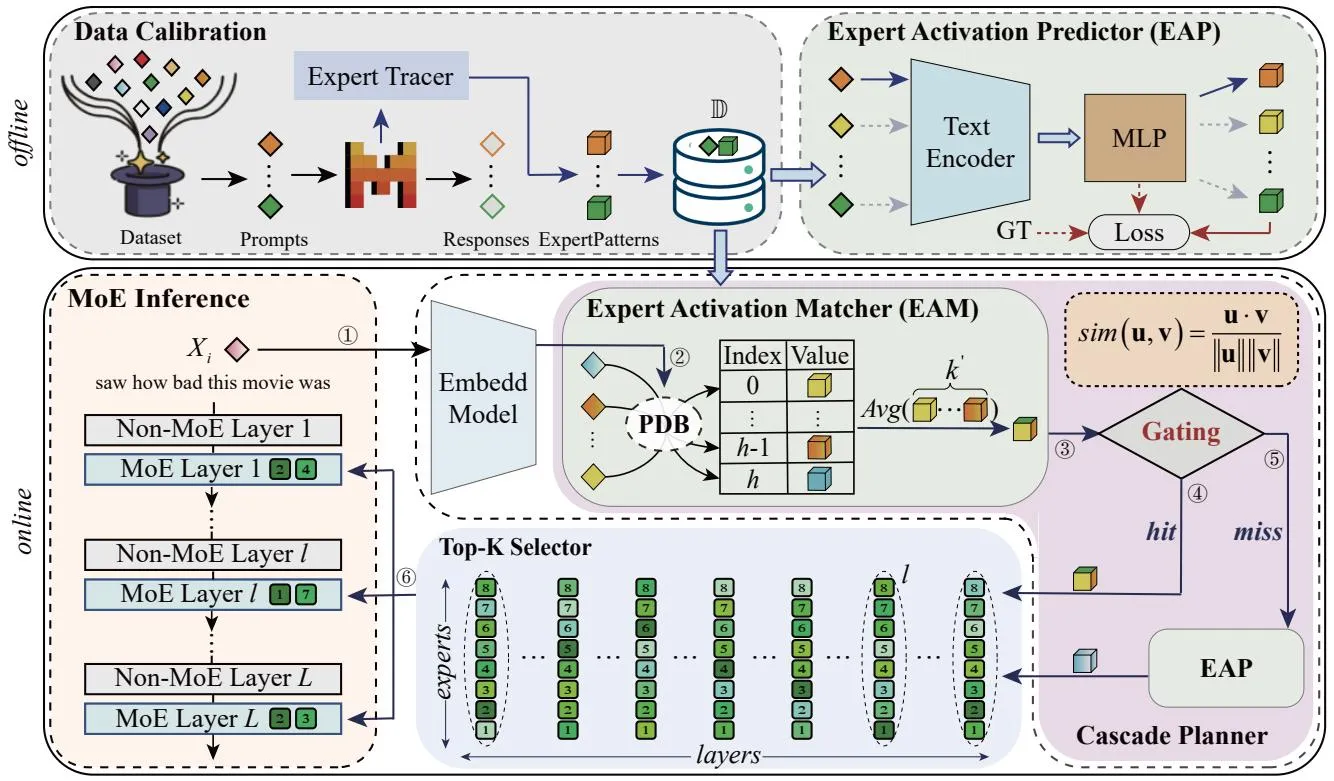
Figure 2: CasMoE框架概述。离线阶段追踪专家模式构建EAM和训练EAP;在线阶段通过级联规划器预测所有MoE层的专家模式
CasMoE 采用两阶段离线-在线方法实现高效专家预取:
-
离线阶段:
- 追踪数据集在预训练MoE模型上的专家激活模式
- 构建专家激活匹配器 (EAM):基于相似度索引的非参数化检索
- 训练专家激活预测器 (EAP):轻量级编码器+预测头
-
在线阶段:
- 级联规划器:独立于MoE架构,在解码前单次预测所有MoE层的专家模式
- 门控机制:动态调整EAM和EAP的灵敏度,灵活平衡效率与质量
三、技术架构
问题形式化
给定输入 prompt ,目标是预测所有MoE层的专家激活模式 ,其中:
- \mathcal{E} = \{\mathcal{E}_0, \mathcal{E}_1, \cdots, \mathcal{E}_L}:所有MoE层的激活专家集合
- :第 层的选择专家集合
- :每层选择的专家数量
数据校准
专家模式标签设计:
其中 是MoE路由器的输出, 是指示函数。
特点:
- 考虑专家选择频率和对token解码的重要性
- 生成 的专家模式矩阵
- 配对 prompt 和专家模式构建校准数据集
级联规划器
专家激活匹配器 (EAM)
非参数化方法,基于数据集 构建:
- 使用 sentence-transformers 计算 prompt 嵌入作为键
- 存储对应的专家激活模式作为值
- 构建 HNSW索引(Hierarchical Navigable Small World)支持相似度检索
检索过程:
检索 top- 最相似键,融合输出:
优势:快速检索,支持数据更新
专家激活预测器 (EAP)
参数化方法,准确预测专家模式:
- 编码器:轻量级 BERT 模型捕捉语言特征
- 预测头: 个 MLP 预测头,输出维度为
训练目标:
对比学习损失(SimCSE):
Huber损失(回归任务):
总损失:
门控机制
利用 EAM 的余弦相似度作为置信度分数:
- 相似度 > 阈值 :采用 EAM 结果
- 相似度 ≤ 阈值 :调用 EAP 预测
推理流程
- 计算输入 prompt 的嵌入
- 使用 EAM 检索 top- 嵌入,推导融合模式
- 如果嵌入相似度低于阈值 ,触发 EAP 预测
- 将专家模式转换为专家选择(top-k)
- 系统预取对应专家用于解码
- 使用缓冲区(大小 )暂存新 prompt 及其模式,满后更新 PDB
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 级联规划器 | EAM+EAP+门控机制 | 灵活平衡效率与质量 |
| 非参数化 EAM | HNSW索引+余弦相似度 | 快速检索(1.22ms) |
| 参数化 EAP | TinyBERT+MLP预测头 | 高精度预测(98%准确率) |
| Prompt级预取 | 单次预测所有MoE层 | 避免逐层预测开销 |
| 对比学习训练 | SimCSE+Huber损失 | 鲁棒语义嵌入 |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 模型 | Mixtral-8×7B(混合量化) |
| GPU | 4× NVIDIA RTX 4090 |
| CPU | 2× Intel Xeon Gold 6330 |
| 数据集 | GLUE (8个子集), MMLU, WMT16 |
| EAP架构 | 6层TinyBERT + 2层MLP |
| 隐藏大小 | 64, 中间大小 128 |
| 学习率 | |
| 缓冲区大小 |
推理质量
表1: GLUE基准测试准确率
| 方法 | CoLA | SST-2 | MRPC | QQP | MNLI | QNLI | WNLI | RTE | 平均 |
|---|---|---|---|---|---|---|---|---|---|
| All-in-GPU | 0.72 | 0.89 | 0.74 | 0.72 | 0.54 | 0.74 | 0.69 | 0.77 | 0.73 |
| MoE-OnDemand | 0.72 | 0.89 | 0.74 | 0.72 | 0.54 | 0.74 | 0.69 | 0.77 | 0.73 |
| SE-MoE | 0.72 | 0.89 | 0.74 | 0.72 | 0.54 | 0.74 | 0.69 | 0.77 | 0.73 |
| Mixtral-Offloading | 0.64 | 0.69 | 0.51 | 0.59 | 0.48 | 0.54 | 0.62 | 0.62 | 0.59 |
| AdapMoE | 0.72 | 0.88 | 0.67 | 0.78 | 0.39 | 0.48 | 0.56 | 0.68 | 0.64 |
| CasMoE | 0.72 | 0.88 | 0.72 | 0.70 | 0.50 | 0.73 | 0.69 | 0.74 | 0.71 |
表2: MMLU和WMT16准确率
| 方法 | MMLU | WMT16 |
|---|---|---|
| All-in-GPU | 0.792 | 43.366 |
| MoE-OnDemand | 0.792 | 43.366 |
| SE-MoE | 0.792 | 43.366 |
| Mixtral-Offloading | 0.626 | 27.720 |
| AdapMoE | 0.507* | 25.024 |
| CasMoE | 0.572 | 34.153 |
*注:AdapMoE在MMLU上出现OOM
推理效率
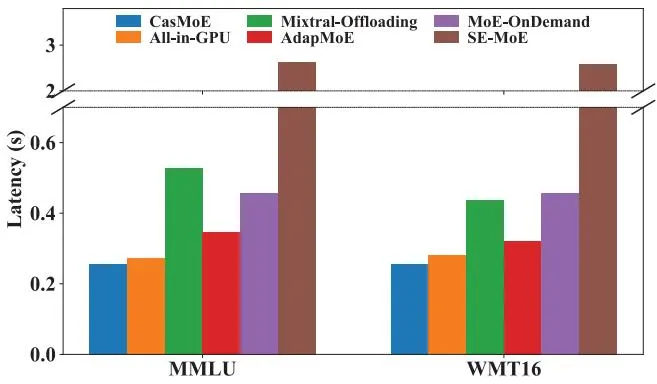
Figure 3: MMLU和WMT16上的延迟评估
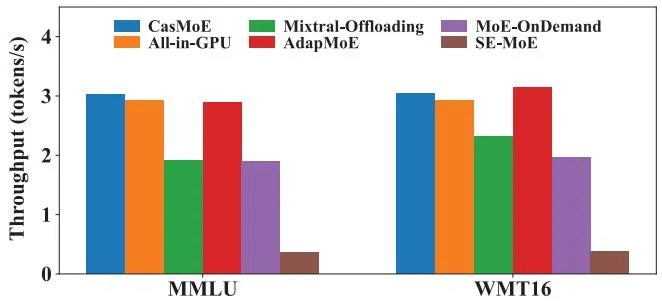
Figure 4: MMLU和WMT16上的吞吐量评估
关键结果:
- 相比SE-MoE:10×性能提升
- 相比MoE-OnDemand:2×性能提升
- GLUE子集上吞吐量超过3.0
- 相比按需加载基线:65.13%吞吐量提升
- 性能保持率:96.6%
GLUE详细结果
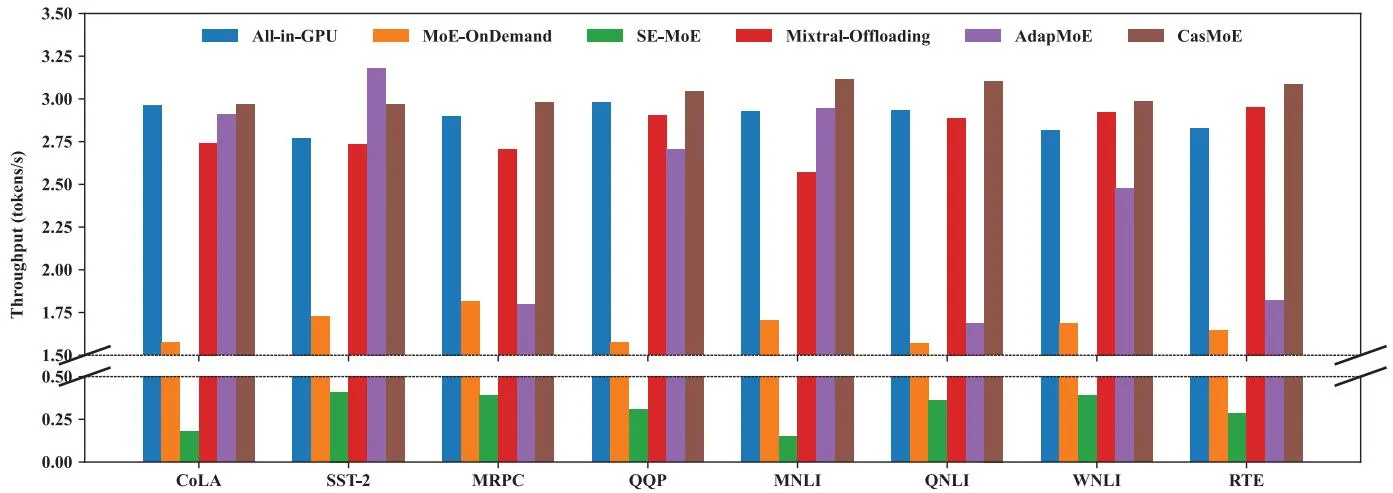
Figure 5a: GLUE各子集上的吞吐量对比
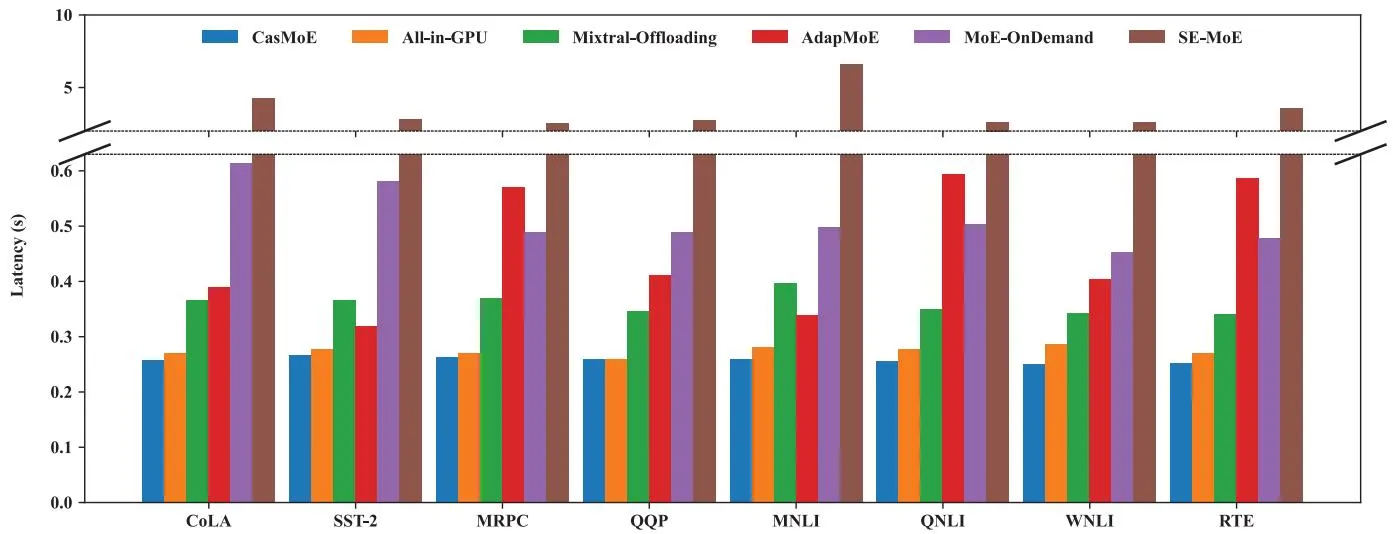
Figure 5b: GLUE各子集上的延迟对比
消融实验
表3: EAP和EAM的贡献(CoLA数据集)
| 方法 | 准确率 | 吞吐量 |
|---|---|---|
| All-in-GPU | 0.72 | 2.963 |
| 仅EAP | 0.71 | 2.971 |
| EAP + EAM | 0.72 | 3.074 |
EAP性能:
- 预测准确率:98%
- 计算时间:10.73ms
- 内存占用:300MB
EAM性能:
- 检索时间:1.22ms
- 无需BERT计算,降低规划器开销
表4: 标签设计评估(CoLA)
| 标签 | 准确率 |
|---|---|
| All-in-GPU | 0.72 |
| count | 0.62 |
| EP (ours) | 0.72 |
六、相关工作对比
| 方法 | 策略 | 预测粒度 | CasMoE优势 |
|---|---|---|---|
| MoE-OnDemand | 按需加载 | 无预测 | 2×加速 |
| SE-MoE | 全层预取 | 无预测 | 10×加速 |
| Mixtral-Offloading | 激活相似性 | 逐层 | 更高精度 |
| Pregated-MoE | 预门控 | 逐层 | Prompt级预取 |
| MoE-Infinity | 序列级追踪 | 序列级 | 灵活效率-质量平衡 |
| AdapMoE | 自适应门控 | 多层 | 无OOM问题 |
七、总结
核心贡献
- 级联规划器:集成EAM和EAP,通过门控机制动态调整灵敏度
- 非参数化 EAM:基于HNSW索引的快速专家检索,支持数据更新
- 参数化 EAP:轻量级编码器+对比学习,端到端训练提高预测精度
- Prompt级预取:单次预测所有MoE层专家模式,避免逐层预测开销
- 灵活平衡:门控机制实现效率与质量的动态权衡
实际意义
- 在资源受限设备上高效运行MoE模型
- 吞吐量提升65.13%,性能保持96.6%
- 支持多种下游任务(GLUE、MMLU、WMT16)
- 无需修改MoE架构,通用性强
技术影响
- 为MoE推理优化提供了新的级联规划范式
- 证明了prompt级专家预取的有效性
- 非参数化+参数化混合方法的典范
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1a | MoE架构 | figure1a-moe-architecture.jpg |
| Figure 1b | MoE内存消耗 | figure1b-moe-memory-consumption.jpg |
| Figure 2 | CasMoE框架概述 | figure2-casmoe-overview.jpg |
| Figure 3 | 延迟评估 | figure3-latency-evaluation.jpg |
| Figure 4 | 吞吐量评估 | figure4-throughput-evaluation.jpg |
| Figure 5a | GLUE吞吐量 | figure5a-glue-throughput.jpg |
| Figure 5b | GLUE延迟 | figure5b-glue-latency.jpg |