Atom: Low-bit Quantization for Efficient and Accurate LLM Serving
一种低比特量化方法,通过混合精度、细粒度分组量化和动态量化实现高效LLM推理
Atom: Low-bit Quantization for Efficient and Accurate LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Atom: Low-bit Quantization for Efficient and Accurate LLM Serving |
| 作者 | Yilong Zhao, Chien-Yu Lin, Kan Zhu, Zihao Ye, Lequn Chen, Size Zheng, Luis Ceze, Arvind Krishnamurthy, Tianqi Chen, Baris Kasikci |
| 机构 | University of Washington |
| 论文 | arXiv:2310.19102 |
| 发布 | 2023年10月29日 (v1), 2024年4月16日 (v3) |
| 领域 | cs.LG (Machine Learning) |
二、核心思想
问题定义
大型语言模型(LLM)在内容生成、智能聊天机器人和情感分析等应用中的需求日益增长,给LLM服务提供商带来了巨大挑战。为了高效使用GPU资源并提升吞吐量,批处理多个请求已成为主流范式;为进一步加速批处理,LLM量化技术被用于减少内存消耗并增加计算能力。
然而,现有的量化方案(如8-bit权重-激活量化)无法充分利用现代GPU的能力,例如4-bit整数运算器,导致性能未达最优。
解决方案概述
Atom提出了一种低比特量化方法,通过以下关键技术实现高吞吐量提升和可忽略的精度损失:
- 混合精度量化:保留少量但显著的激活和权重在高精度以保持精度
- 细粒度分组量化:在权重和激活上应用分组量化,自然减少量化误差
- 动态激活量化:动态量化激活以最佳捕获每个输入的分布
- KV-cache量化:将KV-cache量化为低比特表示以减少内存移动
核心成果:Atom将端到端吞吐量(token/s)相比FP16提升最高7.7×,相比INT8量化提升2.5×,同时保持相同的延迟目标。
三、技术架构
整体框架图
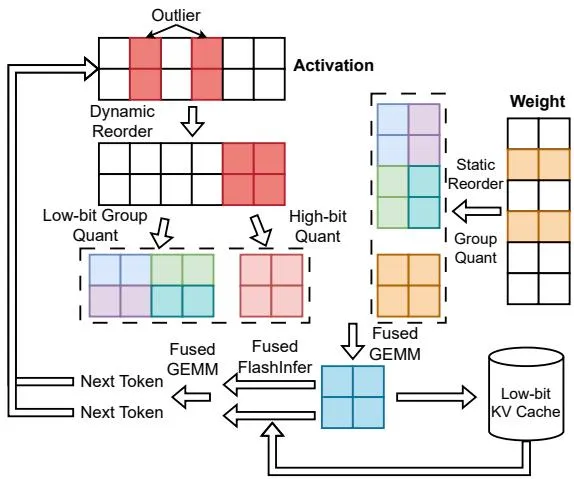
Figure 1: Atom设计概览。对于激活矩阵,动态重排序通道以挑选离群值。然后对正常值应用低比特分组量化,对离群值使用高精度。对于权重矩阵,量化过程可以静态完成。执行融合GEMM和融合FlashInfer以提升吞吐量。同时采用量化KV-cache减少内存移动。
核心公式
量化基础
非对称量化参数计算:
量化张量计算:
对称量化简化:
权重-激活乘法:
其中需要计算三个额外的交叉项,因此Atom采用对称量化以提高效率。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 混合精度模块 | 保留128个离群通道在INT8精度 | 离群通道数=128 |
| 通道重排序 | 将离群通道移至矩阵末尾 | 离线校准确定重排序索引 |
| 分组量化 | 对权重和激活应用细粒度分组量化 | 组大小=128 |
| 动态量化 | 推理时动态计算激活的量化参数 | 裁剪阈值: 激活=0.9, 权重=0.85 |
| KV-cache量化 | 对KV-cache应用低比特非对称量化 | 注意力头粒度 |
| 融合GEMM | 将量化/反量化操作融合到MMA流水线 | INT4 Tensor Cores |
训练流程
Atom采用**后训练量化(PTQ)**方法,无需重新训练:
-
离线预处理:
- 使用128个随机采样的WikiText2句子作为校准数据
- 识别128个具有最高平方和值的通道作为离群通道
- 根据离群通道索引重排激活和权重矩阵
- 使用GPTQ对权重矩阵进行量化
-
在线推理:
- 动态量化激活矩阵
- 执行融合GEMM操作
- 量化KV-cache并融合到FlashInfer
量化时间:在单个RTX Ada 6000上,Llama-65B约需4小时完成量化。
工作流程图
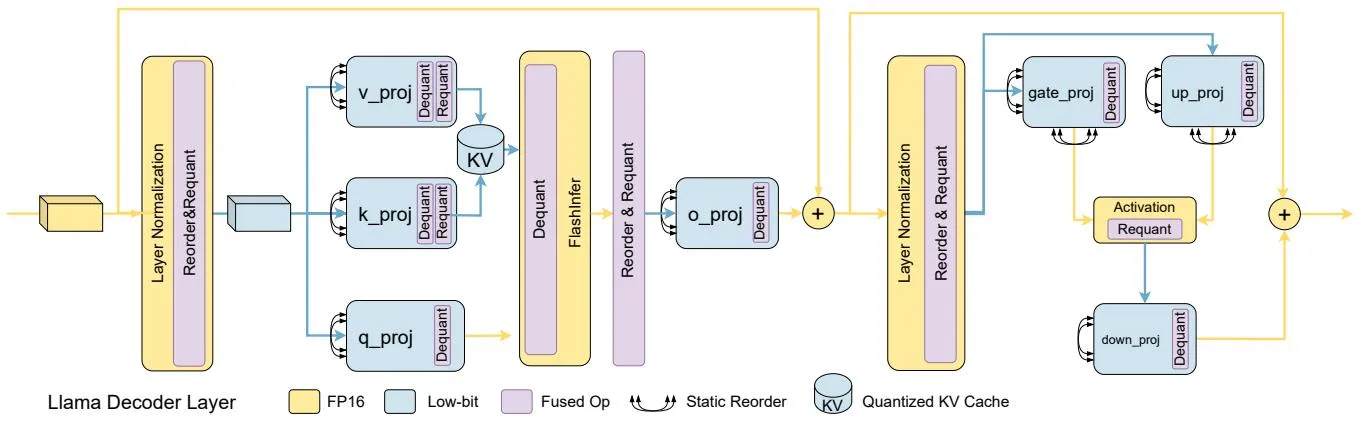
Figure 5: Atom在Llama模型家族上的工作流程概览。Atom通过融合量化算子到现有算子来精心管理开销。对于计算密集型算子,利用高效低比特硬件支持。对于内存密集型自注意力层,量化KV-cache以进一步提升吞吐量。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 混合精度+通道重排序 | 通过重排序将离群通道移至末尾,实现规则内存访问 | 相比矩阵分解方法,延迟降低25-35% |
| 融合GEMM内核 | 将分组反量化和累加融合到MMA流水线 | 770 TOPS吞吐量,超过INT8理论极限18% |
| 动态激活量化 | 推理时动态计算量化参数,融合到前序算子 | 额外开销<0.5%运行时间 |
| KV-cache量化 | 利用Softmax归一化特性,K-cache误差影响小;V-cache离群现象少 | 4-bit KV-cache仅增加0.12困惑度 |
消融实验结果
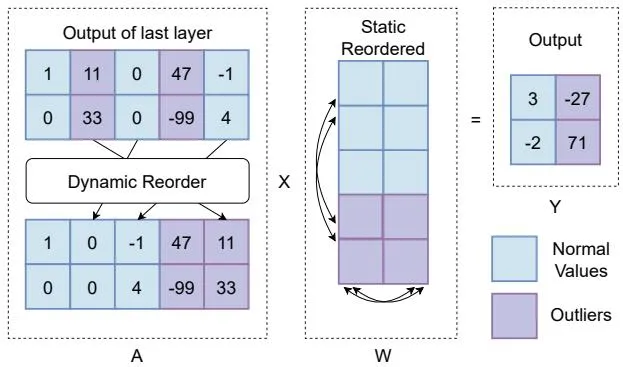
Figure 6: Atom动态重排序激活(A)以将离群通道移至矩阵末尾,重排序索引通过离线校准确定。权重矩阵(W)静态重排序以保持与对应激活通道的对齐。
| 量化方法 | WikiText2 PPL ↓ |
|---|---|
| FP16 baseline | 5.68 |
| W4A4 RTN | 2315.52 |
| + 保留128个离群值在FP16 | 11.34 (↓2304.2) |
| + 量化离群值到INT8 | 11.39 (↑0.05) |
| + 组大小128 | 6.22 (↓5.17) |
| + 裁剪 | 6.13 (↓0.09) |
| + GPTQ | 6.04 (↓0.09) |
| + 量化KV-cache到INT4 | 6.16 (↑0.12) |
关键发现:
- 保留离群通道在FP16显著降低困惑度(从2315.52降至11.34)
- 进一步将离群值量化到INT8仅增加0.05困惑度
- 细粒度分组量化带来另一个主要困惑度降低(5.17)
- 裁剪和GPTQ各降低0.09困惑度
五、实验结果
基准测试
零样本精度 (Zero-shot Accuracy)
Llama-7B W4A4量化对比:
| 方法 | PIQA | ARC-e | ARC-c | BoolQ | HellaSwag | Winogrande | 平均 |
|---|---|---|---|---|---|---|---|
| FP16 | 77.37 | 52.53 | 41.38 | 73.12 | 72.99 | 66.85 | 64.04 |
| SmoothQuant | 63.11 | 40.03 | 31.57 | 58.47 | 43.38 | 52.80 | 48.23 |
| OmniQuant | 66.15 | 45.20 | 31.14 | 63.51 | 56.44 | 53.43 | 52.65 |
| Atom | 76.28 | 52.10 | 38.99 | 69.79 | 69.81 | 63.69 | 61.78 |
Atom在W4A4量化下仅损失2.3%平均精度,而其他方法损失9.6-23.8%。
困惑度 (Perplexity)
Llama-65B W4A4量化对比:
| 方法 | WikiText2 | PTB | C4 |
|---|---|---|---|
| FP16 | 3.53 | 6.91 | 5.62 |
| SmoothQuant | 88.89 | 278.76 | 283.80 |
| OmniQuant | 9.18 | 16.18 | 11.31 |
| QLLM | 6.87 | - | 8.98 |
| Atom | 3.89 | 7.22 | 5.92 |
Atom在Llama-65B上仅增加0.36 WikiText2困惑度。
效率评估
内核性能
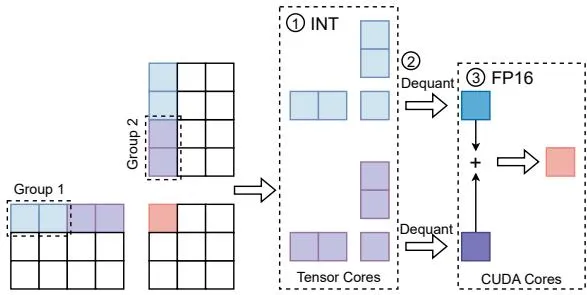
Figure 7: 融合GEMM算子概览。每组的乘法首先由具有高效低比特支持的单元计算,即Tensor Cores(步骤1)。结果随后被反量化并与典型的FP16单元累加(步骤2, 3)。所有操作融合在单个流水线中。
- 矩阵乘法:批大小512时,Atom相比FP16和INT8内核分别实现**3.4×和1.9×**加速
- 自注意力:批大小128时,Atom相比INT8和FP16分别实现**1.8×和3.5×**加速
端到端性能
- 吞吐量:Atom相比FP16基线提升最高7.7×,相比INT8量化提升2.5×
- 延迟:在批大小64时,延迟低于INT8或FP16实现;即使在批大小256时,延迟仍低于100ms
与现有方法对比
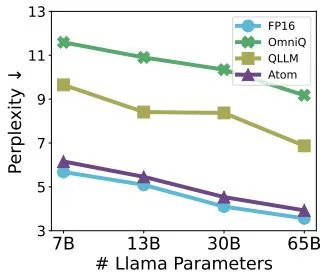
Figure 2: Llama模型上不同4-bit权重-激活量化机制的WikiText2困惑度。Atom在所有模型大小上保持接近FP16基线的困惑度结果。
运行时分解
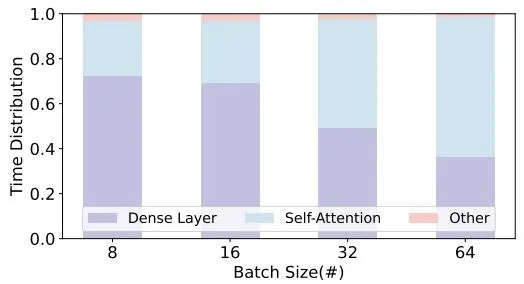
Figure 3: 不同批大小下Llama-7b推理的运行时分解。密集层代表批处理的K、Q、V生成、O投影和MLP。自注意力层由FlashInfer集成PageAttention实现。结果表明密集层和自注意力层合计占执行时间的90%以上。
六、相关工作
LLM服务优化
- Orca:提出连续批处理以提高GPU利用率
- vLLM:使用页表管理KV-cache,显著增加GPU内存利用率
- FlexGen:提出卸载机制以支持更大批处理
权重量化
- GPTQ:使用近似二阶信息进行4-bit量化
- AWQ:通过保留显著权重进一步提高精度
- SqueezeLLM:通过非均匀量化处理离群值
- QuiP:通过自适应舍入方法成功用2-bit表示权重
权重-激活量化
- LLM.INT8:提出混合精度保留激活中的离群值
- SmoothQuant:使用数学等效变换管理激活离群值
- OmniQuant:重排通道以减少量化组内的方差
- QLLM:使用低秩矩阵补偿量化误差
七、总结
核心贡献
- 全面的性能分析:深入分析LLM服务工作负载,确定低比特权重-激活量化的效率优势
- Atom量化算法:结合(1)混合精度+通道重排序、(2)细粒度分组量化、(3)动态激活量化、(4)KV-cache量化
- 集成服务框架:共同设计高效推理工作流,实现低比特GPU内核
- 全面评估:显示Atom提升LLM服务吞吐量最高7.7×,仅损失1.4%零样本精度
技术影响
- 硬件利用:充分利用现代GPU的INT4 Tensor Cores能力
- 内存优化:通过KV-cache量化显著减少内存移动
- 精度保持:在极低比特精度下保持高精度,为大规模LLM部署提供可行方案
局限性
- 模型泛化:主要在Llama系列模型上验证,对其他架构的泛化性需进一步验证
- 硬件依赖:依赖特定硬件的INT4支持(如NVIDIA Ampere)
- 量化开销:离线量化过程对大模型需要数小时
V-Cache采样
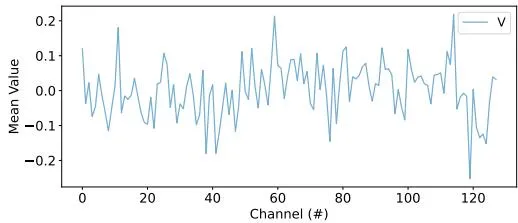
Figure 8: Llama-7b单个注意力头内V cache的采样值。与Figure 5(a)中的采样激活相比,V cache显示出更小的动态范围和更少的离群通道,更容易量化。
八、参考资源
- 论文: arXiv:2310.19102
- PDF: arxiv.org/pdf/2310.19102
- HTML版本: arxiv.org/html/2310.19102v3
引用
@article{zhao2023atom,
  title={Atom: Low-bit Quantization for Efficient and Accurate LLM Serving},
  author={Zhao, Yilong and Lin, Chien-Yu and Zhu, Kan and Ye, Zihao and Chen, Lequn and Zheng, Size and Ceze, Luis and Krishnamurthy, Arvind and Chen, Tianqi and Kasikci, Baris},
  journal={arXiv preprint arXiv:2310.19102},
  year={2023}
}